30 秒看懂
Theo 讨论 OpenAI 宣布的用量限制变化,并比较自己对 Codex 和 Claude 订阅价值的估算。他区分 API 价格与每任务成本,分析重置的影响,并分享一组模型生成代码审查结果的个人比较。
- 1用量限制变化Theo 介绍公告中的增长,并指出部分用量现在合并计算。
- 2每任务成本仅看 token 价格无法说明模型完成一项任务的实际成本。
- 3重置的影响Theo 纠正了对图表的初步解读,并解释重置假设为何重要。
- 4个人比较他的 83 次审查比较更偏好 Opus,而估算的单次审查成本则对 Sol 更有利。
要点建议
- Theo 认为,增长大致让 200 美元档位恢复原有额度,同时提高了 100 美元和 500 美元档位的额度。
- 每 token 价格、每任务 token 消耗和订阅额度是衡量价值的不同方式。
- 是否计入用量重置会显著改变对订阅的回顾性比较。
- 一组由模型评判的个人审查样本更偏好 Opus,但结果只针对该样本。
- 不同产品界面合并计算用量,对用户的影响可能不同。
按章节阅读整理后的全文
新的用量额度
Theo 讨论公告中的增长,以及它与此前削减之间的关系。
我过去一直为 Codex 和 OpenAI 辩护,但最近的用量削减和模型发布让我更难坚持这一立场。对于许多任务,我仍更喜欢 Anthropic 的 Opus 5.5。不过,一项新的用量限制公告看起来是朝正确方向迈出的一步。
根据我讨论的公告,100 美元、200 美元和 500 美元的 Pro 档位以及 Business Premium 的用量限制翻倍。这项变化有一些限定:此前分开的部分用量现在合并计算,因此不同用户的体验可能不同。
要理解这项变化,需要回看此前对 200 美元方案的削减。我的理解是,新增长大致让该档位恢复到原来的水平,而 100 美元和 500 美元档位获得了真正的增长。500 美元档位现在的额度很大,尤其是对于不大量使用高速模式的人。
此前的解释强调,随着模型进步,订阅用户应能在同样价格下完成更多工作;它还主张避免让额度设计激励 API 标价保持高位。我认为以完成工作量为目标是个有用的原则,但额度细节仍然重要。
API 价值与每任务成本
他比较估算额度、token 消耗和基准任务成本。
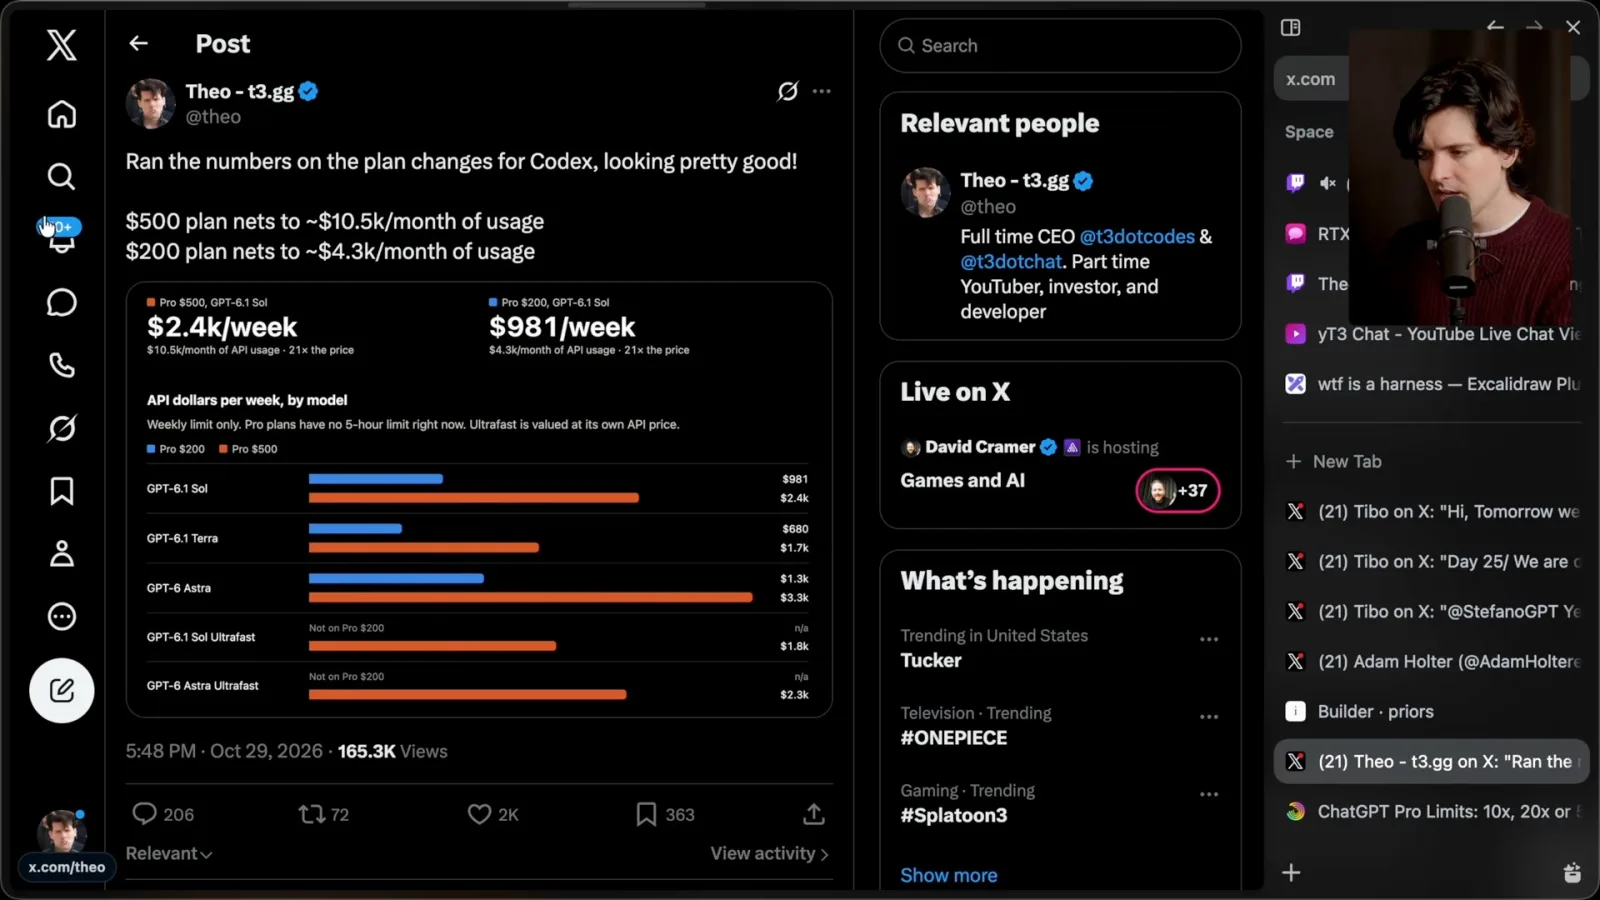
比较方案的一种方式,是估算额度按 API 计价相当于多少价值。我的计算认为,500 美元方案每月约相当于 1.05 万美元,200 美元方案约为 4300 美元。我将其与 Claude 200 美元方案的更高估算值比较,同时指出某些模型有专门限制。
按 API 折算的金额不等于实际完成的工作。每 token 价格只是一个维度;缓存会改变成本,不同模型解决同一任务消耗的 token 数也不同。每 token 价格更低,并不一定直接意味着结果更便宜。
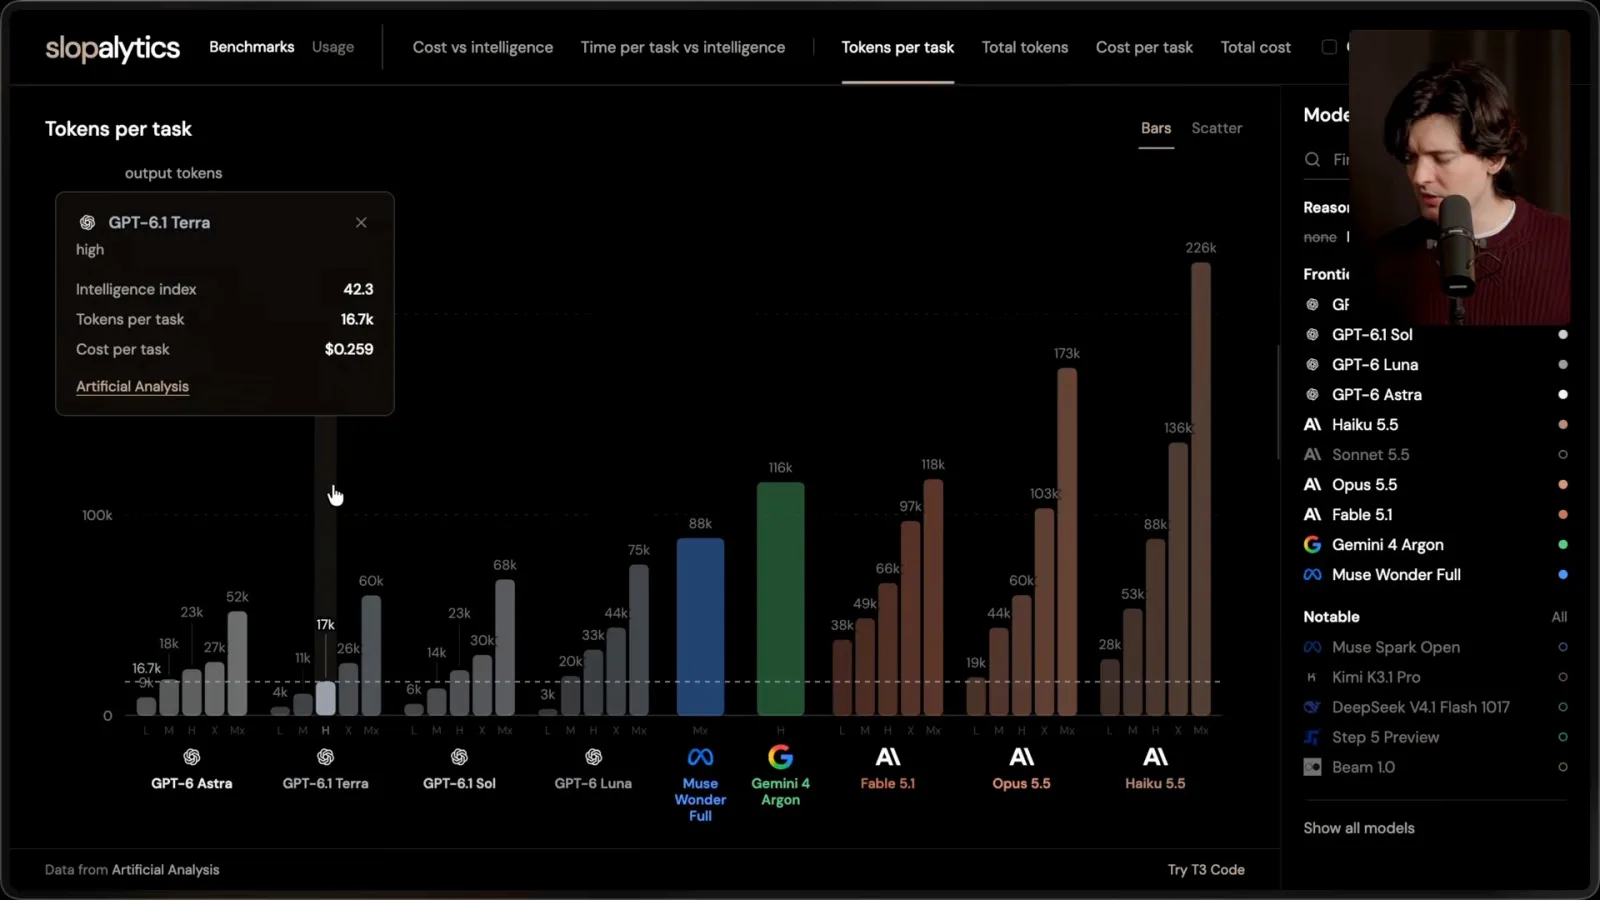
在我展示的基准图表中,所比较的 OpenAI 模型通常比 Anthropic 模型每个任务使用更少 token。比较结果取决于模型和推理级别。我还对照了智能指数和每任务估算成本;在选定配置下,GPT-6.1 Sol 看起来比所选 Opus 配置便宜。
订阅与重置
订阅折扣和用量重置会改变价值比较。
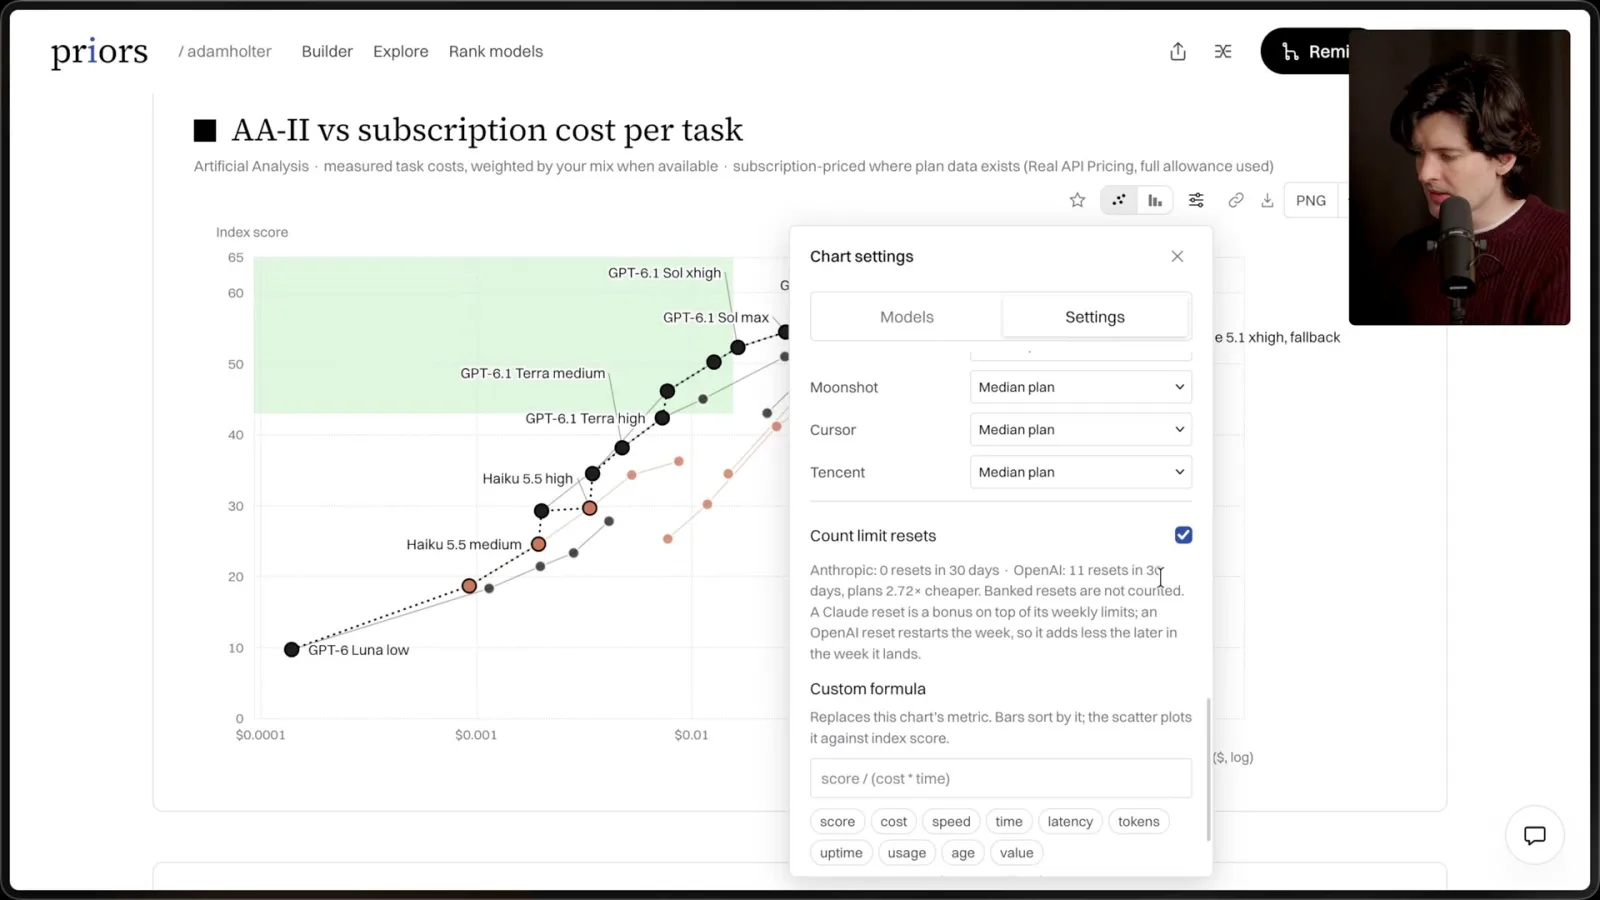
订阅经济性又改变了比较结果。Adam Holter 的分析按照订阅计划的有效额度调整每任务成本。在我最常用的配置中,Opus 5.5 和 GPT-6.1 Sol 的订阅每任务估算成本,比 API 标价比较显示的更接近。
接下来我观察价值前沿:在给定成本下,哪个模型提供最好的测量能力。API 价格和订阅价格可能产生不同的前沿。这张图基于特定基准和一组假设,不应视为适用于所有任务的普遍排名。
是否把用量重置计入,图表也会发生变化。我起初以为两个视图的差异来自额度翻倍,随后纠正了自己:其中一个视图计入了重置。重置历史会显著影响对订阅价值的回顾性计算。
个人审查实验
Theo 比较模型对自己任务中审查结果给出的评判。
这些数字仍然依赖基准任务。为了比较更接近我自己工作的情况,我让多个模型审查同一组拟议改动,再评估它们的审查结果。这是我工作流内的同类比较,并不能普遍证明模型质量。
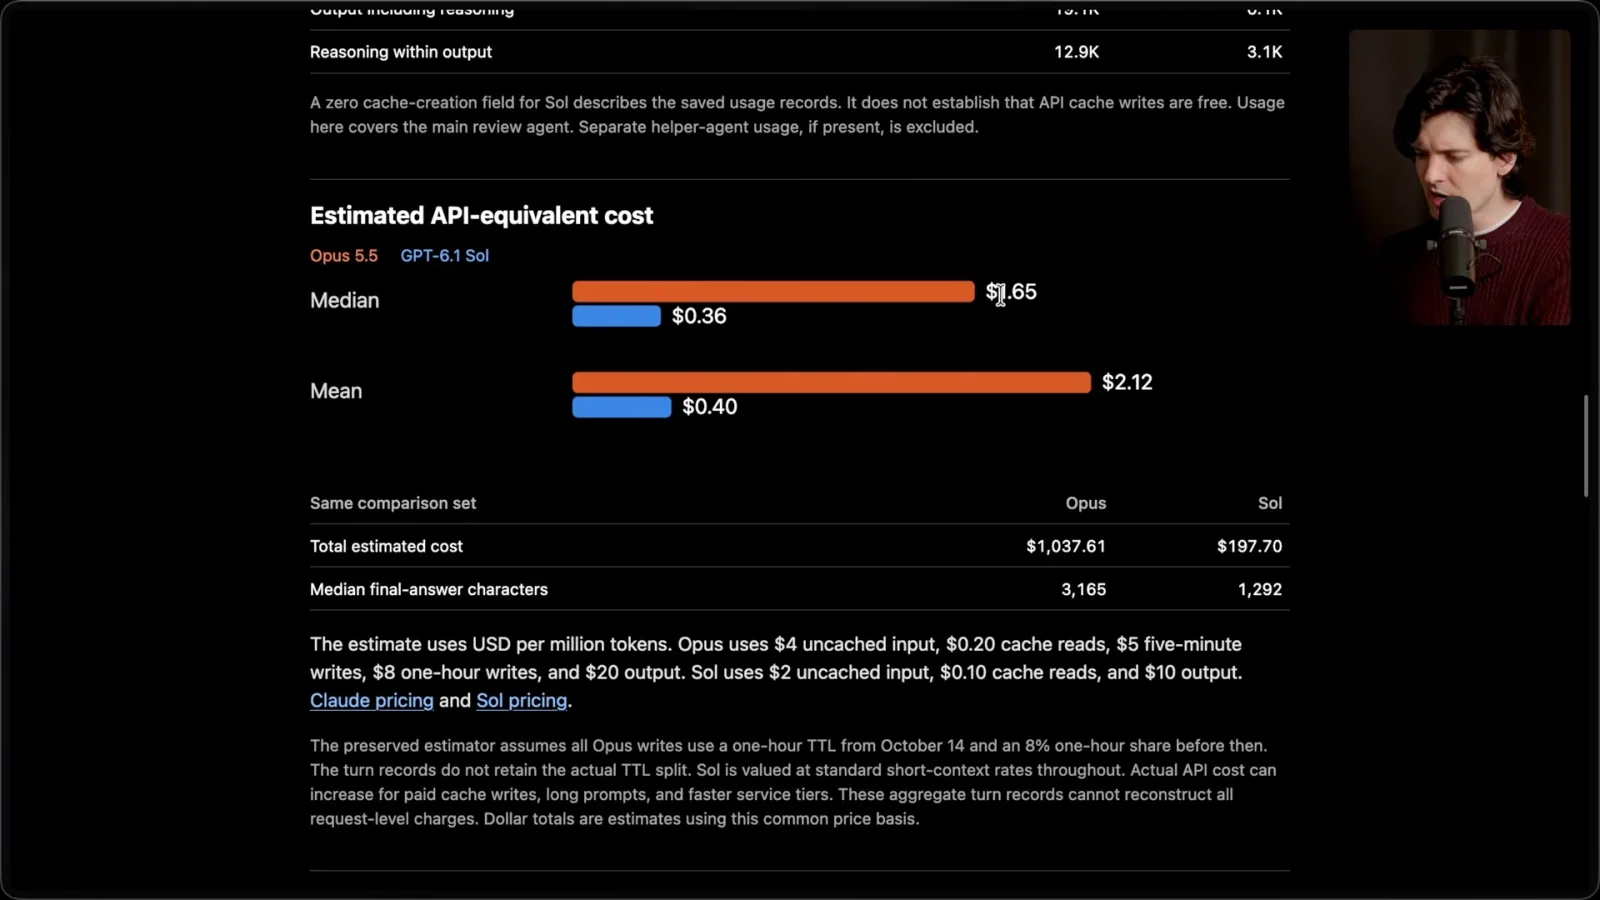
在 83 次比较中,模型评判者更常偏好 Opus 的审查:Opus 有 66 次选择 Opus,Sol 有 54 次选择 Opus。我估算的审查成本中位数按 API 折算分别是 Opus 的 1.65 美元和 Sol 的 0.36 美元。这些判断由模型生成,实验也只反映我的审查任务。
考虑订阅额度后,我的计算约为所比较方案能够完成 205 次 Opus 审查或 290 次 Sol 审查。这比按 API 计算的单次审查成本差距更小。就这个样本的质量而言,我仍会选择 Opus;更重视审查次数或完成速度的人可能做出不同权衡。
共享限额与剩余问题
他讨论合并用量以及自己对更强模型的期待。
公告还把 ChatGPT 和 Work 的用量与所讨论的 Codex 限额合并计算。我预计许多编程用户受到的影响不大,但大量使用其他产品的人可能不同。我不确定 Dots 如何计算,因此不应把我的猜测当作明确规则。
总体而言,我欢迎这次增长,尤其是 100 美元和 500 美元档位。对 200 美元档位,我主要把它看作恢复原状。我仍然担心模型质量:按照我的经验,OpenAI 还需要一个在我重视的工作中更强、能够与 Opus 5.5 竞争的模型。
同频道的其他文章
 16:46EN → 简体中文
 Theo - t3․gg· 2026年11月2日Theo Browne:Claude Ultra、五小时限额与 SDK 用量Theo Browne · Ping Labs解读更名后的订阅档位、账户验证,以及交互式 CLI 与 SDK 用量的报告差异。
 49:29EN → 简体中文Theo - t3․gg· 2026年10月30日Theo:智能体 Harness、界面与不断变化的抽象层次Theo · T3 CodeT3 Code 创建者解释他对 harness 的理解,以及为什么他预计用户会越来越少地注意它们的差异。
 41:49EN → 简体中文Theo - t3․gg· 2026年10月29日Theo 演示如何用 T3 Code 协调编码智能体Theo · t3.ggT3 Code 的创建者介绍多个智能体提供方、远程机器、会话组织方式,以及开源编码界面的取舍。
 38:47EN → 简体中文Theo - t3․gg· 2026年10月28日Theo 的长时间 Agent 实验:验证、算力与成本Theo Browne · Ping Labs滑板游戏和两个编译器项目展示了反复检查与弹性算力如何支撑 agent 工作,也揭示了循环可能带来的高昂成本。
 36:07EN → 简体中文Theo - t3․gg· 2026年10月27日Theo 谈 Token 成本、编程智能体与 AI 能力的价格Theo Browne · Ping Labs一则关于 Lauren 的 AI 支出估算广泛传播,引出了对缓存计价、基准测试和编程智能体工作方式的讨论。
 30:37EN → 简体中文Theo - t3․gg· 2026年10月26日Theo 的三个技能:用编程智能体审查和交付代码Theo Browne · Ping Labssol-loop、full-send 和 full-stop 如何定义审查、验证以及不同程度的合并权限。