30 秒看懂
Osmantic 创始人 Ahmad Osman 说,即使本地模型能力很强,也可能因为配置缺少工具、软件或合适的硬件而失败。他举例说,一个模型获得搜索能力后才成功配置显卡。他建议测试整个工作负载:长提示词、文本生成和并行智能体对资源的要求各不相同。小模型处理特定任务可能更省钱,但购买 GPU 也带来空闲和维护成本。他长期看好能从用户工作中学习的系统。
- 1本地回答可以很快,但一个例子不能决定排名Osman 用一个例子比较本地模型和云端模型,并提醒不同基准测试的结果可能不一致。
- 2长提示词和生成回答对硬件的要求不同处理提示词和生成 token 对计算与内存的需求不同,因此最合适的硬件取决于工作负载。
- 3并发智能体请求改变硬件比较在他展示的测试中,工作站 GPU 并行处理了 50 个请求,其他系统则基本按顺序处理。他认为差距部分源于软件。
- 4组件快 100 倍,整体可能只快 11%Osman 假设分词占请求时间的 10%,以此说明只优化一个组件的局限。
- 5添加搜索解决了被归咎于本地模型的失败模型获得最新信息和工具后,便能配置新显卡。
- 6偶尔使用 GPU,租赁可能更便宜Osman 说,比较租赁与购买时,要考虑设备空闲、维护和可靠性。
- 7Osman 正探索让本地系统持续学习他提出结合检索结构、决策模型和权重编辑,并表示这项工作仍在进行中。
要点建议
- 把失败归因于模型质量前,先用相同工具和信息测试模型。
- 针对自己的工作负载,测量首次响应、输出速度、并发请求和任务准确率。
- 压缩方法和推理软件要适合具体模型与硬件。
- 购买 GPU 前,比较租赁费用、设备利用率、维护和可靠性。
- 用真实任务记录评估小型专用模型是否足够。
按章节阅读整理后的全文
本地 AI 需要完整体验
Osman 认为,模型和硬件进步必须配合普通用户能够操作的工具。单凭基准排名无法判断模型是否适合具体任务。
开源 AI 是优化问题,本地 AI 是用户体验问题,二者需要同时解决。自 6 月的本地 AI 峰会以来,我看到更多推理引擎,也有更多针对具体模型、芯片和工作流的优化。
我们为 RTX Spark 构建了优化过的推理引擎,并在 Windows 上完全用本地资源制作了一款游戏。看到普通访客在发布活动中试玩,我觉得对本地 AI 的兴趣正在超越专业圈子。
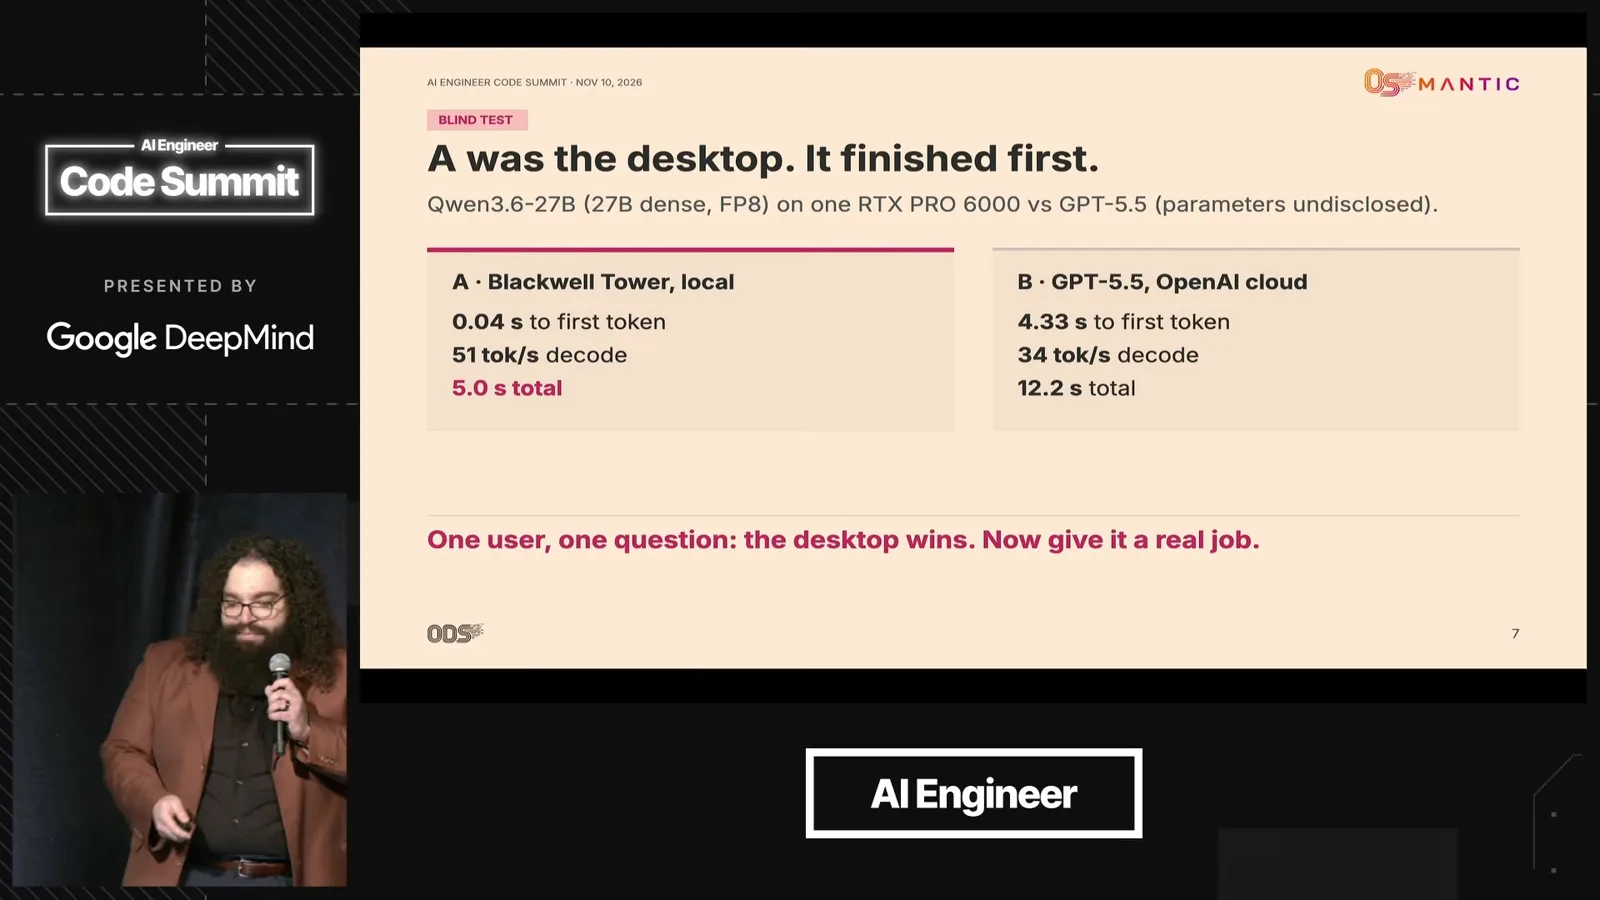
在与 Hugging Face 的一次演示中,一个本地 270 亿参数模型在特定例子中的回答与云端模型相近,输出速度分别为每秒 51 和 34 个 token。单个例子不能决定哪个模型最好,但表明本地运行值得关注。
不同基准排名对开放和闭源模型的评价差别很大。有些显示二者差距悬殊,有些则显示开放模型领先。我很难决定该相信哪个比较,所以希望根据我交给模型的实际任务来评判它们。
智能体工作负载越来越多地为其他智能体生成 token。但智能体可能花大量时间等待 shell 命令或其他任务结束,因此原始输出速度未必是工作流的主要瓶颈。
我看好小型专用模型。一个模型可能擅长写代码,却不太可靠地解决陌生问题;专门的安全模型不需要在所有方面追平大模型,也能发挥作用。
在多台本地机器上制作预告片
Osmantic 创始人介绍如何使用智能体、GPU 和笔记本电脑制作视频。他认为工作流的不同部分可以使用不同模型和机器。
我是 Ahmad Osman,Osmantic 的创始人兼首席执行官。这家公司的核心判断是,工作流的每一步都不需要能力最强的前沿模型。许多独立任务可以交给专门设计的小模型。
我用智能体制作了这场演讲的预告片。我把视频和文章交给它,挑选喜欢的素材,智能体再组合片段、文字和音乐。整个过程大约花了六小时。
预告片仍然需要多台机器协作:两块 RTX Pro 6000 GPU 负责标记和画面放大等任务,我的 MacBook 负责编辑和选择不同版本。我预计小型专用模型最终能在家完成这类工作。
云端就是别人数据中心里的机器。我们的智能体运行框架 Portal 旨在让家里的算力也能参与工作流。真正有用的问题是任务适合哪台机器和哪个模型,而不是某个基准是否把它称为前沿智能。
压缩和内存决定能运行什么
Osman 回顾了在 14 块 GPU 上运行大模型的经历,随后解释压缩技术和模型架构为何影响准确率及内存需求。
长输入仍然很难处理,因为它会占用内存。我过去用 14 块 RTX 3090 GPU 的配置才勉强装下 DeepSeek R1。这个 6710 亿参数模型在系统内存里起初每秒输出约八个 token,但上下文增长后速度就变慢了。
后来,按我的使用经验,一个更小的开放模型能力更强。更早之前,我已经用本地模型和一块 GPU 做出了截图整理工具。缺的往往是模型周围的工程,而不是再把模型做大。
针对特定硬件的软件正在改善,包括为特定 GPU 优化的推理引擎。消费级工作站 GPU 与数据中心芯片即便属于同一系列,特性也可能不同,因此优化要考虑实际机器。
量化通过降低模型数值的精度来减少内存占用。不同方法会在重要的地方保留更高精度,同时更大程度地压缩其他部分。把所有层一视同仁可能损害模型,所以方法和标称位数同样重要。
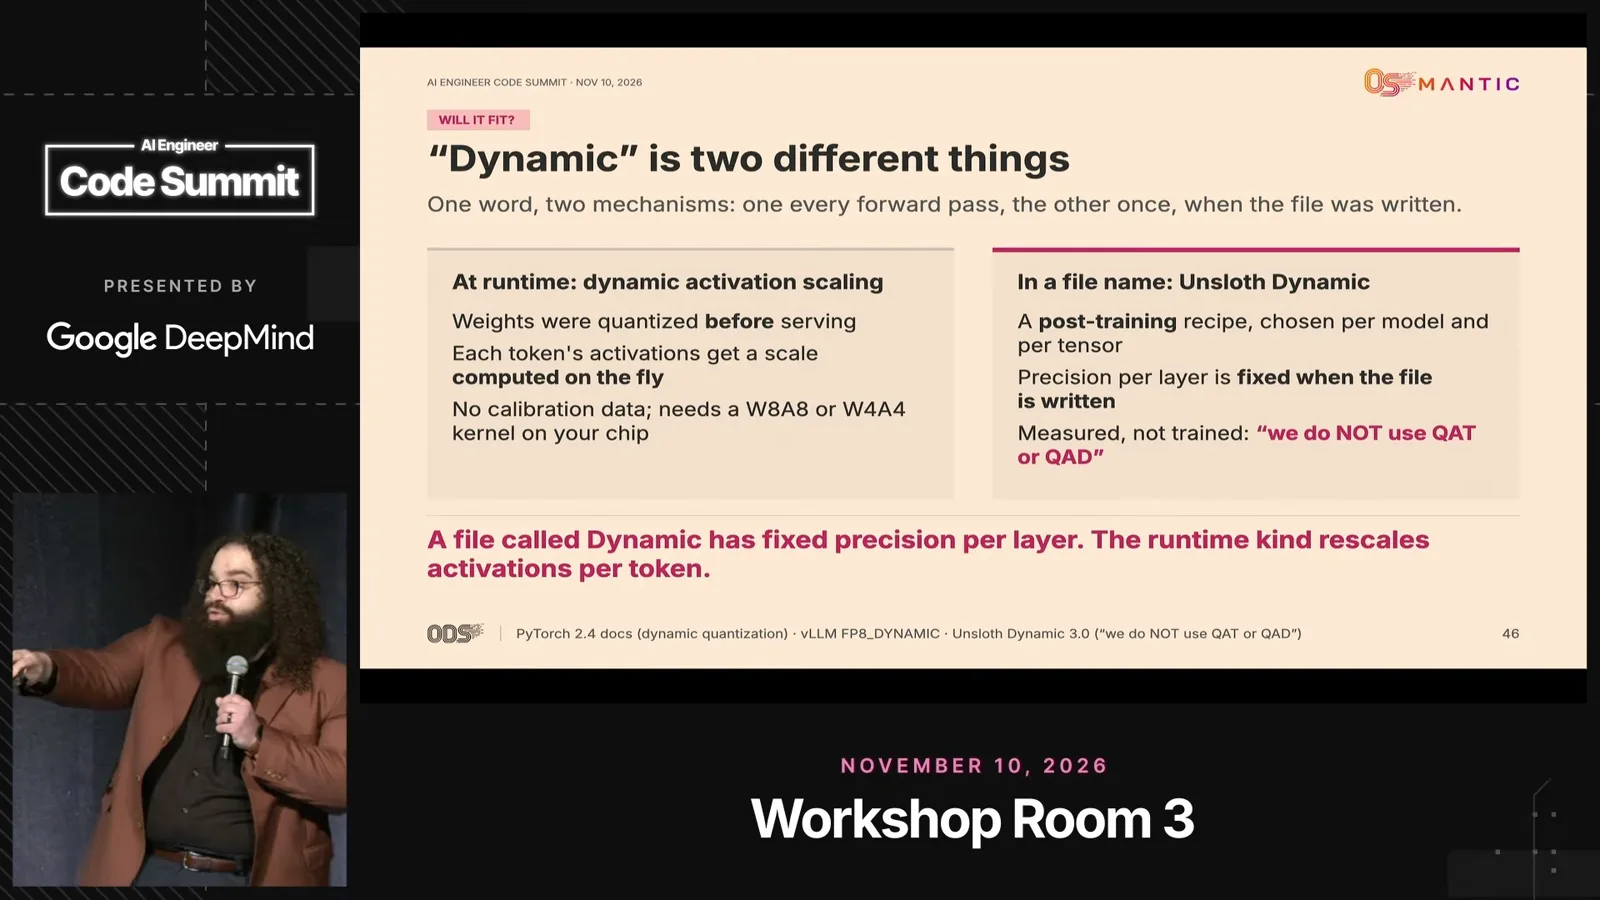
我展示过一个例子:较新的四位模型在压缩后保留的测量准确率比旧模型更多。更好的量化可以让能力较强的模型放进更小内存,但结果取决于模型和方法。
根据工作负载选择硬件
处理提示词、生成 token 和并发请求会给不同资源带来压力。他的硬件测试说明应同时测量带宽与软件表现。
模型先处理提示词,再生成回答。处理长提示词通常更依赖计算吞吐量,而逐个生成 token 往往更依赖内存带宽。应根据自己的工作负载选择硬件。
模型架构也很重要。稠密模型生成每个 token 时都会用到全部参数,混合专家模型则只激活其中一部分。即使单看模型规模数字觉得它们相近,两者对内存和速度的要求也不同。
我预计小得多的模型将能处理更多任务,由另一个模型负责协调。更好的硬件和模型优化可以把过去需要数据中心的能力带到个人设备,但如何比较仍取决于具体任务。
标称内存带宽本身不能预测结果。在我们的测试中,软件优化让两台较小的机器超过了一台标称带宽更高的系统。我认为部分硬件的软件仍需要大量改进。
有人问我该买什么硬件,我会问他愿意花多少时间让它运行起来。想马上获得结果的人可能更适合成熟的软件栈;喜欢实验的人则可能从不太成熟的软件栈中获得乐趣。
在与 Hugging Face 的演示中,我们把同一个模型分别运行在工作站 GPU、MacBook、DGX Spark 和另一台系统上。工作站 GPU 每秒输出更多 token,我认为部分原因是它的内存带宽。
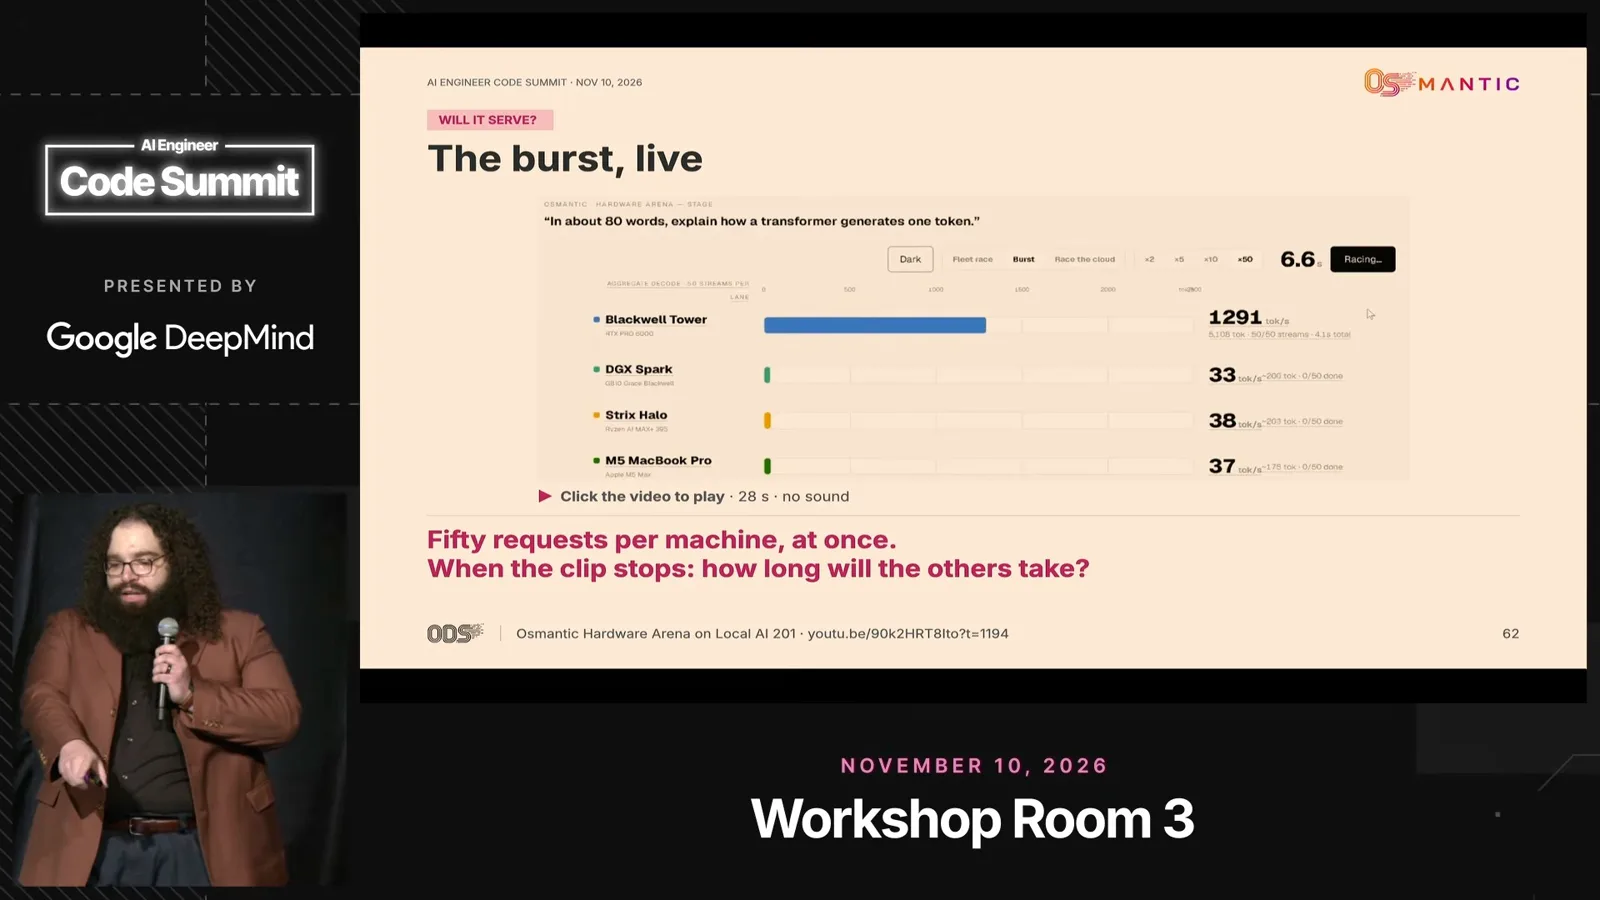
我们同时运行 50 个请求时,差距更加明显:展示的测试中,工作站 GPU 每秒达到近 1300 个 token,其他系统实际上是顺序处理。我认为这既是硬件比较,也是软件问题。
通用推理引擎必须支持许多机器,这可能限制它针对每台机器的优化程度。我希望看到更多针对特定模型和芯片优化的引擎,由开源贡献者在自己拥有的硬件上测试。
如果多个智能体要并行工作,应测量同时处理请求的表现,而不是只测一次回答的速度。我偏好 GPU 正是基于这类工作负载;如果有专门优化的推理引擎,另一台机器可能表现更好。
测量完整推理流程
不同引擎和量化方法会改变性能。一个大幅加快分词器的例子说明,组件速度大增可能只带来较小的端到端收益。
模型格式、压缩技术和推理引擎各有不同。我认为当前最优先的不是统一标准。实验可以帮助我们找到真正重要的优化,即使一些现有实现以后会被丢弃。
选择推理引擎时,要在自己的设备上比较首个 token 的等待时间、每个用户或智能体的输出速度、每秒请求数和任务准确率。网上公布的数字不一定能在你的芯片、模型和工作负载组合上复现。
同一个模型在不同硬件上的表现可能不同,因为指令集和推理软件不同。不能假定指令或数据处理在每个平台上都以相同方式运行。
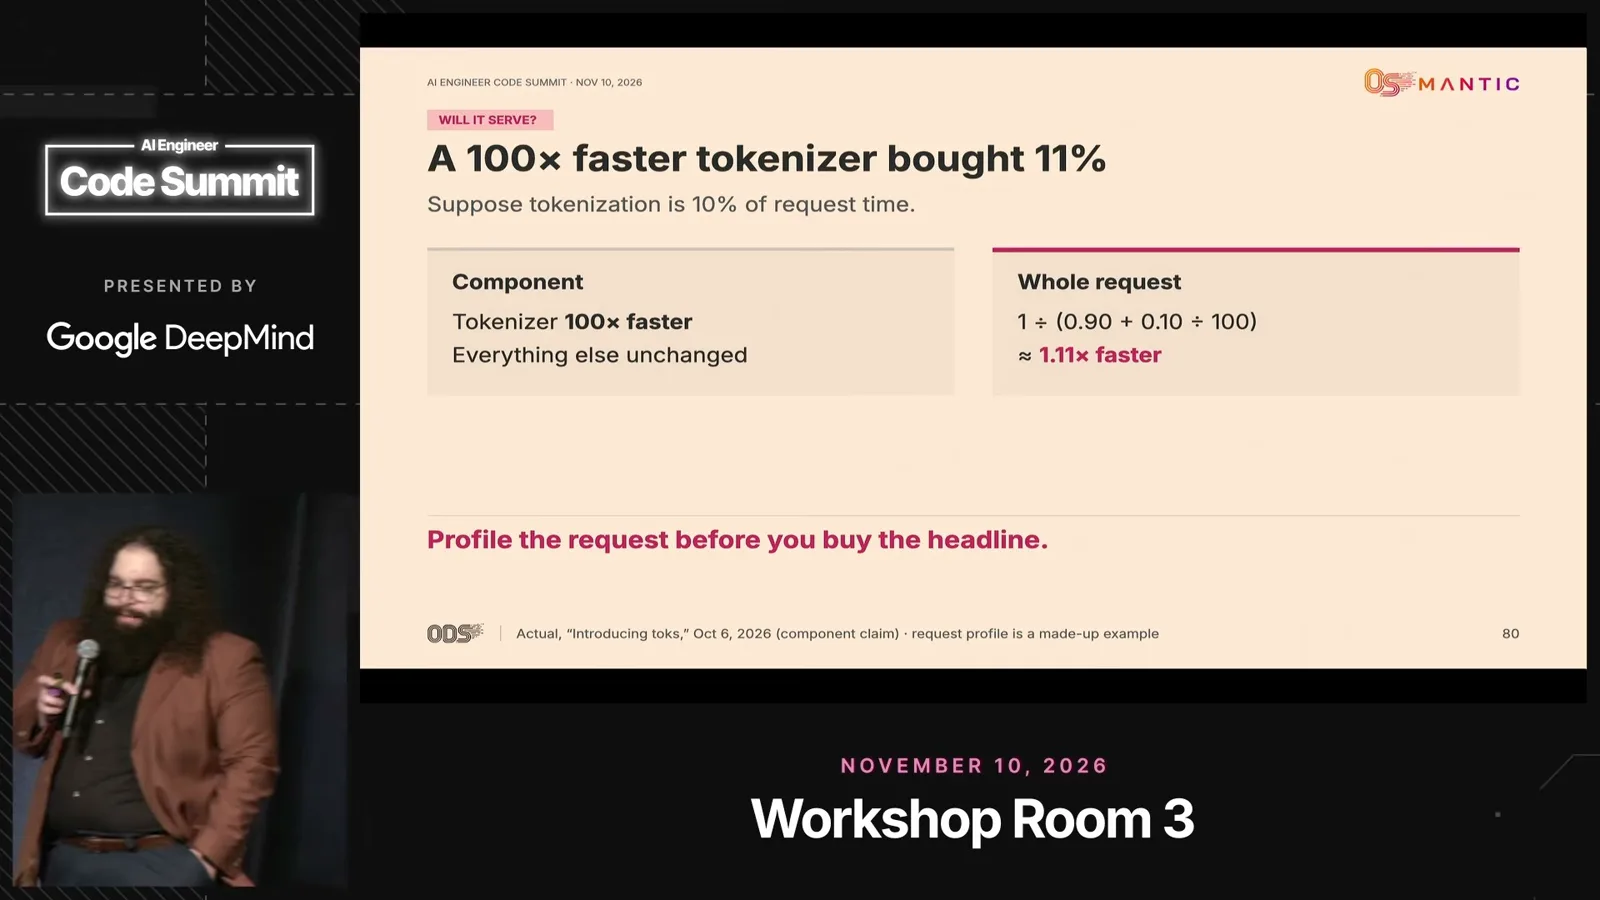
一个团队把分词器的速度提高了约 100 倍。Osman 假设一次请求中分词占用 10% 的时间,以此说明整体请求只会快约 11%。这个例子表明,组件加速不等于端到端收益。
人们正在尝试推测解码和针对不同硬件的推理引擎版本。我刚粗略读过的一篇论文描述了调度改进,在测试中提高了吞吐量;在得出明确结论前,我还需要仔细研究。
模型需要合适的周边工具
一个本地模型在获得搜索和最新信息前无法配置显卡。Osman 认为,用户体验和模型比较都取决于周边工具。
我们希望 ODS 根据模型和平台选择合适的推理引擎,而不是把用户绑定在一个引擎上。大多数人不想研究这些内部细节,他们想要能用的本地工具。
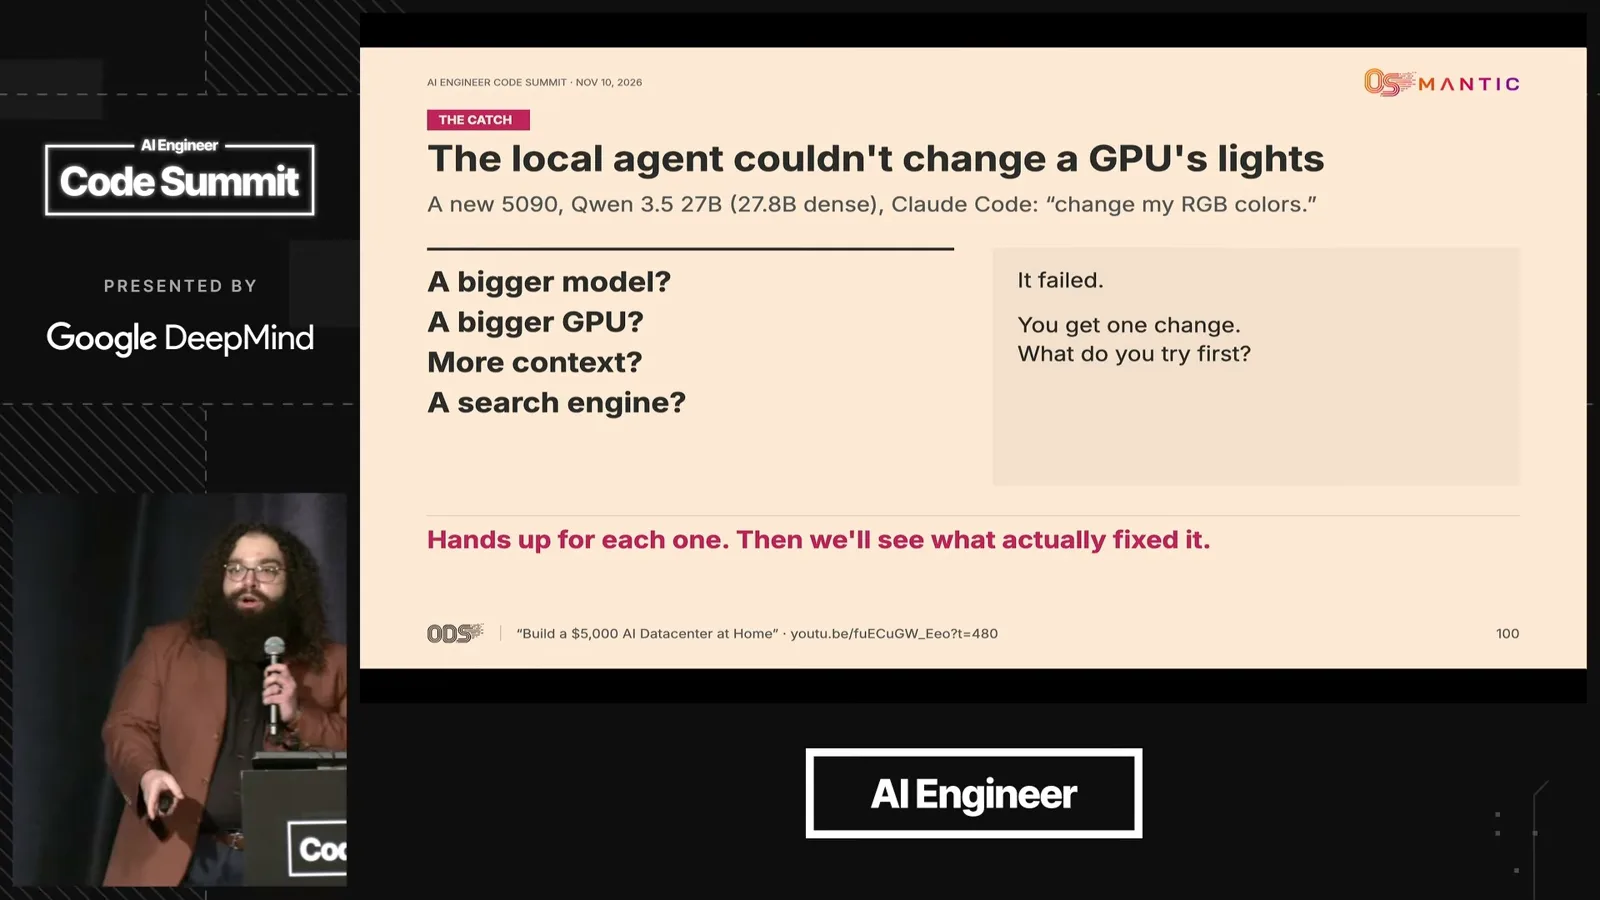
一位朋友让本地模型更改新显卡的灯光,失败后便认定模型更差。云端编程工具能搜索,本地配置却没有这个能力。
我给本地配置添加搜索和所需信息后,它成功完成了任务。如果模型的训练早于某个工具或设备的出现,它可能需要最新文档。如果不给模型相当的工具就进行比较,可能会把基础设施问题误认为模型能力问题。
糟糕的首次体验可能让人彻底放弃本地 AI。所以完整配置很重要,包括工具和合理的默认设置:用户不应先成为推理引擎专家才能得到有用结果。
我提到的一篇论文描述了智能体围绕重复工作构建可复用的工程工具。思路是改善周边系统,让模型在重复步骤上消耗更少 token。
专用模型与租赁、购买的权衡
任务记录可以帮助评估适合特定工作流的小模型。偶尔使用适合租赁,而拥有硬件则增加维护和可靠性成本。
人们更换模型的频率随工作类型而不同。我鼓励大家试试新选择,不要假设某家厂商的模型始终最适合所有任务。
我引用了 Airbnb 的一个例子:一个 20 亿参数模型以远低于前沿模型的成本,达到了某项特定任务所需的质量。这展示了专门训练和评估能为明确工作流带来的效果,并不能保证适用于所有应用。
智能体的运行记录可以帮助团队建立针对特定任务的评估和训练数据。基于这些例子,团队可以探索一个处理重复工作更快、成本更低的小模型,但仍须在实际工作中测量结果。
专用化也有局限。针对常见编码任务调优的模型可能执行得很好,却不一定是我用于真正新颖研究的选择。速度、成本和能力必须针对具体请求权衡。
购买 GPU 不总是正确选择。如果一项任务只运行几小时,租用算力并在结束后关闭,可能比为空闲设备付费更便宜。
对供应商的信任也很重要。我担心低价服务可能把请求转给与宣传不同的模型。对于这种区别很重要的工作负载,我更愿意检查基础设施和实际运行的模型。
在我看来,不断进步的开放模型形成的竞争会给价格带来压力。每百万 token 的价格不能直接告诉你哪个模型最适合你的应用;要比较实际任务中的有效输出和总成本。
提供命令行界面的租赁服务,可以让智能体启动 GPU 任务并在完成后关闭机器。这仍需要一些工程工作,但能避免为空闲机器支付一整天的费用。
拥有设备本身也需要维护:依赖关系、静默故障、硬件损坏和冗余都要考虑。自己运行设备可能很有乐趣,但与云服务比较时也要计入这些运营成本。
为更好的模型与持续学习做准备
Osman 预计更好的引擎和模型会让现有硬件更有用。他介绍了一种基于查找结构、决策模型和权重编辑的实验性持续学习方案。
三股力量正在汇合:每个参数具备更多能力的模型、针对工作流的专用模型,以及更好的推理引擎。模型和软件不断变化,今天买的 GPU 以后可能运行能力强得多的模型。
我比较了一个较新的 270 亿参数稠密模型和一个更早、规模大得多的混合专家模型。在我展示的比较中,新模型表现更好,所需的总内存却少得多。激活参数量和总内存需求是两个不同的数字。
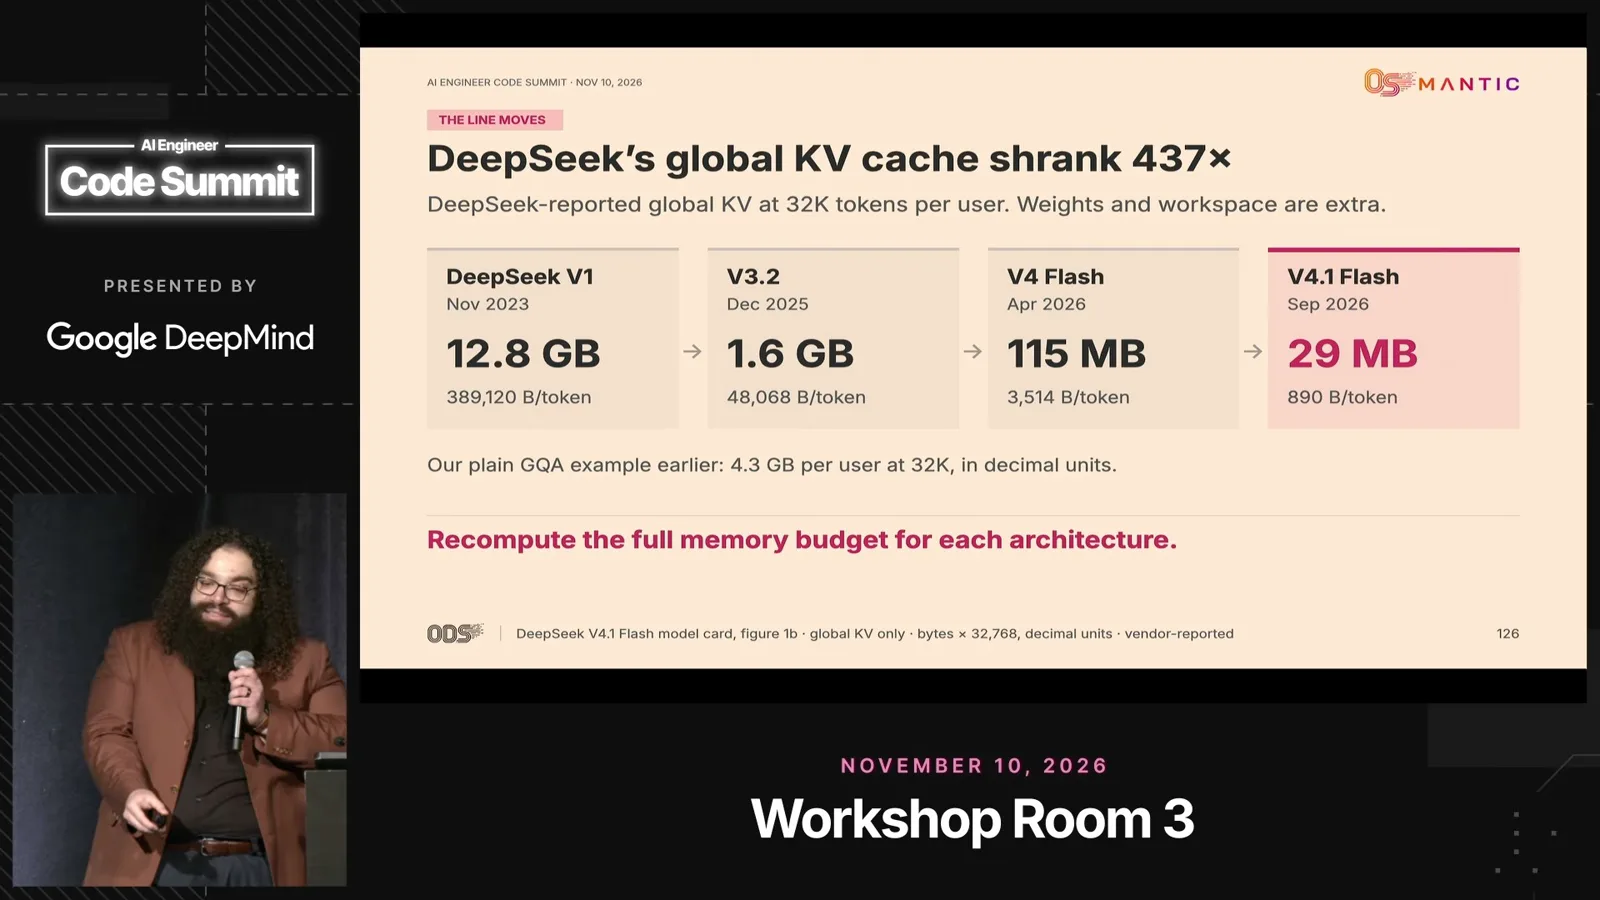
在我展示的例子中,一个较新的模型还减少了注意力缓存所占的内存。降低长输入成本的技术,也是我们应该考察整个模型与引擎,而不是只看设备内存容量的原因。
我下一个押注是持续学习:系统能根据用户自己的经验调整,而不是在单独文件里积累越来越多的指令。我认为本地运行很重要,因为服务众多客户的供应商未必会为每个人单独训练模型。
随着上下文增长,我见过智能体即使有一整套指令,仍然创建相互冲突的文件或重复犯错。在我看来,这使指令文件和记忆变通方法无法完全替代学习。
我们演示过一个运行在配备 128 GB 内存的 Windows 机器上的本地模型,在那个例子中每秒输出约 72 个 token。我想说的是,决定今天买什么硬件时,也应考虑明年可能出现的模型和优化。
开放模型可以进步得很快。对于没有最大实验室那样的算力预算的团队,专用化是一种取得实际进展的方式。我曾预测某项本地能力会在年底达到,在自己的测试中却更早看到了相当的表现。
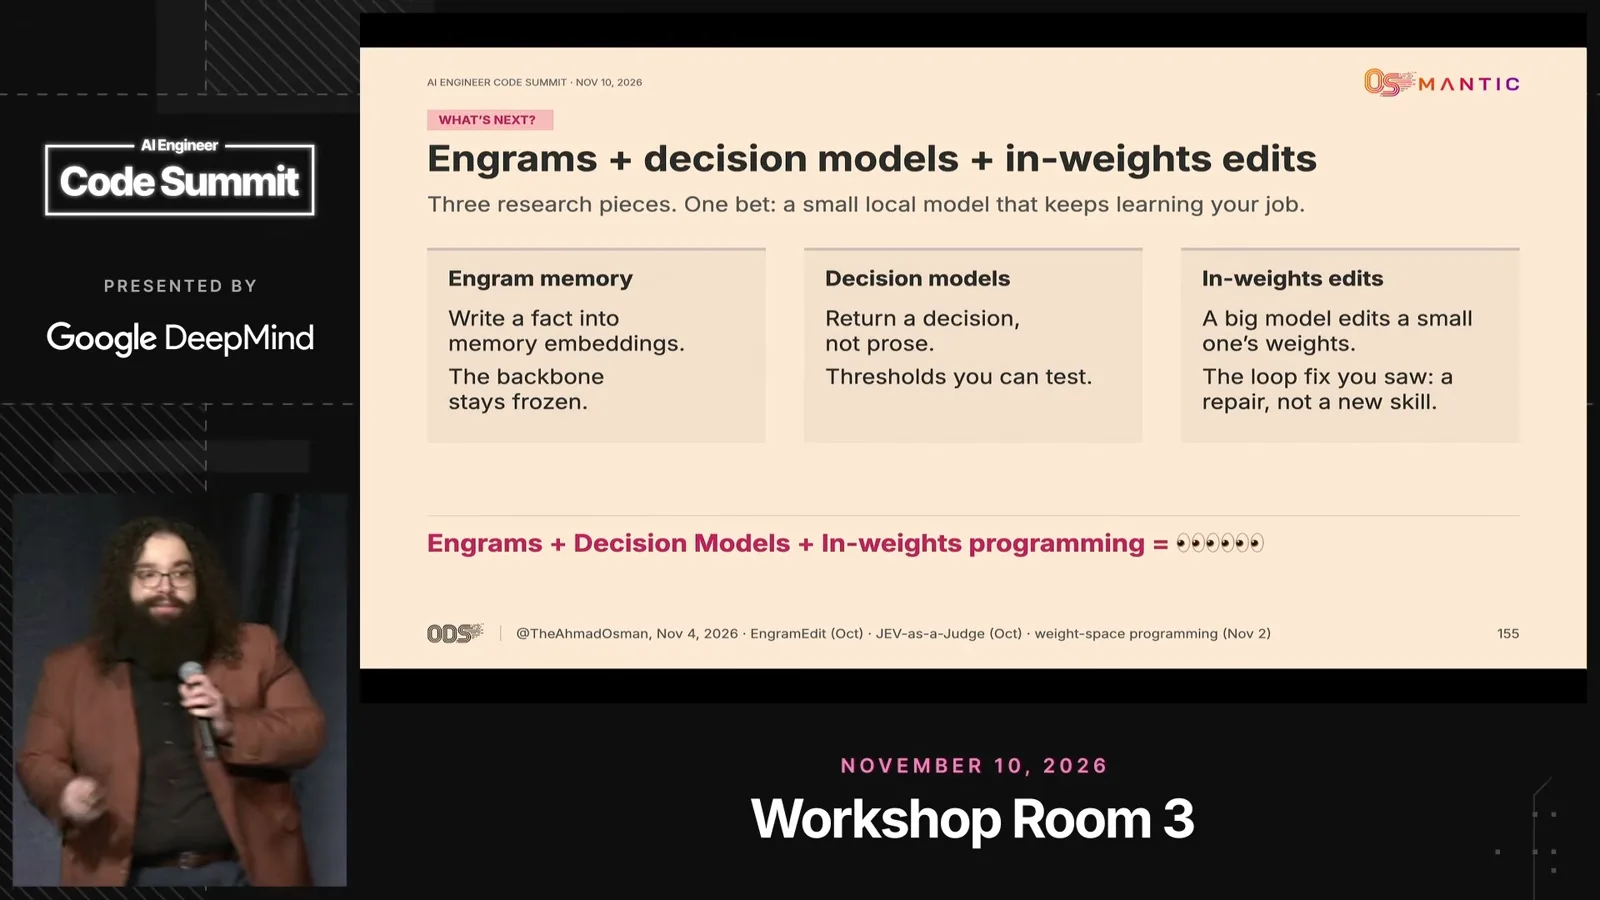
我正在探索一种可能的持续学习方案,把查找结构、决策模型和对模型权重的编辑结合起来。查找结构可以将可检索的信息保存在 SSD 或内存中。这是我正在研究的方向,还不是成品系统。
这样的设计可能在模型内部、模型周围及跨实验使用循环。一些查找组件可以在普通 CPU 和存储设备上运行,不需要每一步都使用 GPU。
评估需要反映你自己的修正和运行记录,而不是仅仅奖励模型钻基准测试的空子。想知道改动是否有助于实际工作,需要好的数据和仔细的测试。
同频道的其他文章
 14:28EN → 简体中文
 AI Engineer· 2026年11月20日Zach Bruggeman:Ramp 如何让编码智能体成为团队共用工具Zach Bruggeman · RampRamp 向同事公开智能体的工作会话,让经验得以传播,也为代码审查提供验证依据。
 18:30EN → 简体中文AI Engineer· 2026年11月20日Zach Lloyd:把编码智能体当作可测量、可改进的系统Zach Lloyd · WarpWarp 创始人认为,团队可以记录智能体的工作,用真实任务测试改动,并衡量成本和质量,以此改进编码智能体。
 19:08EN → 简体中文AI Engineer· 2026年11月19日Thariq Shihipar:在 AI 编写的软件中保留人能读懂的一层Thariq Shihipar · Anthropic他在格斗游戏中保留可读、可编辑的规则,让智能体处理底层引擎。
 22:25EN → 简体中文AI Engineer· 2026年11月19日Fabian Hedin:Lovable 如何让编程智能体持续工作数小时Fabian Hedin · LovableLovable 将智能体历史与执行过程分开,为工作中的计算机保存检查点,并把验证结果反馈给任务。
 17:50EN → 简体中文AI Engineer· 2026年11月18日Melvin Johnson:训练编程智能体解决问题,而不是钻测试空子Melvin Johnson · Google DeepMindGoogle DeepMind 后训练负责人介绍更难的任务、代码审查式评分和对诚实报告的奖励。
 14:07EN → 简体中文AI Engineer· 2026年11月18日Walden Yan:建立让编程智能体持续工作的反馈循环Walden Yan · CognitionCognition 报告称,通过让智能体能够测试代码并承担长期目标,合并的变更数量增长了 40 倍。