30 秒看懂
Warp 创始人 Zach Lloyd 认为,编码智能体需要像其他工程系统一样接受严格的测量。他建议用代码定义智能体工作流、记录运行过程并评估结果,让团队发现失败并测试改进方案。在 Warp,另一个智能体可以分析失败的运行,提出改动供人工审查。Lloyd 还建议用不同模型和配置重跑公司真实任务:公开基准排名本身无法告诉团队哪种方案最适合自己的工作。
- 1逐个提示限制了自动化,也让成本更难管理Lloyd 说,个人配置的本地智能体依赖人工提示,也让组织难以评估整体成本、生产率、安全性和治理情况。
- 2用代码定义工作流,再通过循环不断改进他所说的软件工厂用代码指定智能体、触发条件、工具和工作流,并在任务从问题推进到实现和验证的过程中衡量结果。
- 3记录智能体运行过程,才能调查失败原因对话、产物和截图为改进系统提供原始材料。沙箱计算和可替换的模型则提高了过程的可重复性,也提供更多可测试的选项。
- 4评估器可以标记不同运行中出现的冗余测试Lloyd 演示了一项评估,它会检查智能体产物中不必要的测试并打分。团队可以依据这些结果追问失败的原因,以及如何改变工作流。
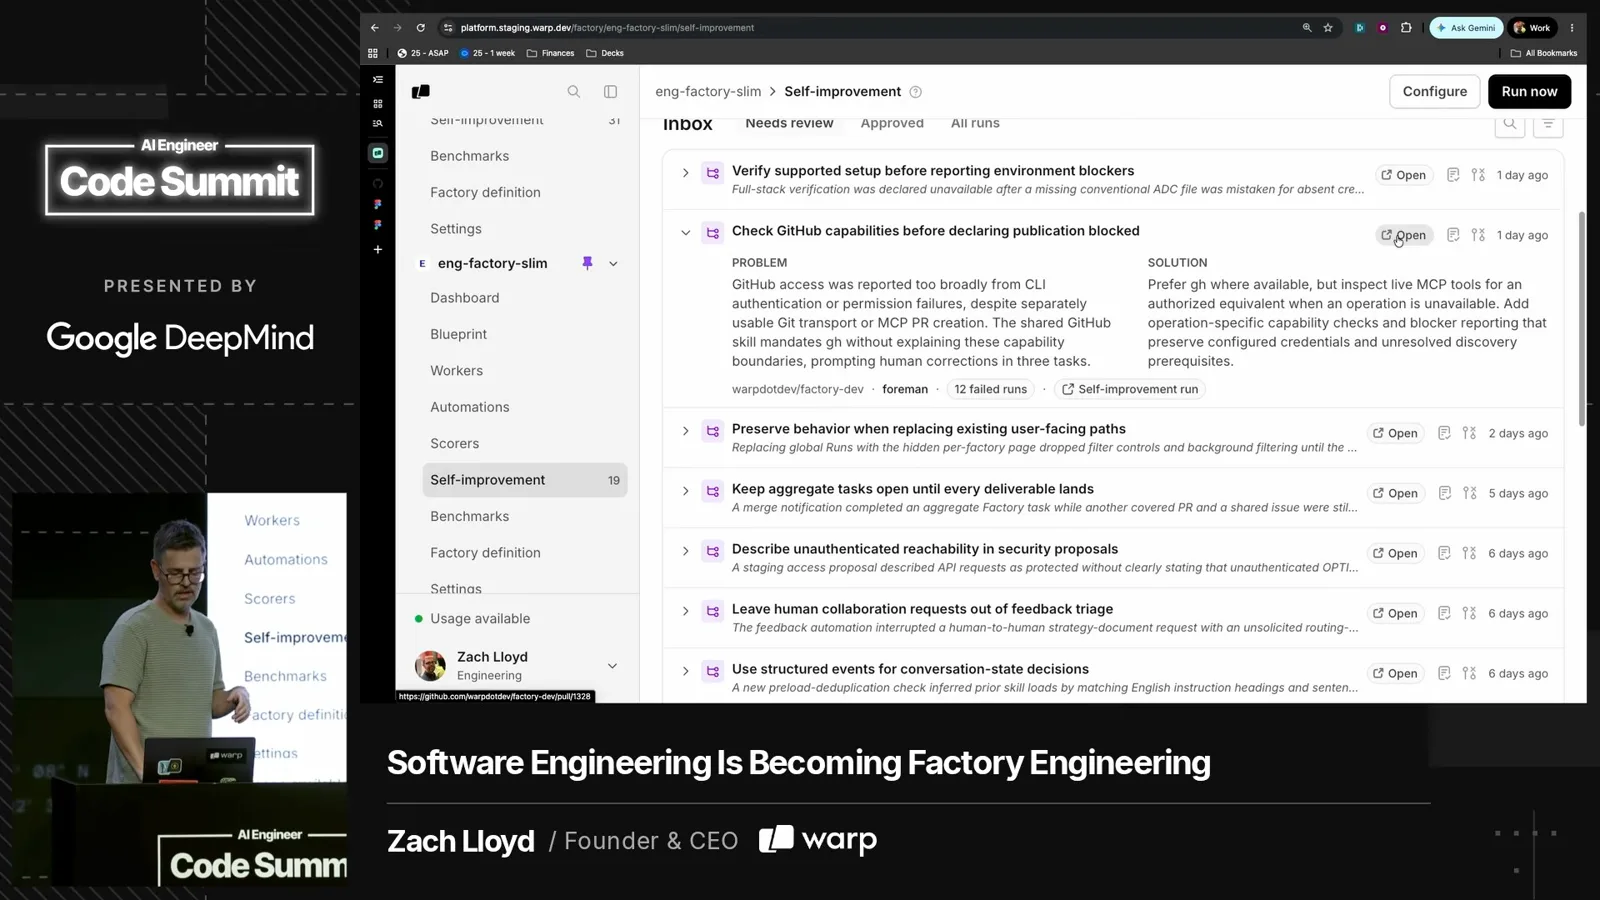
- 5智能体可以对自己的工作流提出修正另一个智能体会分析失败运行中的规律,针对工厂定义提出拉取请求,让人审查改动。
- 6用自己的任务评测模型和配置Lloyd 建议使用不同模型、智能体运行框架和配置重跑真实任务,比较质量和成本,而不是依靠公开排名。
要点建议
- 用有版本记录的代码定义智能体工作流,让改动可以测试和回滚。
- 记录智能体的对话和产物,作为诊断失败的依据。
- 通过评估找到反复出现的问题,再提出可供审查的工作流改动。
- 用组织自己的真实任务比较模型和智能体配置,同时比较成本。
- 在关注质量的同时,跟踪吞吐量、周期时间和每个拉取请求中的人工交互次数。
按章节阅读整理后的全文
为什么逐个提示的智能体难以扩展
Lloyd 说,人工提示限制了自动化,分散的本地配置也让成本管理和治理变得困难。他介绍了自己提出的替代方案:软件工厂。
我当了很多年工程师,曾领导 Google Docs 的工程团队,见证它扩展到数亿用户。现在我经营 Warp,它为企业创建自己的软件工厂提供工具,也因智能体终端而为人所知。我们的目标是帮助开发者更快地交付更好的软件。
我遇到的大多数开发者仍通过终端或开发环境在本地运行编码智能体,有时会同时运行多个。我认为这种情况正开始改变。如果每个智能体都需要交互式提示,自动化的程度就会受人们发出指令的速度限制。
工程负责人还告诉我,如果每个人都自行选择本地配置、模型和技能,就很难知道智能体在成本和生产率方面是否得到了有效使用。各自独立的配置也可能带来安全和治理问题。
定义工厂并测量它的工作
软件工厂用代码描述智能体和工作流,并在持续循环中加以改进。Lloyd 认为,必须能衡量质量、成本和吞吐量,这个循环才有用。
我不会把软件工厂定义为松散组合的自动化工具、AI 队友、共享工具或个人智能体群。它们都是有用的组成部分。对我来说,软件工厂是一个用代码定义的闭环系统,持续测量和改进云端编码智能体。
要扩展这样的系统,就需要以声明式方式定义它:运行哪些智能体、由什么触发、能访问什么工具、在哪里运行,以及工作如何经过你选择的各个阶段。可以把它想成一组以代码定义基础设施风格编写的配置文件。
这个循环可以从人的想法或自动信号开始,然后让一个问题经过分类、实现、验证和监控。随着智能体完成更多工作,运行过程留下的依据可以帮助提高循环效率。
一切都需要能够测量。如果只是凭感觉决定如何部署智能体,就无法确信自己是否以最佳成本获得所需质量,或让吞吐量达到最大。这里的工程问题是,如何围绕智能体构建系统,让它们得到有效使用。
改进智能体所需的工具和基础设施
评估、基准测试和实验成为工程工具的一部分。Lloyd 描述了配置、运行数据、沙箱计算、模型、编排和访问等层次。
这需要一套新工具。我在 Google 学习工程时,调试器、性能分析工具和浏览器开发工具都是工作技能的一部分。对于智能体系统,这些技能包括建立评估、构建改进循环、编写基准测试以及测试不同配置。
产品工程依然重要:工程师仍要对交付的产品是否解决了客户的真实问题负责。但我认为,工程师还需要学习如何改进构建产品的系统。
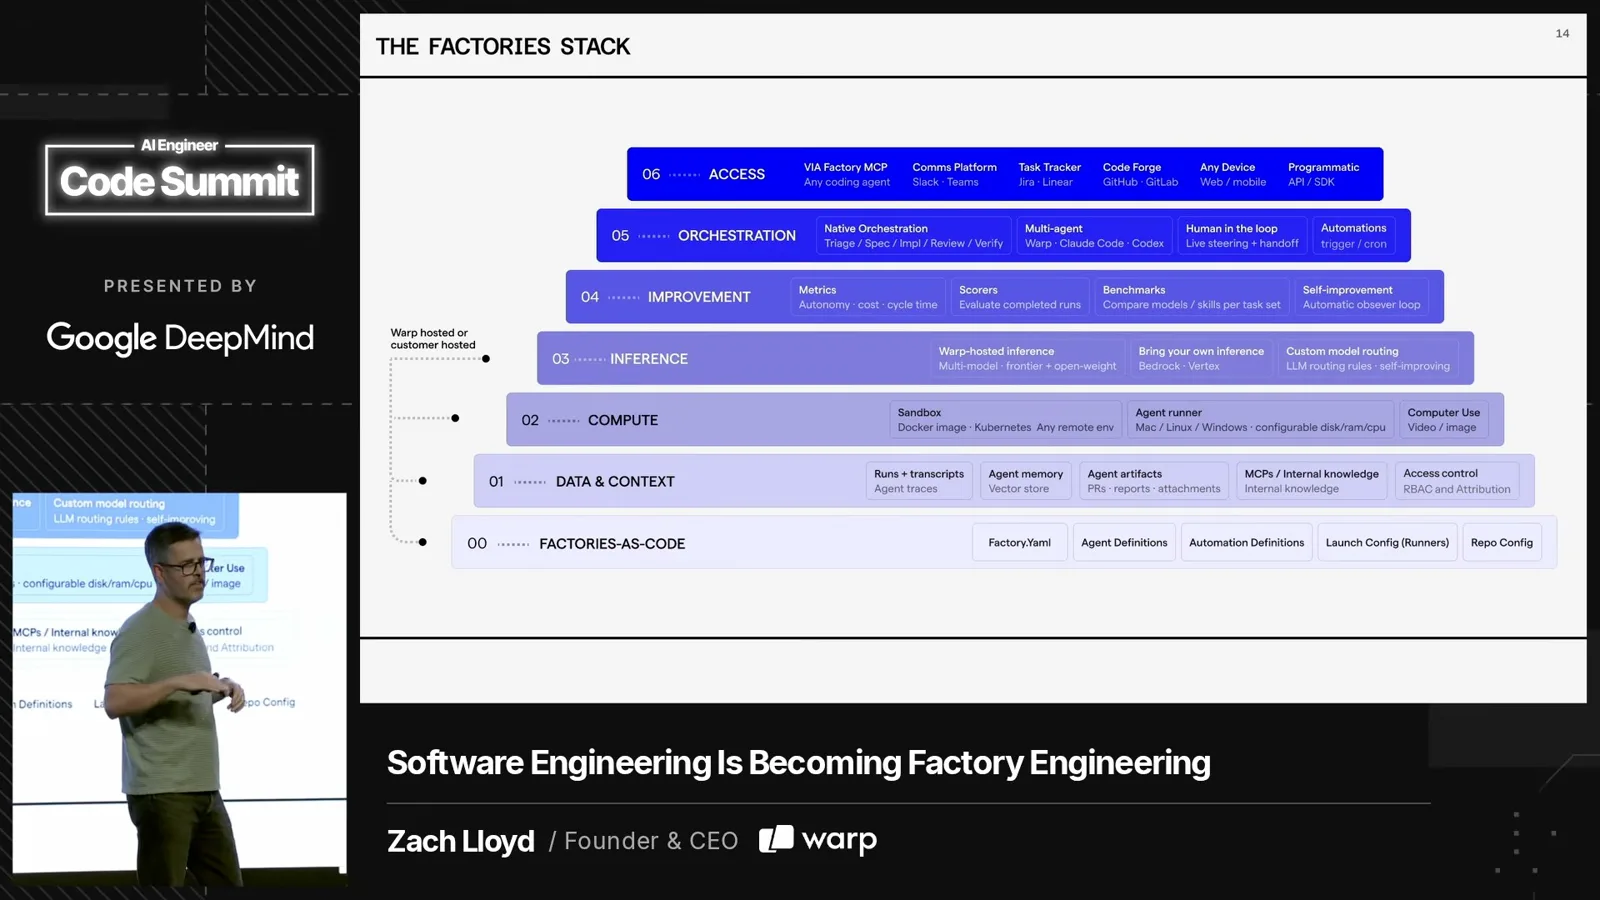
基础设施架构的底层是用代码编写的工厂定义。这样可以创建分支、测试其他配置并回滚,也让编码智能体能够对工厂的运行方式提出改动建议。
再往上是数据和上下文。当智能体在整个组织内运行时,要记录它们的对话和产物,包括视频和截图。这些记录是逐步改进工厂的原始材料。
计算层需要沙箱:隔离执行可以提高安全性和可重复性,也可能需要支持多个平台。再往上一层,模型选择应当是可以测试的变量。系统应该支持多种模型和编码智能体运行框架,因为它们各有不同的特性,团队也可能自行构建框架。
编排层负责让工作在工厂中流转。系统还应该能通过 API 和 Model Context Protocol 访问,让其他智能体也能使用它,并连接到人们开展工作的工具,例如问题跟踪、聊天和代码仓库。
查看并测量每次运行
演示展示了代码定义的配置和智能体工作的共享视图。指标与在线评估有助于发现冗余测试等重复出现的问题。
在 Warp 的演示中,工厂配置描述了策略、仓库、触发条件,以及让工作经过各阶段的流程蓝图。工厂中的其他组件也都有代码定义。即便团队自己构建系统,思路也是一样的。
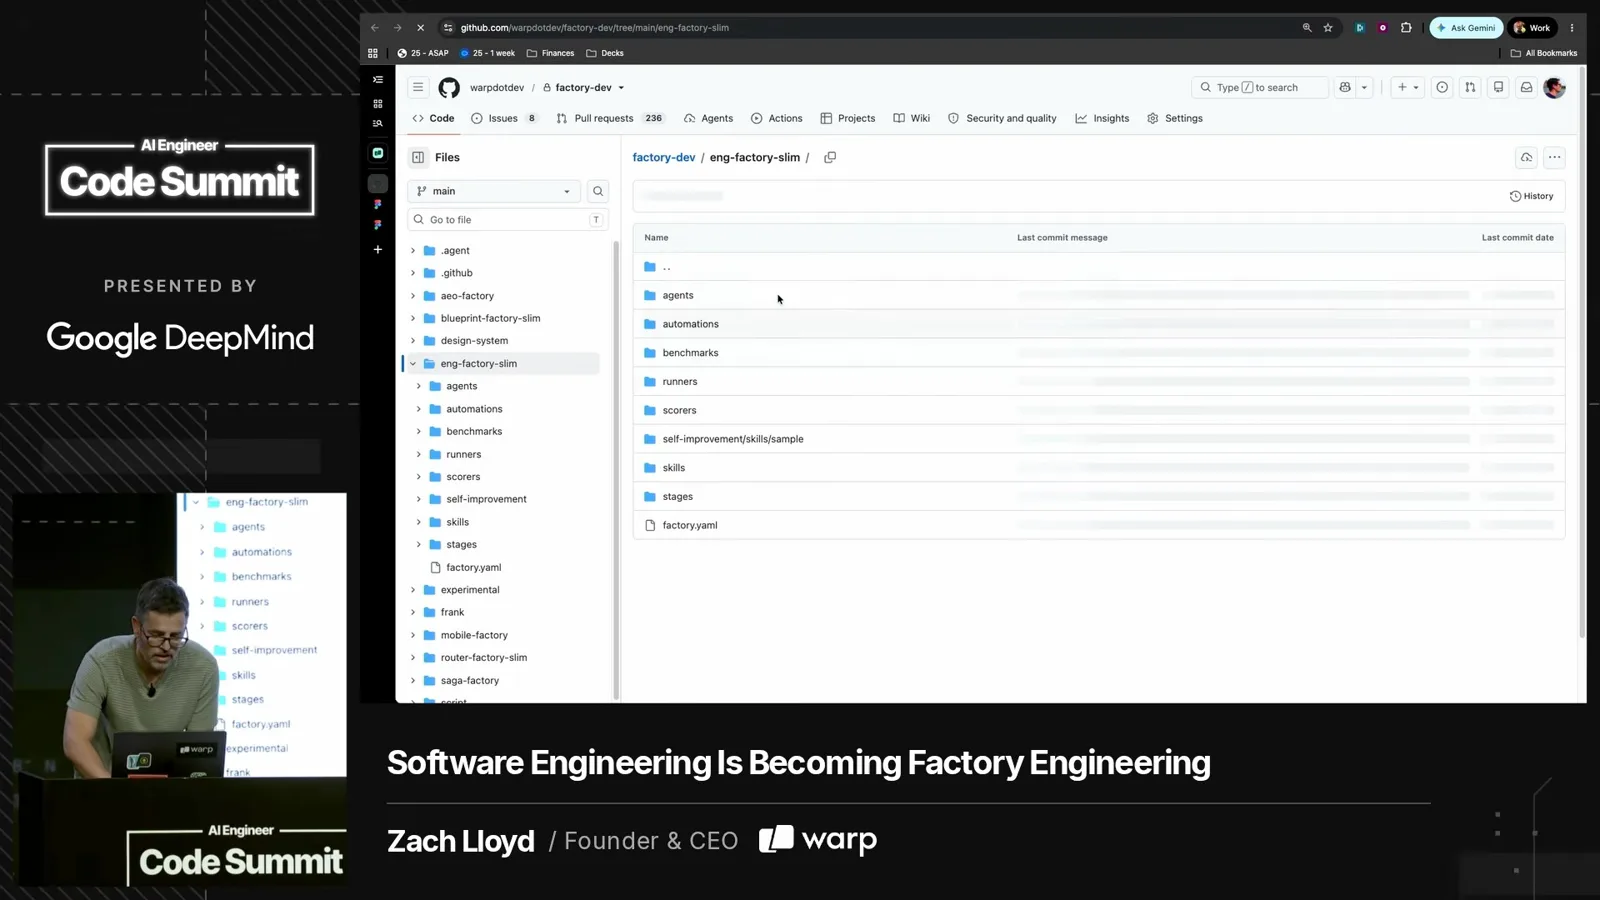
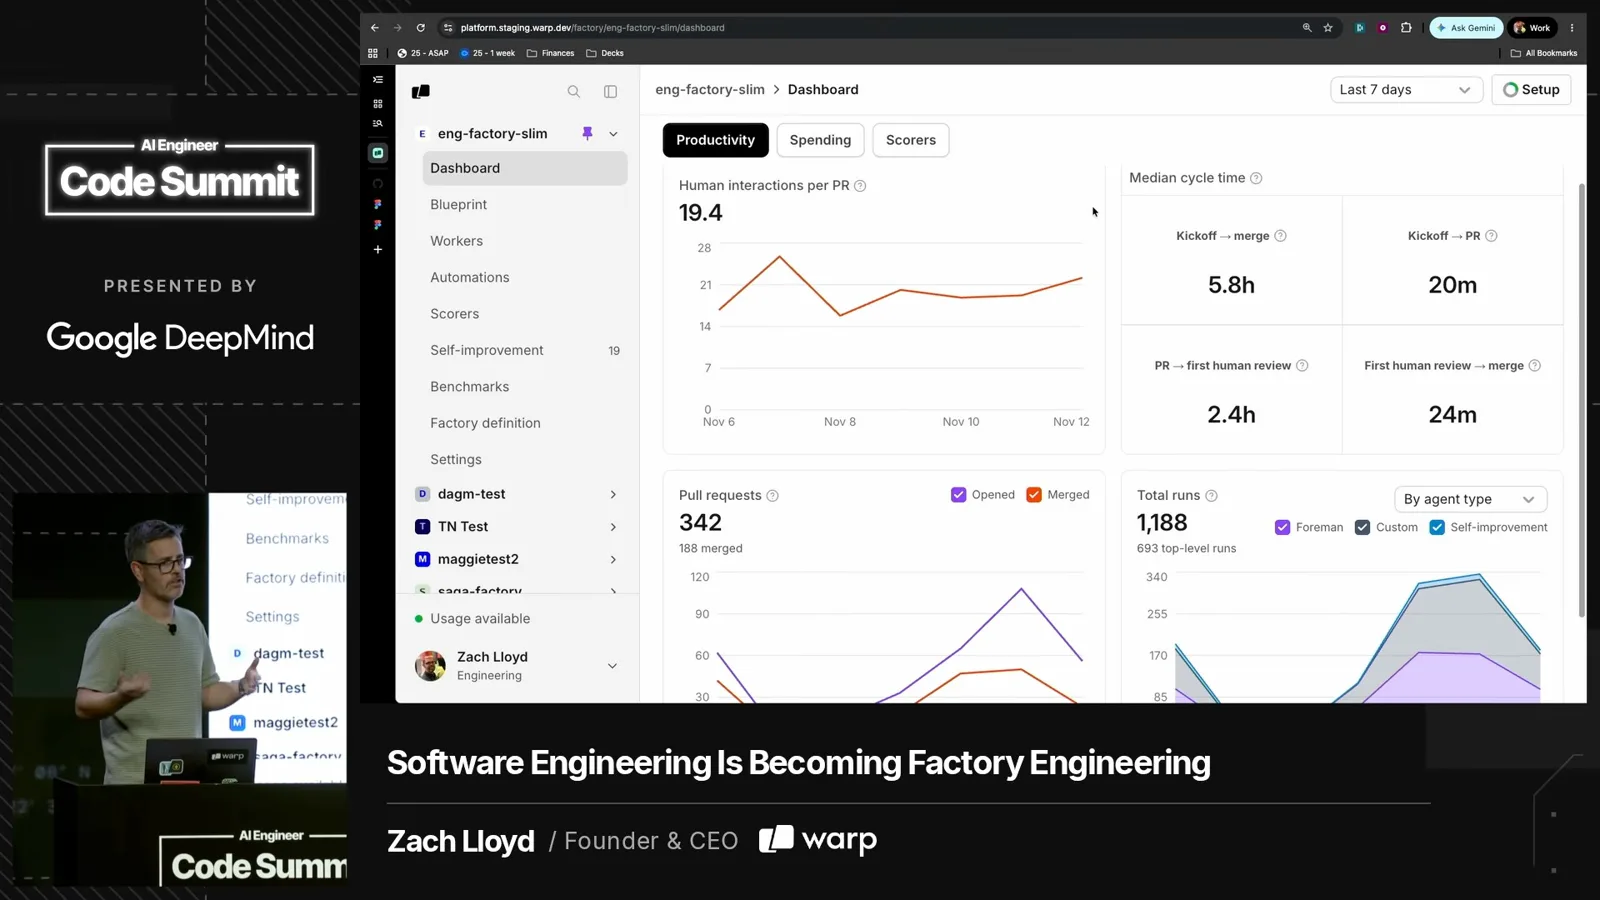
共享的实时视图展示团队各处的智能体正在做什么。我可以打开某次运行,查看它从哪里发起、对话内容以及生成的产物。重要的不只是实时观看,还要保存这些信息来改进系统。
运行数据集中存储后,团队就可以查看周期时间、吞吐量、成本和每个拉取请求中的人工交互次数。没有这些信息,就很难知道工作流的自动化程度以及资源花在了哪里。
在线评估又增加了一个层次。智能体会话运行并记录输出时,另一个智能体可以按选定维度检查和评分。我们使用的一项评估会寻找冗余测试:编码智能体有时会编写不必要的测试,这是一种常见的失败模式。
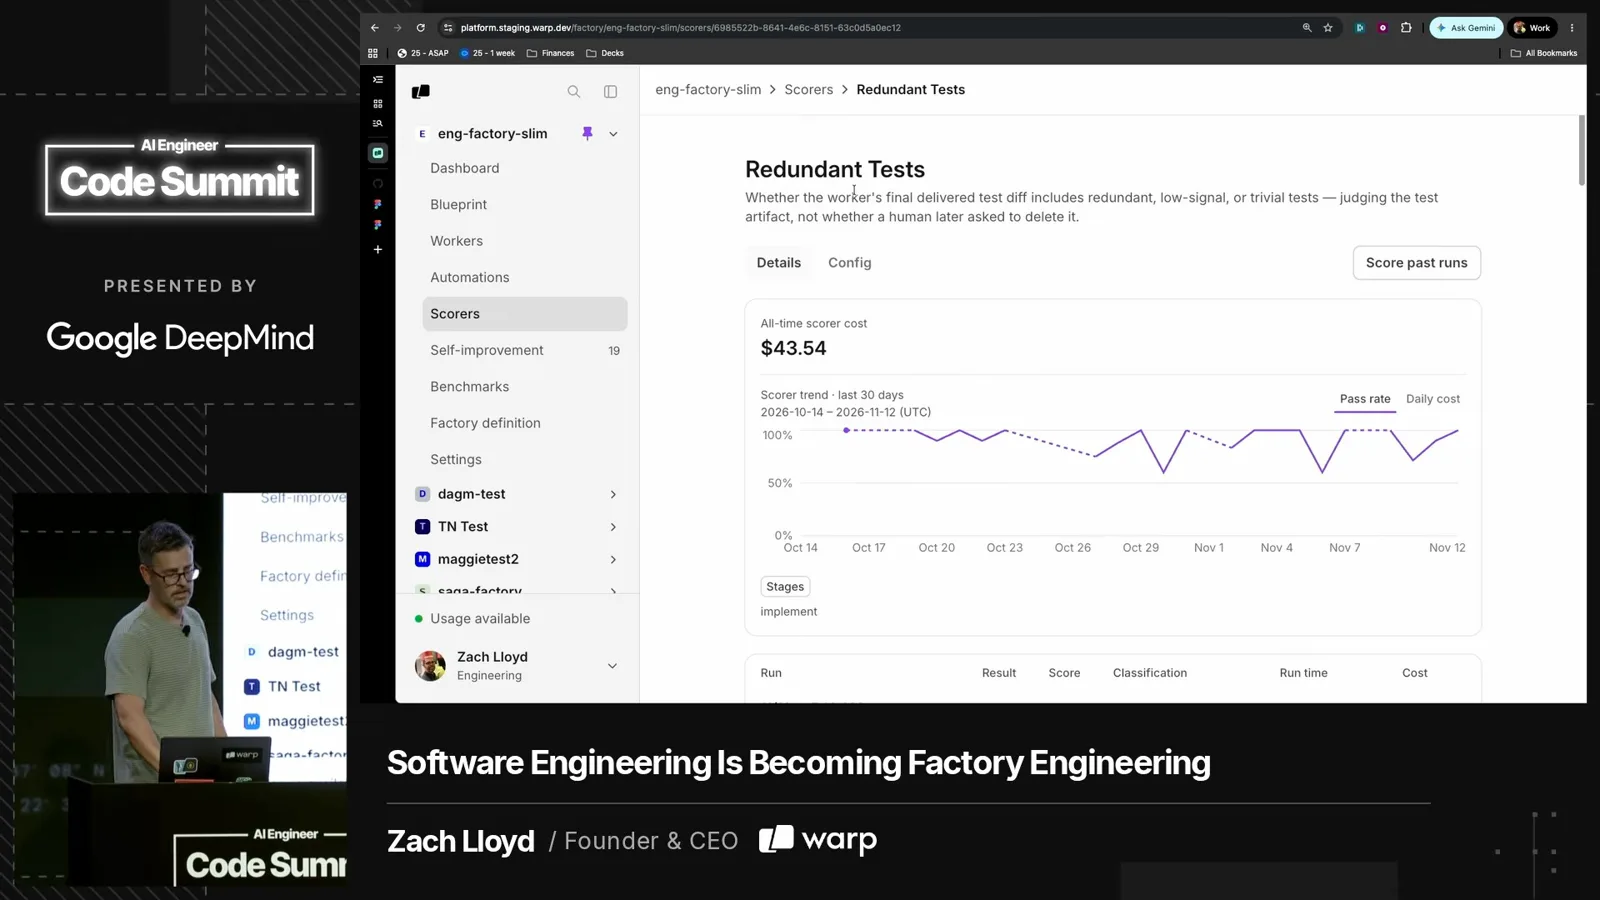
接下来要问的是,为什么会写出不需要的测试,以及能否改变工厂来减少这类情况。记录每次运行,查看它处于工作流的哪个阶段,收集输出,再用评估寻找改进机会。
利用失败的运行改进和评测系统
智能体分析评估失败后,可以提出工作流改动。团队也可以重跑自己的任务,比较模型、运行框架和其他配置。
我们把下一步称为自我改进。无需由人逐一检查评分,智能体可以查看失败的运行,寻找反复出现的规律,再提出可能的解决方案。它会针对工厂定义提交一个拉取请求,呈现这一方案。
另一个必要工具是由自己真实任务组成的基准测试。公开讨论经常宣称某个新模型、技能或智能体运行框架最好,但要回答哪种方案最适合自己的工作,需要重跑有代表性的任务并比较结果。
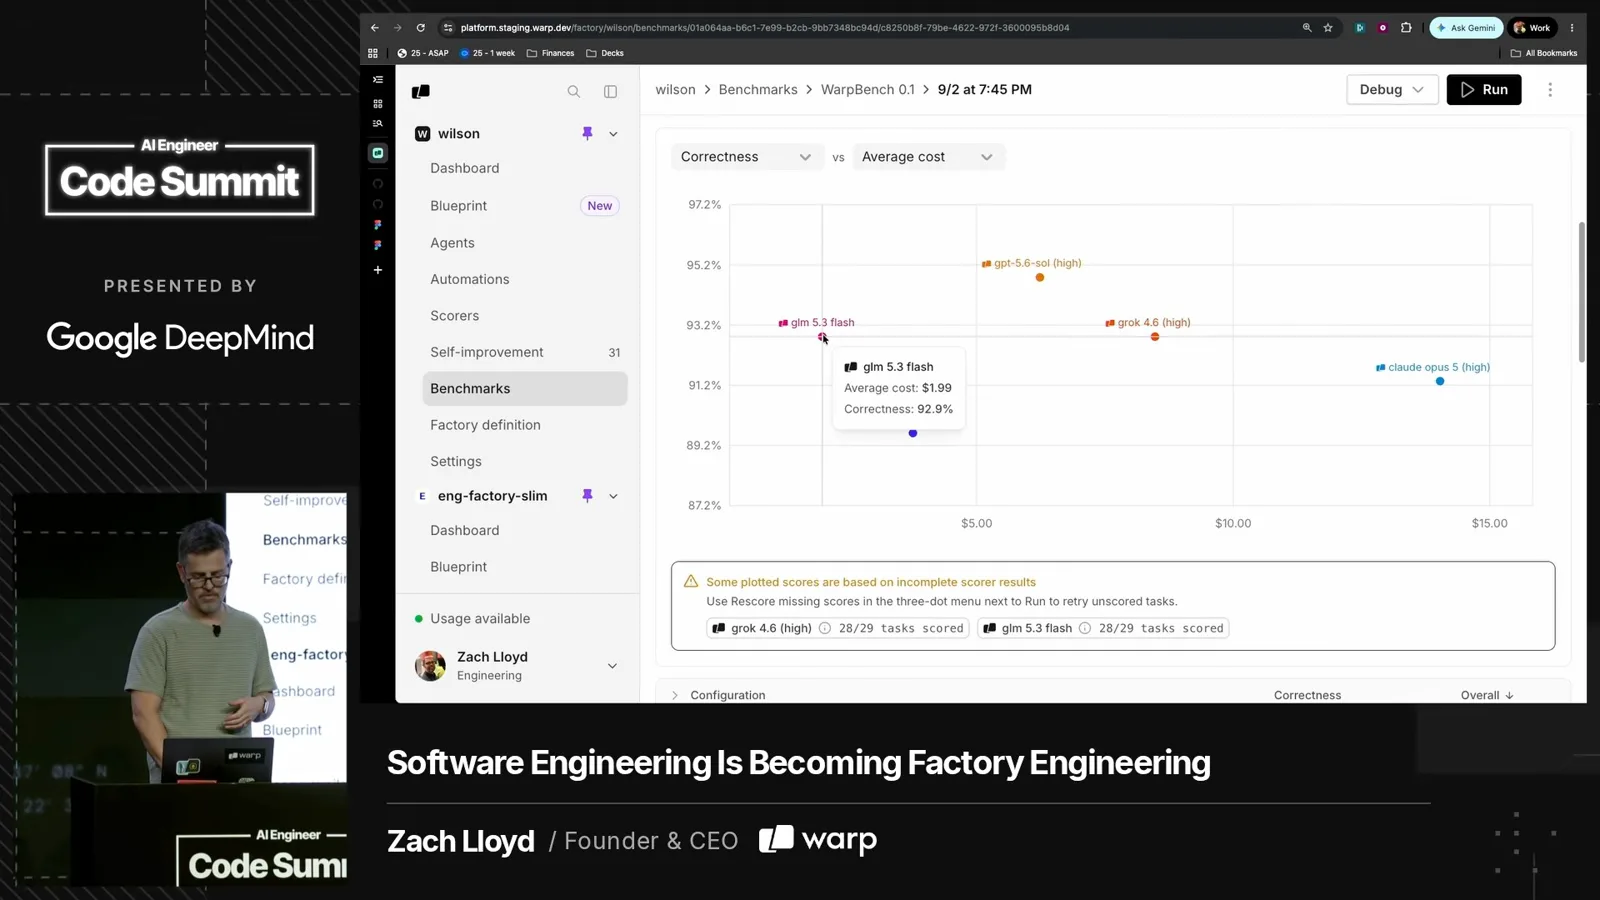
在不同模型、运行框架或工厂配置下运行相同任务,比较质量和成本之间的取舍。你也可以测试,去掉某项技能后,工厂的表现是变好了还是变差了。
Lloyd 说,Warp 运用这个过程提高了吞吐量、降低了成本:建立基线、为运行评分、开展基准测试并反复测试改动。他最后建议围绕智能体设计工程系统,同时继续运用工程技能解决产品问题。
同频道的其他文章
 56:08EN → 简体中文
 AI Engineer· 2026年11月21日Ahmad Osman:本地 AI 需要更好的系统Ahmad Osman · OsmanticOsmantic 创始人解释硬件、工具和针对任务的测试如何决定本地 AI 是否实用。
 14:28EN → 简体中文AI Engineer· 2026年11月20日Zach Bruggeman:Ramp 如何让编码智能体成为团队共用工具Zach Bruggeman · RampRamp 向同事公开智能体的工作会话,让经验得以传播,也为代码审查提供验证依据。
 19:08EN → 简体中文AI Engineer· 2026年11月19日Thariq Shihipar:在 AI 编写的软件中保留人能读懂的一层Thariq Shihipar · Anthropic他在格斗游戏中保留可读、可编辑的规则,让智能体处理底层引擎。
 22:25EN → 简体中文AI Engineer· 2026年11月19日Fabian Hedin:Lovable 如何让编程智能体持续工作数小时Fabian Hedin · LovableLovable 将智能体历史与执行过程分开,为工作中的计算机保存检查点,并把验证结果反馈给任务。
 17:50EN → 简体中文AI Engineer· 2026年11月18日Melvin Johnson:训练编程智能体解决问题,而不是钻测试空子Melvin Johnson · Google DeepMindGoogle DeepMind 后训练负责人介绍更难的任务、代码审查式评分和对诚实报告的奖励。
 14:07EN → 简体中文AI Engineer· 2026年11月18日Walden Yan:建立让编程智能体持续工作的反馈循环Walden Yan · CognitionCognition 报告称,通过让智能体能够测试代码并承担长期目标,合并的变更数量增长了 40 倍。