30 秒看懂
Lovable 联合创始人兼首席技术官 Fabian Hedin 说,公司曾在模型能力不足时构建多智能体系统,险些失败。现在智能体能工作数小时:只追加的任务历史让进程在部署后继续执行,计算机检查点则保存运行环境,降低并行草稿的成本。Hedin 认为,验证既要涵盖即时构建和浏览器检查,也要纳入访问者行为、交易等后续信号。
- 1早期多智能体框架让 Lovable 的产品变差Hedin 说,团队在 2023 年押注复杂智能体后几乎耗尽资金,回归更简单的模型工作流后才恢复。
- 2收件箱让人、其他智能体和定时任务联系运行中的智能体消息先进入独立收件箱,智能体在步骤之间将其复制到任务历史中。
- 3可分叉的事件日志为并行智能体保留历史每个事件指向前一个事件。同一份历史可以生成不同提示,执行进程则能独立重启。
- 4保存后的计算机约 230 毫秒即可恢复Hedin 说,共享检查点包含磁盘、内存和进程;项目专属快照让工作得以快速暂停和恢复。
- 5写时复制内存降低并行草稿的成本分叉共享未修改的内存页,只有草稿写入时才分配副本。
- 6Rust 开发服务器缩短预览启动时间Lovable 将 Vite 重写为 OJ;Hedin 表示冷启动更快,内存占用也更低。
- 7智能体需要即时检查,也需要后续产品反馈构建错误和浏览器检查提供即时反馈;用户行为与转化情况可以指导之后的轮次。
要点建议
- 将持久化的任务历史与运行智能体的进程分开,让工作跨部署继续。
- 保留完整事件日志,并据此为不同模型生成提示,而不是把提示当作唯一记录。
- 为工作环境保存检查点,在并行探索方案时共享未变化的内存。
- 让智能体在当前轮次获得即时检查结果,并在轮次之间获得产品或业务反馈。
- Hedin 说,Lovable 早期的多智能体尝试让产品变差,之后才重新采用这一方案。
按章节阅读整理后的全文
第一个多智能体系统为何失败
Hedin 说,团队在模型尚未准备好时引入复杂智能体。回归更简单的系统后,产品重新变得响应迅速且可靠。
我是 Lovable 联合创始人兼首席技术官 Fabian。过去几年,我们一直在构建一个让人们创建、部署和运营软件的平台。我们与智能体的关系有些复杂:2023 年,我们相信智能体是未来,于是立刻为那个未来构建产品。
这差点让公司倒闭。GPT-4 时代的模型还没有足够的智能来支撑我们想要的复杂智能体系统。现在,我认为它们已能支持更复杂的系统。
我们的第一款产品 GPT Engineer 将聊天窗口放在应用预览旁边。每条用户消息触发一次模型调用,足以构建简单的单页应用。我们预期模型会迅速进步,于是构建了复杂得多的智能体框架。
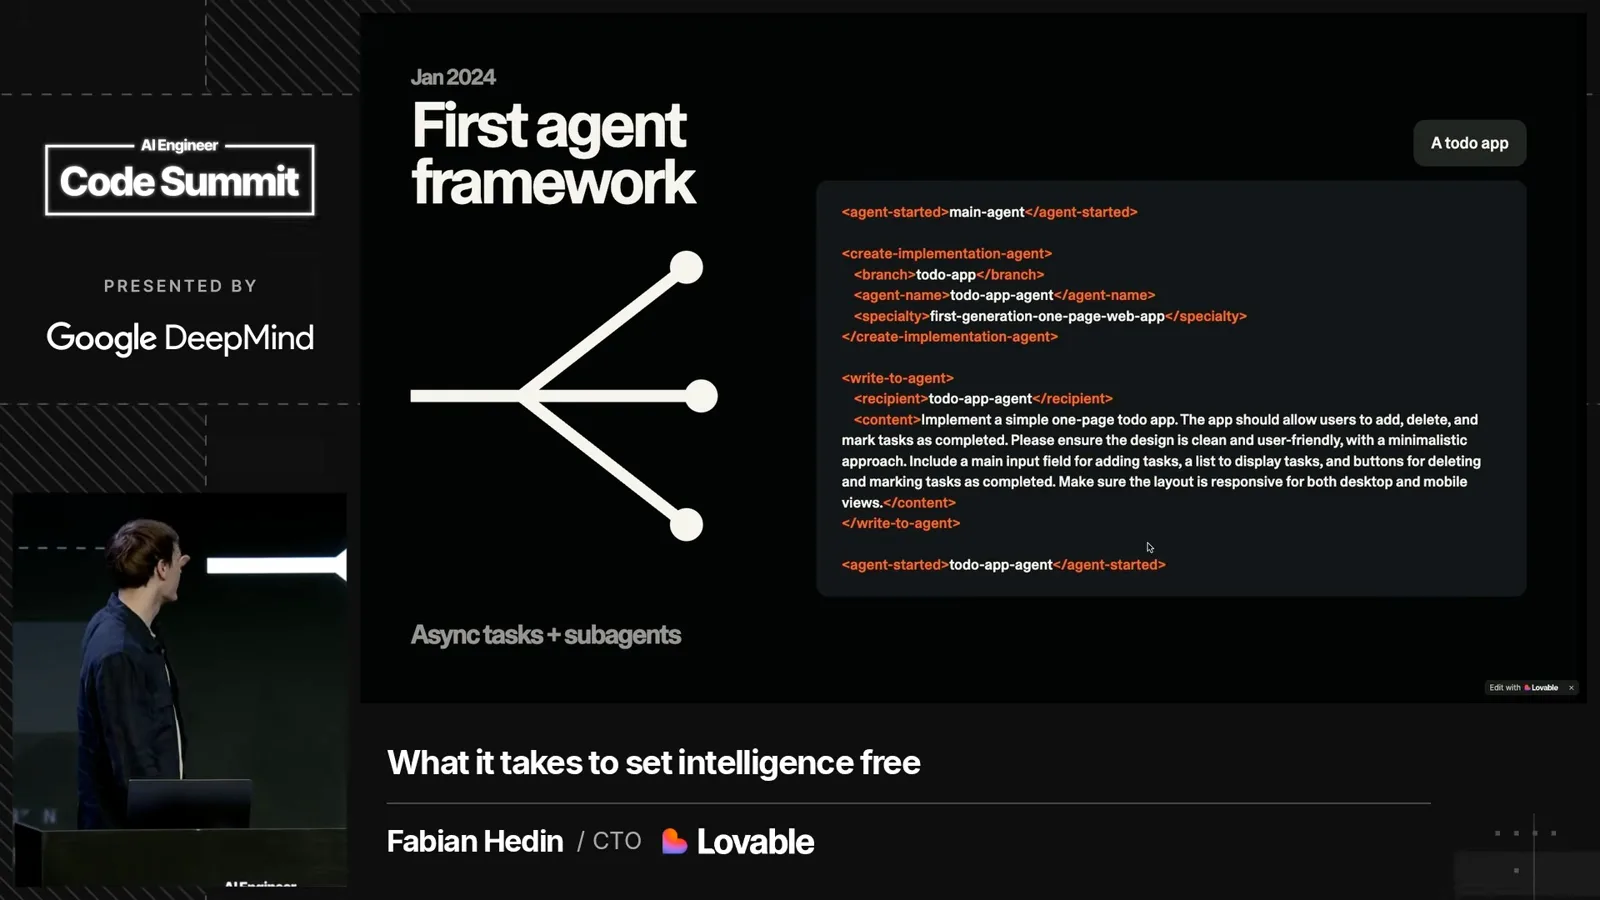
主智能体与用户交谈,并生成实现、前端和后端等专门智能体。它们互相发送消息,但这个设计在实践中行不通:它让产品变差了。在资金耗尽之前,我们回到了更简单的方案。
2024 年底,我们用小模型检索知识,再由一个主模型回复并编写代码。产品响应迅速、运行可靠,用户可以与它密切迭代。现在智能体再次为我们工作,生产系统每分钟处理超过十亿个 token。
Lovable 将业务视为最终成果
产品结合了编程智能体、托管和业务能力。Hedin 说,目标是可用的产品,而不只是代码。
Lovable 仍然在左侧展示聊天窗口,右侧展示结果预览。用户如今可以在这个抽象层次上构建复杂得多的产品。开发者也逐渐转向这样的界面:少看代码,多考虑架构和成果。
用户关心的成果是能够创造价值的产品或业务,而不是代码本身。编程智能体可以使用浏览器检查构建的内容,连接 GitHub,并编写用户可以带走的代码。
我们还向智能体提供云能力,包括数据库、身份验证、存储、后端计算、安全扫描、备份和日志。智能体能直接检查这些内容,用户不必手动组合各种服务。除了托管,我们还支持支付、邮件、搜索优化、广告和分析,让智能体帮助经营软件背后的业务。
收件箱和事件历史支持长期运行的智能体
消息与可分叉的任务日志让智能体接收输入并共享历史。提示从这份记录中生成。
我们曾把智能体的工作时间限制在 30 分钟,因为不相信更长时间的运行足够可靠。现在这个限制取消了,智能体可以工作十小时甚至更久。为此,我们关注运行时、执行工作的计算机,以及验证行动所需的反馈。
每个智能体都有收件箱。人、其他智能体或定时系统都可以向其中发送消息,比如询问进度。智能体在行动之间可以将消息复制到自己的任务历史,也就是我们称为轨迹的记录中。
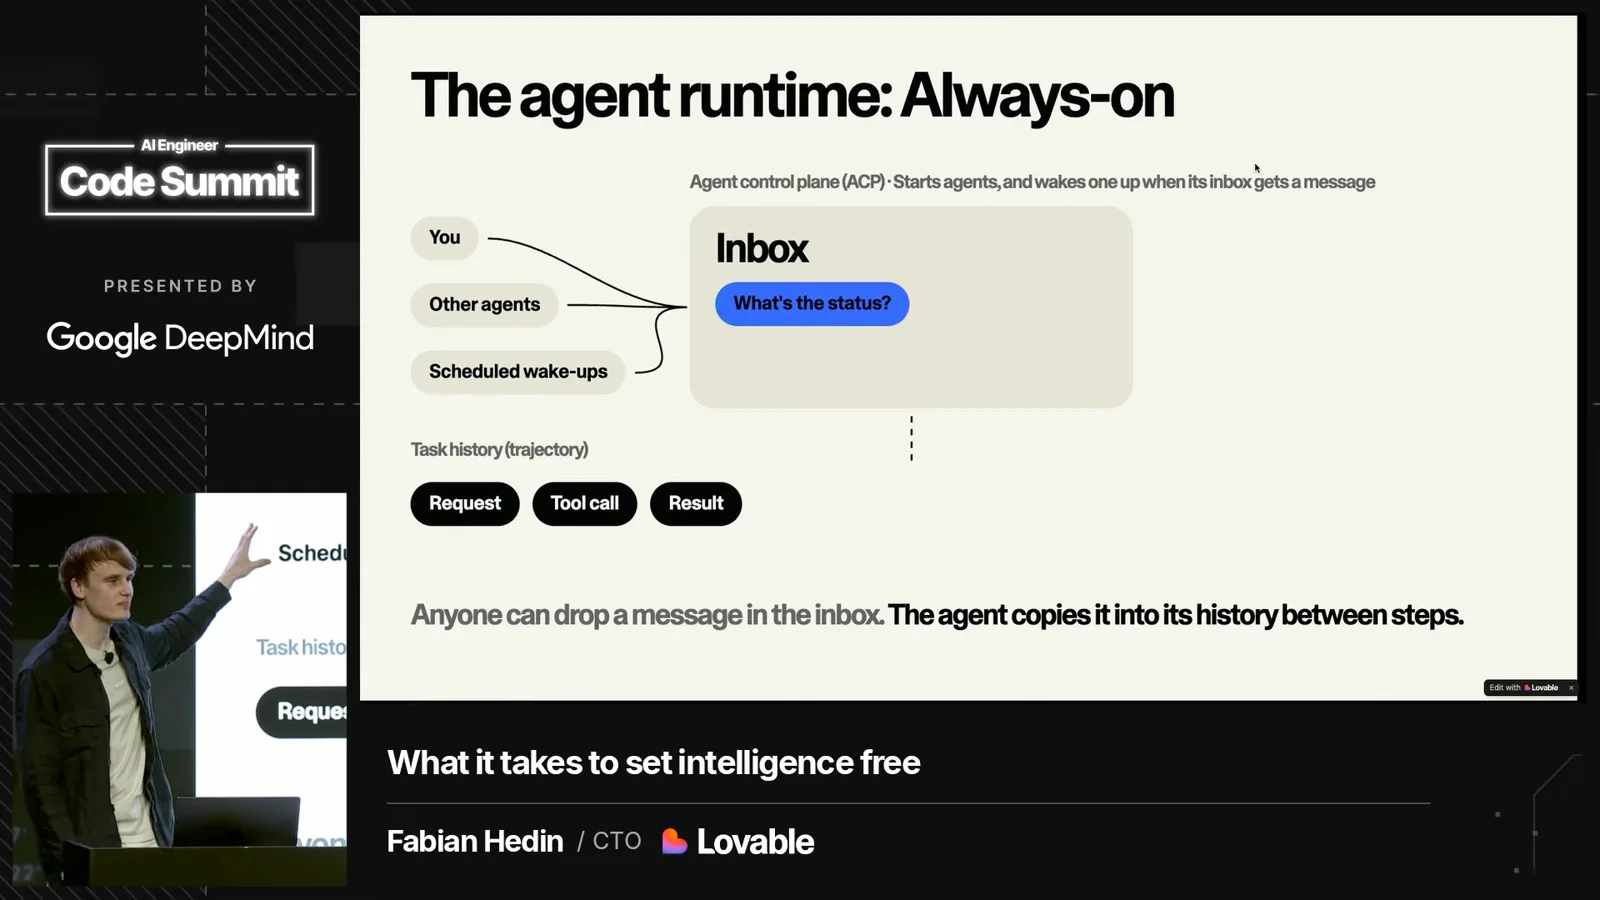
任务历史也是记忆的基础。受 Git 启发,它是一份只追加的日志:每个事件指向前一个事件。两个事件可以指向同一个父事件,让并行智能体从共同历史分支,无需复制全部记录。与 Git 不同,我们不合并这些轨迹;智能体可以通过通信协作。
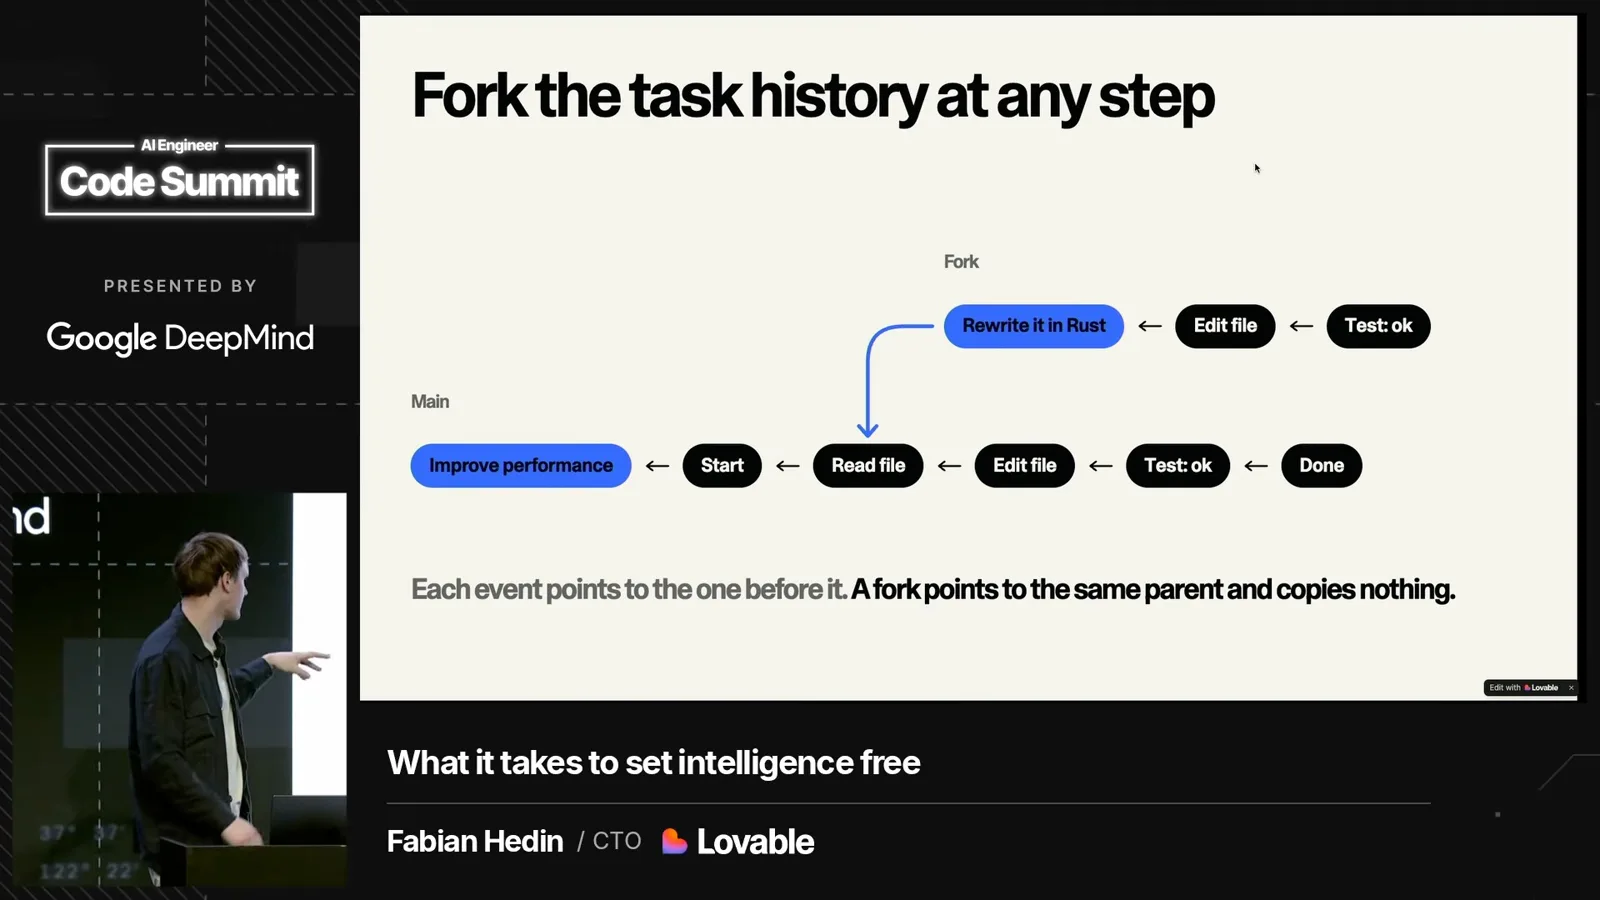
日志记录所有事件,包括工具调用及其成功或失败的结果。然后我们根据历史构建实际交给模型的提示。分开这两者很重要,因为不同模型的上下文长度不同,可能需要在不同时间总结早期事件。
我们的调试工具可以通过滑动条浏览记录的事件,重现每个时间点的用户界面。保留完整事件历史,让我们能够控制如何呈现任务状态。
进程更替时智能体任务继续
任务历史与执行进程分离,让部署无需中断长任务。更新后的进程可以接着执行同一任务。
运行智能体的进程与历史分开。系统在调用和轮次之间持久化工作状态,因此一个进程退出后,另一个进程可以继续任务。这很有用,因为 Lovable 每天部署约 700 次,平均每两分钟一次。
客户的智能体可能要工作十小时,而我们可能需要发布新功能或修复严重的安全问题。将任务历史与执行分离,同一任务就能在更新后的进程中继续,而不必在每次部署时中断。
第二部分是智能体执行工作的计算机:它在上面运行开发服务器并验证结果。尝试多种沙箱方案后,我们构建了一套为整台计算机保存检查点的系统。
保存检查点的计算机快速恢复和分叉
预先准备的检查点为项目提供环境。写时复制内存和流式加载降低了并行草稿的成本。
新项目从一个预先准备的黄金检查点启动,其中包含操作系统、服务、常用工具和准备就绪的开发服务器。检查点涵盖磁盘、内存和运行中的进程。Hedin 说,复制这一状态约需 230 毫秒。
项目积累了代码和依赖后,其计算机也会保存检查点,包括每次智能体轮次结束时。闲置后我们可以关闭计算机以节省资源,需要时在不到一秒内恢复。Hedin 说,这套方案不会丢弃传输中的请求。
同样的机制不仅能分叉智能体历史,也能分叉计算机。Lovable 用它提供草稿:不同环境让智能体探索项目的不同版本。要让大量副本变得可行,我们需要优化。
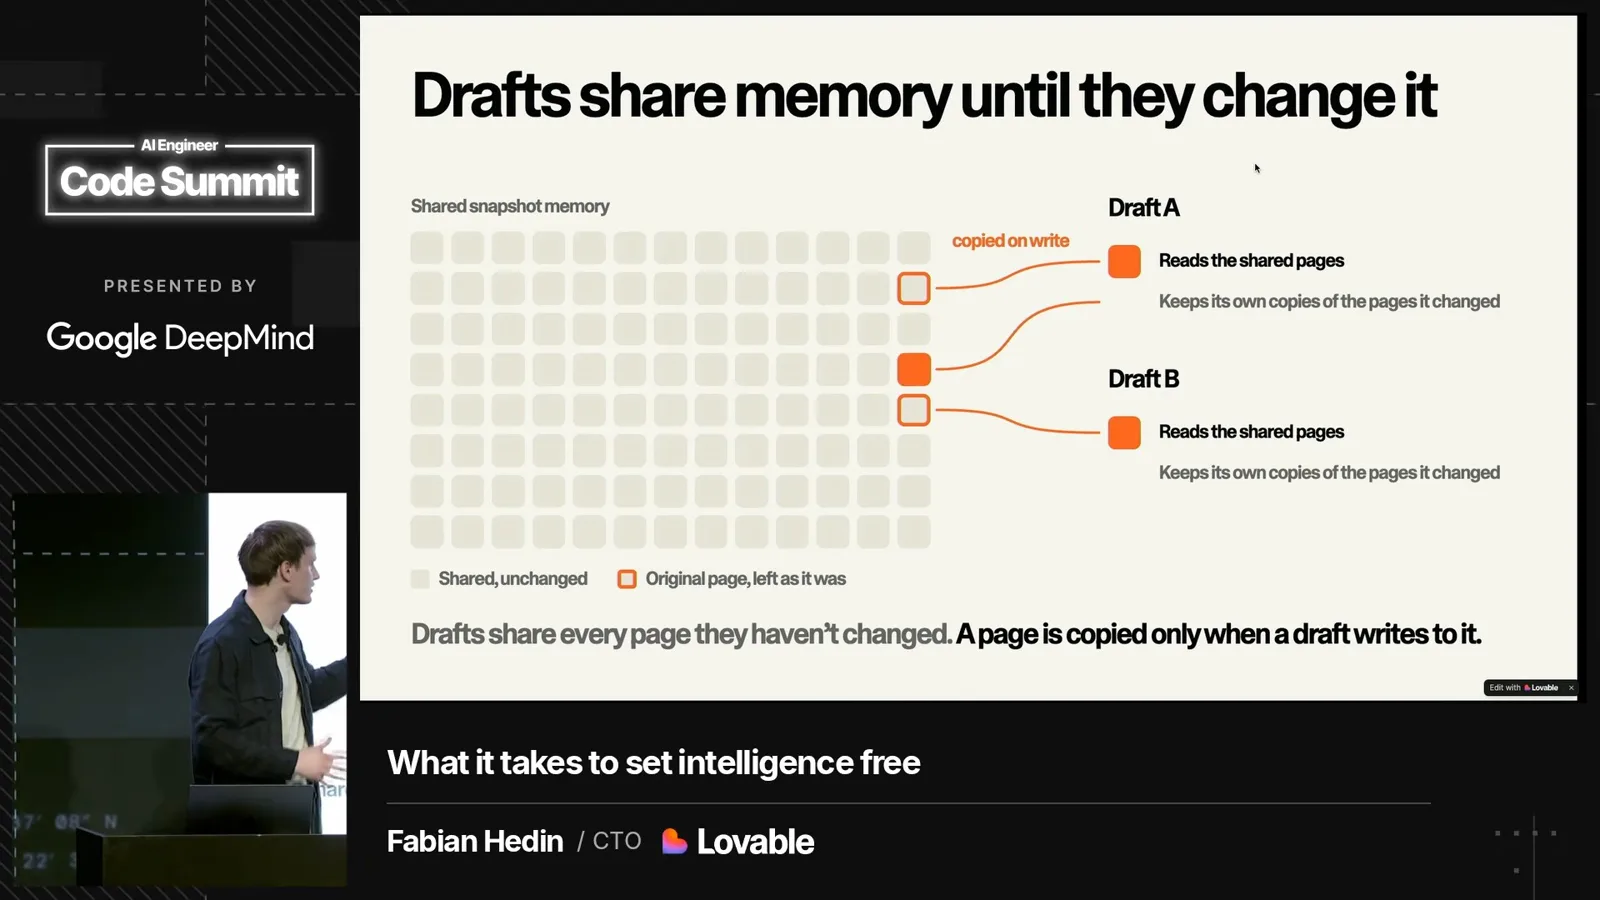
其中一项是内存的写时复制。分叉最初共享相同的内存页,因此创建分支几乎不额外占用 RAM。当进程写入某个页面时,系统才复制该页面,并为修改后的版本分配内存。
一个沙箱需要数百兆字节内存,从冷对象存储读取可能需要数秒。我们改用流式加载:不必等所有页面到齐就启动机器,先向操作系统提供必需内容,其他进程所需的内存随后到达。
重写开发服务器加快预览
Lovable 用 Rust 将 Vite 重写为 OJ。Hedin 表示启动更快、内存占用更低。
我们还用 Rust 将 Vite 开发服务器重写为 OJ。Hedin 说,这使冷启动速度翻倍,并如幻灯片所示,将预览就绪时间从 14 秒缩短到 3 秒。去掉 Vite 对 Node.js 的依赖,也让机器的内存占用减少到原来的约六点五分之一。
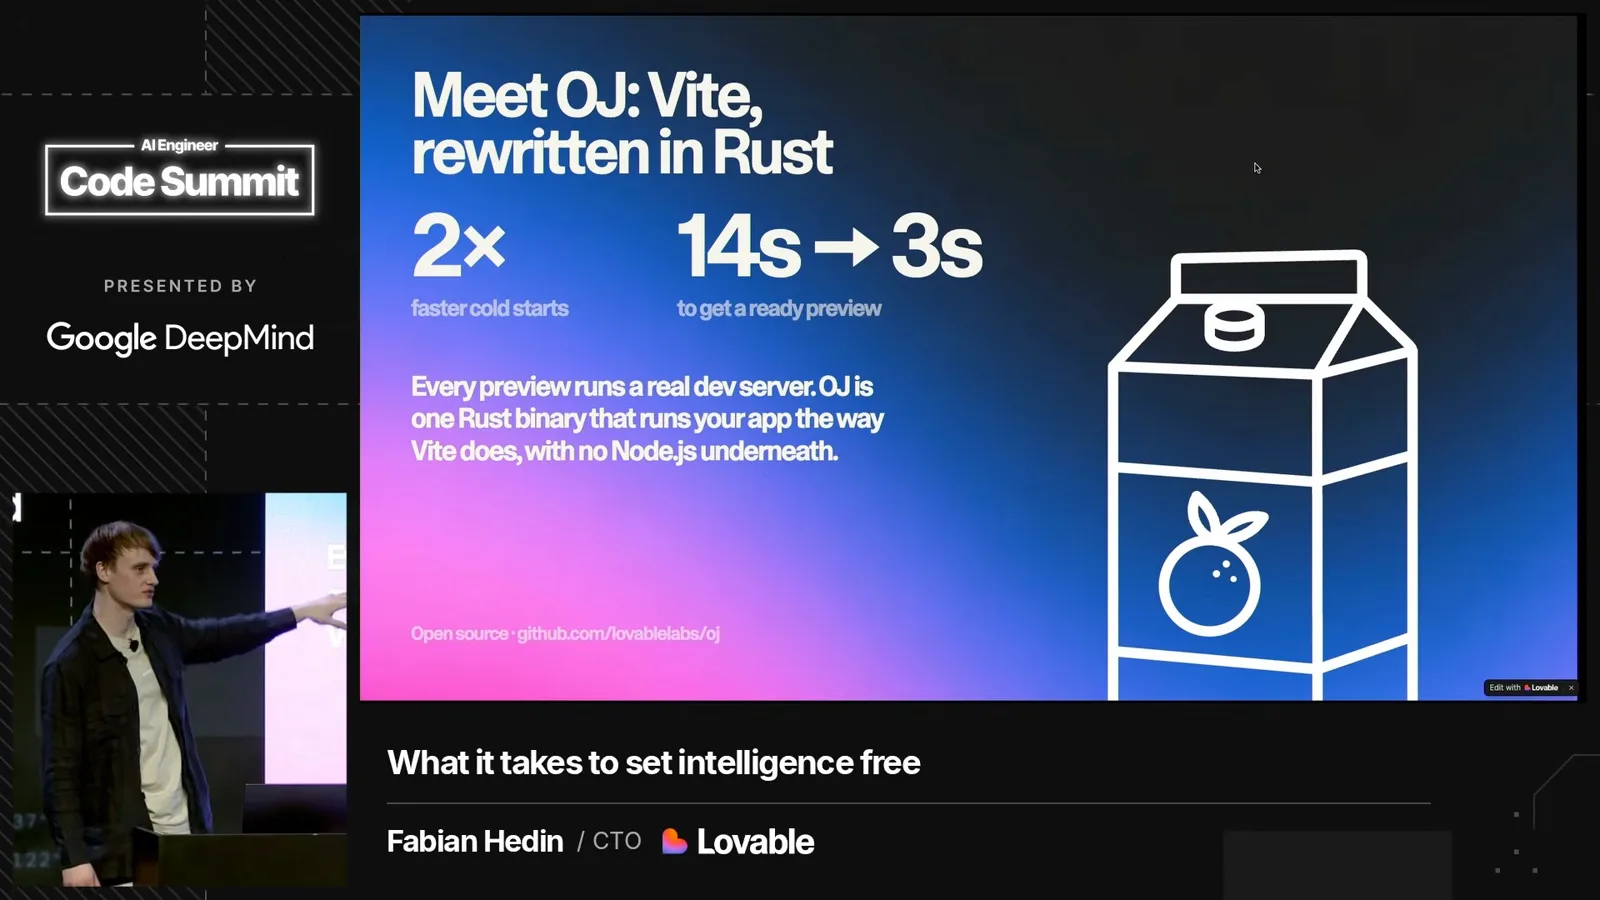
控制这些计算机中运行的应用,也让我们能够控制它们如何写入内存。这进一步提高了写时复制的效率,使大量并行智能体能够探索修复错误或改善性能的不同方案。
验证将代码检查与产品结果连接起来
即时检查帮助智能体在当前轮次修复错误。后续用户和业务信号可以指导未来工作。
最后一部分是验证。智能体需要反馈,知道一个行动是好是坏。在轮次进行中的内循环里,它可以看到构建失败、代码检查和类型错误、预览中的运行错误,以及无头浏览器探索应用的结果。
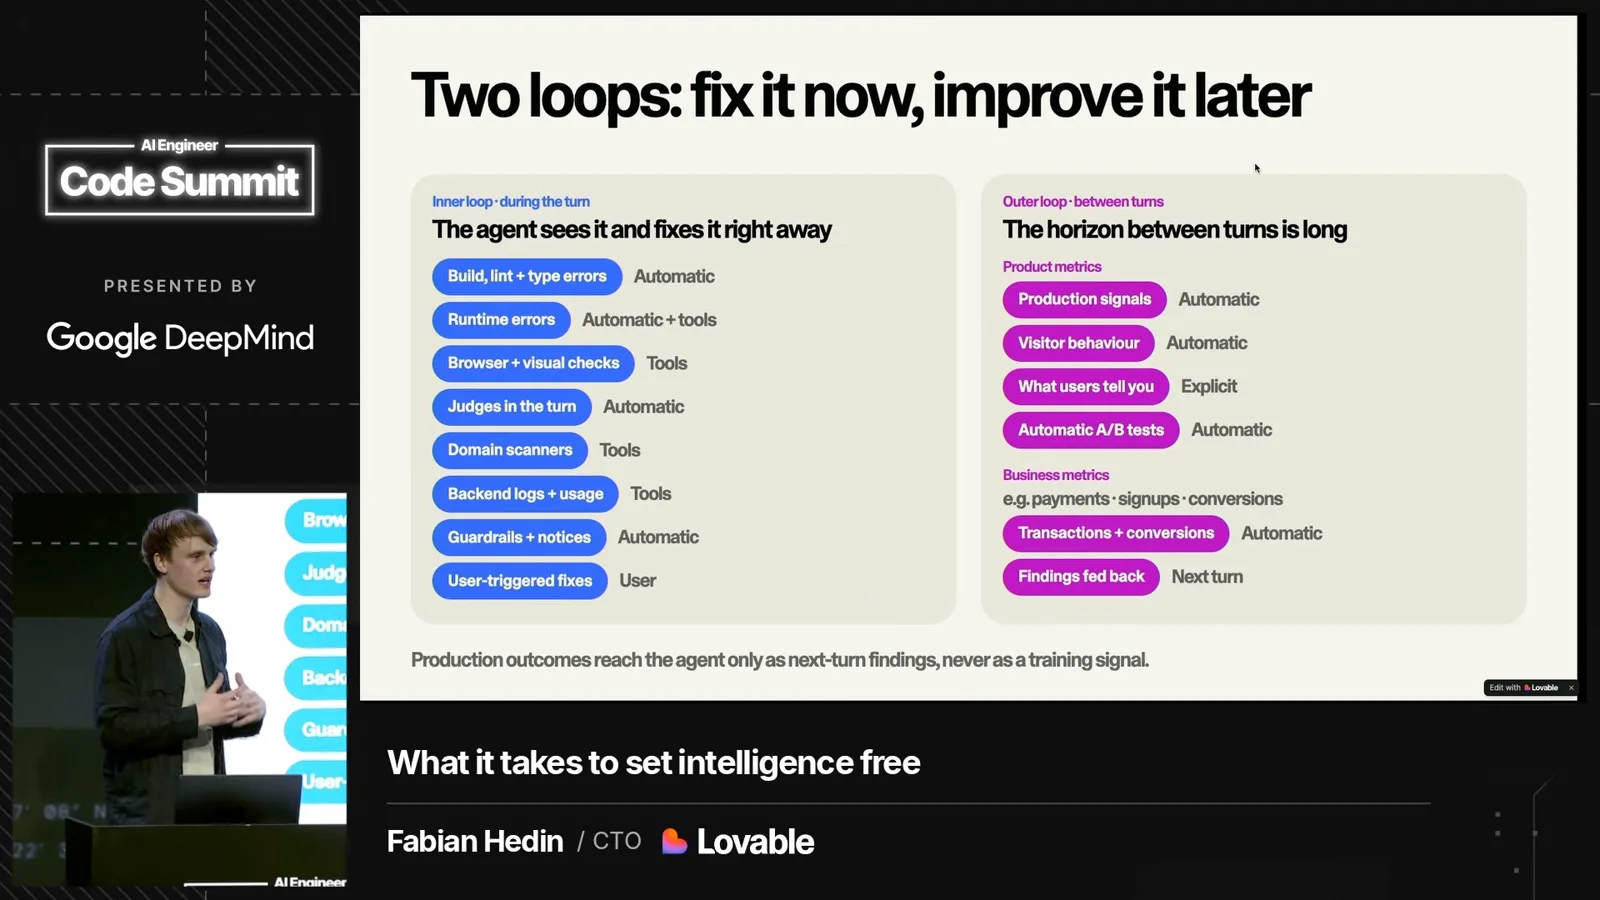
轮次之间还有外循环,这时智能体已将控制权交给用户。生产环境信号、访问者行为和用户反馈可以显示变更后发生了什么。自动 A/B 测试可以比较文案,判断变更是否提高转化率。
由于平台也处理业务能力,智能体可以利用交易和转化信息,帮助改进代码之外的内容。这些后续发现能够指导下一轮工作,以及产品背后的业务策略。
编排、计算机和验证共同构成了我们持续建设的架构。智能体可以共享一台计算机,也可以在不同计算机上探索,并相互通信。Hedin 说,在这些基础设施优化的支持下,多智能体方案如今已能大规模运行。
同频道的其他文章
 19:08EN → 简体中文
 AI Engineer· 2026年11月19日Thariq Shihipar:在 AI 编写的软件中保留人能读懂的一层Thariq Shihipar · Anthropic他在格斗游戏中保留可读、可编辑的规则,让智能体处理底层引擎。
 17:50EN → 简体中文AI Engineer· 2026年11月18日Melvin Johnson:训练编程智能体解决问题,而不是钻测试空子Melvin Johnson · Google DeepMindGoogle DeepMind 后训练负责人介绍更难的任务、代码审查式评分和对诚实报告的奖励。
 14:07EN → 简体中文AI Engineer· 2026年11月18日Walden Yan:建立让编程智能体持续工作的反馈循环Walden Yan · CognitionCognition 报告称,通过让智能体能够测试代码并承担长期目标,合并的变更数量增长了 40 倍。
 58:03EN → 简体中文AI Engineer· 2026年11月17日Codex 如何连接上下文、云端工作与智能体委派Dominik Kundel, Charlie Guo · OpenAIOpenAI 的 Dominik Kundel 和 Charlie Guo 展示如何把已连接的上下文、快速反馈和远程智能体融入实际工作。
 19:38EN → 简体中文AI Engineer· 2026年11月17日Simon Willison:AI 智能体能解决更多问题,工程工作却仍然不轻松Simon Willison · Datasette一个蜂鸣探测器、一款策略游戏和鹈鹕基准测试,展示了编程智能体如何在 2026 年改变他的工作。
 19:55EN → 简体中文AI Engineer· 2026年11月16日Brandon Thomas:用 AI 智能体开源重建创意软件Brandon Thomas · ArtCraftArtCraft 团队用约一天时间构建了一个类似 Photoshop 的初版编辑器,随后与社区一起扩展开源创意工具。