30 秒看懂
Cognition 说,一年内合并的拉取请求数量增长约 40 倍,工程团队人数增长 2.7 倍。联合创始人 Walden Yan 认为,原因不只是采用了编程智能体:团队现在端到端负责客户问题,隔离的虚拟机则让智能体测试变更并通过 Slack 返回证据。他介绍了智能体如何反复测量并改进 GPU 推理,以及如何在 44 天里以 iOS 版本为参照构建 Android 应用。这些数字是 Cognition 对自身流程的报告;合并变更数量衡量吞吐量,本身不能证明质量。
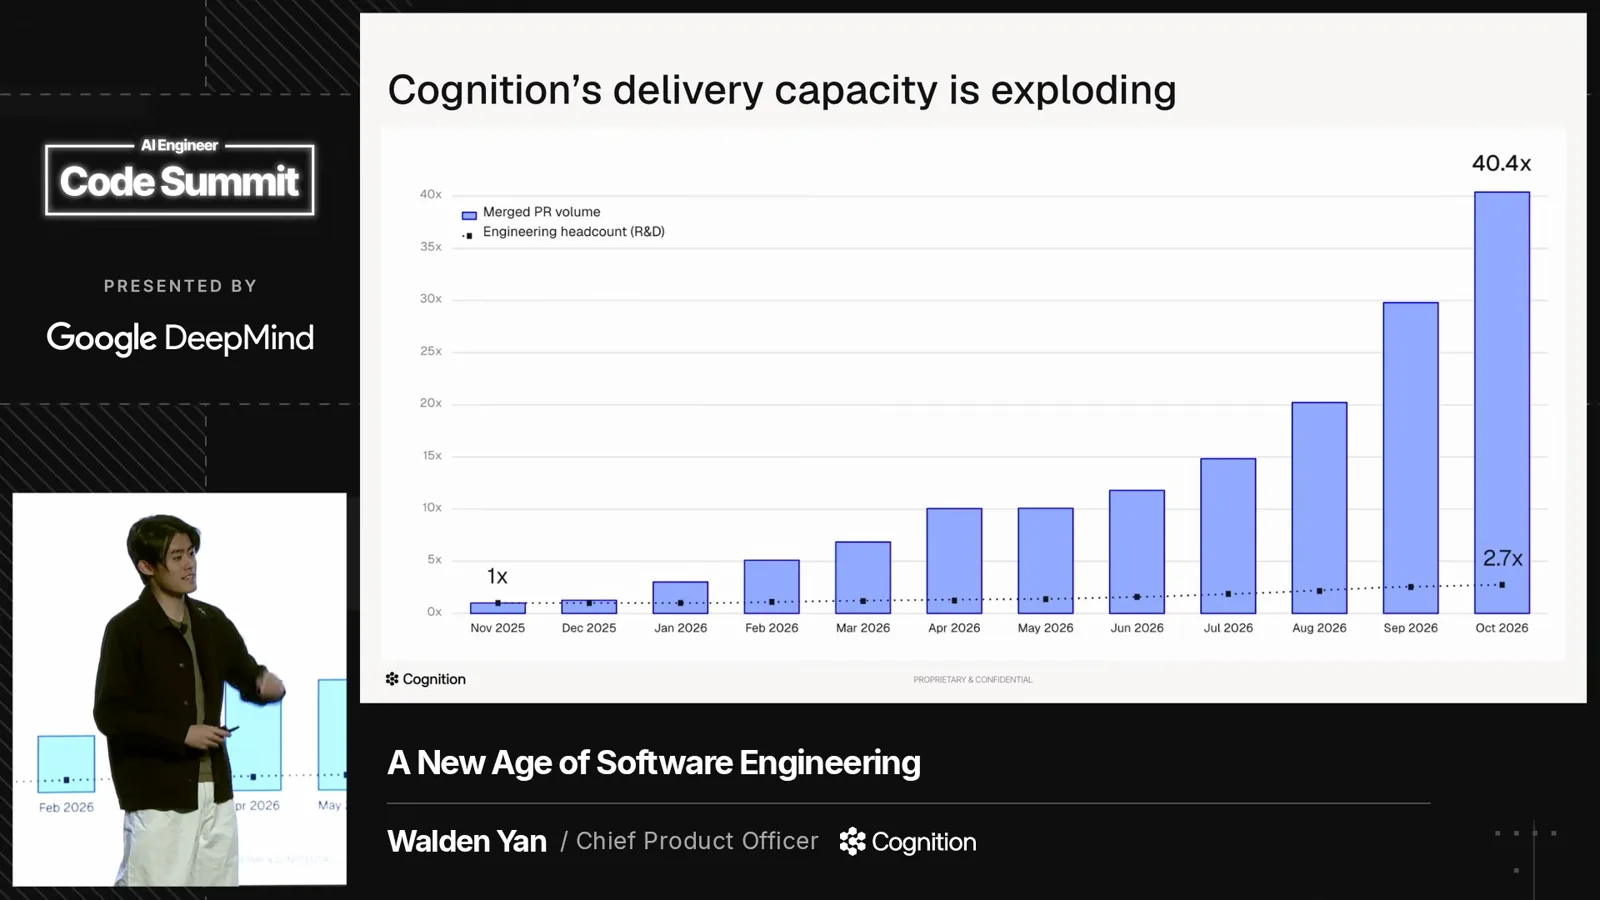
- 1合并的变更增速超过工程师人数增速Yan 说,一年内合并的拉取请求数量增长约 40 倍,工程师人数增长 2.7 倍。他认为质量保持稳定,但图表衡量的是合并变更的数量。
- 2小团队负责客户问题,而不只是实现两到三名工程师处理错误报告、产品决策和质量检查,再将描述清楚的工作交给智能体。
- 3智能体针对本地服务测试,而非依赖线上服务Cognition 将服务迁入虚拟机,模拟外部依赖,并每小时重建环境。
- 4智能体可以改进运行自身的流程一个每日更新的频道集中展示有关构建速度、测试和其他时间浪费问题的改进建议。
- 5给智能体可衡量的工作,并设置汇报与升级机制对于延迟,Yan 建议建立监测、告警和定期汇报,而不是为每个修复单独写提示词。
- 6GPU 优化结合反复试验与人工批准智能体在分配给它的 GPU 上测试吞吐量改动,将最好的方案交给工程师。
- 7Android 应用持续以 iOS 应用为参照Yan 描述了一项为期 44 天的工作,其中包括代码钩子、反馈和功能一致性检查;他说成果计划发布。
要点建议
- 在期待智能体端到端完成工作之前,先提供隔离环境和可重复的测试。
- 随着实现工作更加自动化,围绕客户问题、测试和产品决策组织工程团队。
- 把长期目标转化为测量、反复实验,以及需要人类判断时的升级节点。
- Cognition 的合并拉取请求增长是吞吐量指标;变更的质量和影响需要另行评估。
按章节阅读整理后的全文
软件工厂如何改变工程师的工作
Cognition 报告合并变更数量大幅上升。Yan 描述了默认由智能体驱动的工作流程,以及责任更广的小团队。
Cognition 一年内合并的拉取请求数量增长约 40 倍,工程师人数增长 2.7 倍。我认为这些变更的质量至少不低于以前。这是我们用合并变更数量衡量吞吐量得到的结果;重要的问题是,我们对代码库和团队做了哪些改变。
软件工厂的基本想法是默认让开发流程自行运转。在 Cognition,Devin 可以从错误报告着手,完成拉取请求合并以及后续监测;需要人类判断时再升级处理。这种默认方式改变了工程师需要做的工作。
如果工程师只是挑一张任务单,再让智能体实现,我认为这并不足以让他们取得成功。工作描述清楚后,我们可以交给 Devin。工程师需要承担更多定义和指导工作的责任。
我们把较大的团队拆成两到三名工程师组成的小组,给他们更广的责任范围和多个智能体。工程师听取客户错误报告、测试产品、做产品管理,并维护自己的工作清单,交给智能体实现。
让测试不依赖线上服务
智能体通过 Slack 接收客户报告,并返回修复证据。本地服务、模拟依赖和每小时重建的虚拟机使它们能够独立测试。
我们在整个过程中都使用 Slack。客户可以发送带视频的错误报告;我们把它转发到内部频道并标记 Devin。它提出修复方案并返回录屏作为证据,大多数时候我们无需打开编辑器或 GitHub,就能把证据分享给客户。
这一流程需要调整底层基础设施。以前测试需要连接预发布服务和数据库,再由工程师逐步点击验证。我们将服务迁入本地 Docker Compose 环境,并模拟第三方依赖,使智能体能在一台虚拟机中运行应用。
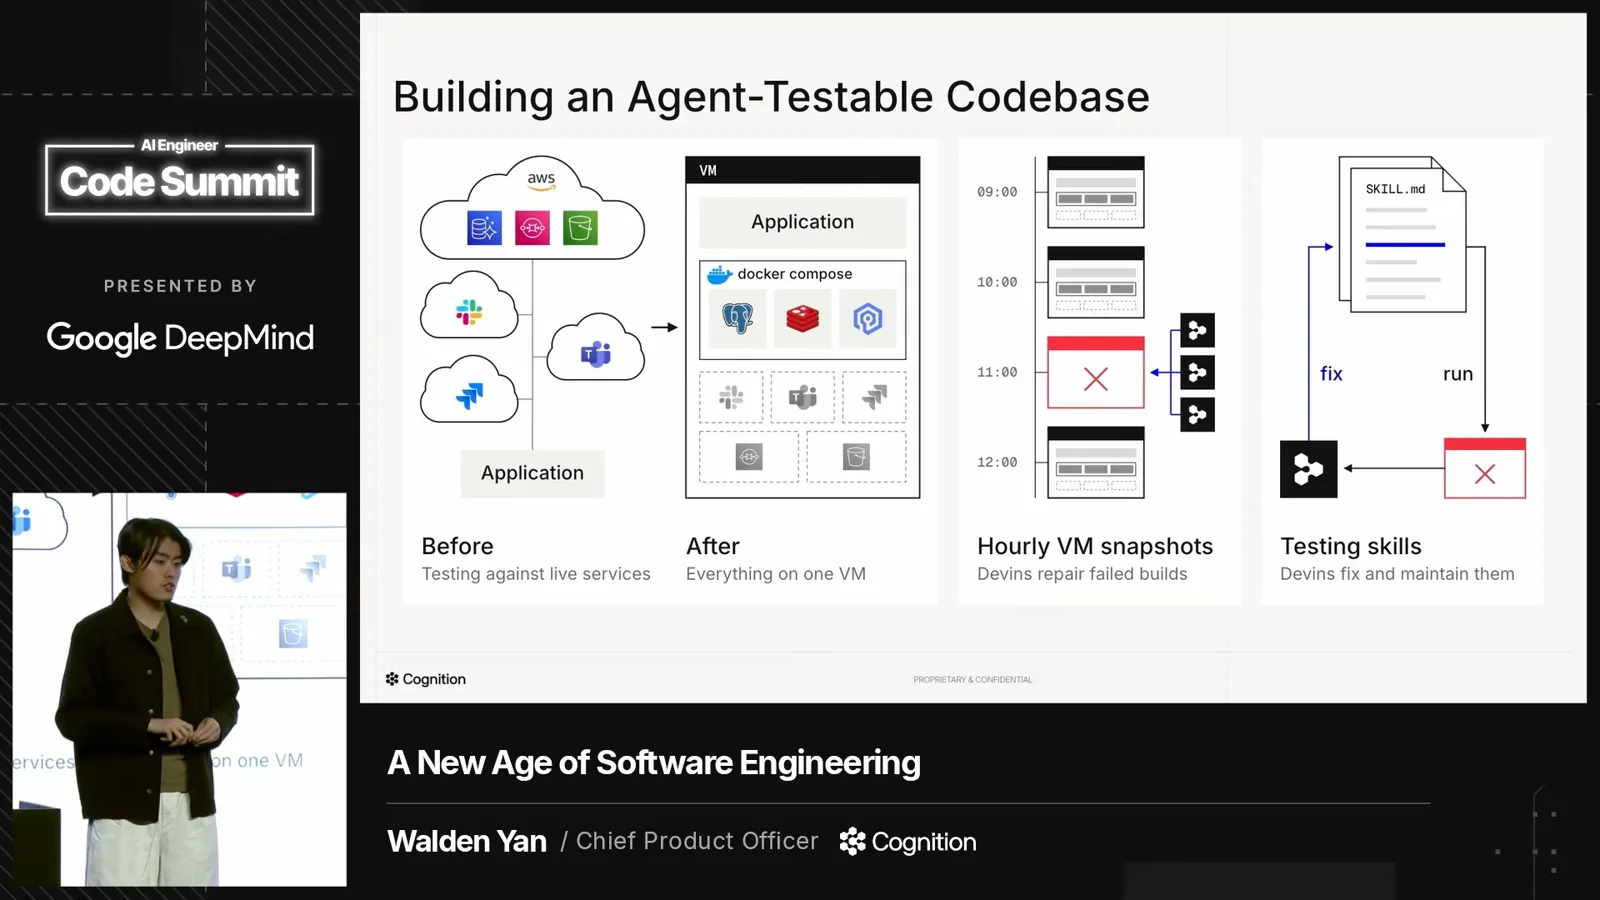
我们每小时根据最新代码重建这些虚拟机。如果快照构建失败,Devin 会首先响应并修复。从 Slack 启动的智能体因此能获得一台包含较新代码的全新机器,无需接触线上服务即可测试。
智能体还需要关于如何测试代码库的指引。随着代码变化,我们的云端智能体会编写和更新自己的测试 skill。因此,一些工程师无需打开笔记本电脑就能审阅和测试工作,还有几位在开发流程中使用 iPad。
我认为受控的云端虚拟机也能降低开发者个人设备上遗留密钥带来的风险。测试也可以很复杂:我们构建语音和 Zoom 参会功能时,Devin 在虚拟机中创建多个账号、加入同一通话并互发语音消息,以检查功能。
让智能体改进工厂本身
智能体分析开发记录,对构建、测试和脚本提出改进建议。
云端智能体系统会记录代码变更、拉取请求和决策。我们让智能体分析这些历史记录,寻找浪费的时间或 token、适合写成脚本的工作以及缺失的测试,然后提出改进软件生产流程的建议。
Devin 每天都会在一个频道发布想法。一条建议可能通过更改 Node 配置为持续集成节省一分钟;另一条可能通过 lint 脚本,在 AI 代码审查之前捕获更多错误。智能体不仅能在工厂里工作,也能帮助优化工厂。
从单项任务转向可衡量的工作
Yan 建议给智能体一个结果目标,以及长期追求目标所需的测量、告警和汇报机制。
下一步是从给智能体单项任务转向给它一项工作。如果我关心应用的第 99 百分位延迟,也就是用户响应时间中较慢的一端,我希望智能体自行建立测量、设置告警、拆解工作并报告进展,而不是等我指定每一步。
尽可能让目标可衡量。这可能意味着测量点击延迟、布局偏移或新用户留存。如果团队能把有价值的结果表达为一个数字,我鼓励它设置智能体持续改进这一指标。
测试 GPU 推理改进
智能体在分配的硬件上尝试提升吞吐量,并将最好的方案交给人类批准。
Cognition 获得 Nvidia Vera Rubin GPU 时,针对它们的推理内核尚未建好。我们给一个智能体分配了一组 GPU,并设定目标:最大化每分钟输出的 token 数。它在约一周内尝试不同方法,把最好的候选方案交给工程师最终批准。
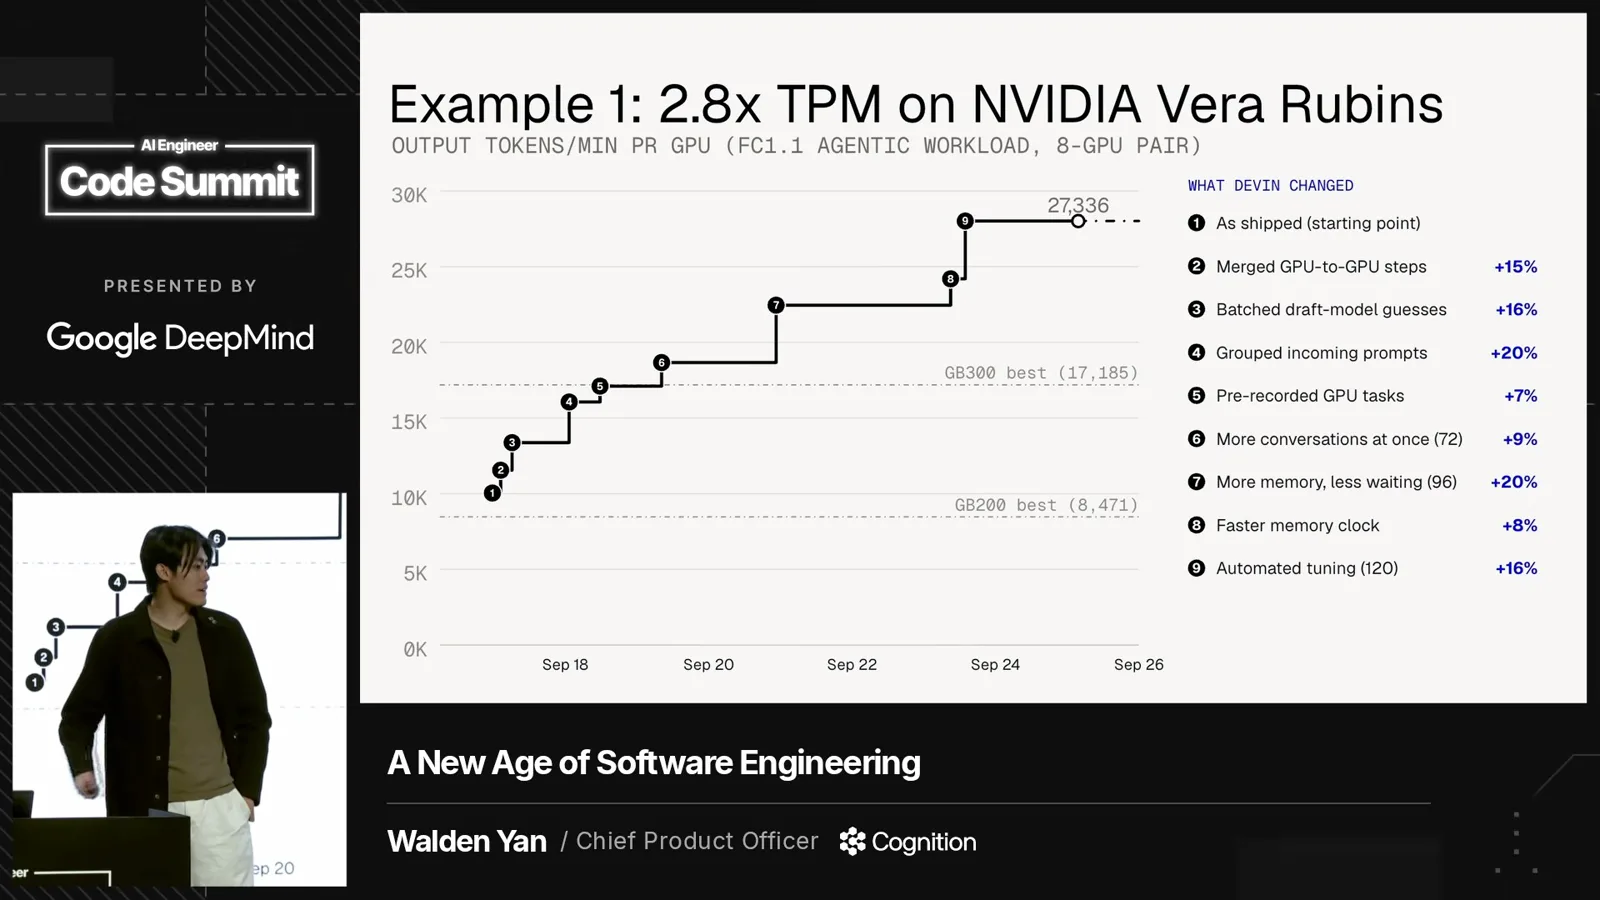
智能体找到了八九项改动。在展示的工作负载中,累计优化使吞吐量从低于我们的 GB300 对照结果提高到明显高于它。关键不在于一条巧妙的提示词:系统拥有硬件、可衡量目标、反复测试和人工批准环节。
以 iOS 应用为参照维护 Android 应用
一个长期运行的智能体利用代码变更、客户反馈和质量检查来追求功能一致。Yan 说,44 天后他们得到了一个可运行的应用。
第二个例子源于我们的小团队没有足够人手全面负责 Android 应用。一名叫 Samuel 的工程师问,能否把现有 iOS 应用作为蓝图,并让 Devin 负责维持 Android 版本与之的一致性。
这并非一次短暂的会话。他设置了持续运行的钩子,监测 iOS 代码库、听取 Slack 中的用户反馈、改进 Android 应用,并对照现有产品测试。智能体可以比较细节,把最重要的决策升级给人类。
44 天后,我们有了一个计划发布的可运行应用。时间线显示,有些天人类发给智能体的消息很少或为零,而合并的拉取请求多达 40 到 50 个。工程师可以在 Slack 中查看录屏,而不必反复打开智能体会话。
我从中得到的结论是,智能体的结果取决于围绕它们建立的循环。有了测试、反馈和目标,团队可以让智能体长期持续工作,而不是为每次改动重新下达指令。
同频道的其他文章
 58:03EN → 简体中文
 AI Engineer· 2026年11月17日Codex 如何连接上下文、云端工作与智能体委派Dominik Kundel, Charlie Guo · OpenAIOpenAI 的 Dominik Kundel 和 Charlie Guo 展示如何把已连接的上下文、快速反馈和远程智能体融入实际工作。
 19:38EN → 简体中文AI Engineer· 2026年11月17日Simon Willison:AI 智能体能解决更多问题,工程工作却仍然不轻松Simon Willison · Datasette一个蜂鸣探测器、一款策略游戏和鹈鹕基准测试,展示了编程智能体如何在 2026 年改变他的工作。
 19:55EN → 简体中文AI Engineer· 2026年11月16日Brandon Thomas:用 AI 智能体开源重建创意软件Brandon Thomas · ArtCraftArtCraft 团队用约一天时间构建了一个类似 Photoshop 的初版编辑器,随后与社区一起扩展开源创意工具。
 23:19EN → 简体中文AI Engineer· 2026年11月15日Diogo Almeida:可靠的 AI 需要不同的训练目标Diogo Almeida · TypeSafe AIAlmeida 认为,为辅助人类而训练的模型不适合无人监督的自动化;他主张围绕可靠智能构建软件。
 17:31EN → 简体中文AI Engineer· 2026年11月14日Lauren Tan:用可执行的检查让 AI 生成的代码更可信Lauren Tan · SpaceXSI这位 Grok Bot 工程师介绍了团队如何通过架构、验证和审查,支持大量智能体生成的代码。
 17:31EN → 简体中文AI Engineer· 2026年11月12日Claude Code 需要的引导更少,无人值守工作却需要更强的检查Lydia Hallie · AnthropicLydia Hallie 介绍权限、隔离环境和验证如何接手人们过去在每次会话中执行的任务。