30 秒看懂
2025 年 1 月,Matthew Berman 汇总研究人员、开发者和投资者对 DeepSeek R1 的反应。他讨论了发布的权重、较小的蒸馏模型、报告的基准得分、API 价格,以及这对获取推理模型可能产生的影响。 比较反映的是 2025 年的特定模型版本、测试和价格。本地推理需要硬件;论文中 R1 的训练过程包含监督数据,强化学习结果并不意味着完全没有人工参与。
- 1开放研究的反应NVIDIA 研究员 Jim Fan 欢迎权重与训练研究的发布,并强调强化学习。
- 2本地硬件实验Alex Cheema 展示了多台 Mac 组成的设备,并期待用它运行大型模型。
- 3小模型结果论文在特定评估设置下报告,Qwen 1.5B 蒸馏模型在 AIME 2024 上得分 28.9%,在 MATH-500 上得分 83.9%。
- 4编程基准Aider 创始人报告,当时 R1 在其多语言编程基准上得分 57%,o1 high 得分 62%。
- 5历史 API 价格一份 2025 年 1 月发布的价格比较分别列出缓存输入、未缓存输入和输出费率。
- 6模型行为与修改Berman 讨论了政治话题上的拒答,以及通过微调改变模型行为的可能性。
要点建议
- DeepSeek 随研究报告发布了 R1 权重和较小的蒸馏模型,扩大了本地部署的选择。
- R1-Zero 与 R1 的训练流程不同;后者既使用监督冷启动数据,也使用强化学习。
- 报告的基准得分适用于特定数据集、版本和测试条件,不能代表普遍的模型排名。
- 2025 年的 API 价格比较和本地计算成本取决于供应商、token 构成及硬件。
- 开放权重使修改成为可能,但不能保证消除拒答或安全限制。
按章节阅读整理后的全文
开放权重与强化学习
Berman 介绍 R1,讨论 Jim Fan 的反应和论文中的训练方法。
DeepSeek 发布 R1 引发了业界强烈反应。团队发布了模型权重和一份介绍推理方法的研究报告。我对更多开放可用的推理模型感到兴奋,但获取权重并不等于公开了每一项训练数据或细节。
NVIDIA 研究员 Jim Fan 称赞了这次发布,并强调强化学习飞轮。我将其解读为消除人工反馈瓶颈。论文作出了重要区分:R1-Zero 是没有初始监督微调阶段、以强化学习为核心的实验,而 R1 使用了监督冷启动数据及其他训练阶段。这两项说法都不能证明整个开发过程中没有人工参与。
Fan 将对未来 AI 的宣传与公开算法和学习曲线作了对比。我很欣赏看到其他人可以研究的具体技术材料,尽管公开论文和权重不一定意味着披露了复现模型所需的每一种要素。
本地模型与早期评估
他回顾多台 Mac 的配置、较小蒸馏模型和早期基准比较。
Alex Cheema 展示了一套多台 Mac 的设备,并称这些机器的统一内存合计为 896 GB,聚合带宽为 3,557 GB/s。他期待用它运行大型 R1 模型。这些数字描述的是他的设备和预期,并非每种本地安装方式的实测速度。
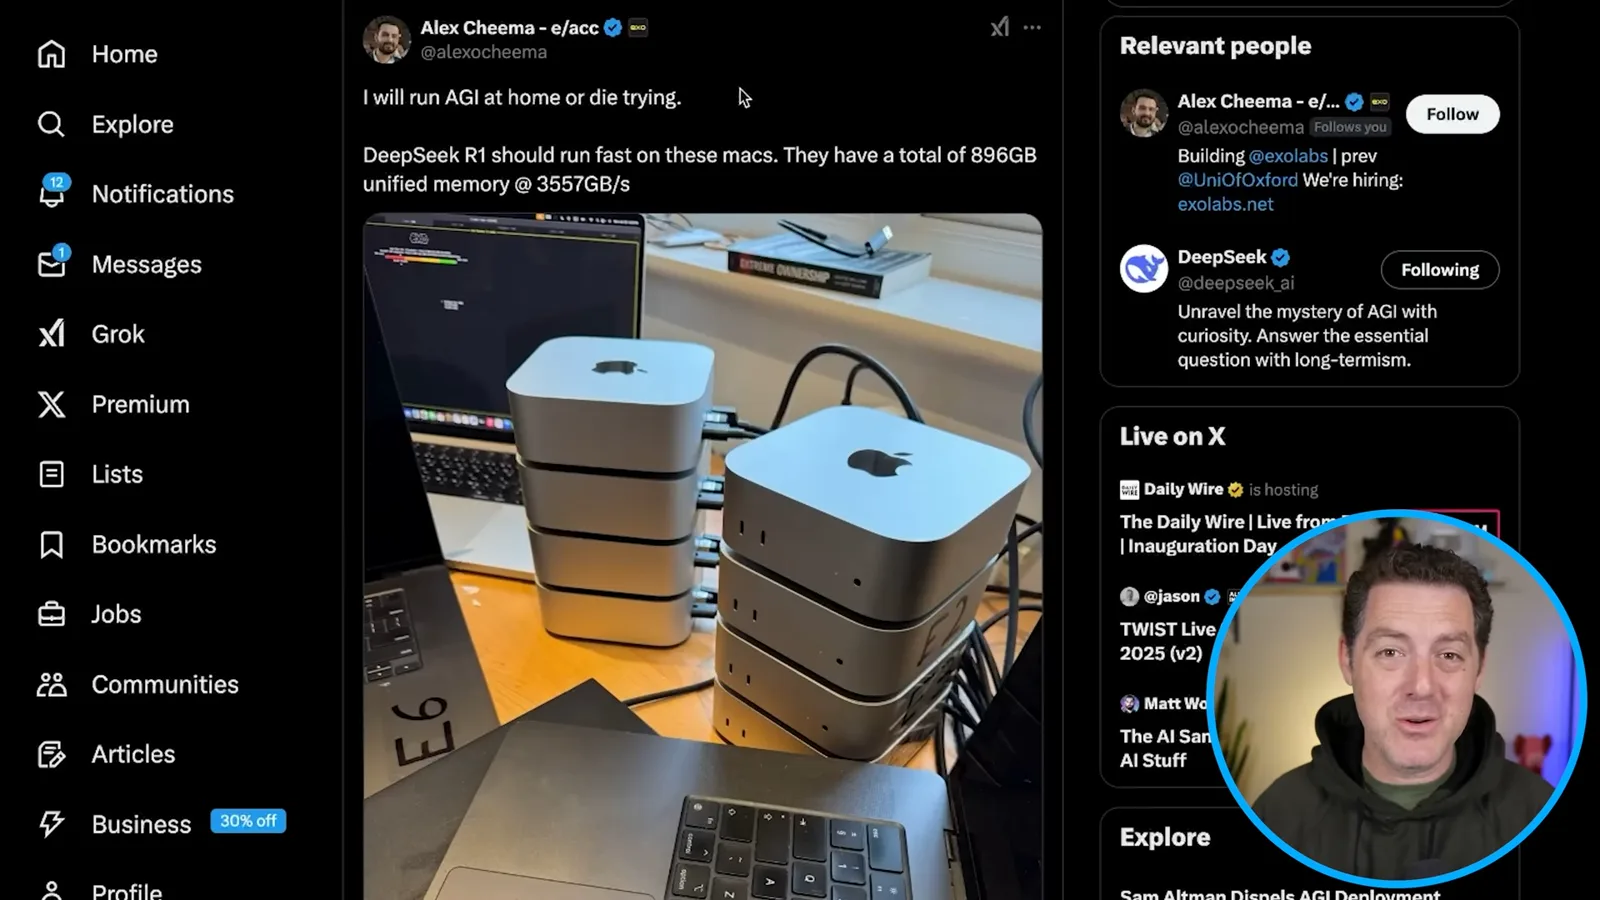
权重的可用性意味着用户可以探索本地推理,而不必只依赖托管服务。我将其与专有模型的订阅和 API 价格作比较,强调更低成本的访问方式。下载权重并不会让硬件、电力或托管推理免费,不同版本的模型许可和资源需求也各不相同。
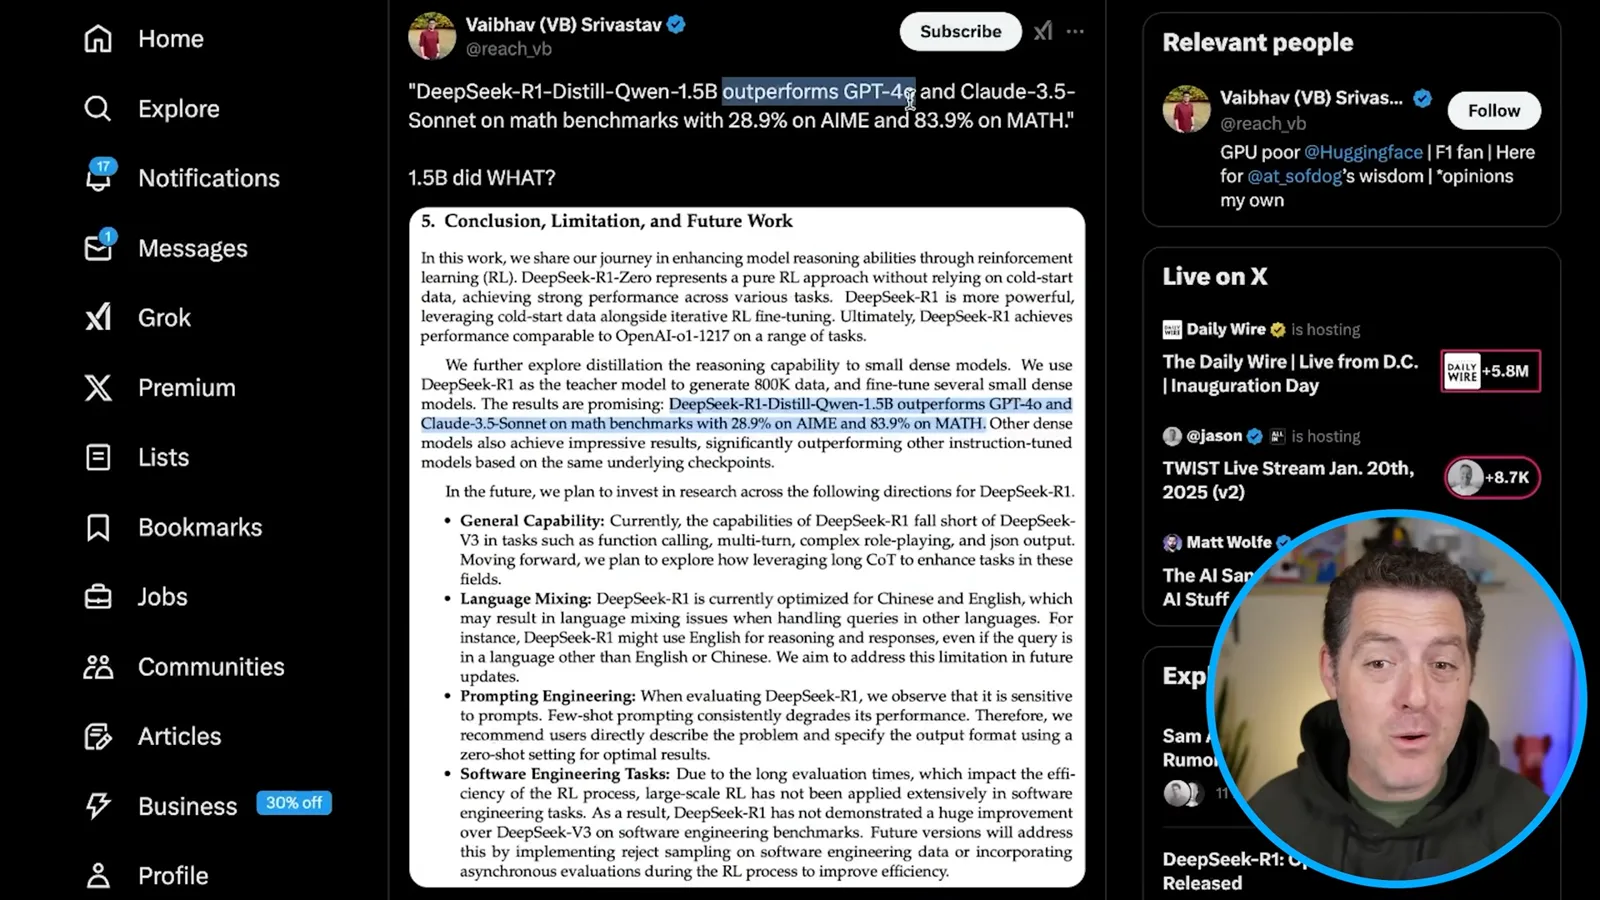
一名 Hugging Face 团队成员重点介绍了较小的 DeepSeek-R1-Distill-Qwen-1.5B。DeepSeek 论文报告,该模型在 AIME 2024 上得分 28.9%,在 MATH-500 上得分 83.9%,高于论文中 GPT-4o 和 Claude 3.5 Sonnet 在这些数学测试上的基线。这些得分并不意味着它在所有任务上都更好;本地速度和内存需求取决于硬件与量化方式。
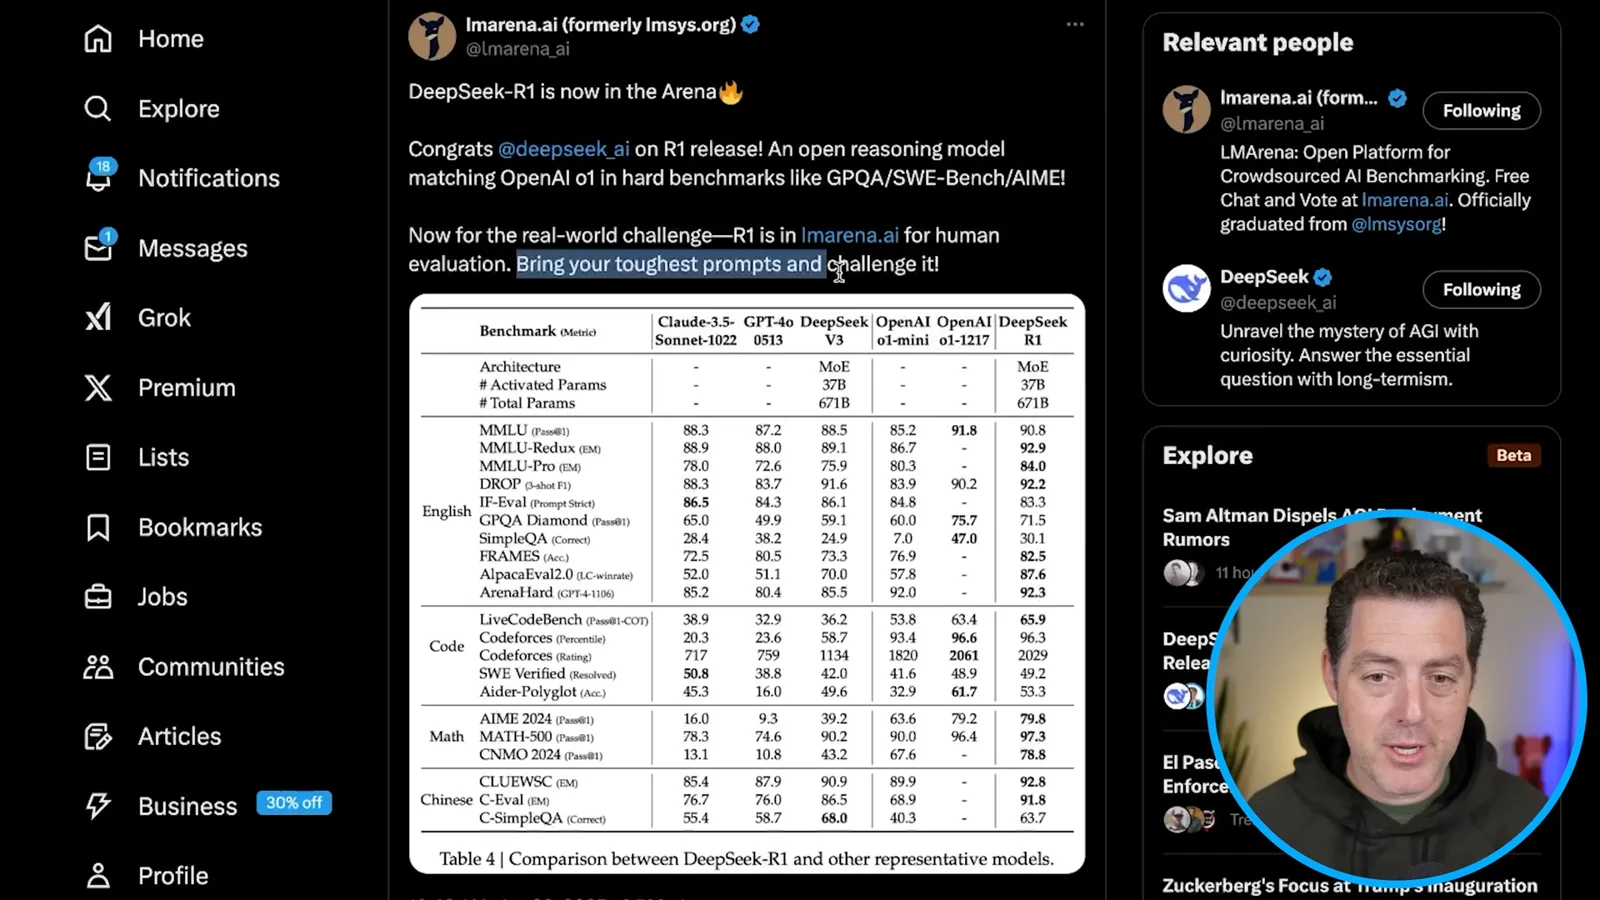
LMArena 宣布 R1 可供人工评估,并引用了 GPQA、SWE-bench 和 AIME 等测试中的强劲结果。画面中的基准表来自 DeepSeek 的评估,得分会因任务和模型而异。我设想工程师可以在编程环境中离线使用较小或量化后的版本,但这取决于可用硬件和集成方式。
Ethan Mollick 将此次发布描述为一个有能力的开放推理模型,并指出最小版本可以在笔记本电脑上运行。他将部分基准结果与 o1 比较,同时将它们与 o1 Pro 区分开来。基准比较是有用信号,但不能证明这些模型在每种应用中都可以互换。
行业影响与预测
Berman 汇总对开放模型、竞争和未来发布速度的评论。
Dean W. Ball 认为中国实验室可能继续取得强劲的基准结果,而开放模型具有战略价值。他呼吁发布更多开放模型,而不是依赖一家公司。我同意让更多人获得有能力的模型可能很重要,同时未来模型的预测仍具有不确定性。
Emad Mostaque 对 R1 作出了关于经济的挑衅性评论,也拿前沿实验室之间的竞争开玩笑。Perplexity 首席执行官 Aravind Srinivas 也评论了推理成本下降的速度。我预测几个月内会出现公开可用、达到 o3 水平的模型;那是我当时的预测,而非既定结果。
编程得分、价格与行为
他讨论 Aider 结果、历史 API 价格比较,以及拒答和修改模型的问题。
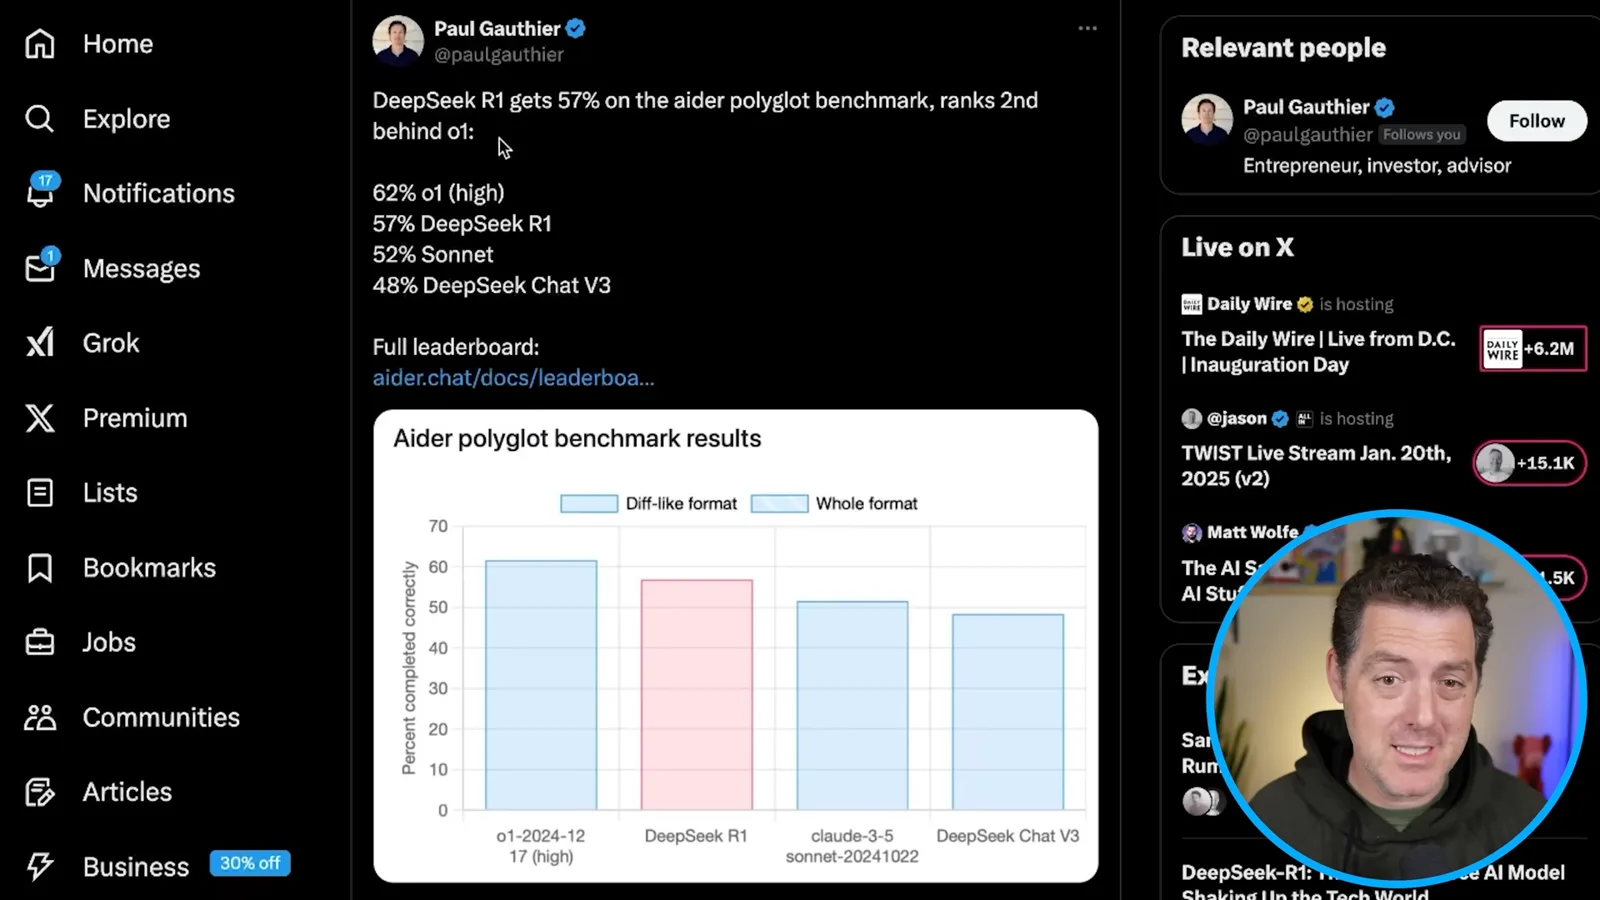
Aider 创始人 Paul Gauthier 报告,R1 在 Aider 多语言编程基准上得分 57%,低于他发布的比较中 o1 high 的 62%。这反映的是当时使用的基准和配置。LM Studio 提供了可供本地使用的蒸馏版本;我披露自己是 LM Studio 的小额投资者。
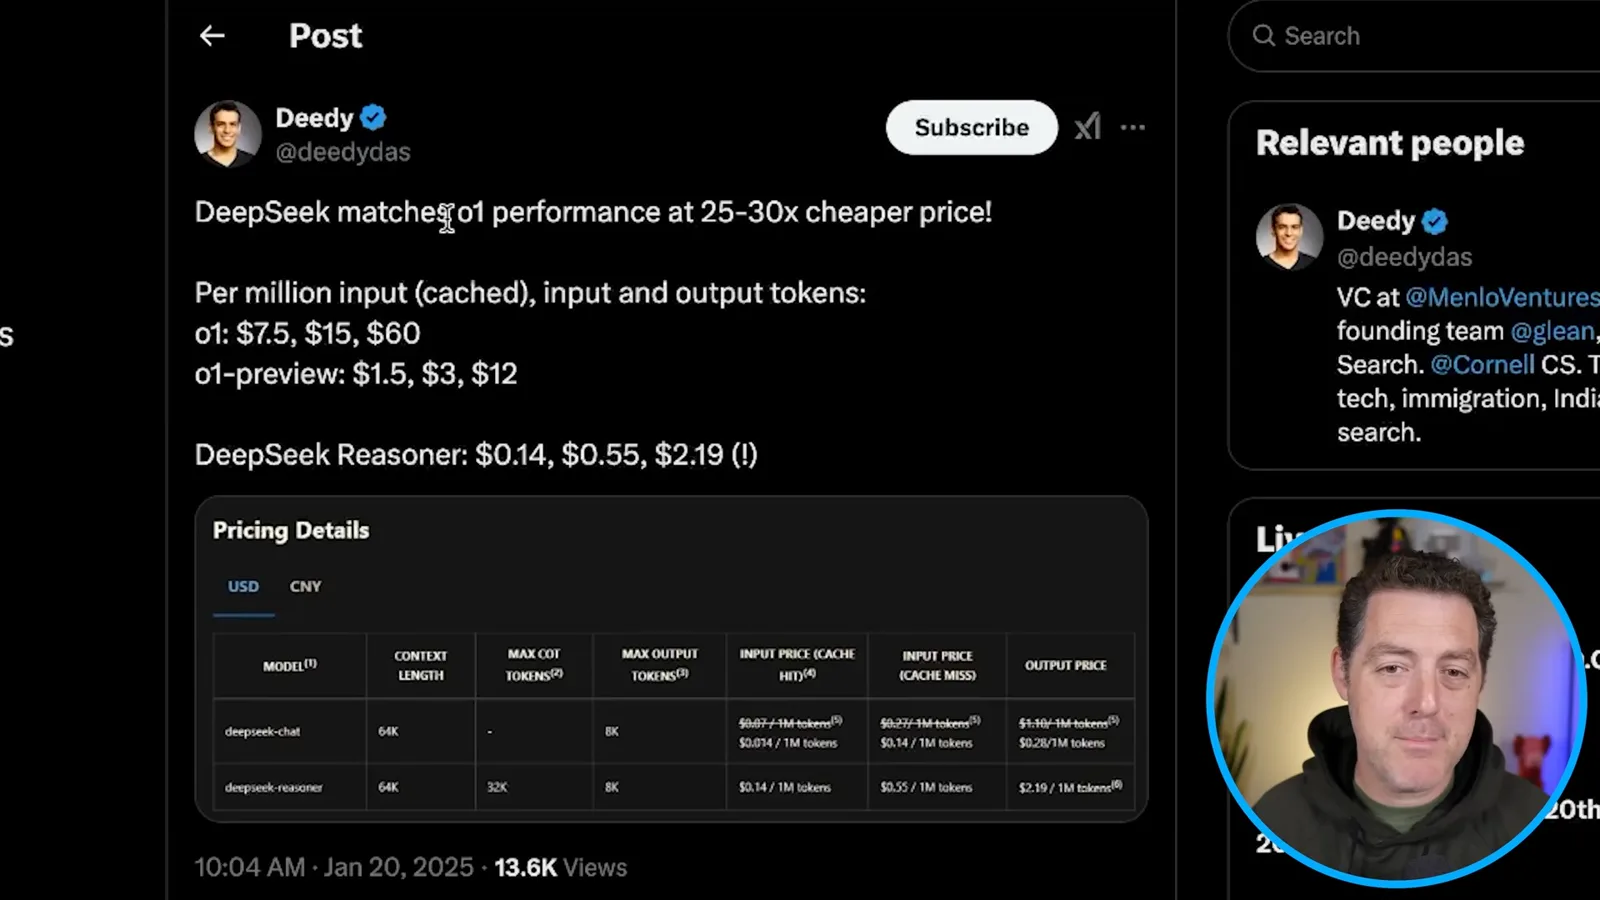
一篇 2025 年 1 月的帖子比较了每百万个缓存输入、未缓存输入和输出 token 的价格:o1 分别为 7.50 美元、15 美元和 60 美元;DeepSeek Reasoner 分别为 0.14 美元、0.55 美元和 2.19 美元。这些是当时公布的历史费率,节省多少取决于 token 构成、供应商和其他成本。我认为较低价格可能让更多应用变得可行,但这一市场结果仍是预测。
我对涉及台湾和天安门广场等政治敏感话题的拒答表示担忧。托管服务与下载或修改后的权重、不同提示词及版本之间,行为可能有所不同。微调可以改变模型行为,但不能保证消除所有拒答或限制。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。