30 秒看懂
Matthew Berman 根据开发者公布的结果和技术报告,讨论 DeepSeek V3.2 及使用更多计算量的 V3.2-Speciale。他分析基准分数、稀疏注意力、强化学习和合成智能体任务,同时指出其工具使用表现仍落后于领先的专有模型。
- 1两种模型版本DeepSeek 宣布 V3.2 和计算量更高的 V3.2-Speciale;发布材料称 Speciale 在推出时仅通过 API 提供。
- 2推理基准DeepSeek 的表格报告 Speciale 在 AIME 2025 上得分为 96.0,V3.2 Thinking 为 93.1;前者使用了更多词元。
- 3稀疏注意力DeepSeek 表示,其注意力机制在保持长上下文表现的同时降低计算复杂度。
- 4后训练与智能体任务技术报告介绍了庞大的后训练预算,以及用于强化学习的合成环境。
- 5模型规模Berman 引述称,这个混合专家模型总参数为 6,710 亿,活跃参数为 370 亿。
要点建议
- DeepSeek 报告称 V3.2-Speciale 在推理任务上表现强劲,其推理词元用量高于标准思考模型。
- DeepSeek Sparse Attention 旨在降低长上下文的注意力计算复杂度。
- 团队报告后训练算力预算超过预训练算力预算的 10%。
- 团队使用合成环境和提示词训练智能体使用工具。
- 这个总参数为 6,710 亿的混合专家模型每个词元激活 370 亿参数,但完整权重仍需要大量内存。
按章节阅读整理后的全文
V3.2 发布与基准测试
Berman 介绍两个版本,并比较报告中的推理、编程和科学基准分数。结果来自 DeepSeek 自己公布的表格。
DeepSeek V3.2 已经发布,我认为它是开放模型的又一个重要时刻。DeepSeek 报告称,其计算量更高的模型在 2025 年国际数学奥林匹克和国际信息学奥林匹克中达到金牌级别表现。这些是开发者报告的评估结果,不能确立该模型在每项任务上都领先所有封闭模型。
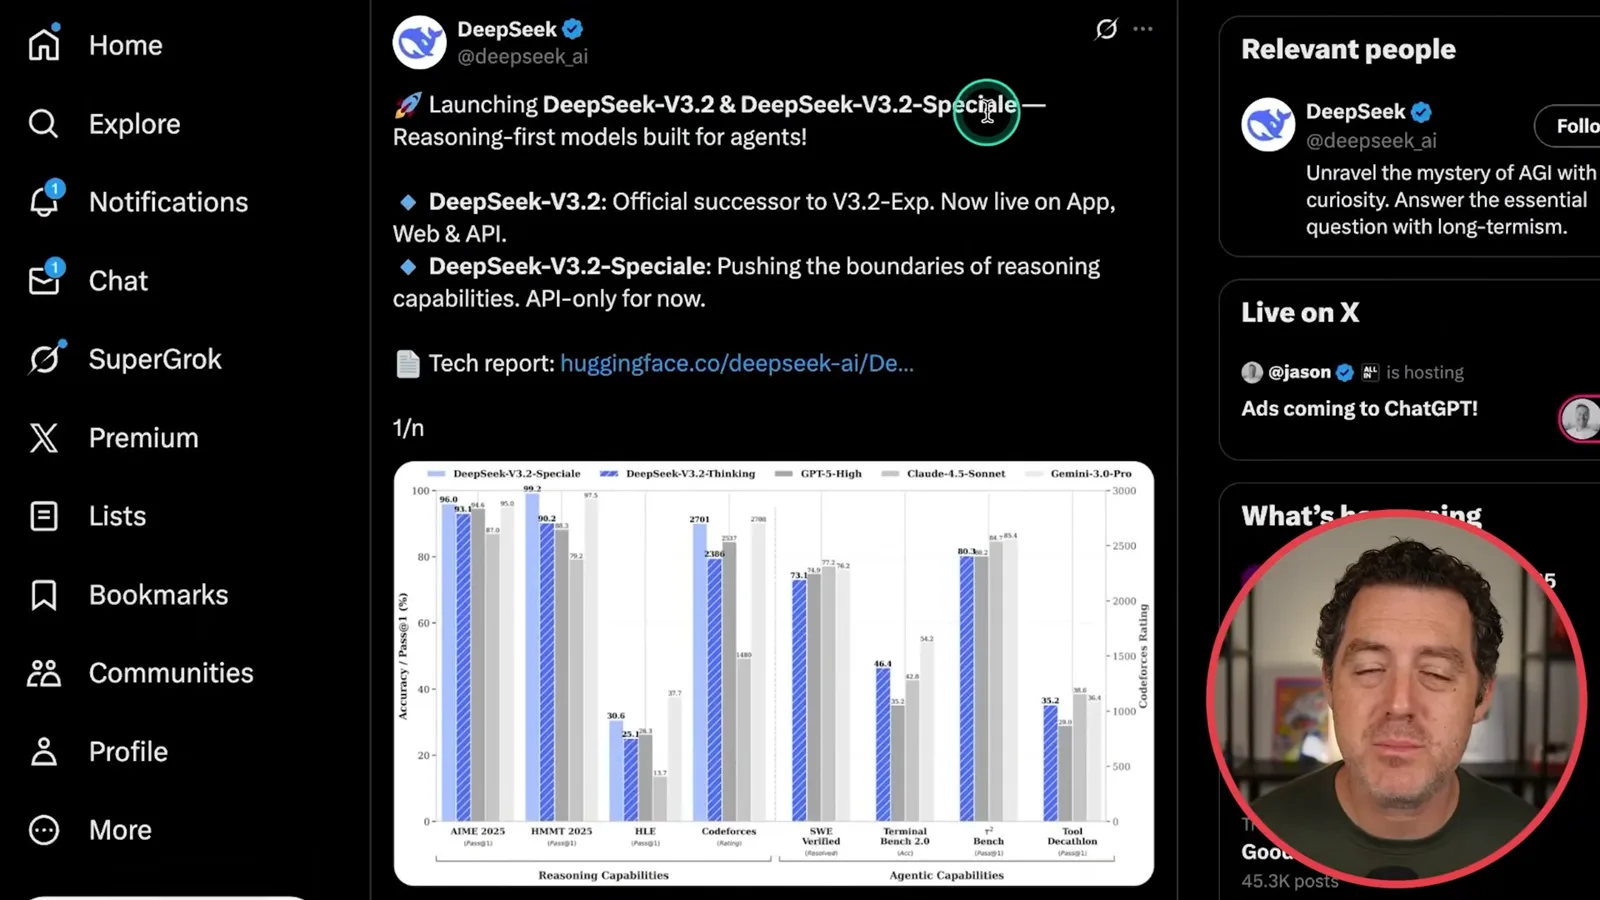
DeepSeek 宣布 V3.2 和 V3.2-Speciale 是以推理为先的模型。发布帖子将 V3.2 描述为 V3.2-Exp 的后继版本,可通过应用、网页和 API 使用;Speciale 是计算量更高的版本,推出时通过 API 提供。帖子还称 Speciale 当时不支持工具使用。
公司的基准表将这些模型与 GPT-5 High、Gemini 3.0 Pro 和 Kimi K2 Thinking 比较;我注意到其中没有 Claude Opus 4.5。在 AIME 2025 上,表格报告 GPT-5 High 为 94.6、Gemini 3.0 Pro 为 95.0、V3.2 Thinking 为 93.1、Speciale 为 96.0。
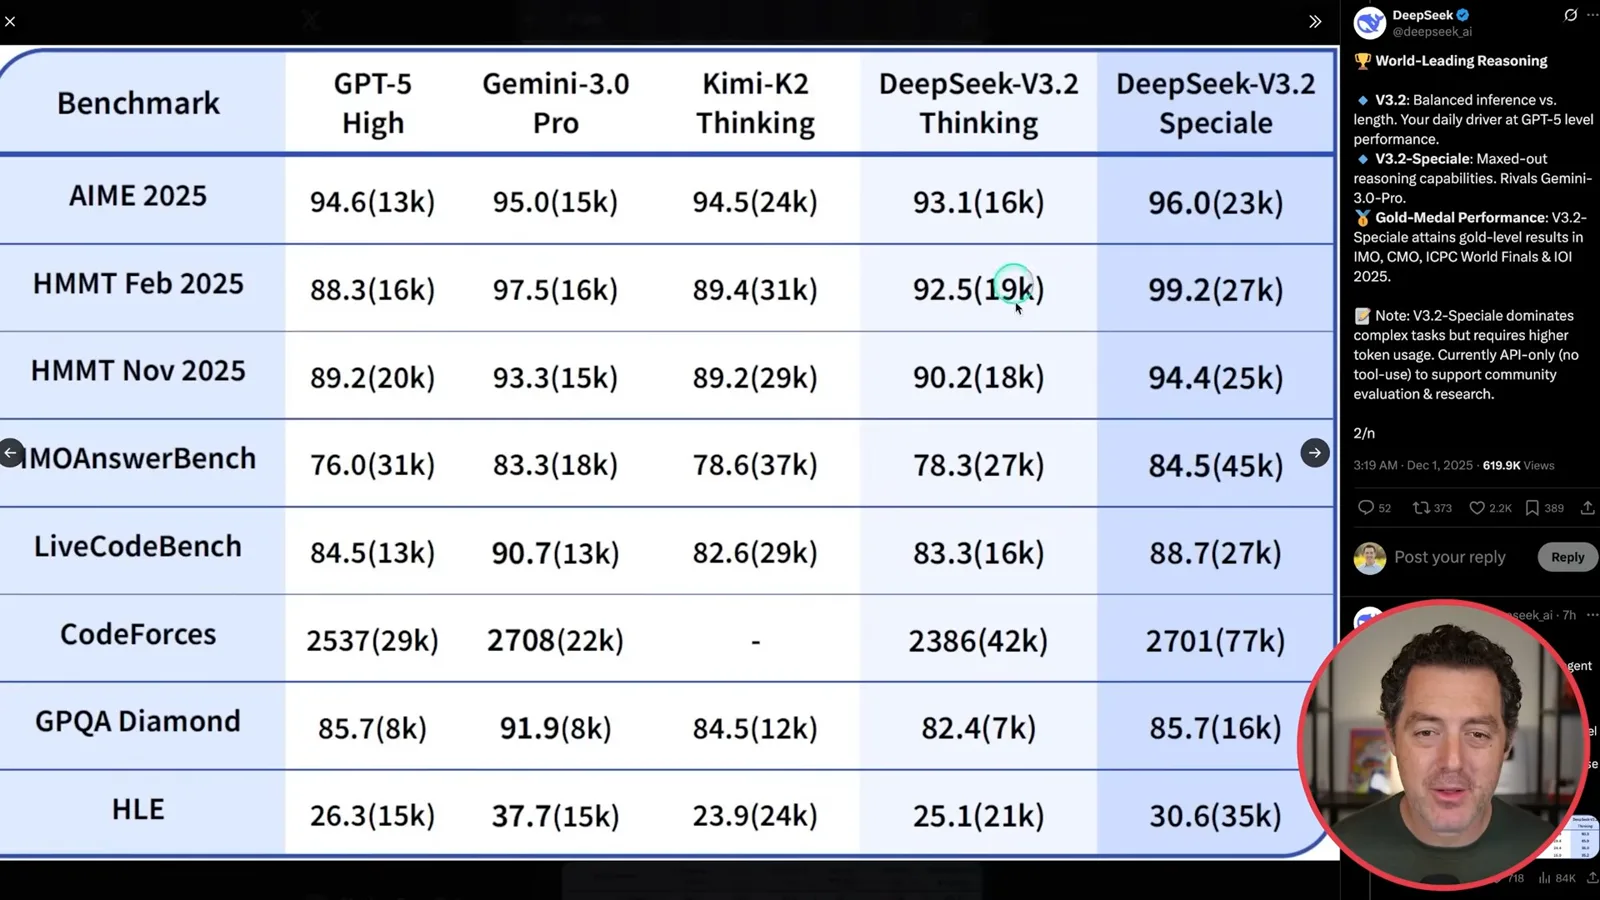
括号中的数字是使用的推理词元数。在所展示的例子中,DeepSeek 的标准思考模型使用的词元少于 Speciale,而 Speciale 为获得更高分数花费了更多词元。比较性能和成本时,这些额外的推理计算量很重要。
在 LiveCodeBench 上,展示的结果为 GPT-5 High 84.5、V3.2 Thinking 83.3、Speciale 88.7。在 GPQA Diamond 上,表格显示 GPT-5 High 和 Speciale 均为 85.7,Gemini 3.0 Pro 为 91.9。这些是选定的基准测试,不能保证每项实际任务都保持相同排序。
注意力、强化学习与智能体数据
技术报告介绍稀疏注意力、扩大后的后训练和合成智能体任务。Berman 解释了预期收益。
DeepSeek 的报告介绍了几项技术变化。第一项是 DeepSeek Sparse Attention(DSA);作者表示,该机制在保持长上下文场景表现的同时,大幅降低了注意力计算复杂度。更高效的注意力可以降低处理长上下文的成本。
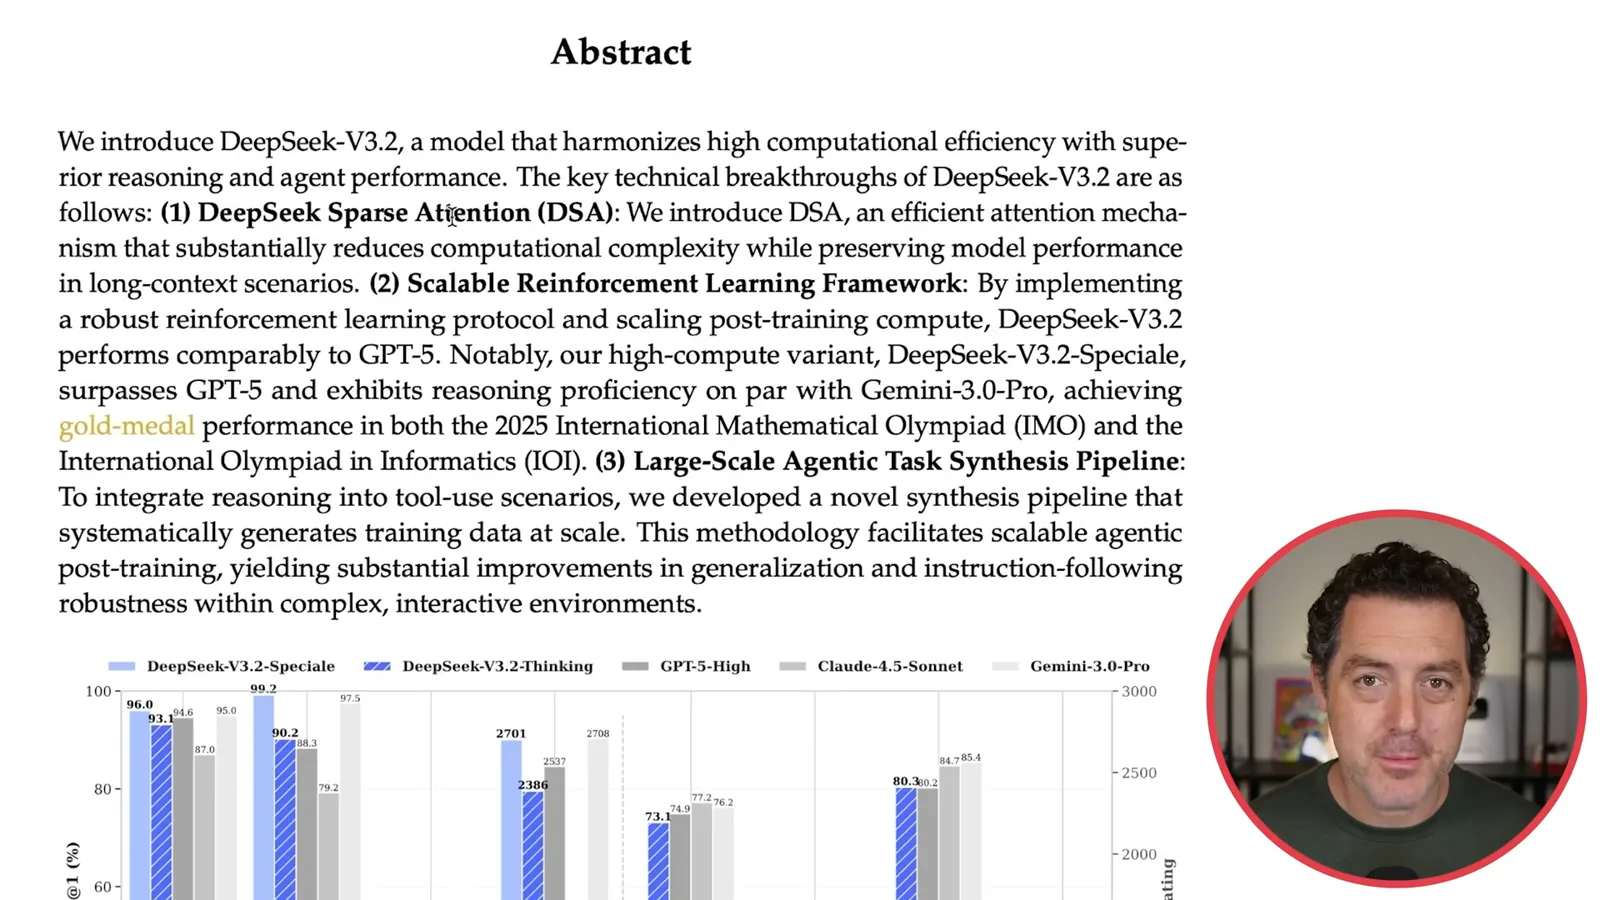
传统全注意力随着序列增长会变得昂贵,因为其注意力计算呈二次方增长。DeepSeek 称核心注意力复杂度从 O(L²) 降到 O(L × K),其中 L 是序列长度,K 是选中词元的数量。节省的程度取决于 K 的值,这并不意味着模型推理的每个部分都变成线性。
第二项是可扩展的强化学习框架和更多后训练算力。DeepSeek 表示,V3.2 在其评估的推理任务上与 GPT-5 表现相当,并报告 Speciale 在 2025 年 IMO 和 IOI 上达到金牌级别。这些比较反映的是开发者的评估条件。
第三,DeepSeek 构建了大规模合成智能体任务的流水线。团队生成旨在结合推理与工具使用的训练场景,为强化学习提供数据,而非完全依赖人工创建的示例。目标是改善交互环境中的泛化能力和指令遵循能力。
训练细节与实际部署
Berman 再次讨论算力预算和合成环境,随后介绍工具使用的限制和运行模型所需的内存。
DeepSeek 的报告称,后训练算力预算超过预训练成本的 10%。这是与预训练算力的比较,不是说强化学习使用了整个项目预算的 10%。公司还报告为智能体任务生成了 1,800 多个不同环境和 85,000 个复杂提示词。
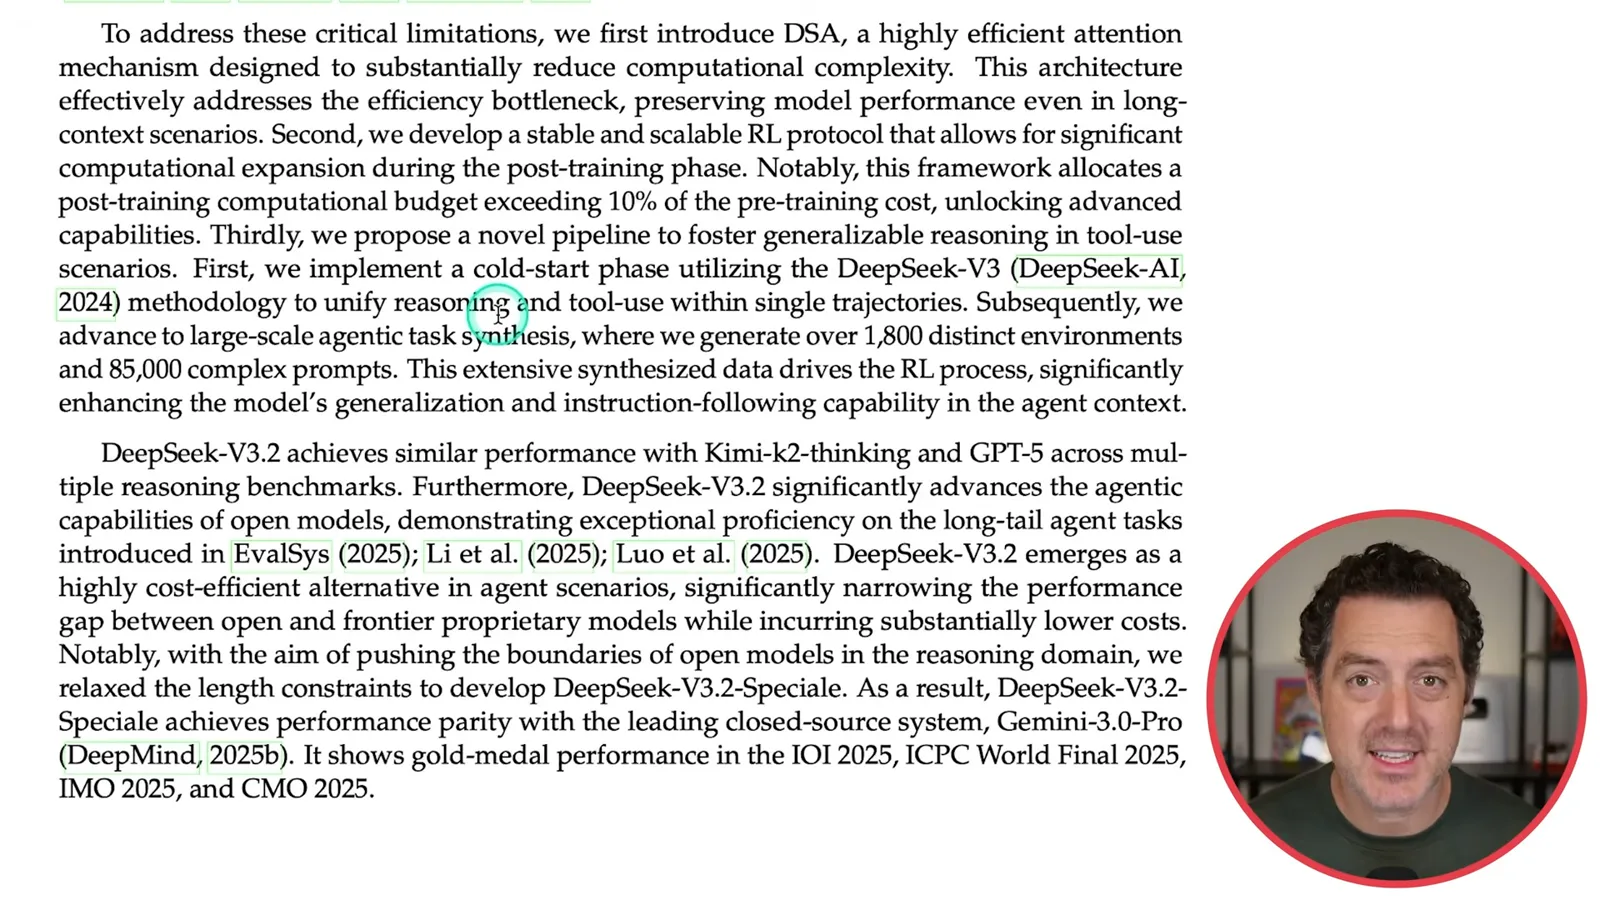
稀疏注意力的优势在于,主要注意力操作不再按二次方增长,而是按 L × K 比例增长。Berman 将实际目标描述为控制更长序列的成本,但实际运行时间和费用仍取决于实现方式、硬件及其他模型操作。
DeepSeek 报告称,V3.2 在工具使用基准上缩小了开放模型与封闭模型的差距,但在该评估中仍落后于前沿系统。展示的论文还指出,冗余的自我验证可能产生很长的轨迹,在某些任务中超过 128K 上下文限制。
该混合专家模型总参数为 6,710 亿,推理时激活 370 亿参数。我估计 FP8 权重约需 700 GB 显存,BF16 约需 1.3 TB;这说明活跃参数相对较少并不能消除保存完整模型所需的内存。该版本以 MIT 许可证开放权重;Speciale 在发布时的可用范围更有限。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。
 1:03:37EN → 简体中文Matthew Berman· 2026年10月23日Matthew Berman 团队测试 Kimi K3.1:动画、游戏与图表Matthew Berman, Alex, Brian · Forward Future一场团队直播问答变成了对 Kimi K3.1 的非正式测试,内容涵盖个人智能体工作流、动态图形、浏览器游戏和基准图表。
 0:53EN → 简体中文Matthew Berman· 2026年10月22日Sam Altman 谈 AI 与新知识的发现Sam Altman · OpenAIAltman 预计,数学发现方面的进展将延伸到生物学、材料和能源领域。
 0:22EN → 简体中文Matthew Berman· 2026年10月21日机器人保镖短片展示戏剧性的救援场景Matthew Berman · Forward FutureMatthew Berman 观看一段展示格斗与车辆救援场景的机器人短片。