30 秒看懂
Matthew Berman 讨论 Joon Sung Park 及其合作者在 2024 年开展的一项研究:他们用个人访谈记录作为提示来构建代理,将代理的回答与参与者在问卷、人格测评以及经济和社会实验中的决策进行比较。 GSS 的主要结果 0.85 是以参与者间隔两周的回答一致性为基准进行归一化的;论文报告的代理原始准确率为 68.85%,参与者重测准确率为 81.25%。这一数字并不衡量人格被复制了多少,也不能证明代理能可靠地预测现实社会。
- 11,052 个基于访谈的代理研究使用个人访谈记录为模型提供提示,并将代理的回答与参与者的回答进行比较。
- 20.85 衡量的是什么在 GSS 中,报告的归一化准确率将代理准确率与参与者两周后的重测一致性比较;代理原始准确率为 68.85%。
- 3半结构化访谈AI 访谈员遵循共同的访谈提纲,并根据各参与者的回答调整追问。
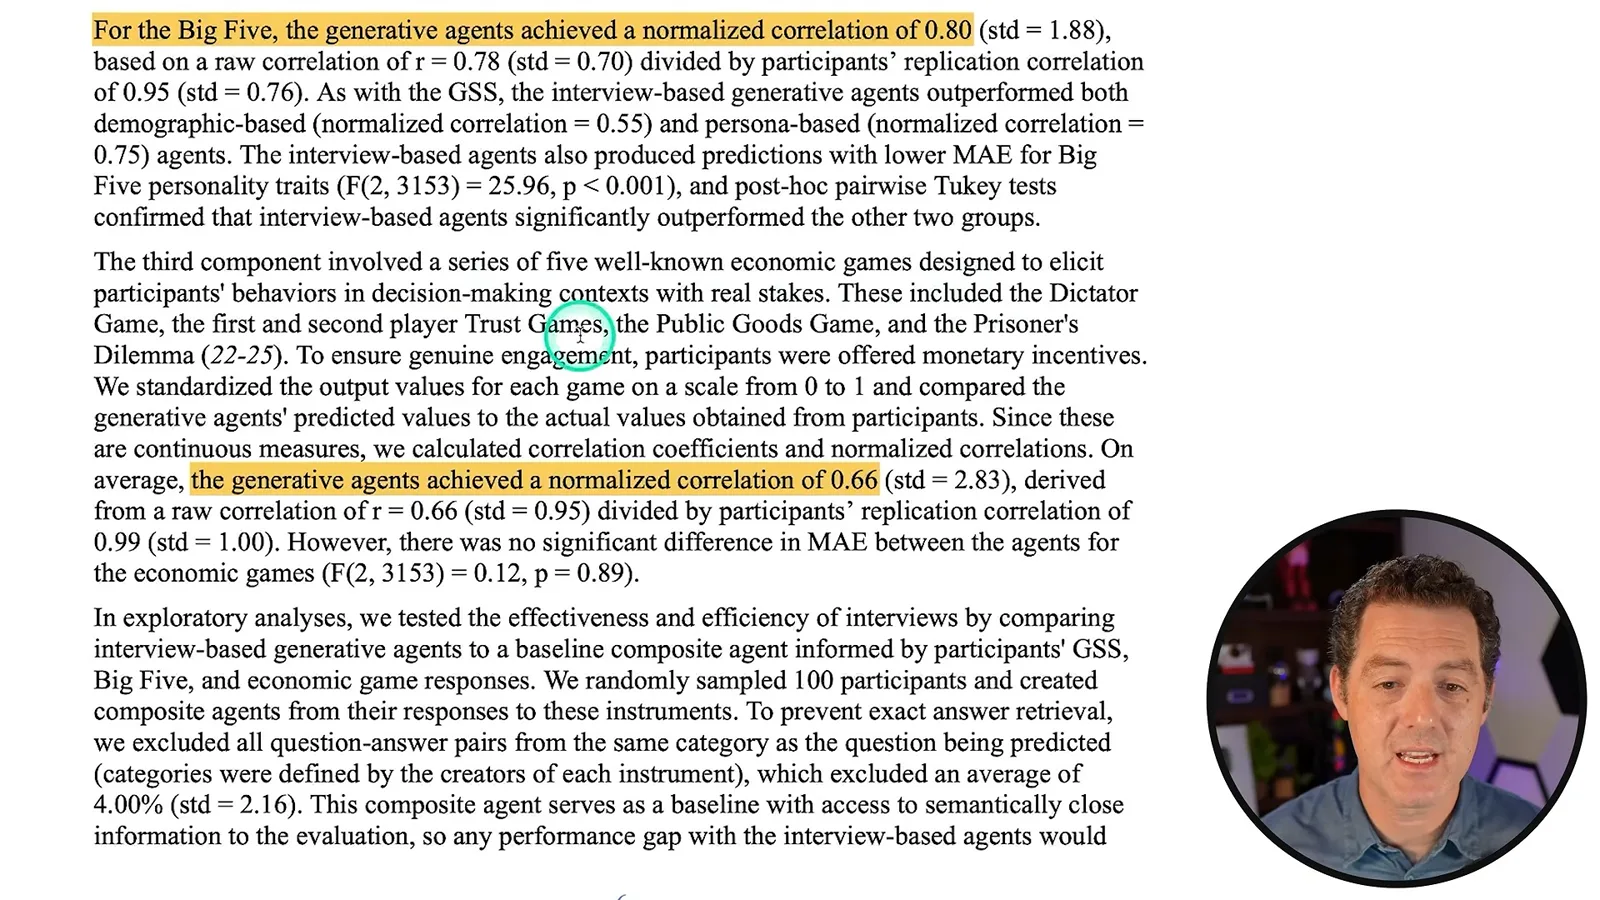
- 4不同测试采用不同指标报告的归一化相关系数在大五人格测试中为 0.80,在经济博弈中为 0.66。
- 5删除访谈内容删除 80% 的访谈内容后,受测代理的归一化 GSS 准确率为 0.79。
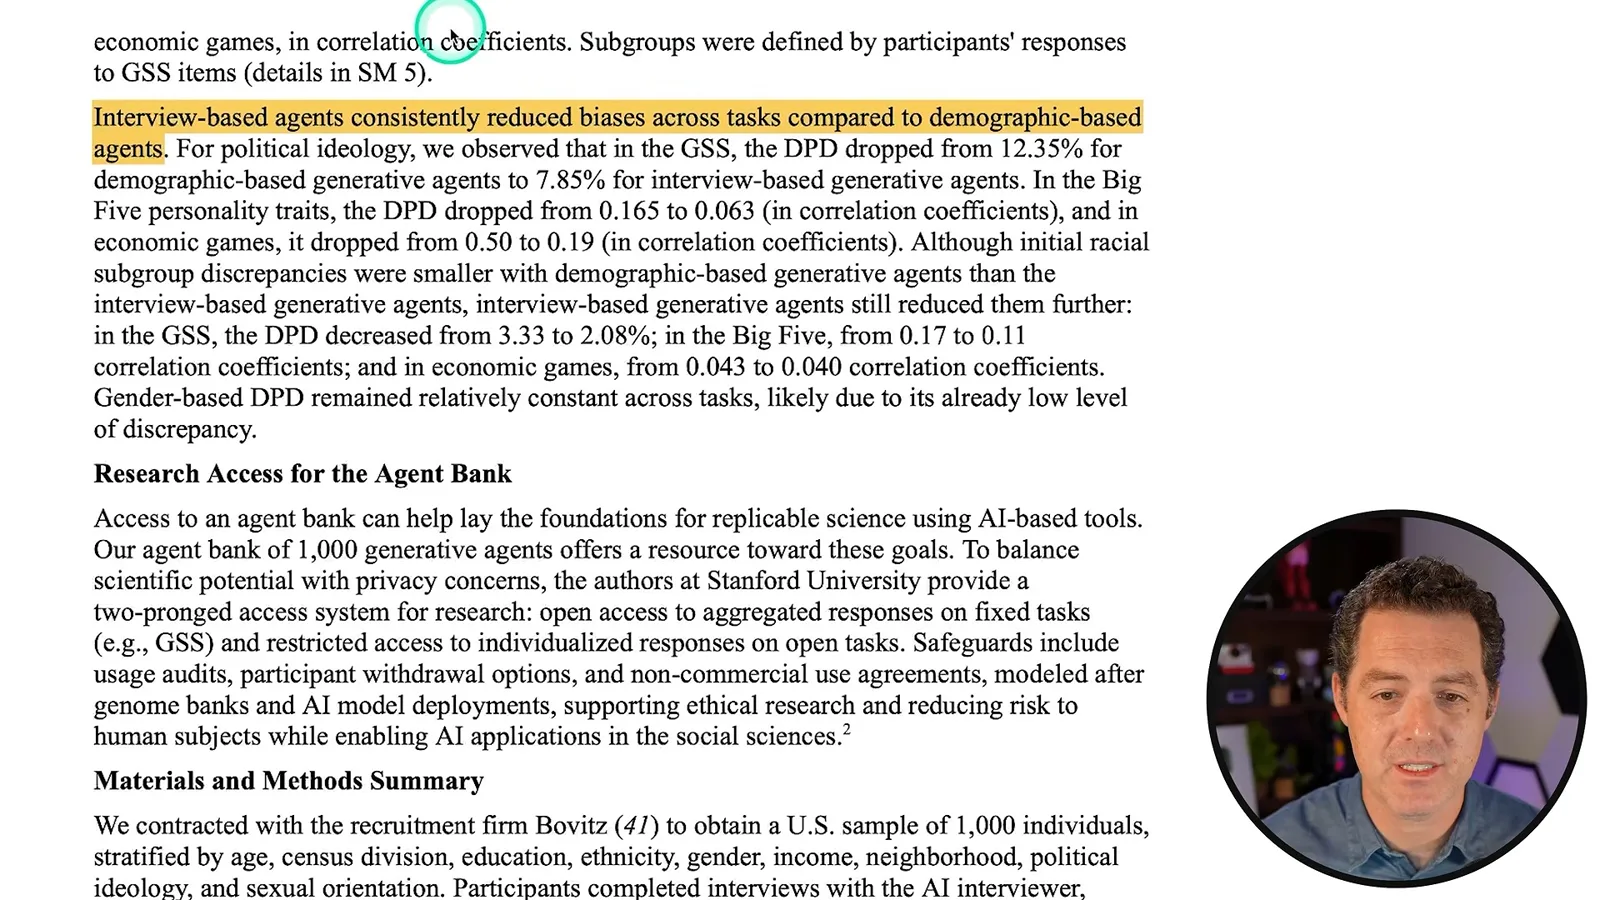
- 6群体间表现差距论文报告,在 GSS 政治意识形态群体的表现差距上,基于访谈的代理小于基于人口统计的代理。
要点建议
- 研究人员通过约两小时的 AI 主持访谈,收集 1,052 名美国参与者的信息,用来构建生成式代理。
- GSS 的 0.85 分数是将代理预测准确率与参与者重测一致性比较,并非以 100% 原始准确率为基准。
- 大五人格和经济博弈结果使用归一化相关系数,与调查准确率是不同指标。
- 在报告的 GSS 指标上,基于访谈的代理超过了基于人口统计和人物画像的基线,但准确程度因任务而异。
- Berman 设想的政策模拟是可能的未来用途,并非研究已经展示的结果。
按章节阅读整理后的全文
从模拟小镇到真实参与者
Berman 回顾了此前的生成式代理研究,并介绍 2024 年的访谈研究。他讨论 GSS 结果和政策模拟的设想,但证据仍限于所测任务。
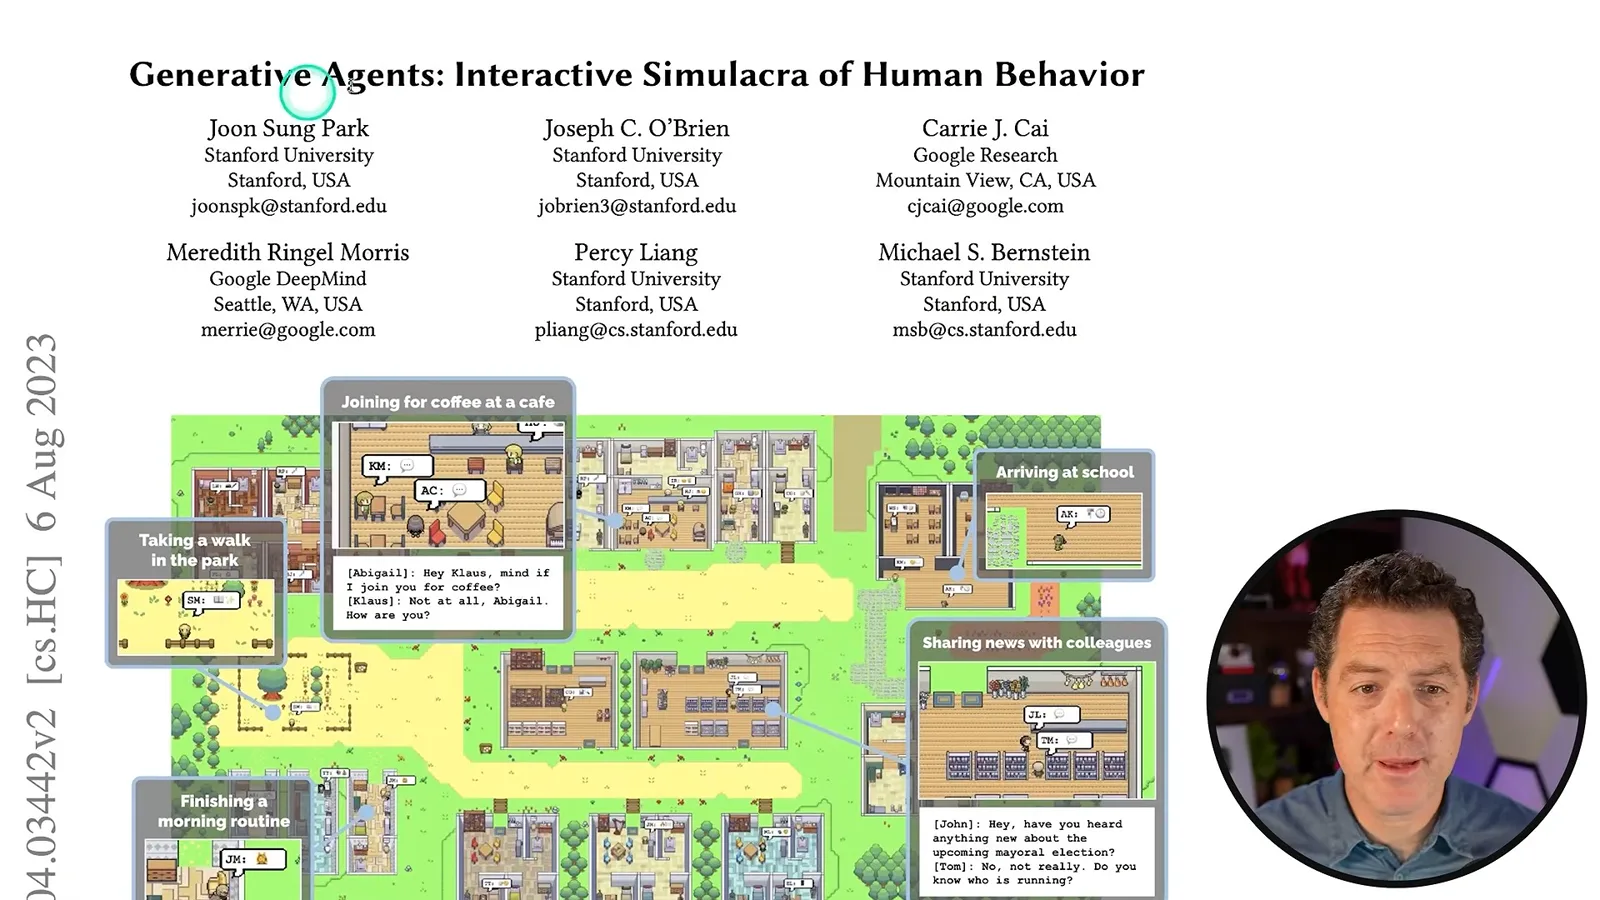
此前一篇与 Stanford 相关的论文探讨了生活在模拟小镇中的生成式代理如何形成记忆、关系和计划。我对更有活力的游戏角色和模拟社会的可能性印象深刻。Joon Sung Park 及合作者的一篇新论文提出了另一个问题:根据访谈信息构建的代理,能否近似预测特定人的回答和决策?
研究人员访谈了 1,052 名美国参与者,并根据他们的叙述构建代理。他们将模拟回答与这些人在问卷和行为任务中的回答进行比较。把代理称作人格克隆夸大了研究所能证明的内容:研究衡量的是特定回答和实验结果,而不是整个人格是否得到复制。
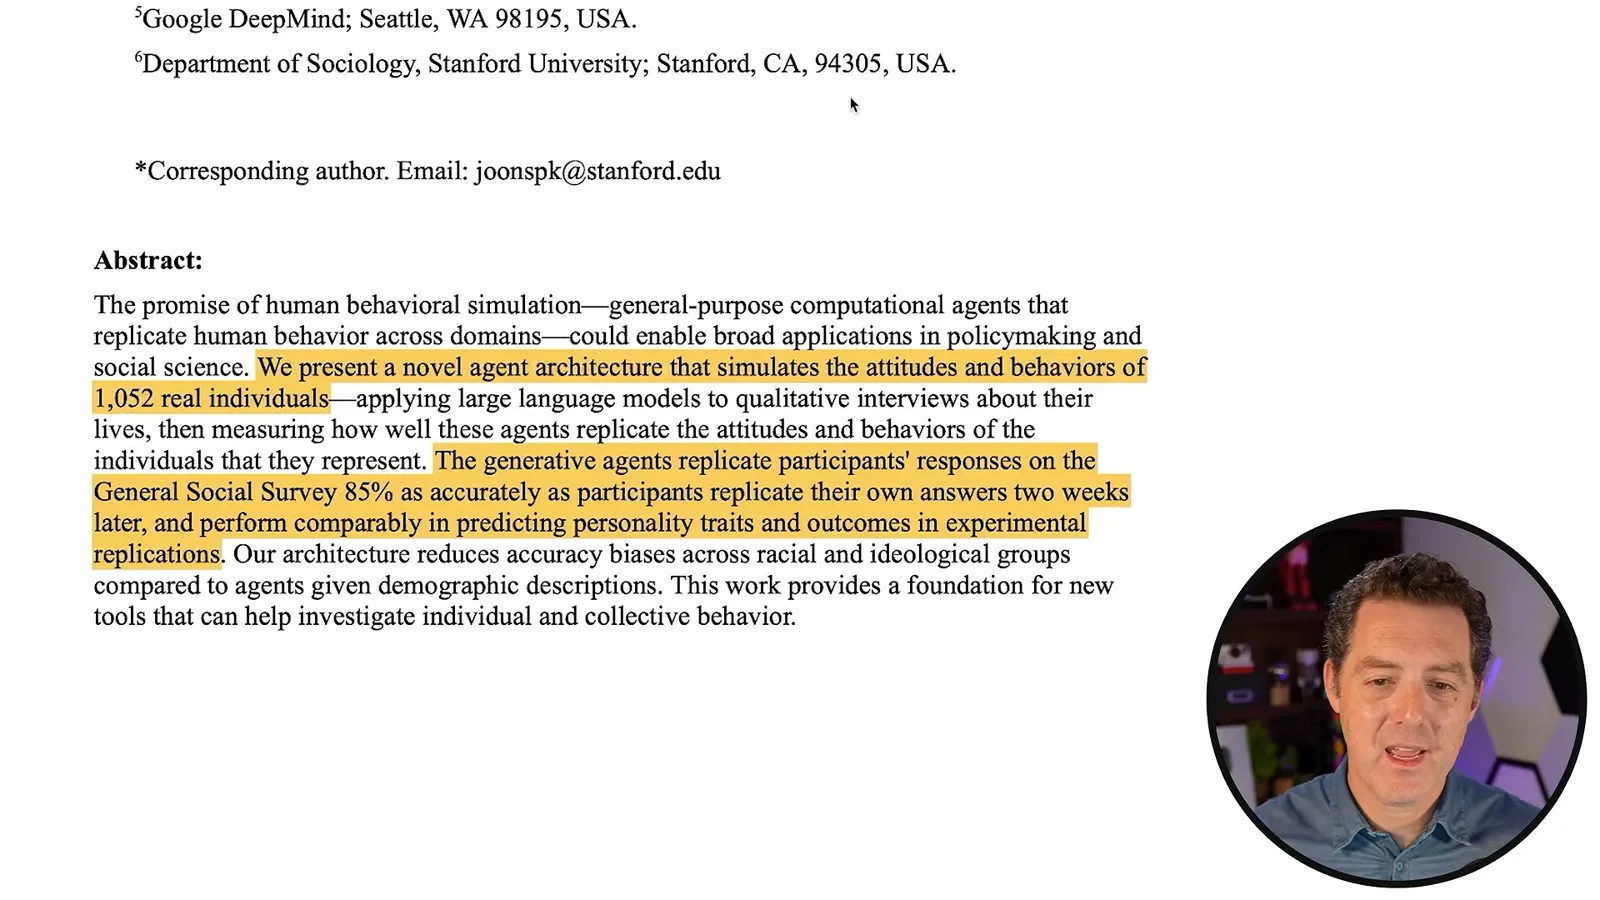
最受关注的结果来自综合社会调查(GSS)。论文报告的平均归一化准确率为 0.85:代理的预测准确率以参与者间隔两周重复回答的一致性为基准进行比较。这篇 2024 年论文报告,代理原始准确率为 68.85%,参与者重测准确率为 81.25%;0.85 是相对指标,不代表复制了一个人的 85%,也不是 85% 的原始准确率。
评估还包括大五人格量表、行为经济学博弈和社会科学实验。这些是使用不同指标的独立测试,因此不能把 GSS 数字用于所有测试。研究人员提到的潜在用途包括试点干预措施,以及研究制度和网络。
我设想在实施新税收政策之前,利用模拟人口探索人们可能如何回应。这是未来可能的用途,研究本身并未展示这一点。仅凭准确预测调查回答,并不能证明模拟社会能可靠预测政策在现实中的影响。
访谈与代理构建
参与者接受 AI 主持的半结构化访谈,并完成问卷和实验。访谈记录为模仿各参与者的代理提供上下文。
研究将语言模型与约两小时的定性访谈结合起来,并通过 GSS、大五人格、独裁者博弈和公共物品博弈等经济游戏,以及五项选定的社会科学实验评估代理。参与者还在两周后重复评估,以衡量他们自身回答的一致性。
访谈采用半结构化方式:除了共同提纲,还会根据参与者的回答提出有针对性的追问。AI 访谈员通过语音开展对话。这让人们可以详细讲述自己重视的事情,而不只是从固定问卷答案中选择。
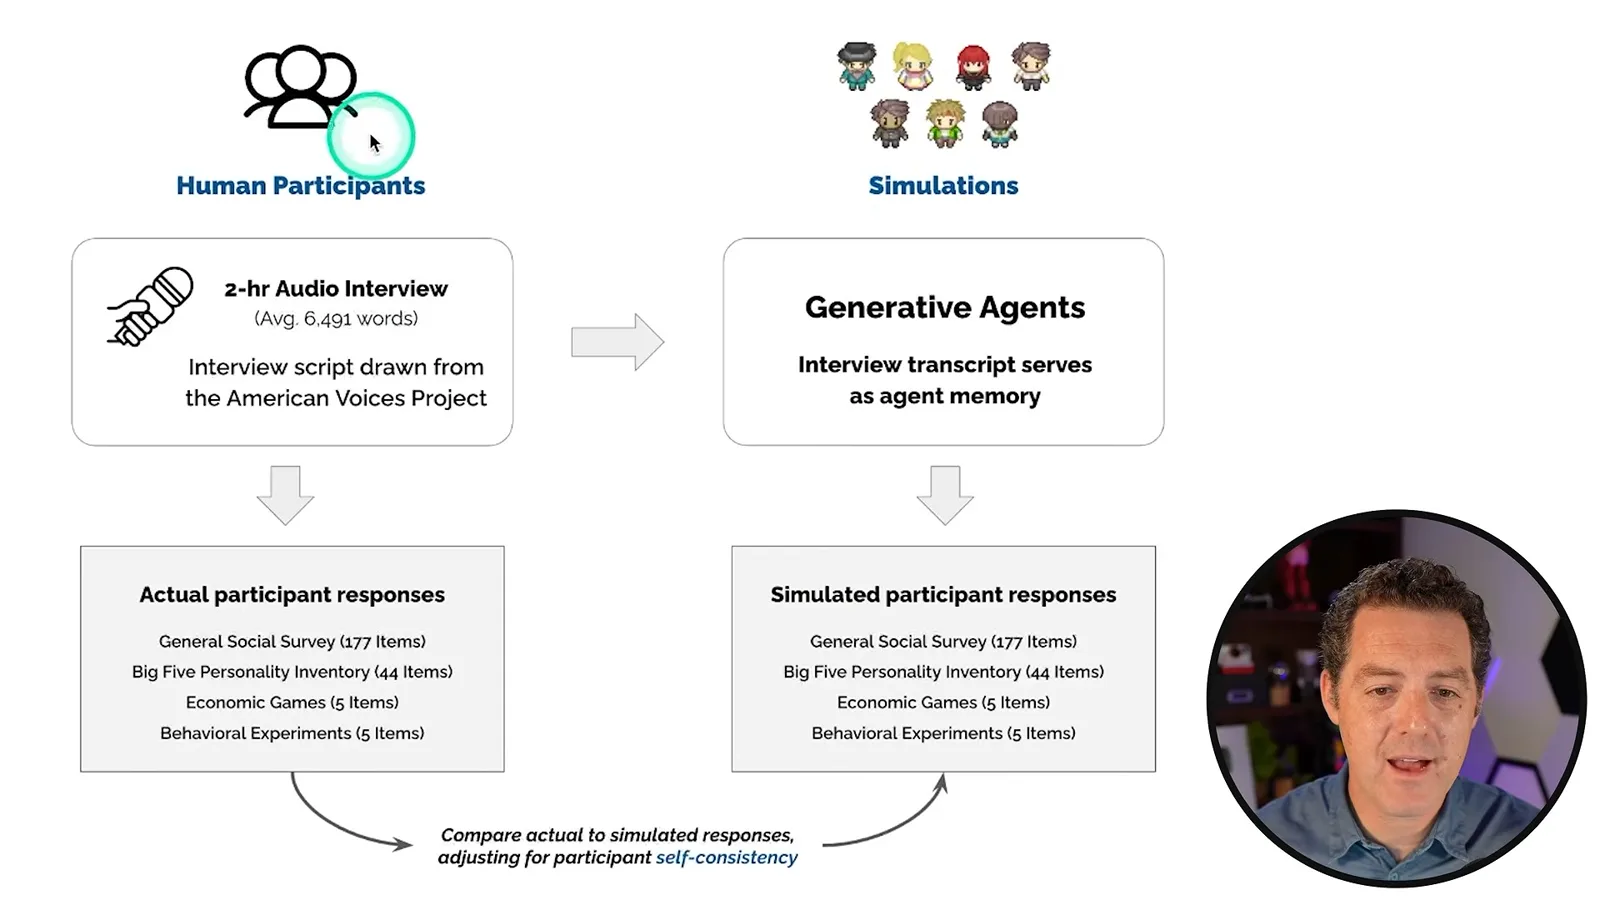
录制的访谈被转写并作为记忆提供给代理。早期生成式代理研究使用简短背景介绍和互动中形成的记忆;这项研究则把真实人的访谈记录作为上下文。研究人员提示代理模仿该参与者,并将其回答与参与者的实际回答比较。
访谈主题涵盖人生经历、教育、家庭和人际关系,也包括对社会问题的看法。访谈员根据每次回答生成后续问题。在多步骤实验中,代理还可以获得先前刺激和自身早期回答的简短描述。
准确率与访谈比较
Berman 评析调查准确率、人格测试和经济博弈中的相关系数。作者还测试了缩短的访谈和摘要,并将其与其他基线比较。
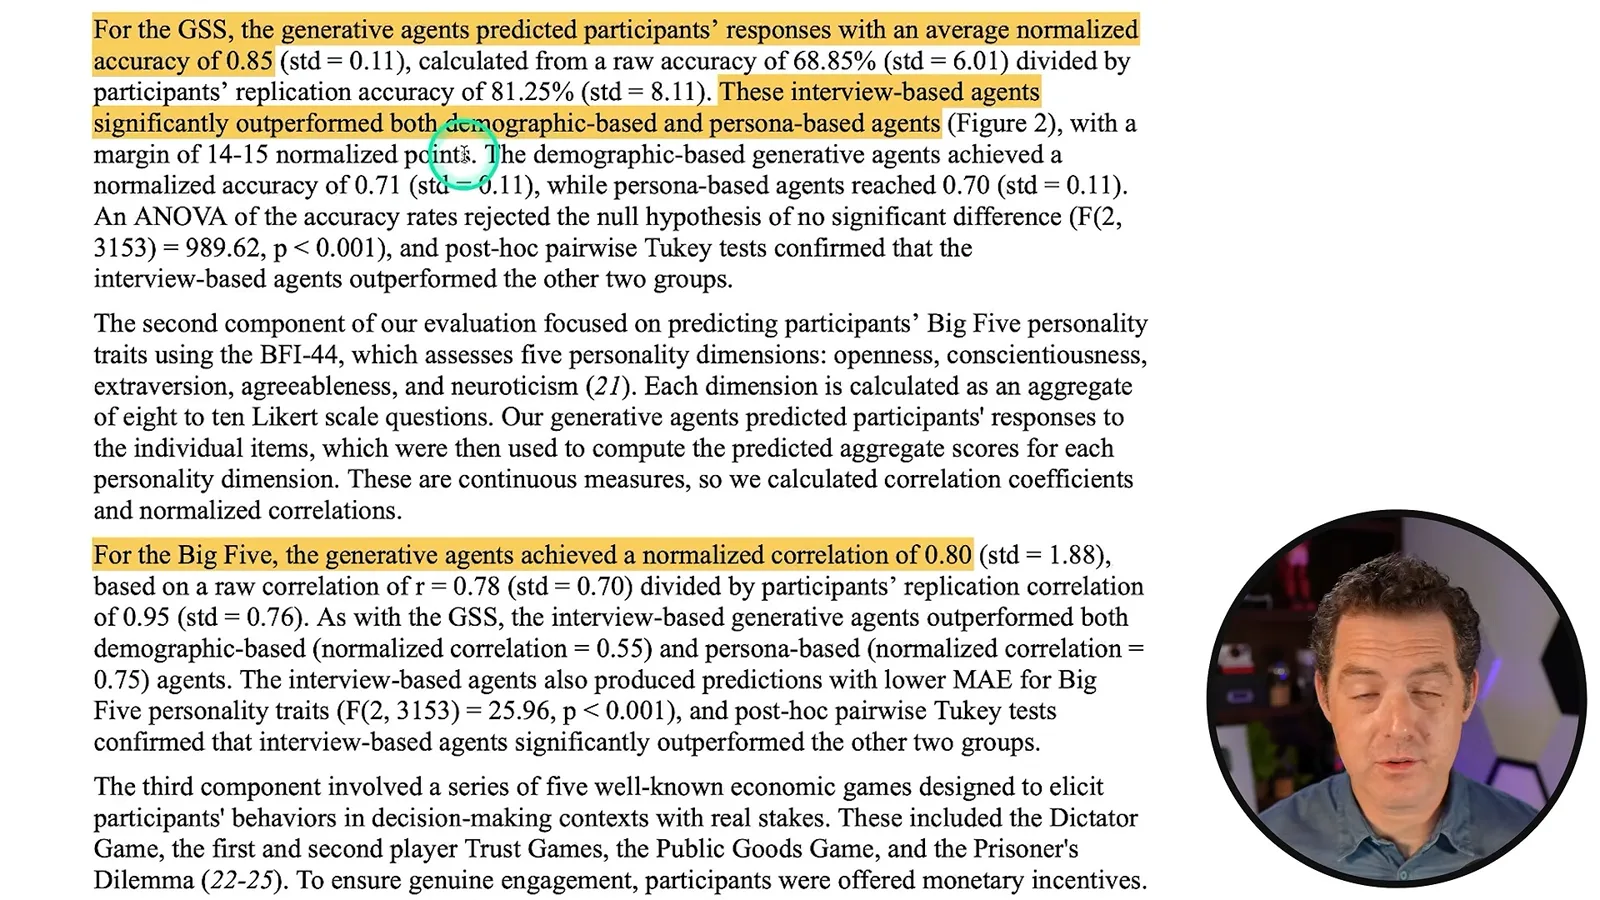
在 GSS 上,论文报告基于访谈的代理归一化准确率为 0.85,而基于人口统计的代理为 0.71,基于人物画像的代理为 0.70。我认为这表明,在这项评估中更丰富的个人信息有帮助;但这不意味着人口统计偏差已经消失,也不意味着代理完全理解了人。
大五人格测试报告的归一化相关系数为 0.80,经济博弈为 0.66。这些是以参与者重测一致性为基准归一化的相关系数,并不是正确预测的决策百分比;论文还报告,不同代理类型在经济博弈中的平均绝对误差没有显著差异。
作者随机删除 80% 的访谈记录,以测试访谈内容的作用;这相当于从 120 分钟访谈中移除约 96 分钟。使用剩余内容的访谈代理仍达到 0.79 的归一化 GSS 准确率,并在该分析中超过了根据其他参与者数据构建的组合基线。
另一项测试使用 GPT-4o 将访谈转换为要点摘要,保留事实内容并去除原始措辞。这些基于摘要的代理也表现不错,不过论文报告其归一化 GSS 准确率为 0.83,略低于使用完整访谈的代理。这一比较表明访谈中的信息有助于表现,但不能证明语言线索完全没有作用。
群体差异与未来用途
研究衡量了不同群体之间的表现差距,并报告部分指标上的差距有所缩小。Berman 推测访谈和代理可能如何生成更多数据。
研究人员还考察了政治意识形态、种族和性别群体之间预测表现的差异。对于 GSS 政治意识形态子群体,他们报告说,表现最好和最差群体之间的差距从人口统计代理的 12.35 个百分点缩小到访谈代理的 7.85 个百分点。这是一项特定测量结果,并不能证明所有偏差都已消除。
我想知道,大规模访谈是否能为模型提供信息并生成有用的合成数据。这是对研究的推测性延伸。论文的测量结果针对其招募的参与者和选定评估,因此任何更广泛的应用都需要进一步验证,并关注所代表的人群。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。
 1:03:37EN → 简体中文Matthew Berman· 2026年10月23日Matthew Berman 团队测试 Kimi K3.1:动画、游戏与图表Matthew Berman, Alex, Brian · Forward Future一场团队直播问答变成了对 Kimi K3.1 的非正式测试,内容涵盖个人智能体工作流、动态图形、浏览器游戏和基准图表。
 0:53EN → 简体中文Matthew Berman· 2026年10月22日Sam Altman 谈 AI 与新知识的发现Sam Altman · OpenAIAltman 预计,数学发现方面的进展将延伸到生物学、材料和能源领域。