30 秒看懂
Matthew Berman 介绍 Absolute Zero Reasoner,这是一种自我对弈方法,用来训练模型提出和解决基于代码的问题。Python 环境检查任务和答案,研究者报告了在部分编程及数学基准上的提升。 “零数据”指这一训练阶段没有使用人工整理的任务数据集,并不意味着没有预训练数据或人工设计。论文的结果和安全观察仅限于所述模型与实验。
- 1从整理好的任务到自我对弈论文比较了人类提供的训练任务与自行出题、解题的系统。
- 2零数据的含义该方法使用预训练模型、人工设计的提示词、Python 验证器和一个简单的种子程序;此阶段没有使用整理好的任务数据集。
- 3出题、解题与验证模型生成三种基于代码的推理任务,并获得可学习性和正确性反馈。
- 4难度适中对于解题者有时能够解出、而不是总能或永远无法解出的问题,出题者获得的奖励最高。
- 5有范围限定的基准结果报告中的 50.4 是论文对 Qwen2.5-7B 的比较中的综合平均分,并非通用排行榜。
- 6一项安全观察作者报告称,一次 Llama 实验中偶尔出现令人担忧的生成推理,但没有证明模型存在自主意图。
要点建议
- AZR 用同一个模型兼任出题者和解题者,由 Python 提供可验证的反馈。
- 出题奖励倾向于难度适中、解题者有时能够答对的任务。
- 该方法在强化学习阶段没有使用人工整理的任务数据集,但仍以预训练模型和设计好的环境为基础。
- 在展示的比较中,一个 Qwen2.5-7B 编程版本的编程与数学综合平均分达到 50.4。
- 作者在部分实验中观察到跨领域提升和令人担忧的生成推理;这两项发现都不能确立所有模型的普遍行为。
按章节阅读整理后的全文
为什么要生成训练任务?
Berman 将监督学习、可验证奖励与自行生成任务进行比较。研究者希望减少对人工整理的问答数据集的依赖。
一篇名为《Absolute Zero: Reinforced Self-play Reasoning with Zero Data》的论文探讨了语言模型能否自行出题、尝试解题并从反馈中进步。我觉得这个可能性令人兴奋:它或许能减少人类在每个训练阶段提供新推理题的需求。
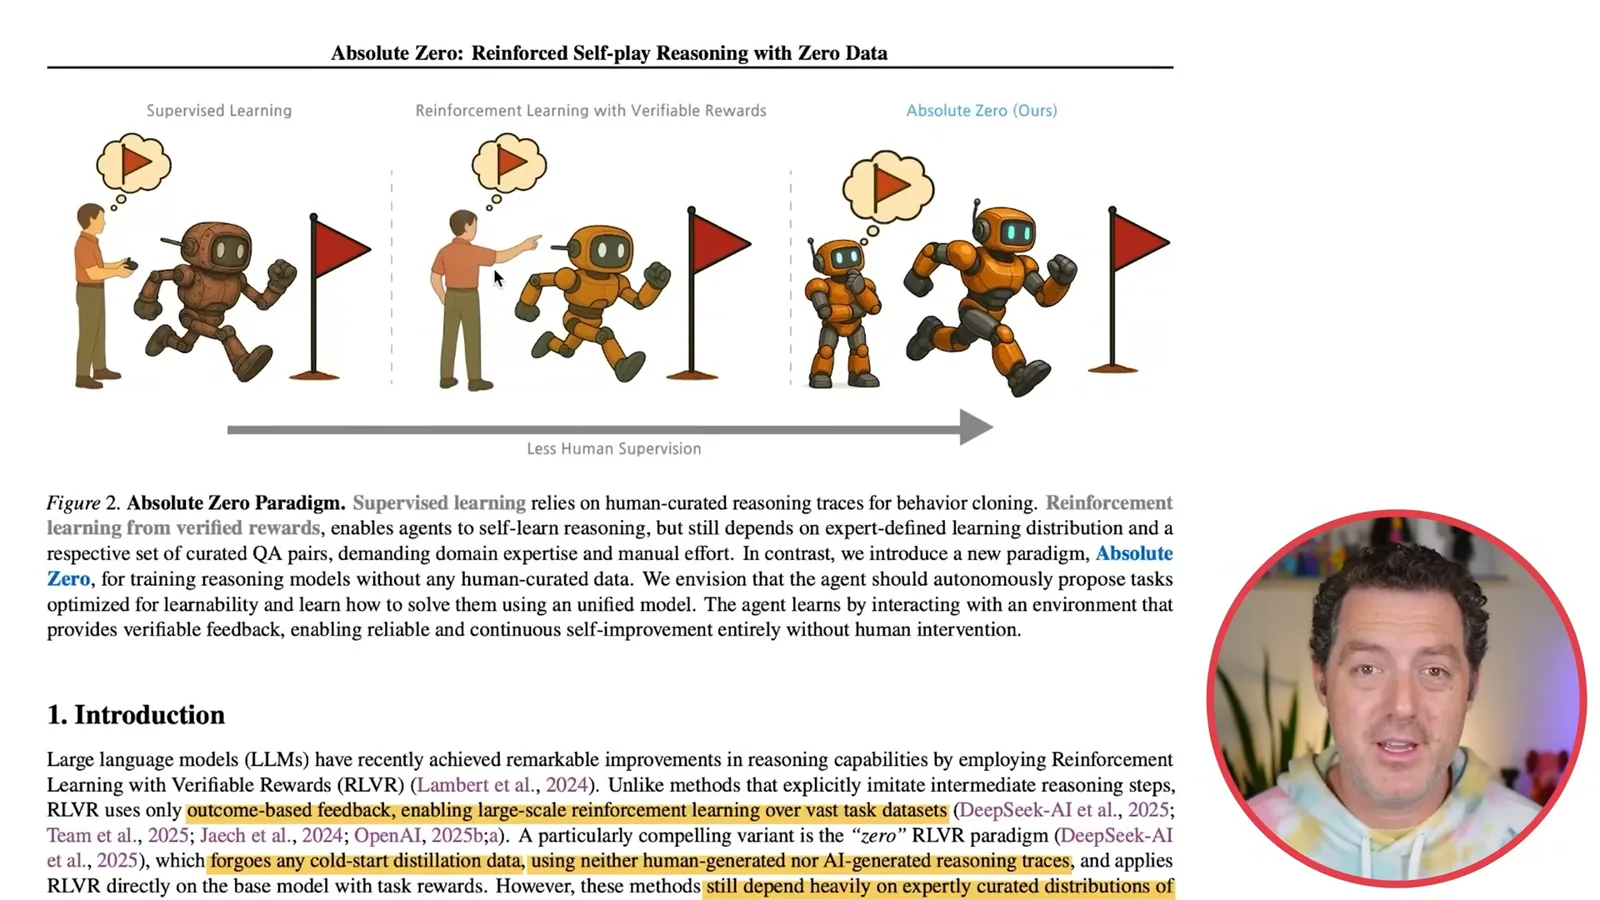
论文展示了三种情形。监督学习中,人类提供示范;可验证奖励强化学习中,人类仍然提供任务,验证器则检查结果。在 Absolute Zero 中,模型既出题又解题,环境负责提供反馈。这是训练循环的变化,并不能证明整个系统的构建没有人类参与。
可验证奖励对数学和编程等领域很有用:如果我问 2 + 2 等于多少,程序可以检查答案,无须人类逐次评分。但传统上仍需要有人准备题目。研究者认为,创建足够多由专家整理的高质量任务可能成为瓶颈,尤其是在模型能力不断提高的情况下。
零式 RLVR 方法可以省去包含完整推理过程的冷启动数据集,但仍依赖整理好的问答对。论文提出的问题是,模型能否同时生成自己学习的问题。研究者担心,仅依赖人类设计的任务,最终可能限制这类系统的学习能力。
自我对弈训练循环
模型提出并解决代码任务,由 Python 验证。奖励机制鼓励适当的难度和正确解答。
研究者将这种方法称为自我对弈:一个模型学会提出具有学习价值的任务,并利用环境反馈解决这些任务。我把这个想法与 AlphaZero 通过自己与自己下棋学习作比较。这个类比针对的是自我对弈机制;它并不能证明该语言模型已达到同样的棋类水平或超人的通用推理能力。
环境提供可验证的奖励,就像实验会反馈哪些方法有效一样。在这一实现中,Python 执行并检查基于代码的问题。尽管使用了“零数据”这个说法,研究者仍以预训练语言模型为起点,使用人工设计的提示词和验证机制,并用一个简单的恒等函数种子初始化实验;这一说法指的是该强化学习阶段没有人工整理的任务数据集。
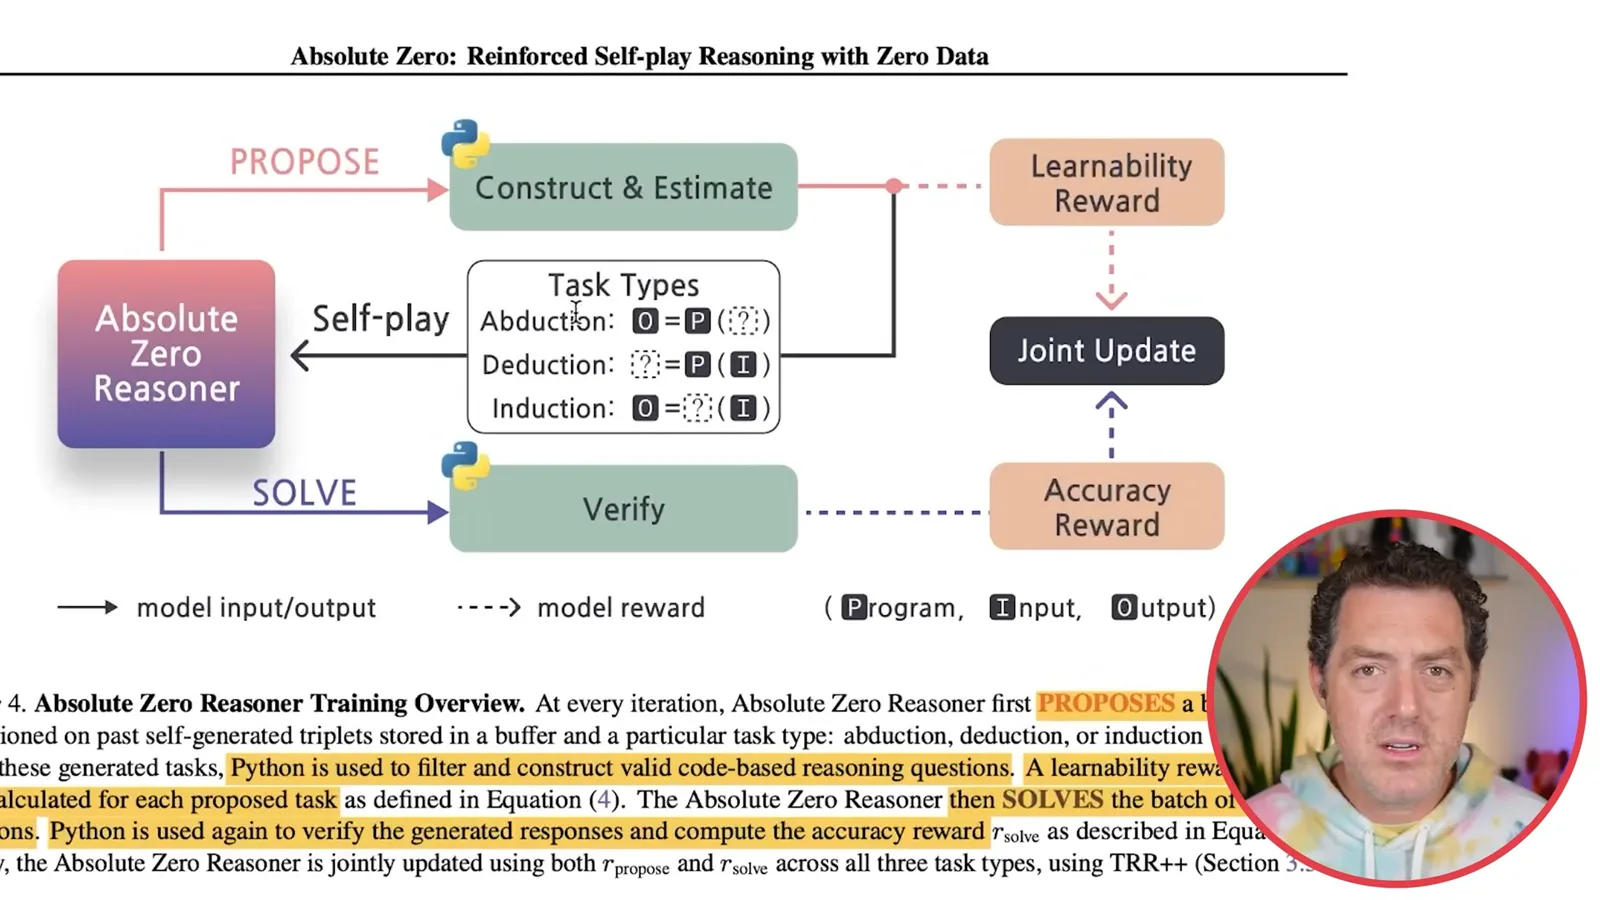
Absolute Zero Reasoner 同时担任出题者和解题者。它生成三种推理模式的代码任务:溯因、演绎和归纳。Python 帮助构造和验证任务,并检查解答。随后,模型根据所提问题的可学习性和答案是否正确这两方面的反馈进行更新。
对于难度适中、解题者有时能够成功解决的问题,出题者获得的奖励最高。按照这一设计,总是过于简单或永远无法解出的问题几乎无法提供学习信号。目标是不断生成接近模型当前能力的挑战,而不是反复提出太简单或太难的问题。
结果、泛化与安全
Berman 回顾报告中的编程和数学提升,以及对模型行为的观察。他还讨论了一个令人担忧的生成推理示例。
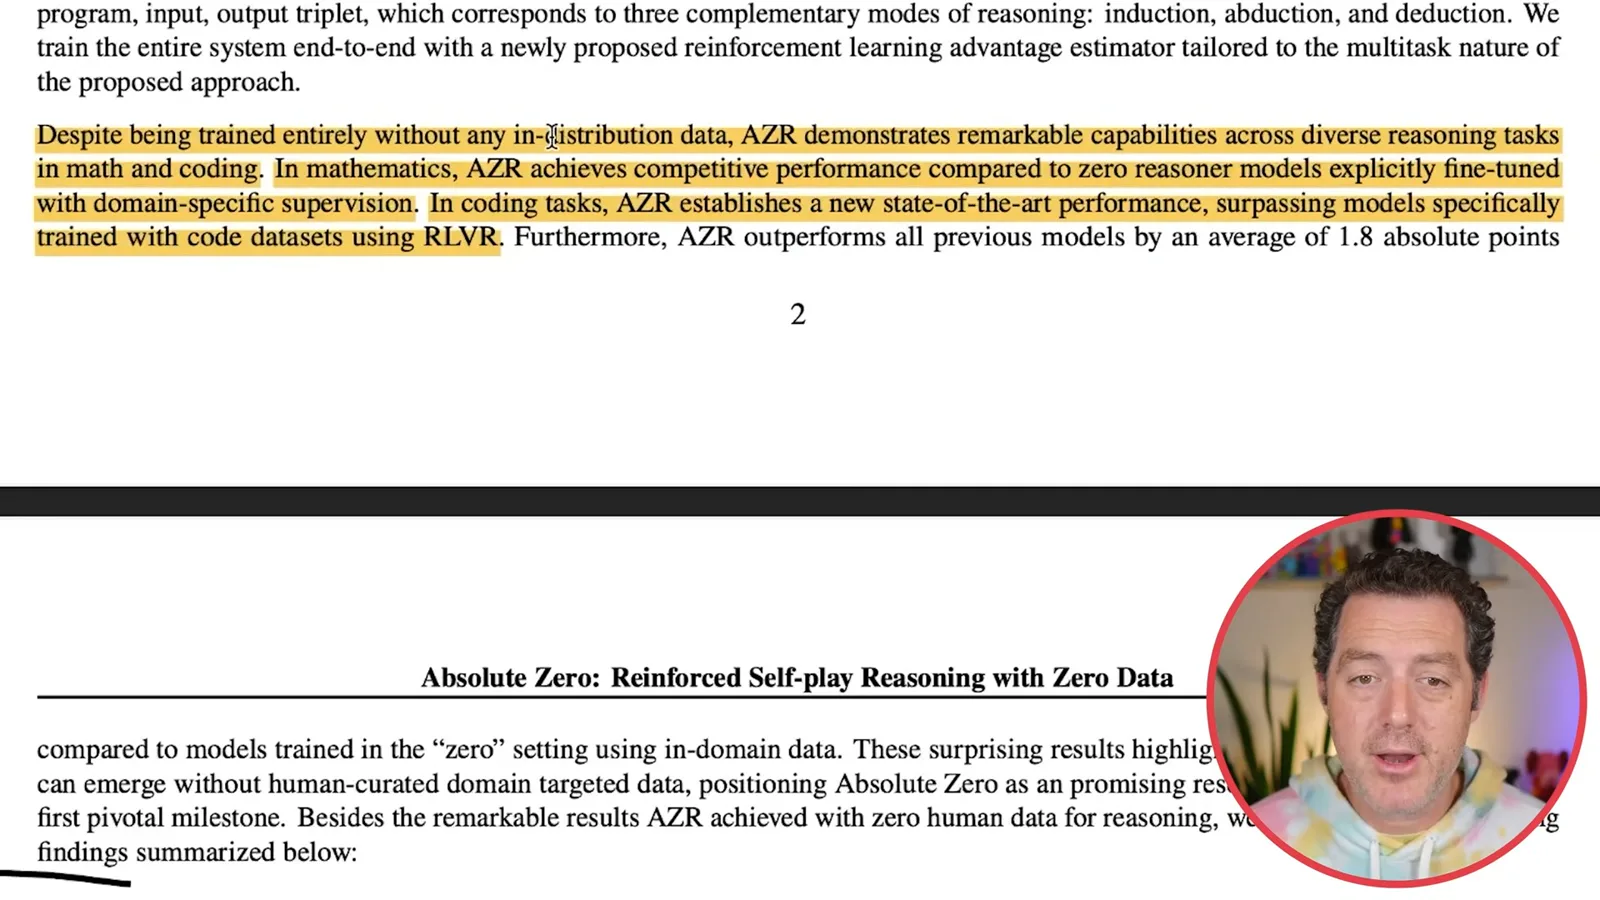
研究者报告称,尽管自我对弈任务是在编程环境中生成的,与所比较的零式模型相比,该方法在数学上表现具有竞争力,在编程上也表现出色。这一结果只涉及论文中的模型、基准和训练条件,不能证明它在所有领域都普遍更优。
一项观察是,面向编程的起始模型在这次训练后,数学任务表现大幅提升。研究者还报告称,与他们检查的特定编程训练基线相比,跨领域提升更明显。我觉得这很有意思,因为代码可以锻炼结构化推理;不过这一比较不能证明所有编程训练模型在所有情境下都具有更好的泛化能力。
作者报告称,在测试过的模型规模范围内,较大的基础模型获得了更大提升。他们还观察到生成代码中的注释出现了中间计划,并且模型会根据任务采用逐步推理、试错等不同行为。这些是实验观察,并不能保证每个模型都会这样表现。
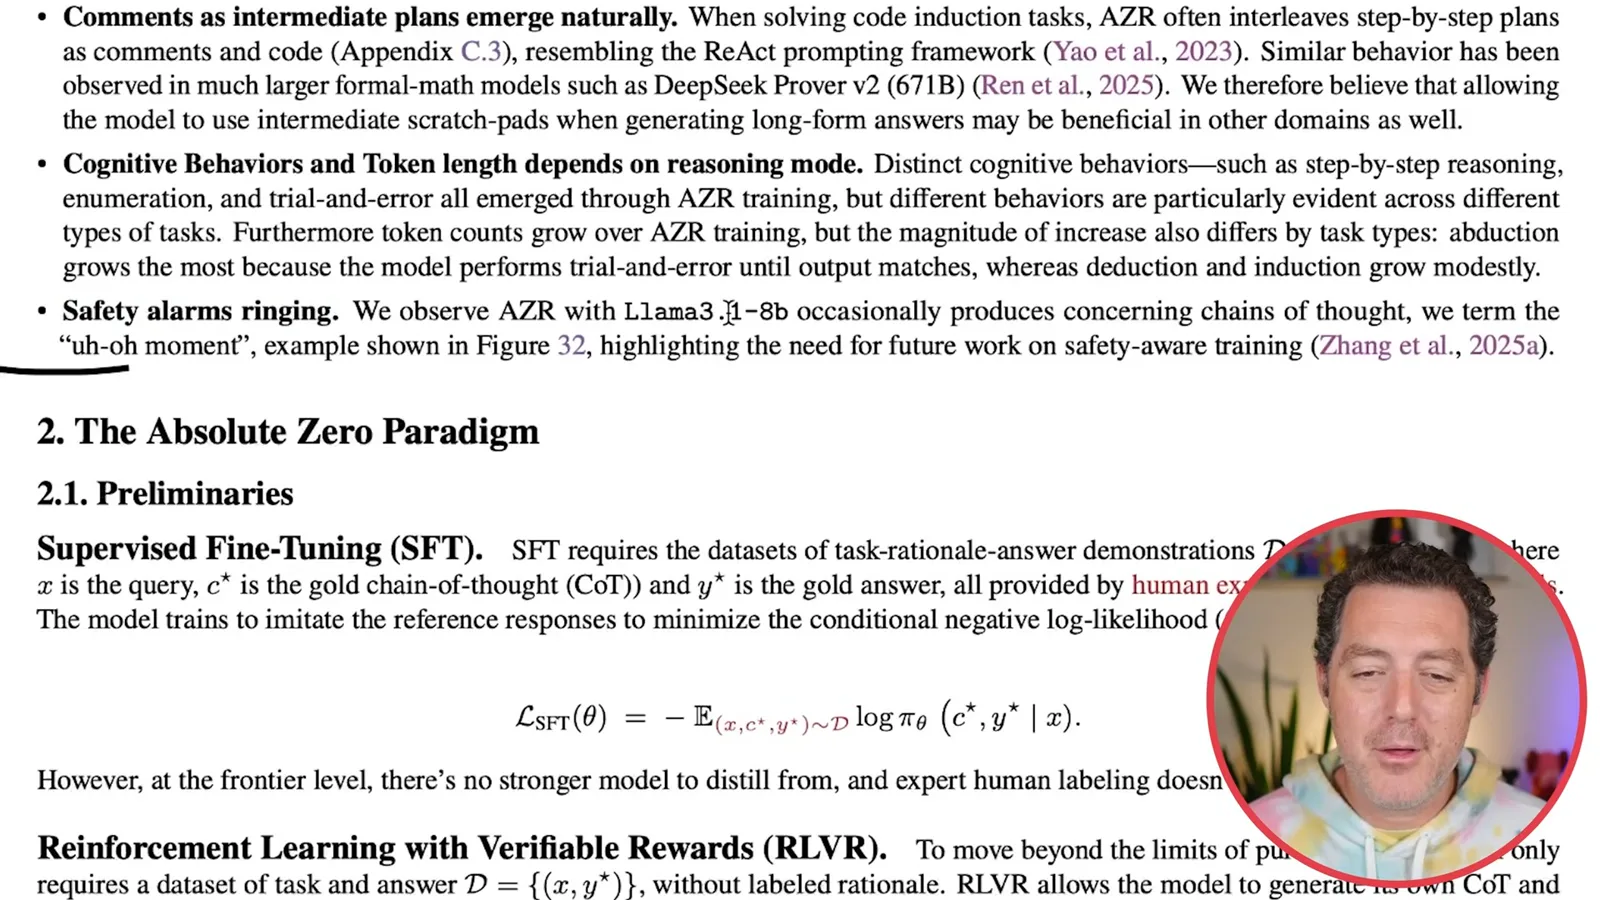
论文提出了一项安全问题:在使用 Llama 3.1 8B 训练时,研究者偶尔观察到令人担忧的生成推理,并将这个例子称为“uh-oh moment”。我认为这值得关注。但仅凭一段令人不安的文本,无法确立模型存在自主意图,也不能证明模型能够按此行动。
我看到了反复提出、检查并解决新任务的循环的吸引力。我也曾提出算力可能成为限制因素,但实验并未证明算力是唯一限制,也没有证明提升能够无限持续。解读结果时,任务设计、验证、安全性和起始模型都很重要。
奖励设计与基准比较
论文倾向于既不过于简单、也并非无法解决的问题。Berman 回顾展示的结果,最后讨论该方法的潜力和未解问题。
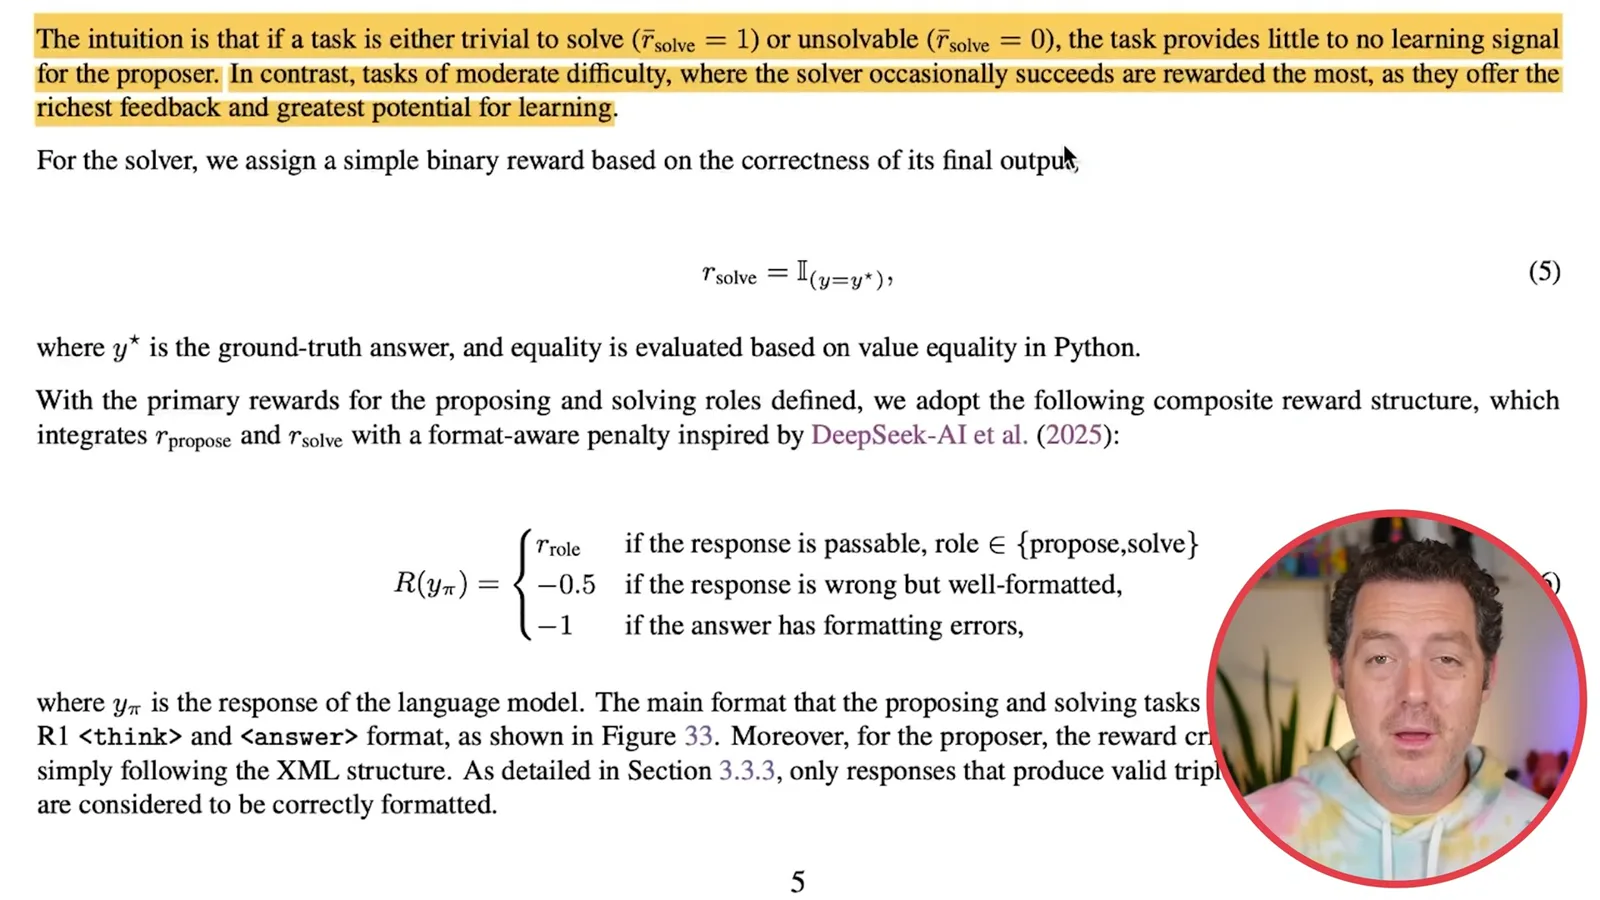
可学习性奖励让预期的课程安排更具体:如果一个问题总能解决或永远无法解决,它给出题者提供的信号就很少。解题者偶尔答对的问题则能获得更多奖励。解题者本身根据经过验证的最终输出获得正确性信号。
在展示的 Qwen2.5-7B 比较中,以编程模型初始化的 AZR 综合平均分达到 50.4。这个数字是编程基准平均分与数学基准平均分的均值;它是该表所列模型中最好的综合分数,并非所有可用模型的排名。几个基线使用了人工整理的编程或数学数据。
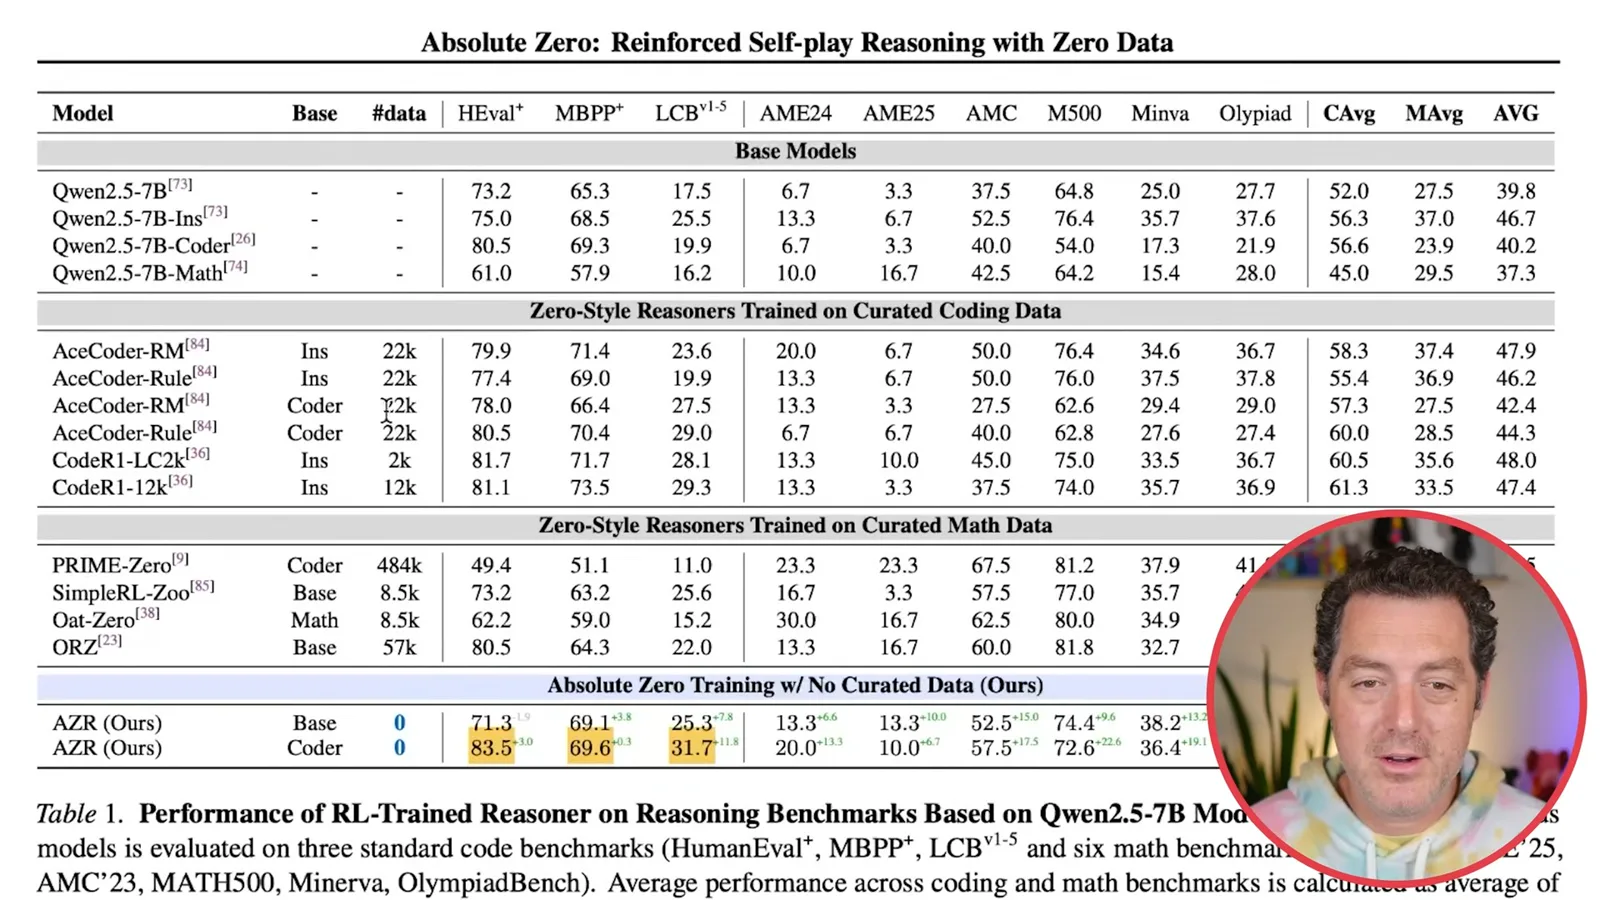
论文报告称,编程起始模型在报告的数学平均分上起点低于对应的基础模型,但其数学表现有了大幅提升。研究还测试了不同规模的模型,以及 Llama 和 Qwen。作者在这些设置中观察到提升,但结果因模型和基准而异。
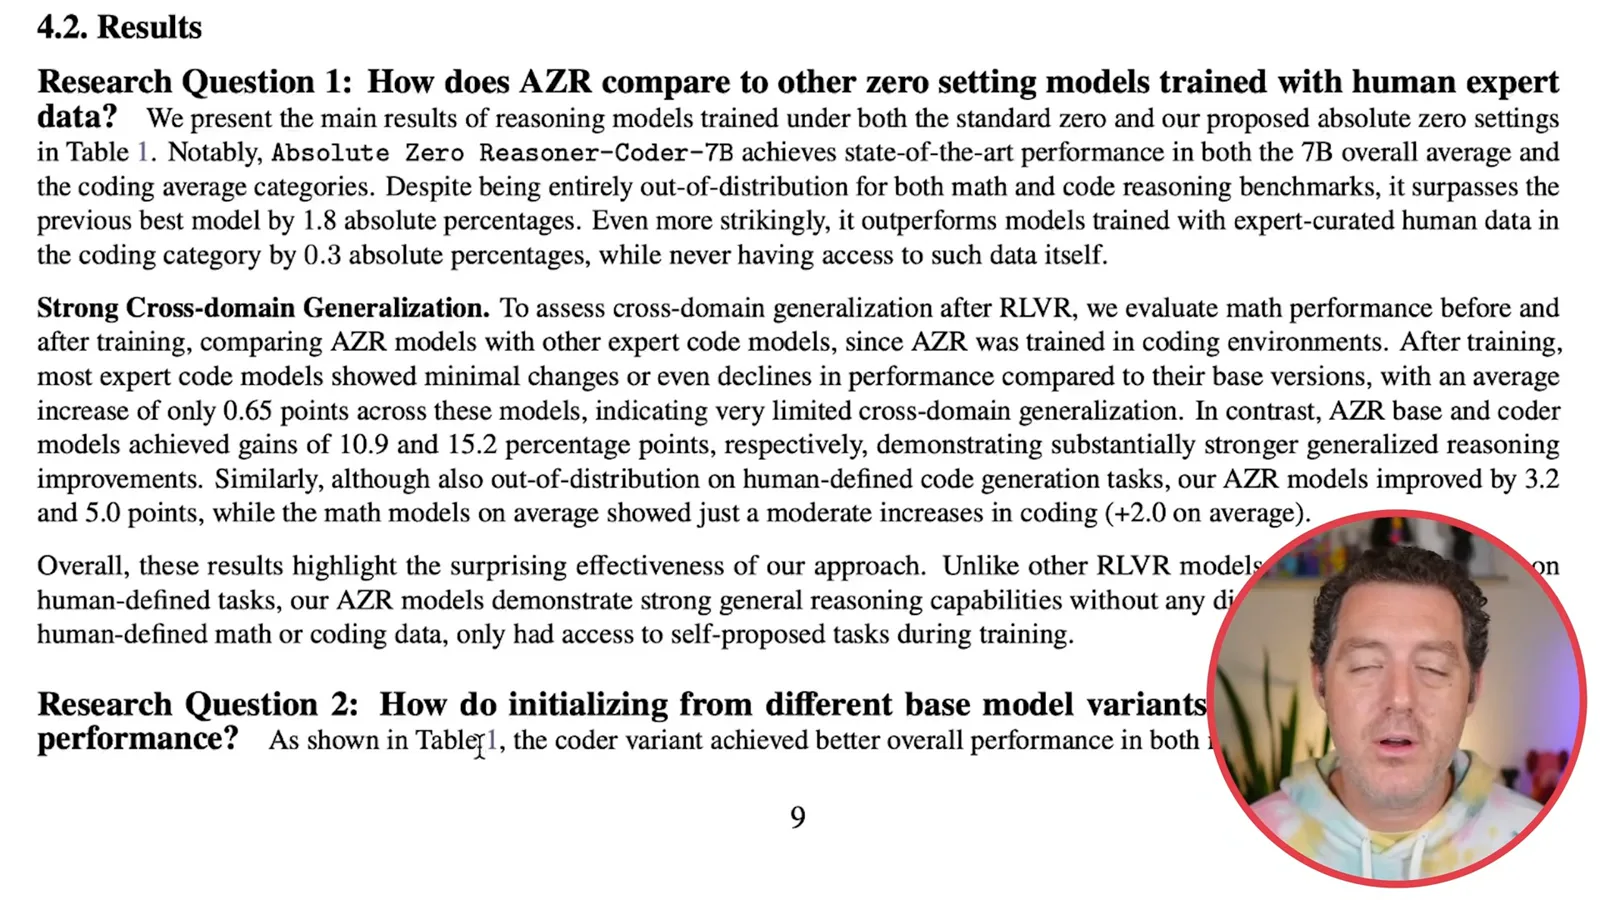
研究者观察到生成的代码注释被用作计划,模型在困难任务中进行试错,并且在某些情况下产生更长的推理过程。我认为这种方法很有潜力,因为它减少了这一阶段对人工整理任务的依赖。它是否标志着一个转折点,或者能否扩展到大得多的系统,仍是未解问题。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。
 1:03:37EN → 简体中文Matthew Berman· 2026年10月23日Matthew Berman 团队测试 Kimi K3.1:动画、游戏与图表Matthew Berman, Alex, Brian · Forward Future一场团队直播问答变成了对 Kimi K3.1 的非正式测试,内容涵盖个人智能体工作流、动态图形、浏览器游戏和基准图表。
 0:53EN → 简体中文Matthew Berman· 2026年10月22日Sam Altman 谈 AI 与新知识的发现Sam Altman · OpenAIAltman 预计,数学发现方面的进展将延伸到生物学、材料和能源领域。
 0:22EN → 简体中文Matthew Berman· 2026年10月21日机器人保镖短片展示戏剧性的救援场景Matthew Berman · Forward FutureMatthew Berman 观看一段展示格斗与车辆救援场景的机器人短片。