30 秒看懂
Matthew Berman 介绍了开源项目 LLM Colosseum,它通过格斗游戏模拟器让语言模型相互对战。他回顾项目当时的排名,猜测响应速度会影响结果,并演示安装过程和一场比赛。 画面中的结果只适用于这个实时游戏测试环境,不能确立模型能力的通用排名。
- 1实时对战Berman 展示 Mistral Small 对阵 Mistral Medium,并猜测更快的响应可能发挥作用。
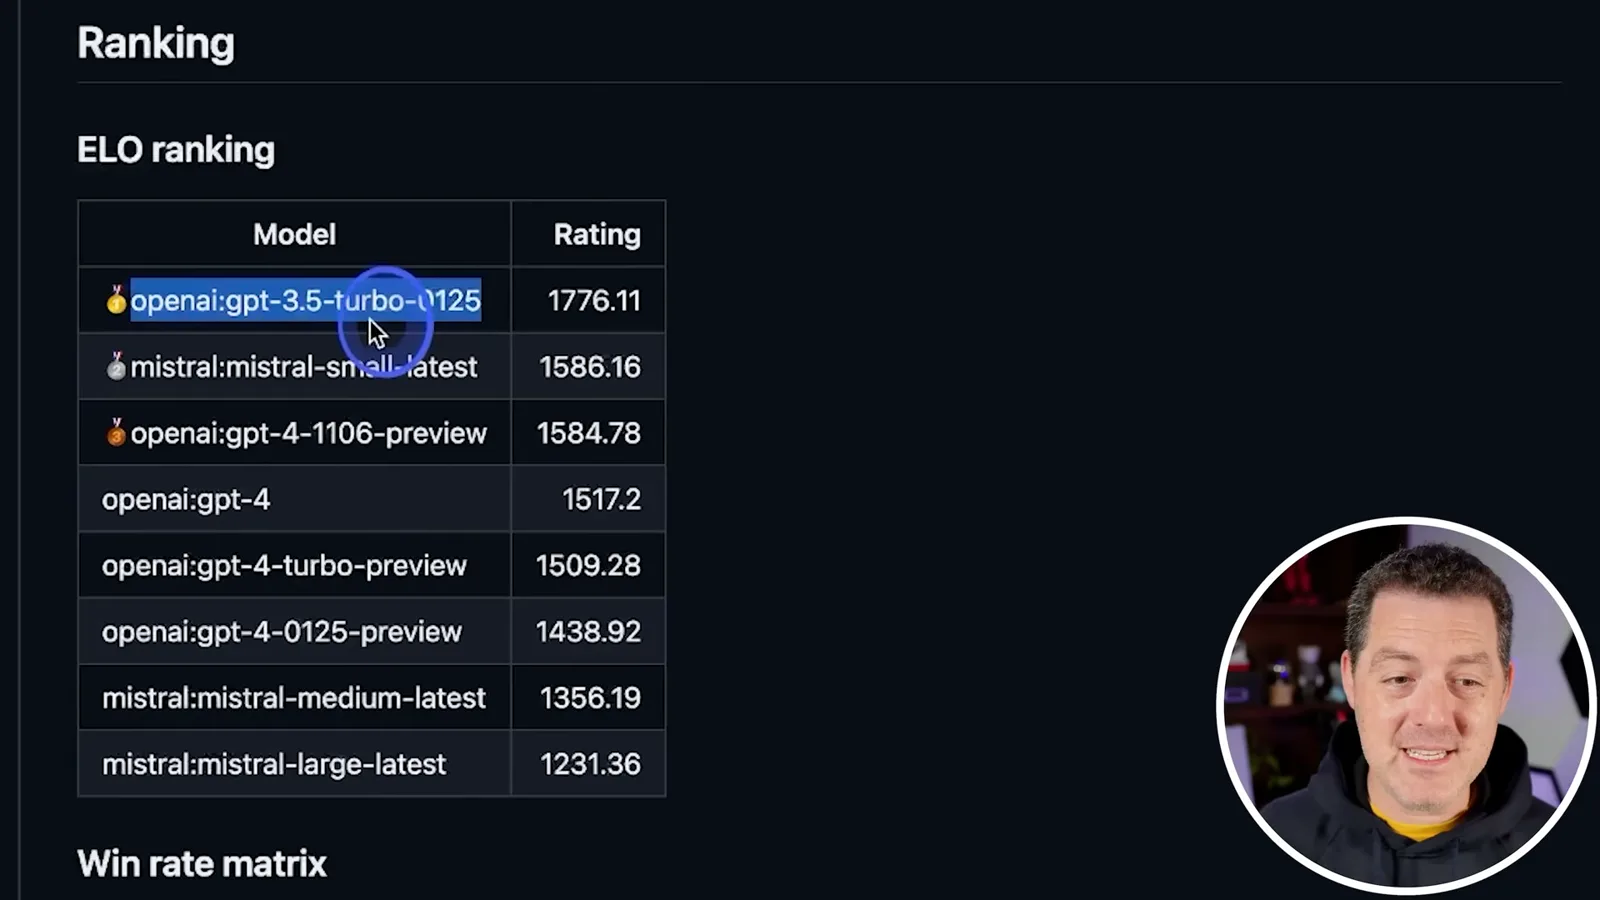
- 2历史排行榜在这份快照中,GPT-3.5 Turbo 在该游戏里排在其他展示模型之前,但这并不代表它在所有任务中领先。
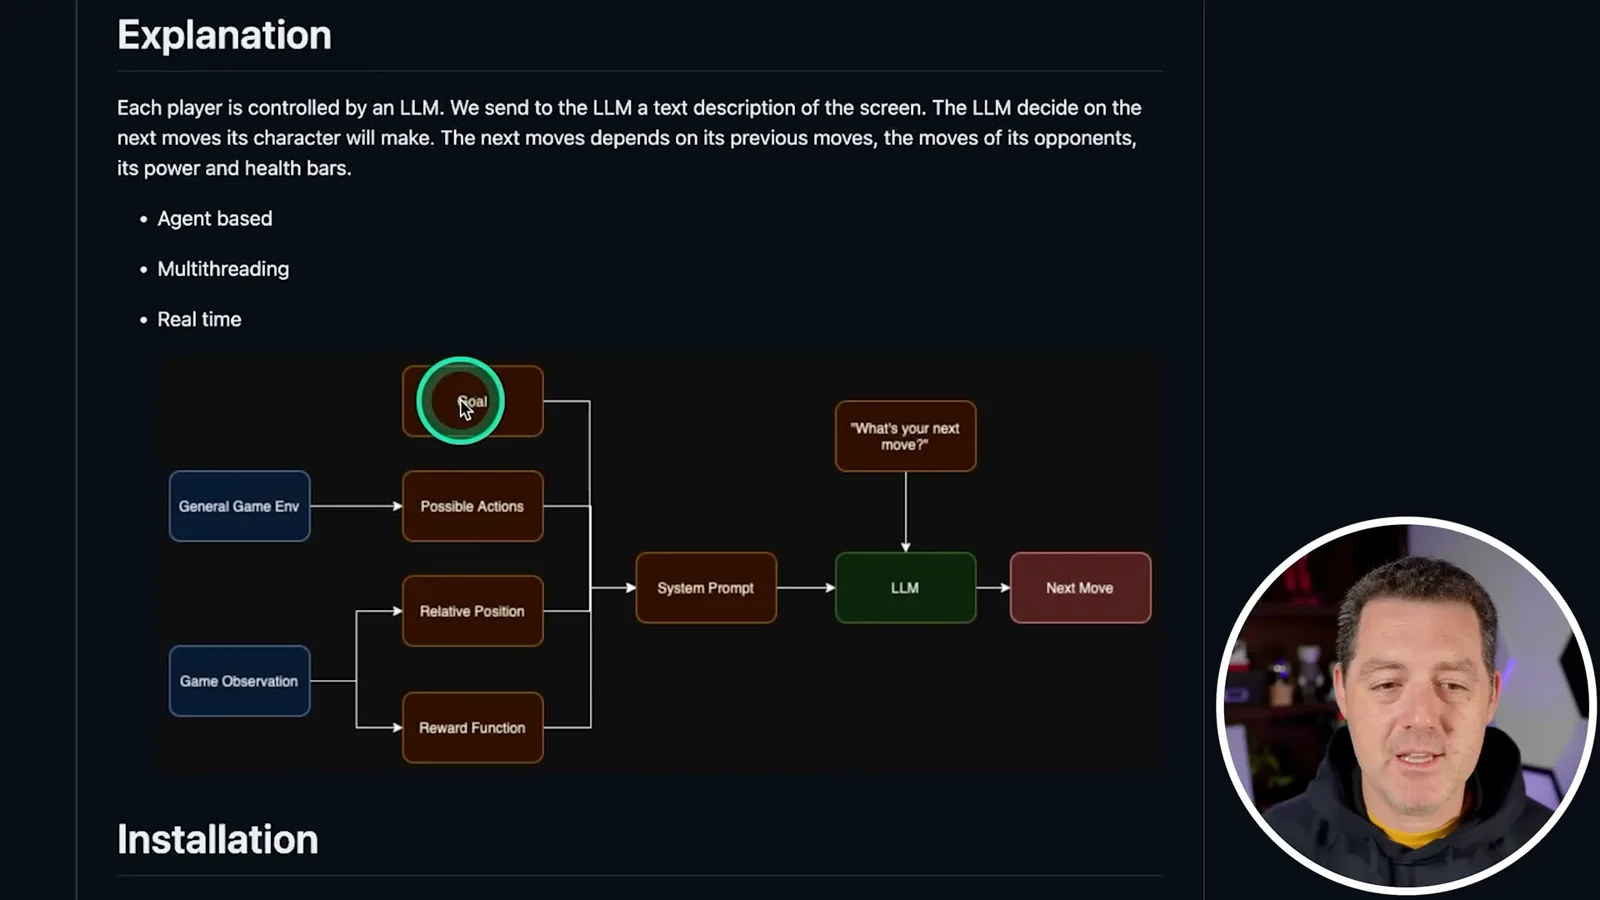
- 3从游戏状态到下一步招式测试程序把观察到的状态和可选动作转成文字提示词,再执行模型选择的招式。
- 4配置模拟器演示先使用 DIAMBRA Arena、Docker 和 Python 环境,再配置模型 API。
- 5一次演示结果Berman 表示画面中的比赛由 Mistral 获胜;一局比赛不能证明模型在各方面都更优。
要点建议
- LLM Colosseum 将游戏状态的文字描述发送给模型,再执行模型选择的招式。
- 画面中的 2024 年排行榜只反映该项目的格斗游戏评测。
- Berman 猜测推理速度会影响结果,但没有通过实验单独验证这一因素。
- 演示使用 DIAMBRA Arena、Docker、Python、兼容的 ROM 和模型 API 凭据。
- 一场演示比赛无法判定模型的整体质量。
按章节阅读整理后的全文
模型在 Street Fighter III 中对战
Berman 介绍 LLM Colosseum、一场比赛及历史排名,并猜测响应速度的重要性。
LLM Colosseum 让语言模型在 Street Fighter III 中相互对战,每个模型在游戏过程中选择招式。Stan Girard 和 Quivr 团队创建了这个开源项目。这是一种有趣的模型行为比较方式,我还会展示 2024 年 4 月使用的配置方法。
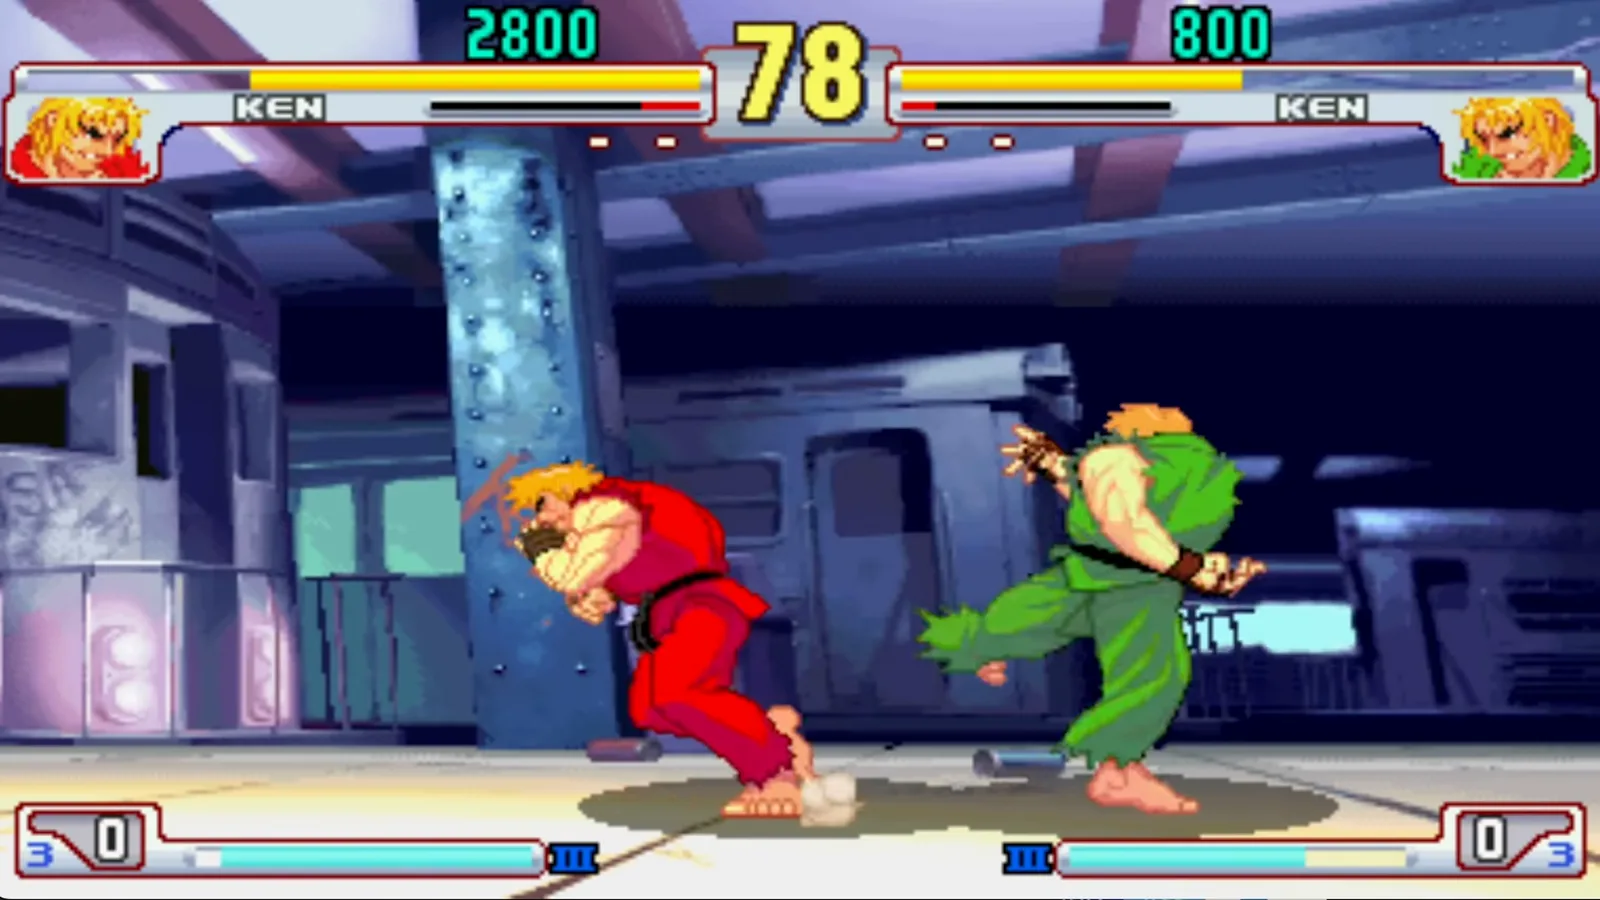
开场比赛中,我指出红色 Ken 由 Mistral Small 控制,绿色 Ken 由 Mistral Medium 控制;Small 获胜。我猜测响应速度在实时格斗游戏中影响很大,也许能解释为什么较小的模型有时会赢。这只是我的解读,并非单独测量后证明速度导致了这一结果。
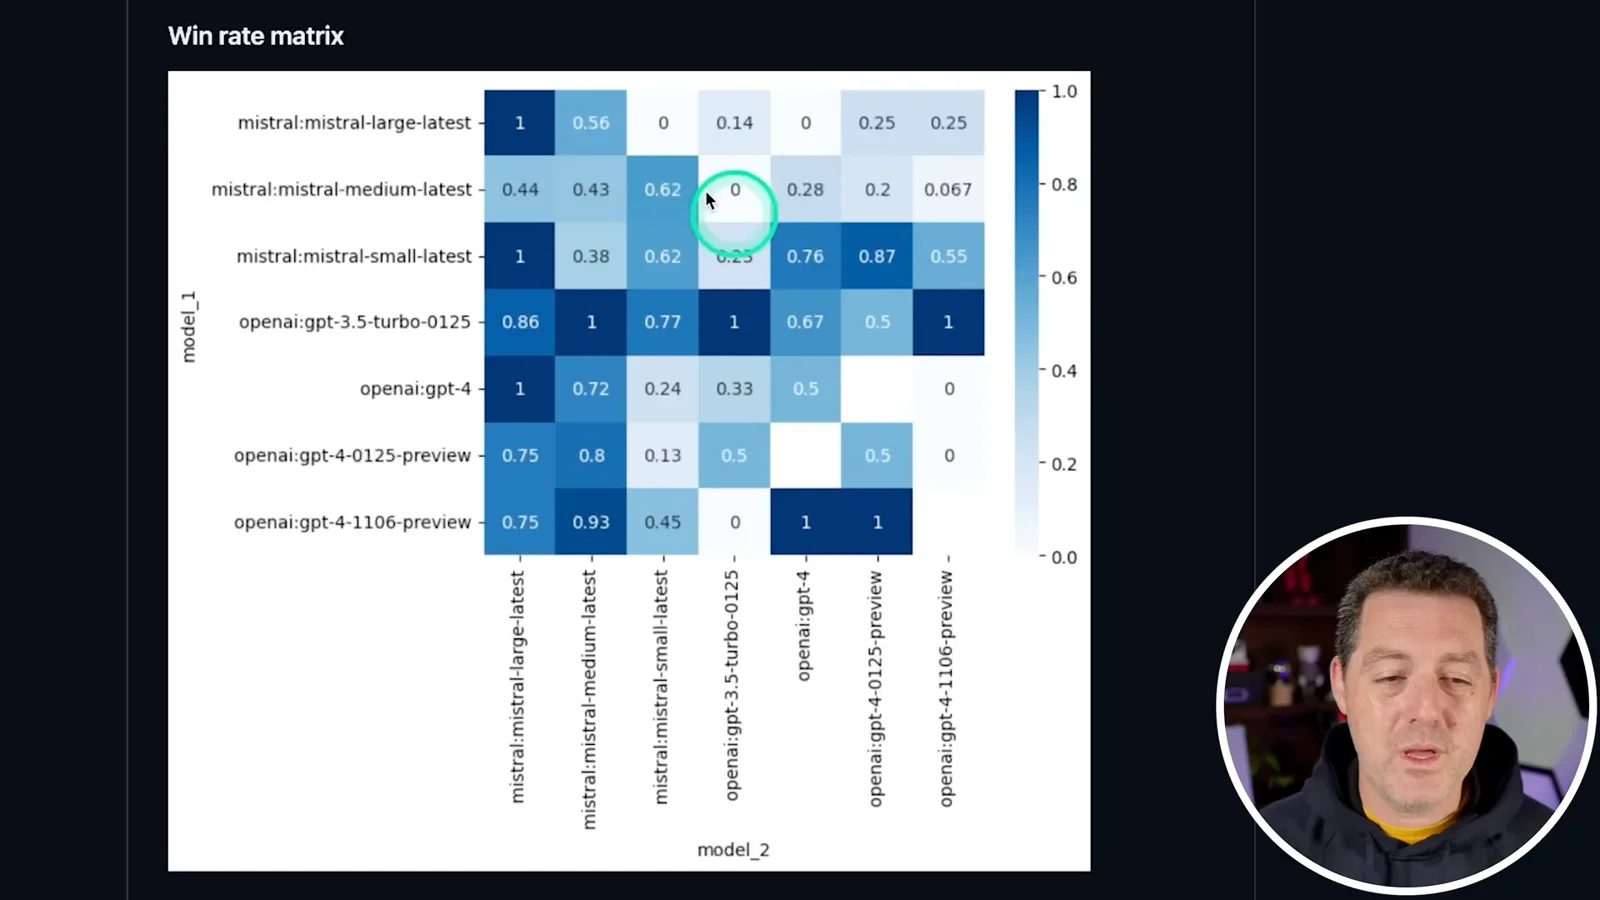
项目展示了 Elo 排名和交手胜率矩阵。在画面所示的快照中,GPT-3.5 Turbo 排在几个 GPT-4 和 Mistral 模型之前。我觉得这很令人意外,但我不确定这项基准究竟衡量了什么;这个特定游戏中的排名不应视为语言模型智能的通用排名。
游戏测试程序的工作方式
项目将游戏观察结果和可选动作转为发给各模型的文字提示词,再由模拟器执行选定的招式。
项目创建者提出,速度、战略思维、适应能力和韧性都是相关特质。系统将游戏观察结果、可用动作和目标转为提示词;每个模型收到游戏状态的文字描述,并选择下一招。游戏模拟器实时执行这些动作。
安装与演示比赛
Berman 演示 DIAMBRA、Docker、Python 和 API 配置。他配置模型并展示一场比赛,其结果只反映这次运行。
配置时,我在 VS Code 中克隆 LLM Colosseum 仓库,并安装 DIAMBRA Arena 模拟器。我注册其服务、安装 Docker,并创建一个使用 Python 3.10 的 conda 环境。激活环境后,我安装 DIAMBRA Arena,再列出支持的 ROM 来检查安装情况。
教程需要将兼容的游戏 ROM 以 ZIP 文件放入模拟器的 ROMs 文件夹。我没有提供下载地址,并讨论了游戏所有权。获取和使用 ROM 的权利取决于适用的许可和法律;仅拥有实体副本并不能确立下载任意副本的许可。
我安装 LLM Colosseum 的依赖,重新打开项目并再次激活 conda 环境。我将示例环境文件重命名为 .env,然后配置 OpenAI 和 Mistral 的 API 凭据。视频中提到录制时使用的密钥已在发布前撤销;教程中的服务接口和模型名称反映的是 2024 年的情况。
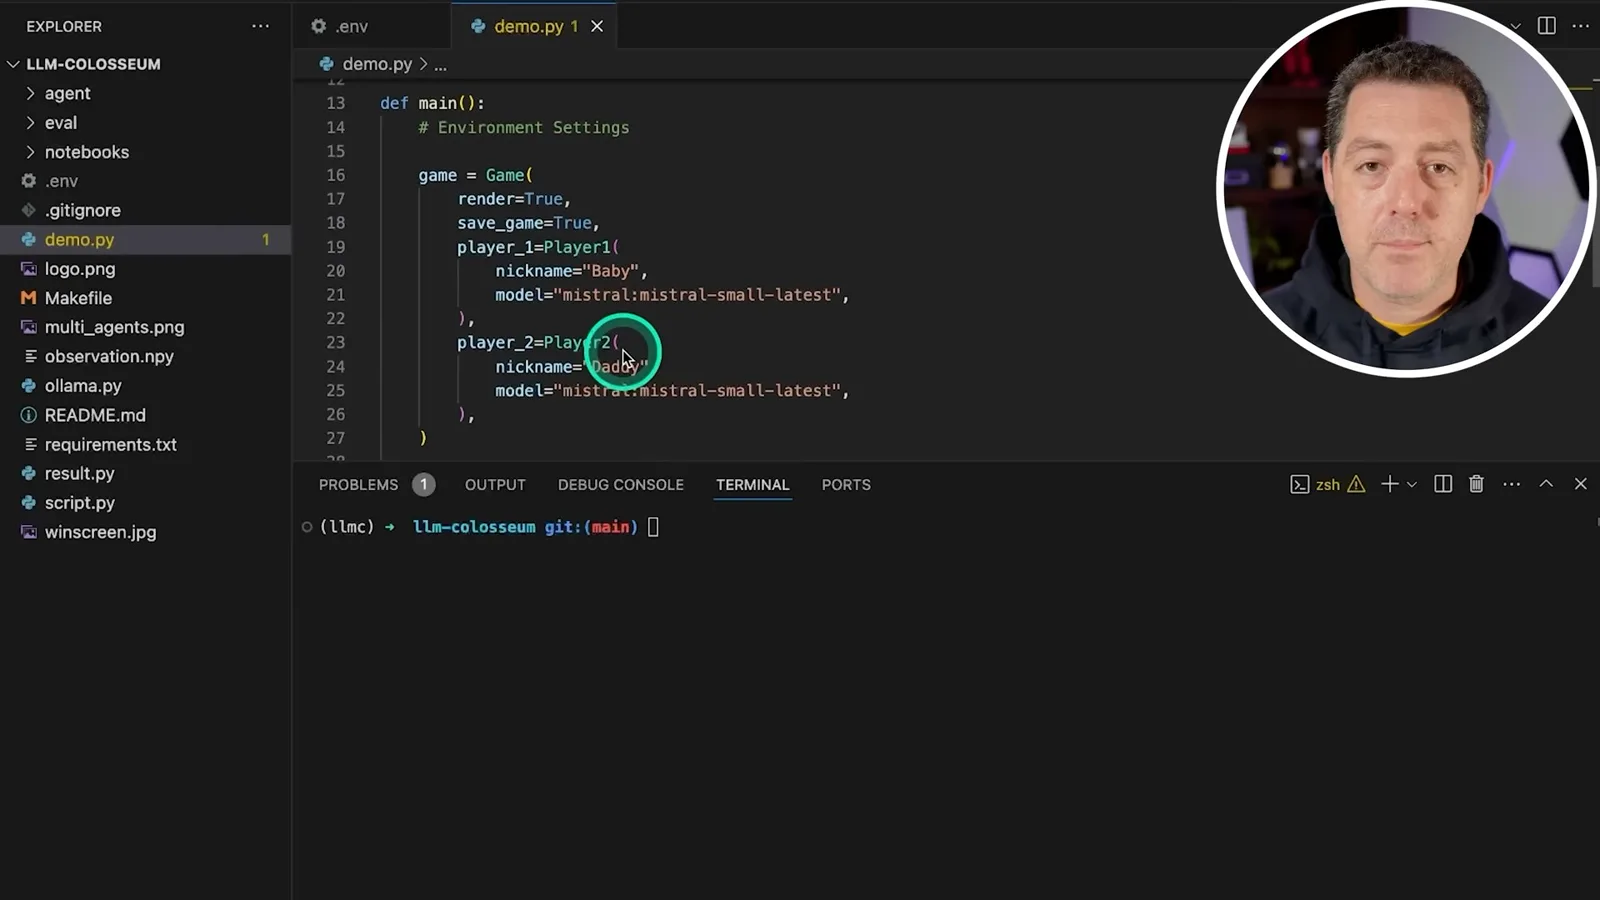
在 demo.py 中,我将一方配置为使用 Mistral 模型,另一方使用 GPT-3.5 Turbo,然后运行演示。首次运行可能需要登录 DIAMBRA,模拟器启动也需要一些时间。在展示的比赛中,我最初弄混了双方的颜色,随后纠正了自己。
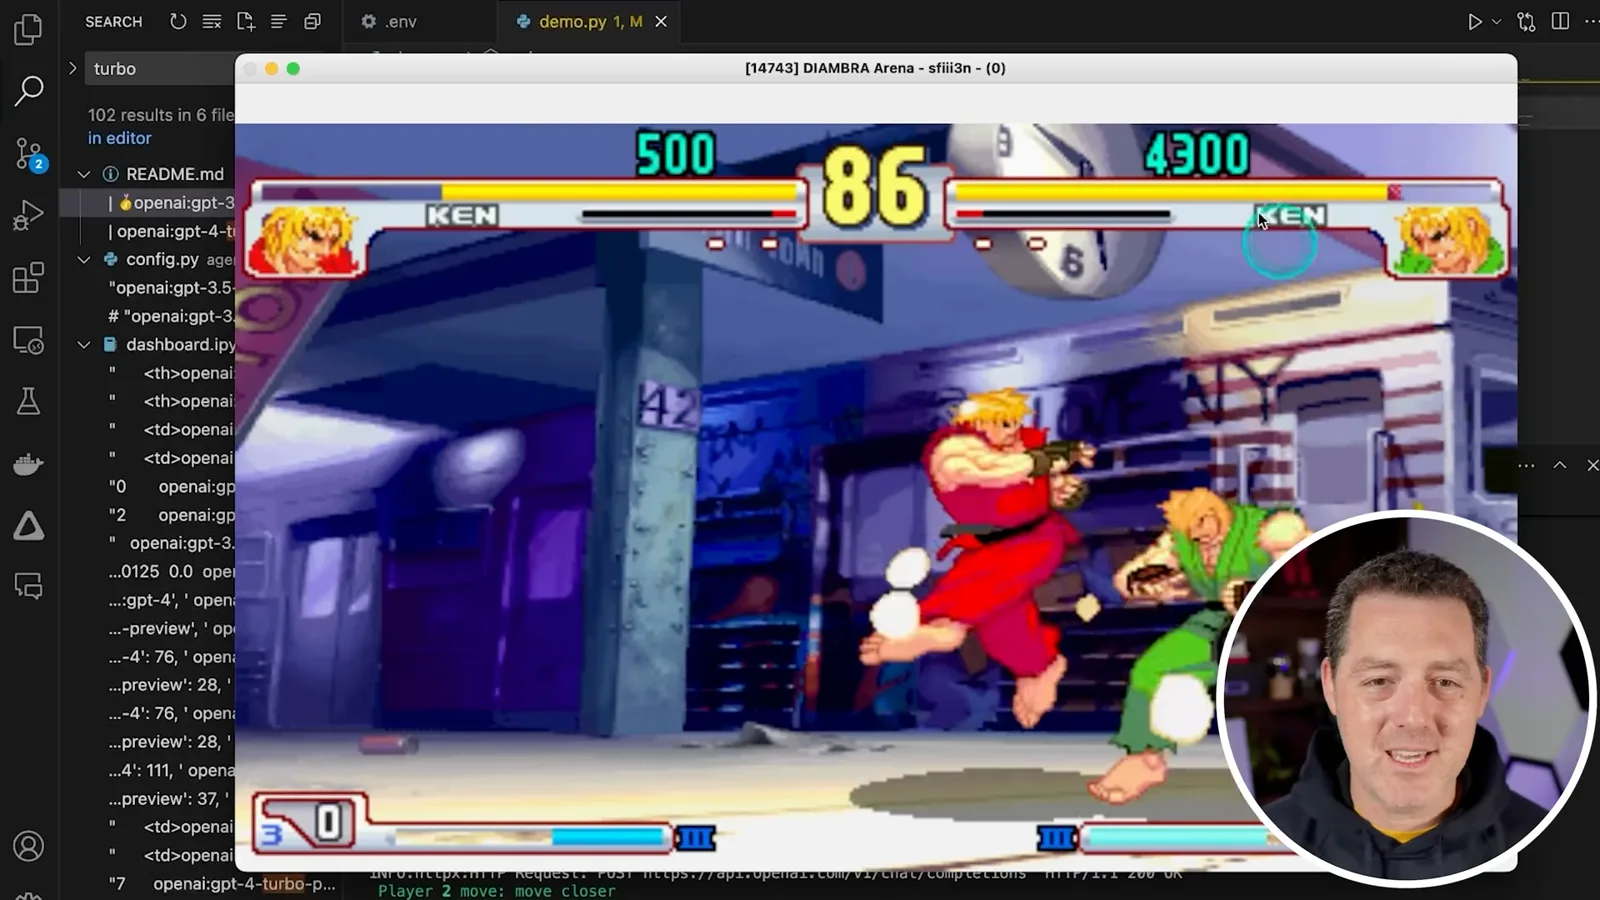
两个 Ken 角色对战时,模型不断选择招式。我说 Mistral 赢得了这场比赛,并指出项目当时在该配置下只提供 Ken。这一场比赛和画面中的排行榜只是该游戏测试环境的例子,不能作为某个模型在其他任务中更优秀的受控证据。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。
 1:03:37EN → 简体中文Matthew Berman· 2026年10月23日Matthew Berman 团队测试 Kimi K3.1:动画、游戏与图表Matthew Berman, Alex, Brian · Forward Future一场团队直播问答变成了对 Kimi K3.1 的非正式测试,内容涵盖个人智能体工作流、动态图形、浏览器游戏和基准图表。
 0:53EN → 简体中文Matthew Berman· 2026年10月22日Sam Altman 谈 AI 与新知识的发现Sam Altman · OpenAIAltman 预计,数学发现方面的进展将延伸到生物学、材料和能源领域。
 0:22EN → 简体中文Matthew Berman· 2026年10月21日机器人保镖短片展示戏剧性的救援场景Matthew Berman · Forward FutureMatthew Berman 观看一段展示格斗与车辆救援场景的机器人短片。