30 秒看懂
Matthew Berman 评述 Alibaba Group 的研究系统 EMO。该系统利用参考图像和人声音频生成富有表情的人像视频。他解释了扩散架构、稳定控制、报告的数据集和局限,并强调逼真的合成画面可能错误呈现一个人说过的话。 他还讨论了 Jensen Huang 关于自然语言计算的一段讲话,并认为学习基础编程对系统性解决问题仍有价值。
- 1从图像和音频到视频EMO 根据提供的人声音频让参考人像动起来,因此画面中的人不一定实际说过或唱过这段录音。
- 2扩散与控制该架构结合帧和音频特征、速度及面部区域信号来生成视频帧。
- 3稳定性挑战作者用控制机制应对抖动和扭曲,同时承认仍可能出现伪影。
- 4研究局限论文报告,该方法生成速度比非扩散方法慢,也可能意外生成身体部位伪影。
- 5编程的讨论Huang 强调领域专业知识与自然语言计算;Berman 仍重视通过学习代码培养系统性思维。
要点建议
- EMO 根据一张参考图像和人声音频生成人像说话或唱歌的视频。
- 该研究不仅旨在生成唇部动作,还要生成表情和头部运动。
- 论文使用稳定控制,但承认扩散生成耗时较长,并可能产生身体部位伪影。
- 报告的比较结果适用于研究所选的数据和指标。
- Berman 将更容易使用的 AI 媒体工具与编程及领域专业知识的讨论联系起来。
按章节阅读整理后的全文
合成人像示例
Berman 以生成的唱歌和说话人像开场,询问人们如何判断真实性,并介绍 EMO 的图像和音频输入。
当看似真实的视频不再能证明画面中的人说过或唱过音频内容时,会发生什么?我以一些看起来令人信服、实际上是合成的生成式人像示例开场。这项技术引出了人们如何判断网上所见内容真实性的问题。
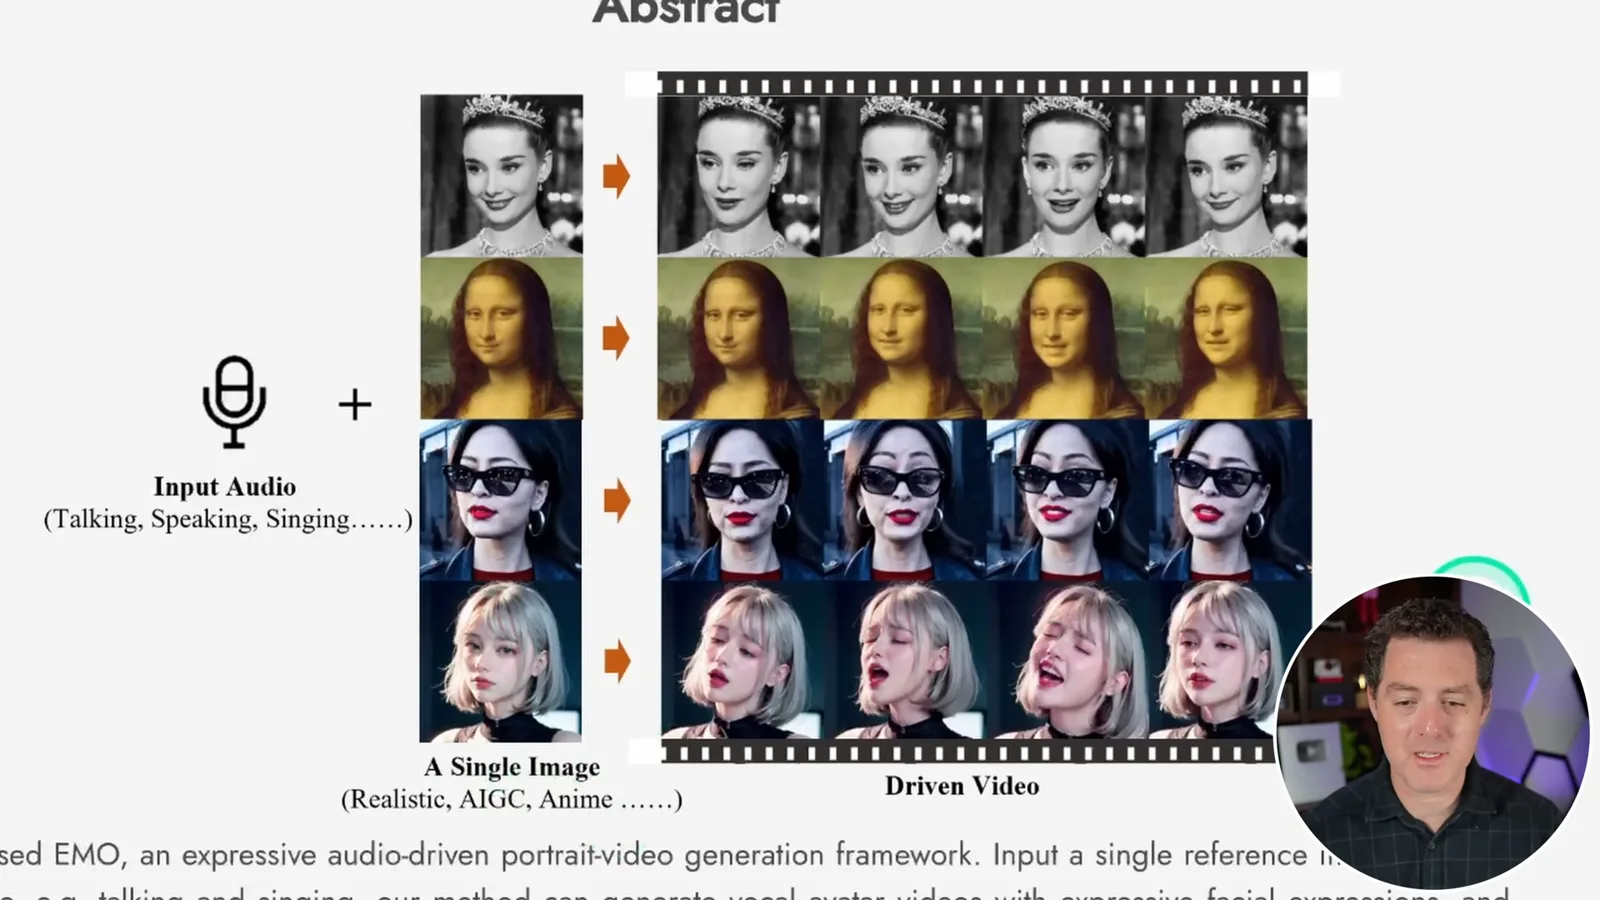
Alibaba Group 的研究项目 EMO 全称为 Emote Portrait Alive。它接收一张参考图像和人声音频,生成看起来在说话或唱歌的人像视频。示例包括一张老电影画面、《蒙娜丽莎》、Sora 视频中的 AI 生成角色和一个插画角色。画面中的表演是生成的,所描绘的人不一定实际说过提供的音频。
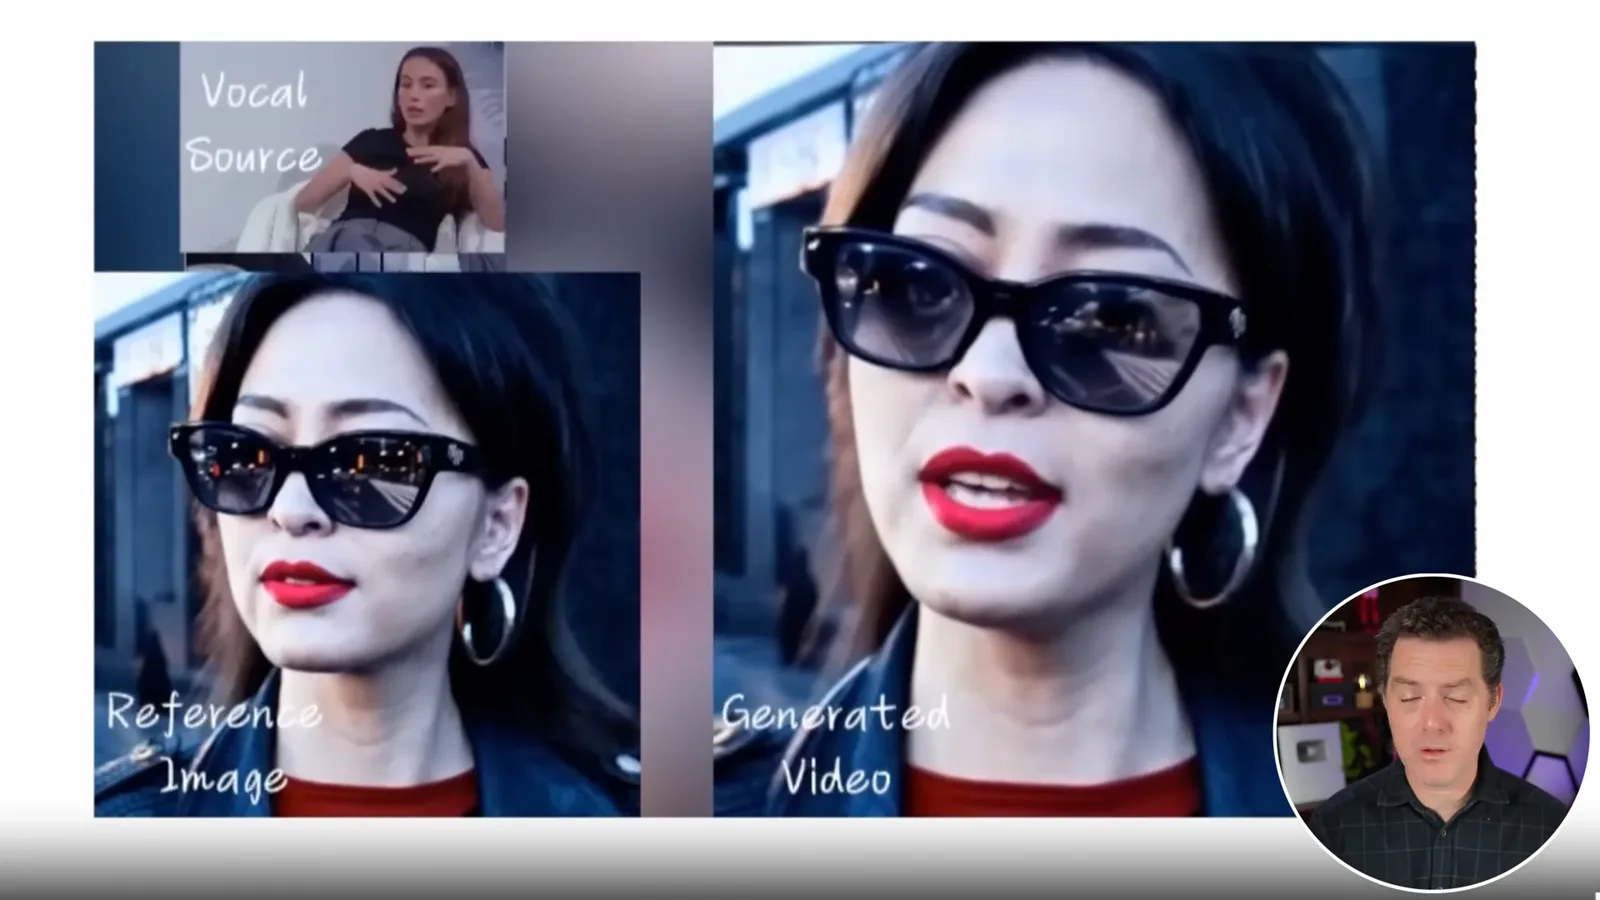
项目图示展示的不只是嘴唇运动:表情和头部姿态也会随着音频变化。一个比较用同一张图像展示唱歌和说话。另一个示例将单独的声音来源应用到 Sora 中的合成女性角色上,在选定演示中生成了看起来令人信服的说话人像。
EMO 如何生成人像视频
他介绍扩散架构、表情动作、稳定控制、训练数据和比较结果。论文还指出生成时间和伪影方面的局限。
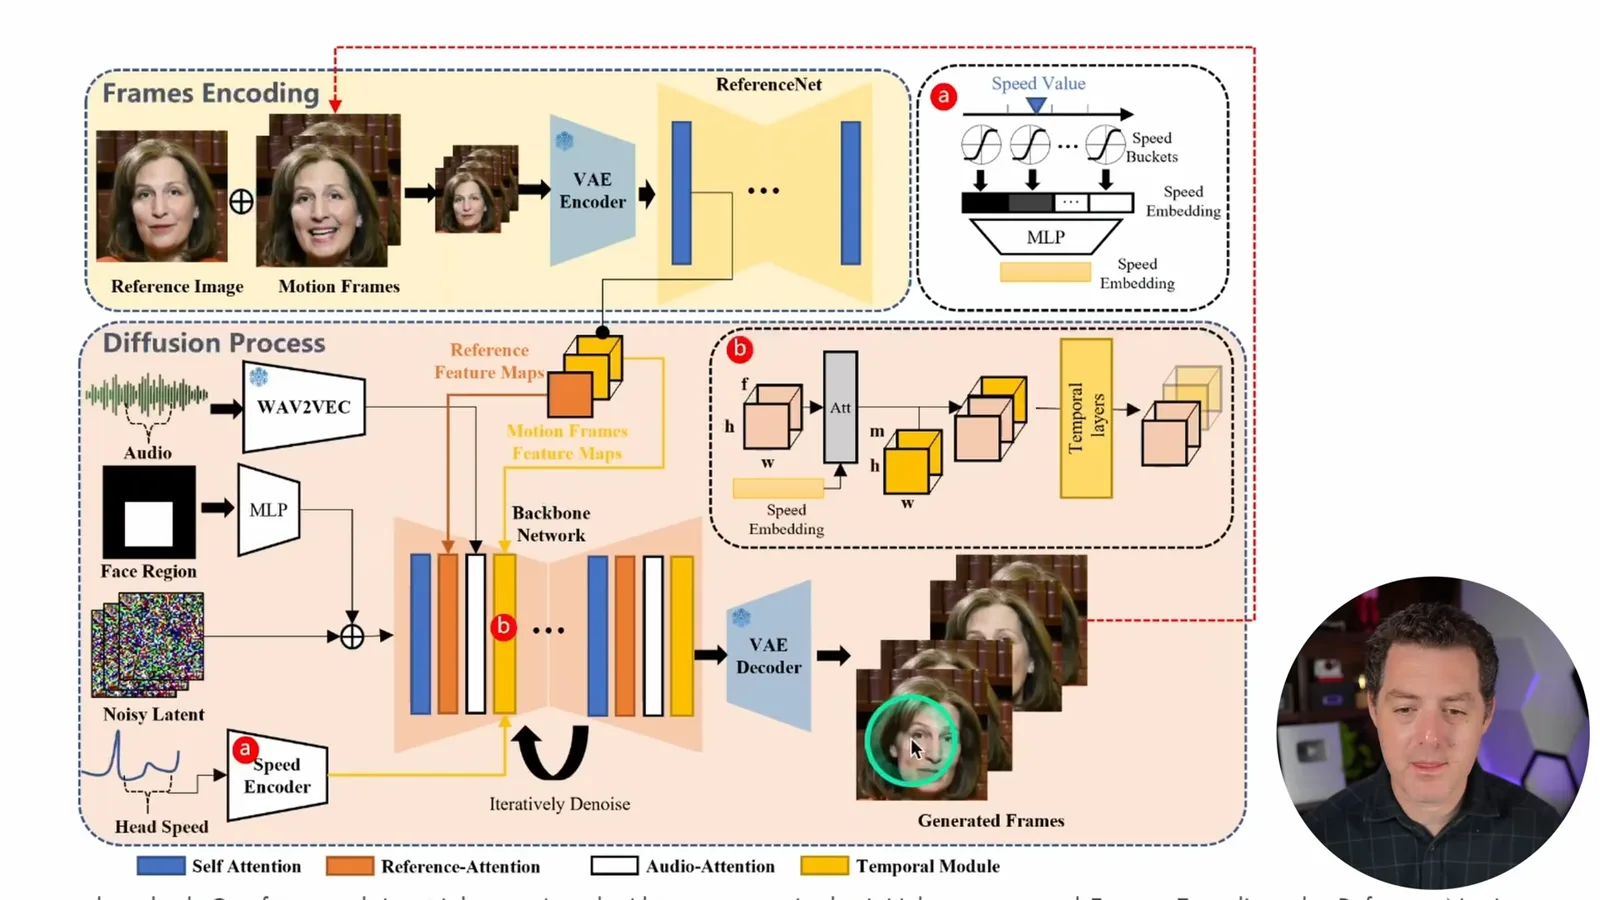
架构图展示了参考帧和运动帧的编码,以及音频特征、面部区域信号、带噪潜变量和头部速度信息。扩散网络生成视频帧,再与提供的音频结合。这是作者的研究架构,不能证明每种输入都能生成完美视频。
论文介绍了一种直接从音频生成视频的方法,避免使用中间 3D 模型或面部关键点。作者称生成时长可以随输入音频长度变化。这是关于该方法的研究主张,并不保证时长无限,也不保证所有输入都有一致的质量。
核心问题是音频与表情之间的关系。兴奋的声音可能伴随扬眉或不同的头部姿态,但音频并不能唯一决定面部动作。作者希望生成合理的表情和具有个性的面部风格,而不只是匹配嘴部运动。
研究人员认为,直接合成省去了某些方法使用的中间表示和复杂预处理。这不应理解为整个流程完全不需要任何准备。他们的见解是,人声音频包含有助于判断表情的线索,即使二者之间的映射仍有歧义。
这种歧义可能导致帧间抖动、面部扭曲,甚至视频崩坏。论文引入速度控制器和面部区域控制器来提高稳定性。这些控制旨在减少伪影并保留表现力,不能保证生成的动作完美无缺。
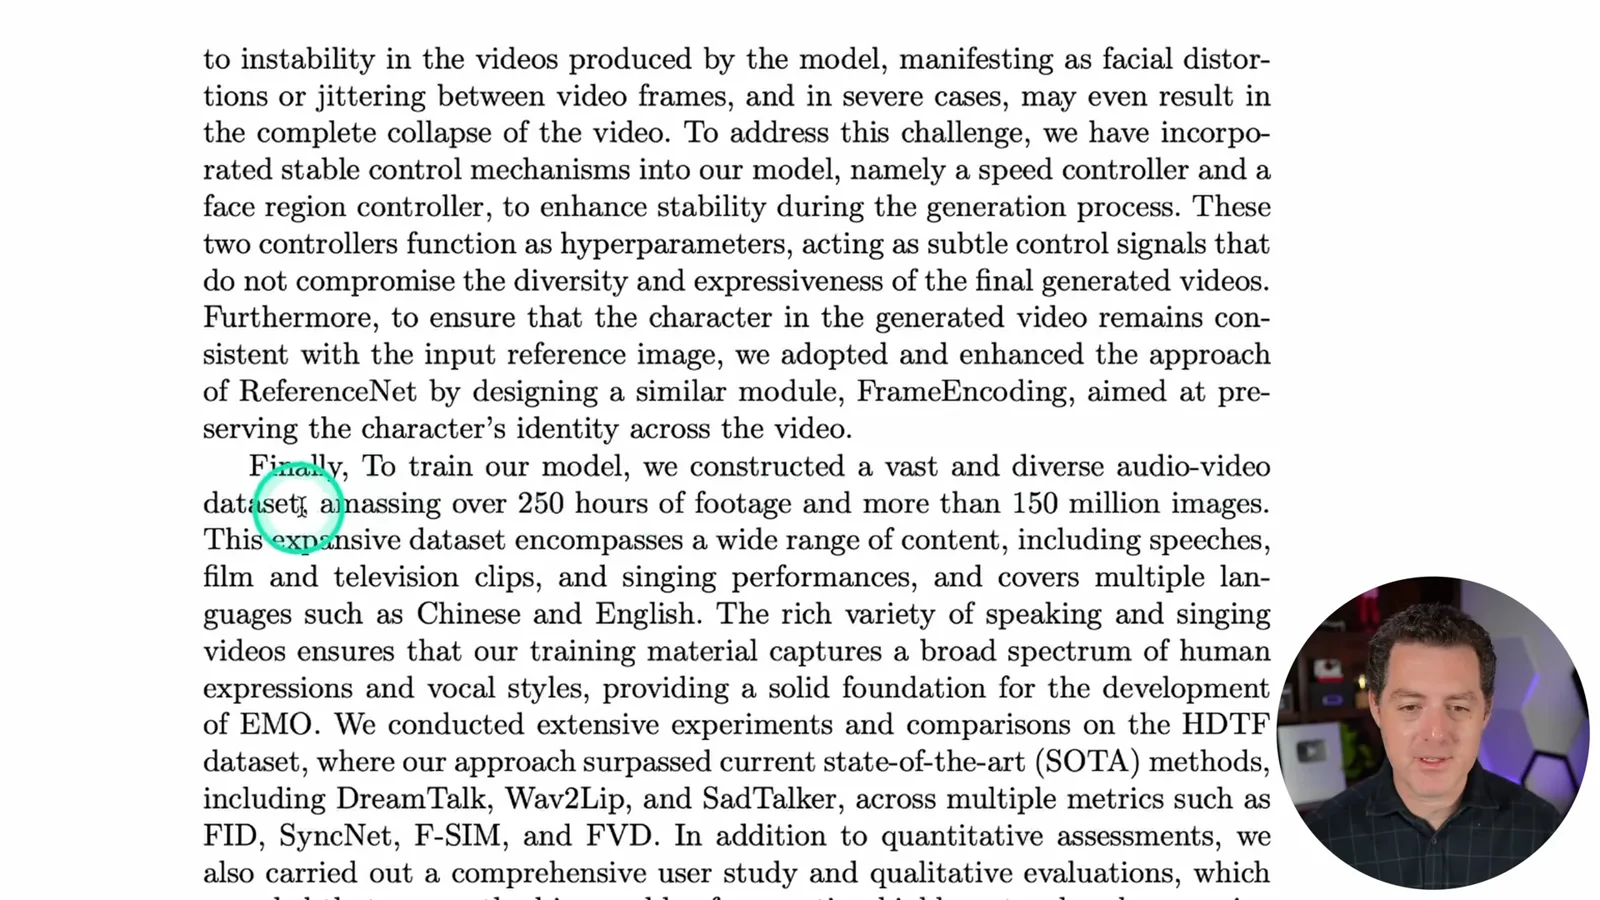
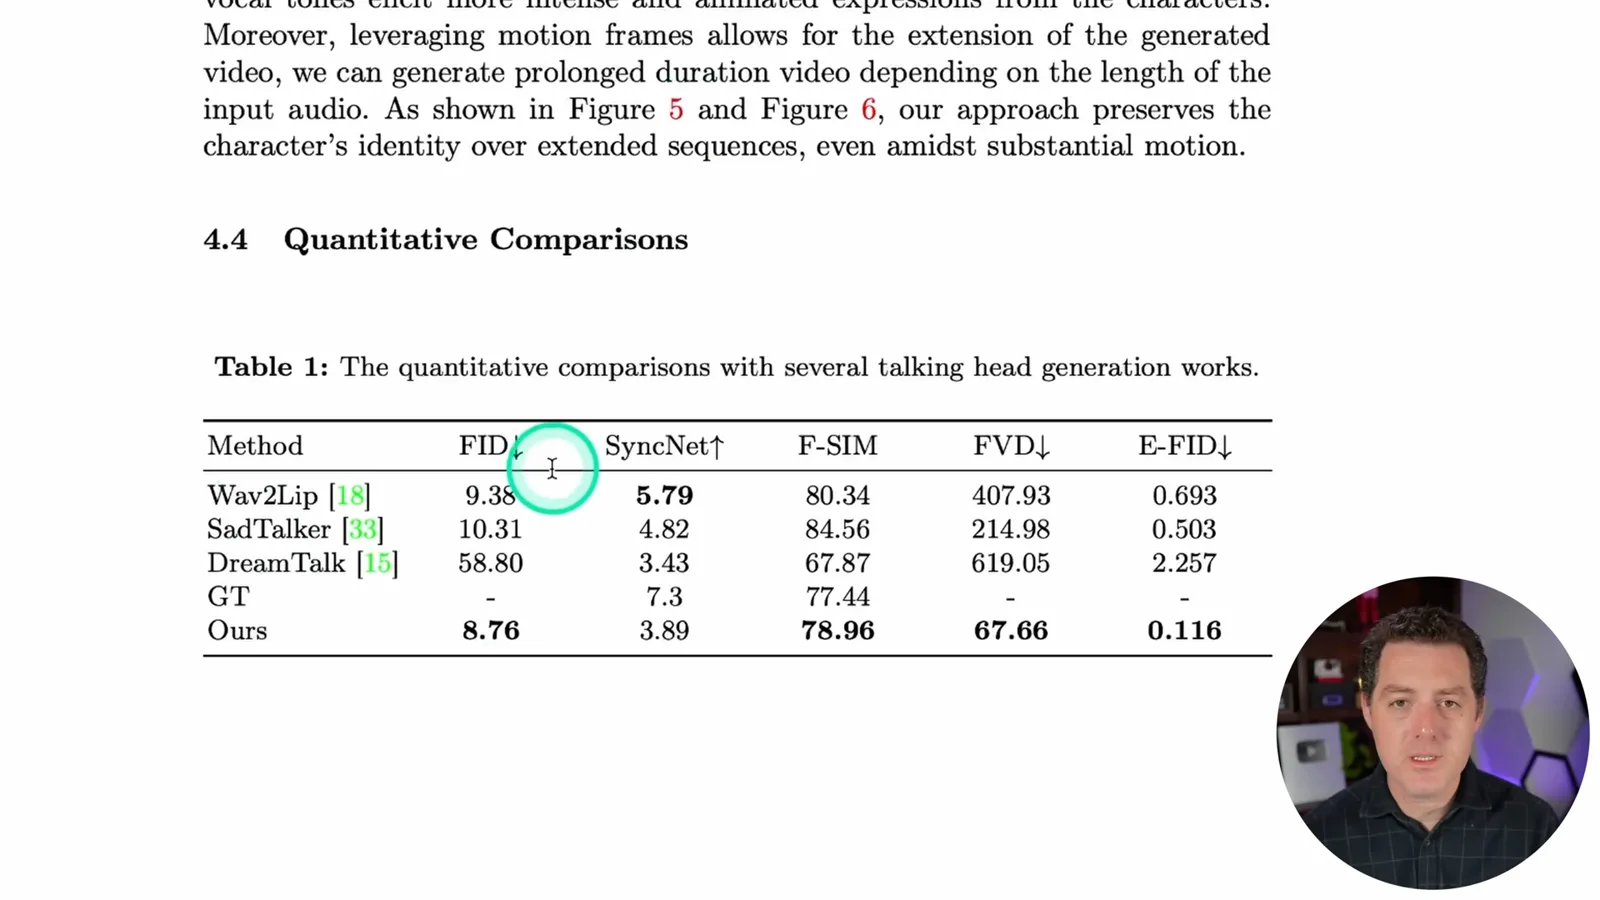
作者报告,训练使用了超过 250 小时的音视频素材和超过 1.5 亿张图像,包括演讲、影视片段以及多种语言的歌曲。论文使用若干定量指标将 EMO 与此前的人像说话生成方法比较。这些结果反映的是研究选用的数据集和测量方式,而非普遍排名。
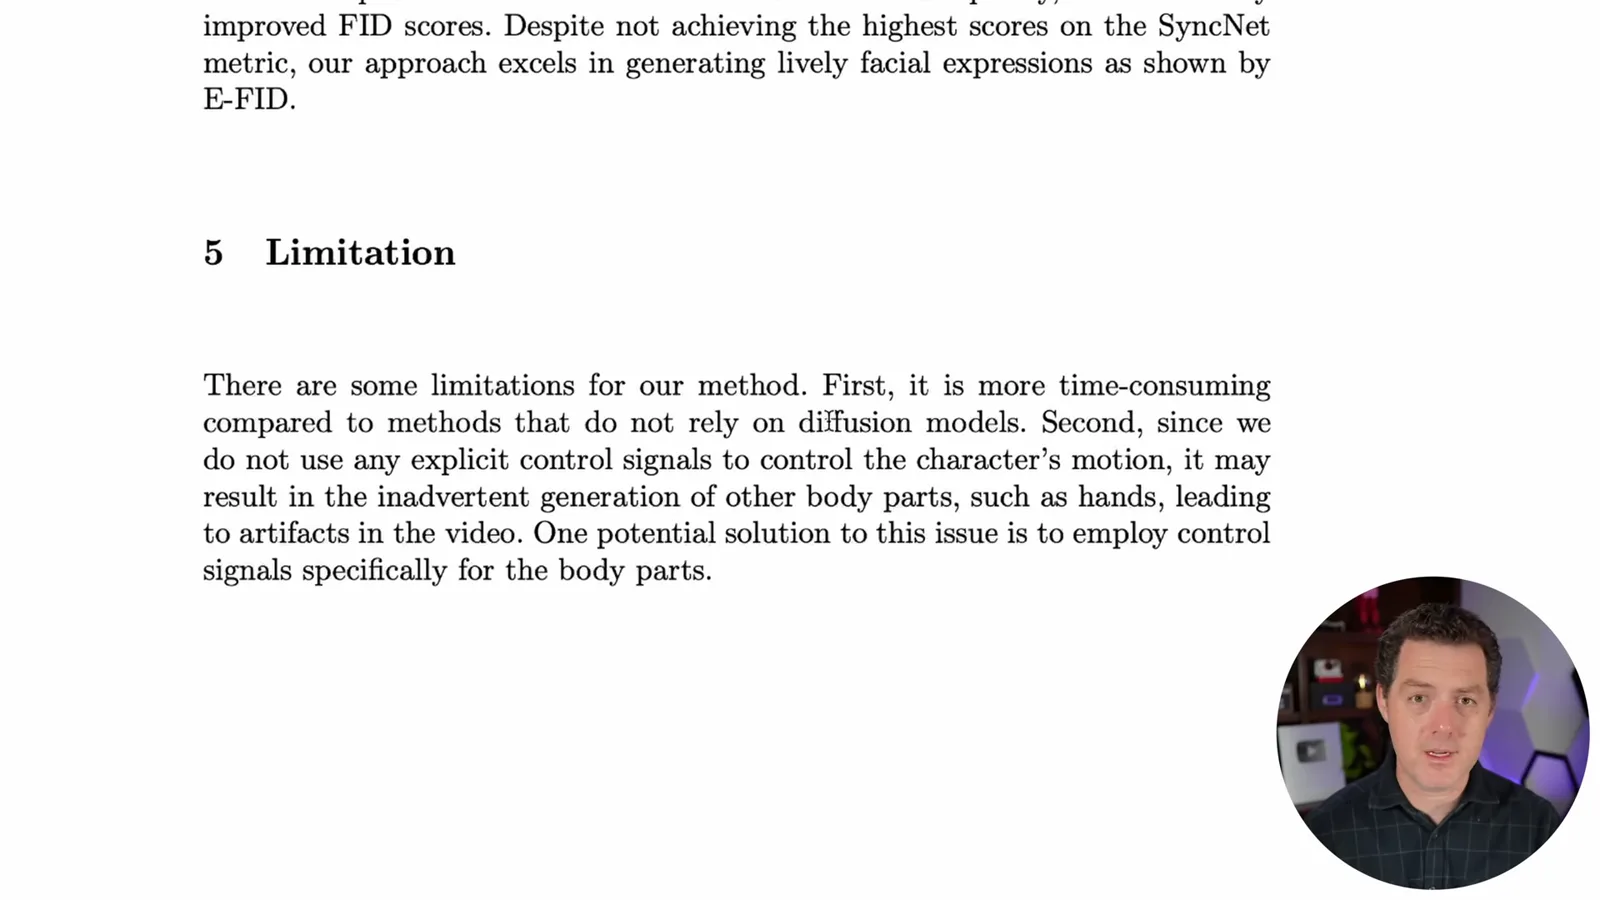
局限不容忽视:扩散方法比不使用扩散的方法更耗时,缺少明确的身体动作控制可能导致意外生成手部或其他伪影。作者提出,使用针对身体部位的控制信号可能是一种解决办法。我播放更多生成示例,展示结果。
编程与自然语言工具
Berman 播放 Jensen Huang 关于领域专业知识和自然语言计算的讲话片段。他认为基础编程仍能培养有用的系统性思维。
接下来,我转向 NVIDIA 首席执行官 Jensen Huang 讨论编程的一段讲话。Huang 认为,计算应该能够通过人类语言使用,让生物学、教育、制造和农业等领域的专家也能应用它。他强调提升技能和解决领域问题。
我仍打算教孩子编程,因为它有助于培养系统性思维和解决问题的能力。我的预测是,随着自然语言界面进步,我们熟悉的编程方式会发生变化,而不是说所有技术问题都已经解决。学习如何提出和解决问题仍然有价值。
我将这一预测与视频生成、游戏、虚拟形象和机器人领域的研究项目联系起来:过去困难的任务正变得更容易借助 AI 工具开展。EMO 就是一个将参考图像和音频转化为生成动作的例子。我仍鼓励初学者学习基础编程,以培养系统性思考的习惯。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。