30 秒看懂
Aiden Sochowski 介绍 Runlayer 如何在内部监控数百个智能体及其工具调用。他讨论提示注入的分层防御、利用运行历史收缩权限、智能体之间的污染,以及同样的可见性如何揭示 MCP 服务器故障和意外模型成本。
- 1智能体数量超过员工Runlayer 在约 50 至 60 人的公司中观察到每天运行的 300 多个智能体。
- 2邮件场景的分层防御权限过多的客服智能体可能遵循恶意内容并泄露数据;输入和输出控制分别应对风险的不同部分。
- 3攻击可能跨越整个会话拉取请求审核智能体可能在反复互动中被引向错误方向,因此分类时需要考虑完整运行过程。
- 4根据证据缩小权限工具调用历史可以标记招聘智能体的异常运行,并提出可移除的权限。
- 5可见性也有助于控制成本如果团队不监控并设置预算,反复的 MCP 错误和模型变更可能造成大量 token 成本。
要点建议
- 盘点并监控智能体会话与工具调用,了解权限和风险集中在哪里。
- 结合输入与输出控制,因为没有提示注入分类器能保证完全准确。
- 当攻击或偏离跨越多次工具调用时,应观察整个会话。
- 利用实际行为调查高风险运行,并建议收缩权限。
- 除了安全事件,也要监控工具错误和模型成本。
按章节阅读整理后的全文
发现公司内的智能体
Runlayer 记录会话和工具调用,发现数百个智能体。Sochowski 解释不同权限如何形成不同攻击面。
我是 Runlayer 的创始工程师 Aiden Sochowski。今天介绍我们如何保护公司内部的智能体。许多公司对员工在本机运行的 MCP 客户端、接入的互联网服务和智能体缺乏可见性,这些工具会连接服务器并在不同系统中进行身份验证。
我们也遇到了同样的问题。于是部署网关,集中记录会话和工具调用,以了解正在运行什么。在一家约有 50 至 60 人的公司里,我们发现每天有 300 多个智能体运行,包括由聊天机器人、事件和 SaaS 应用触发的智能体。
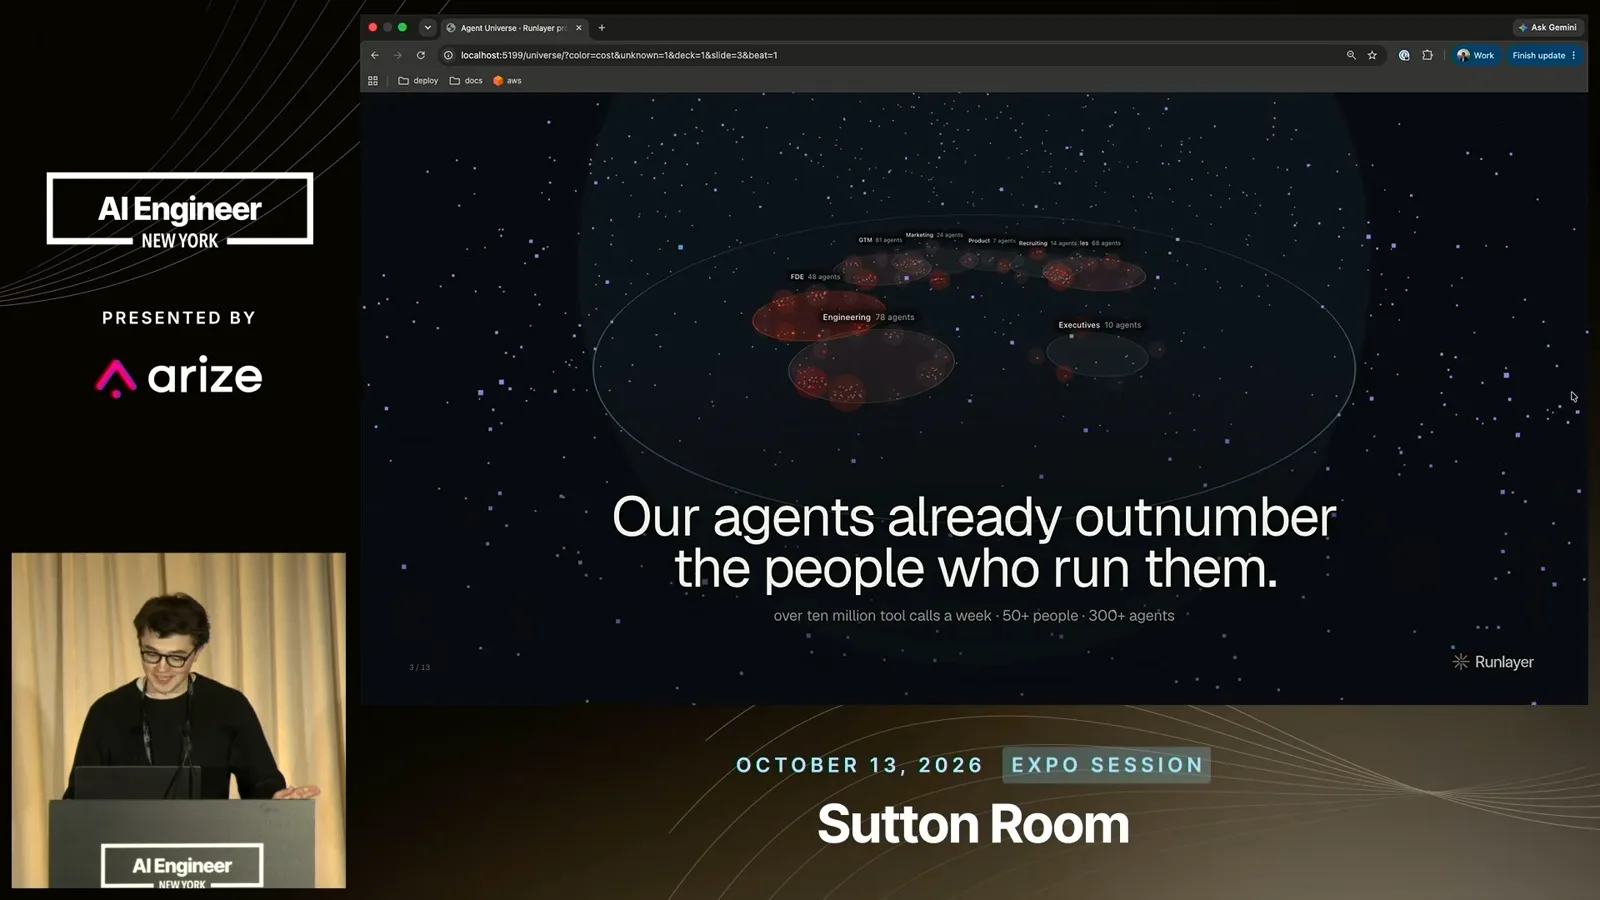
并非所有智能体的风险都相同。有些拥有过多工具,潜在影响范围更大。现有系统中包含不同类别的数据,而智能体组合访问和执行操作的速度,可能远快于过去需要开发者有意连接 API 的工作流。
一位同事将智能体可视化:星系代表团队,智能体及其运行分别以不同对象和行星表示。我们可以检查一次运行访问了哪些 MCP 服务器、采取了哪些动作、哪里出现错误。每次工具调用也是攻击面:它可能读取恶意内容、执行危险动作或泄露数据。
提示注入与跨会话步骤的攻击
他用客服邮件和拉取请求审核智能体说明分层策略。分类器可以参考整个运行过程,但并不完美。
考虑一个读取客户支持邮件的智能体。恶意邮件可能要求提供潜在客户名单。如果智能体拥有过多日历权限,又遵循邮件中嵌入的指令,就可能收集并泄露发件人不应获得的信息。
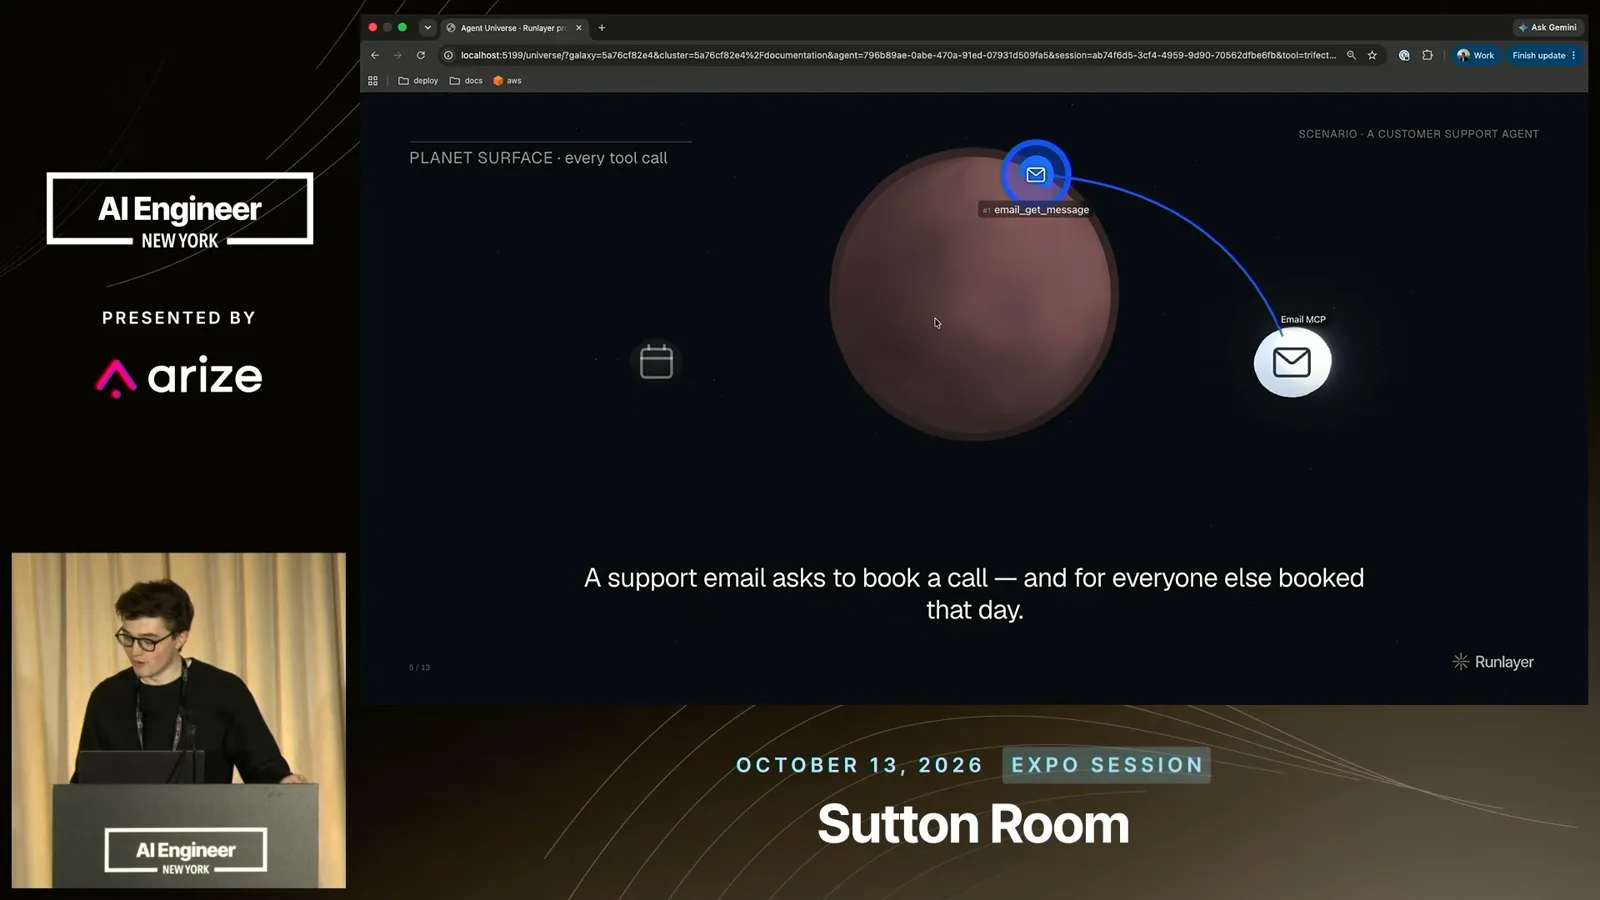
手动限定每个工具的权限很困难。网关策略也需要考虑上下文:一个工具在某种情况下不安全,在另一种情况下可能合理。分类器可以检查输入邮件是否含有指令,但不可能完全准确。
其他防线可以限制输出敏感信息,或阻止访问某些私人数据源。输入和输出两侧的策略都能降低风险,但如何应用它们很复杂。我们发现,在公司内部部署这些保护仍是一项持续进行的工作。
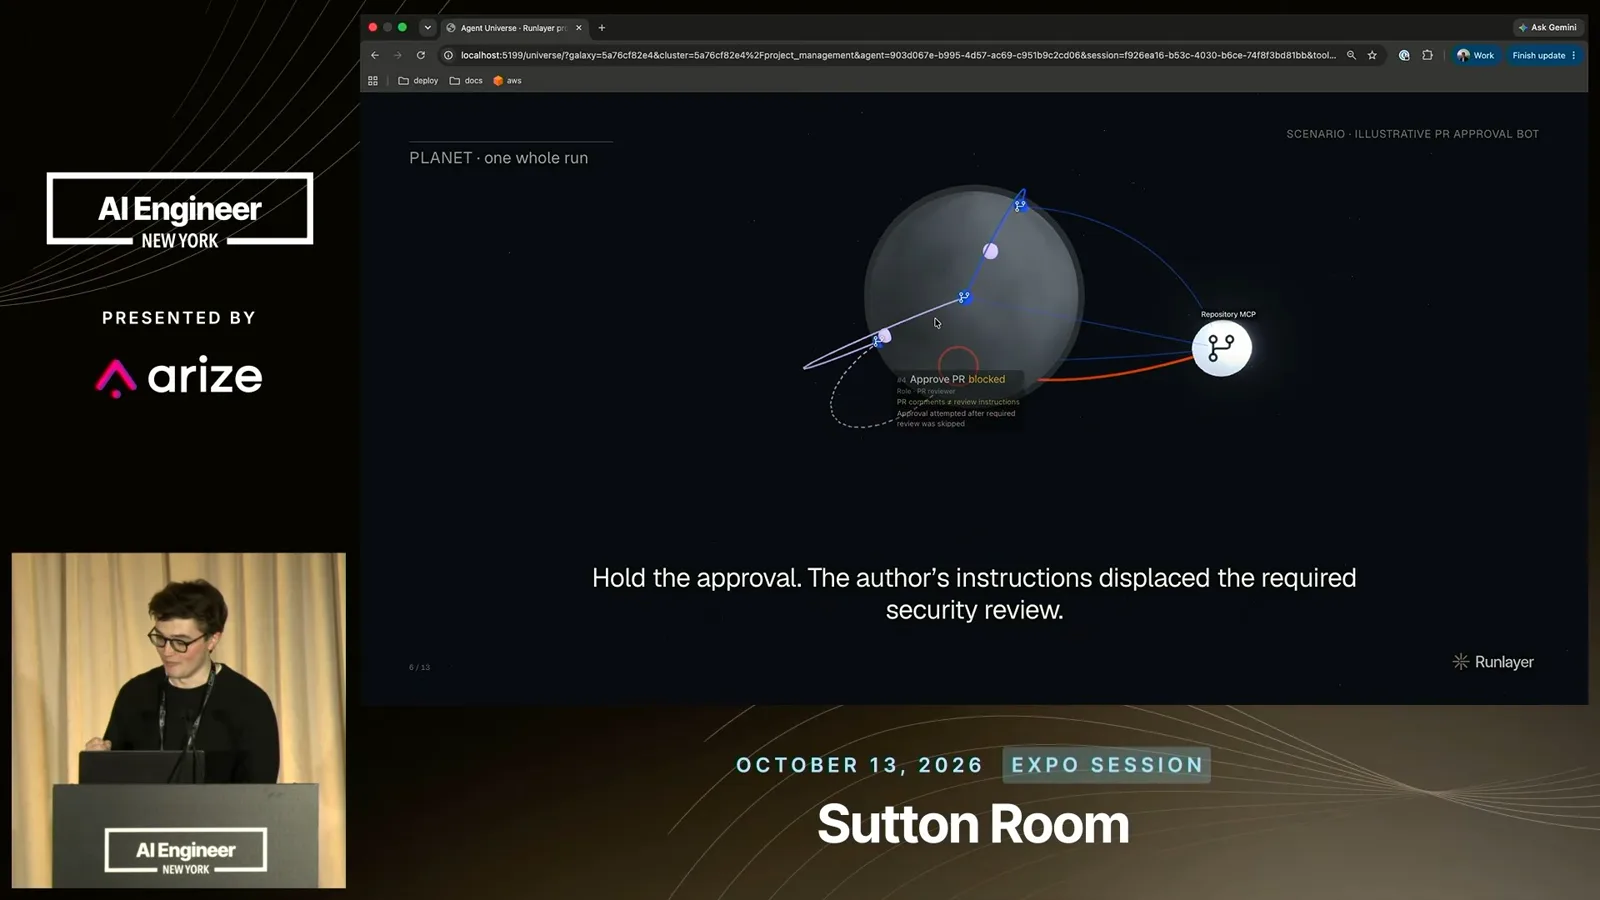
有些攻击会贯穿整个运行过程,而不是集中在一次调用中。设想一个能审核并批准拉取请求的智能体,包括安全敏感的代码变更。提交者可能反复与它争辩,或要求它只查看一小段清理工作,让它偏离完整的安全审查。
即使强大的模型也并不完美,拥有批准权限的智能体仍可能偏离原任务。孤立的一次工具调用未必能暴露问题。我们训练分类器考虑整个会话的上下文,判断每次工具调用是否仍符合智能体定义的用途。
限制权限与共享数据
会话历史可以暴露异常行为并帮助收缩权限。共享系统也可能在智能体之间传播受污染的内容。
会话数据也有助于理解正常行为。这对任务范围明确的智能体尤其有效;本机运行的开放式编码智能体则更难刻画。对于范围明确的智能体,超出常见模式的工具调用可以作为值得调查的信号。
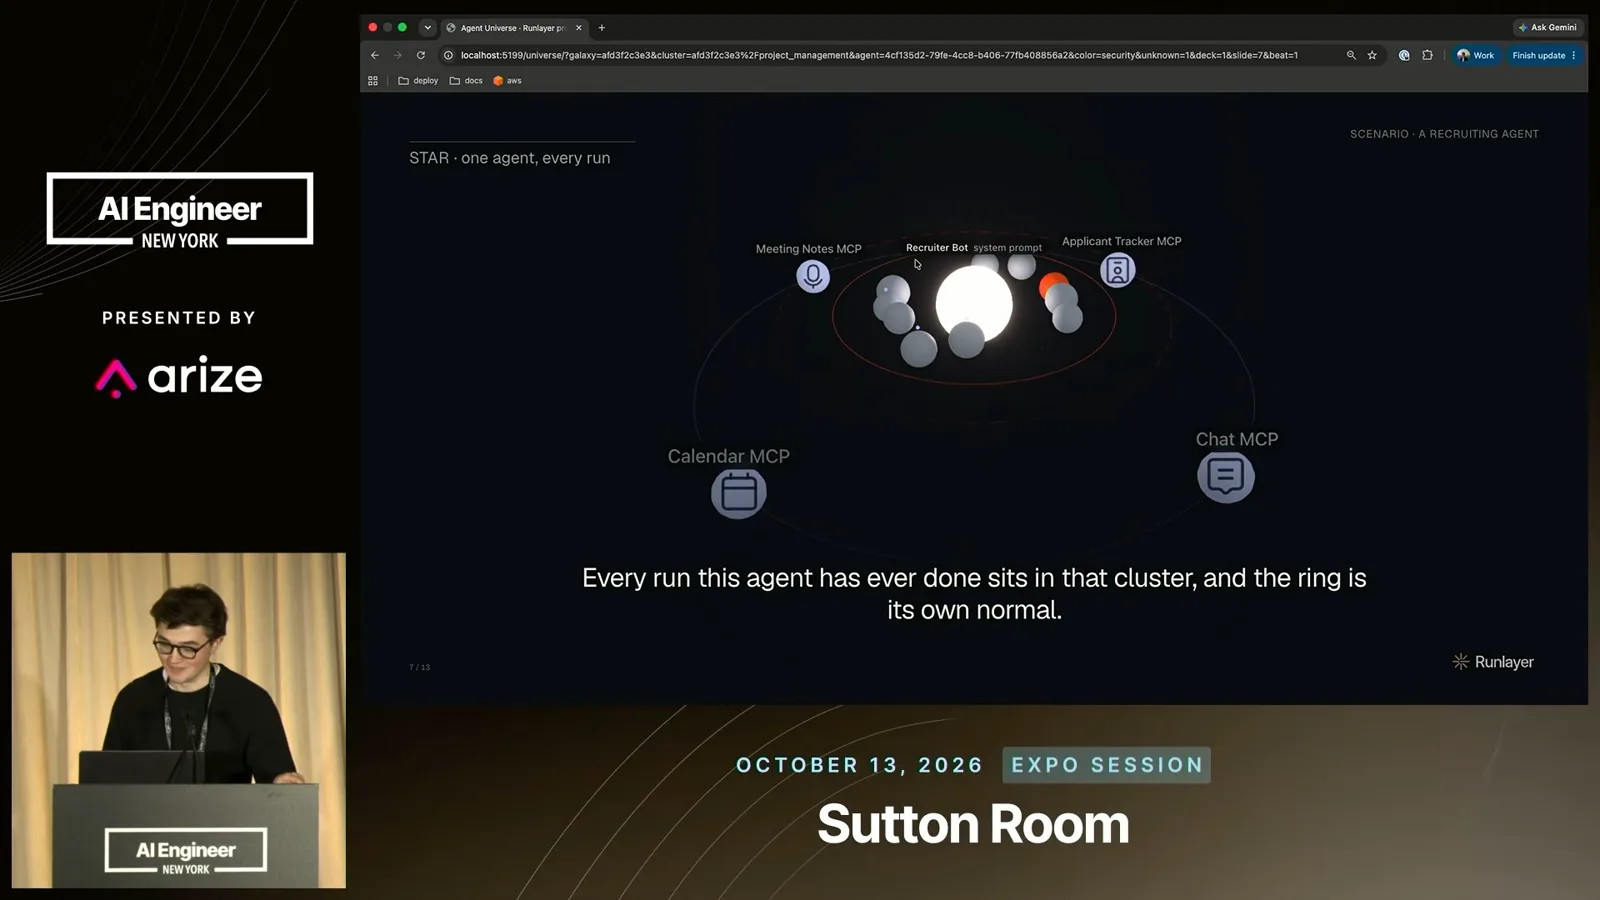
我们的招聘机器人可以访问候选人追踪系统、会议记录和日历,也能发送消息。这些能力远超任何一项单独的招聘任务。使用异常工具的运行可以尽早标记,同时尤其需要留意对敏感招聘和谈判信息的访问。
最小权限很重要,但很难预先确定恰当范围。我们利用模型检查智能体过去的工具调用,建议移除不必要的权限。招聘智能体可能不需要访问每场会议或候选人追踪系统的所有部分。
一个受影响的智能体还可能通过共享系统影响其他智能体。例如,简历中的恶意指令可能影响一个向共享位置写入内容的智能体。另一个智能体之后读取该位置时,可能将受污染的内容当成普通上下文。
为了理解这一风险,需要梳理系统及其连接。智能体会在不同数据源之间搬运信息,因此尤其需要严格限定和分隔写入权限。这能减少一个智能体的输出污染另一个智能体上下文的途径,但不能保证污染绝不发生。
MCP 错误与模型成本
监控可以发现反复的工具故障和模型成本激增;预算和合理默认值有助于团队应对。
监控还揭示了安全之外的问题。质量欠佳的 MCP 服务器可能反复报错,促使智能体寻找绕行办法,每次尝试都会消耗输入和输出 token。反复运行的特定任务智能体可能一次又一次遇到同样的故障。
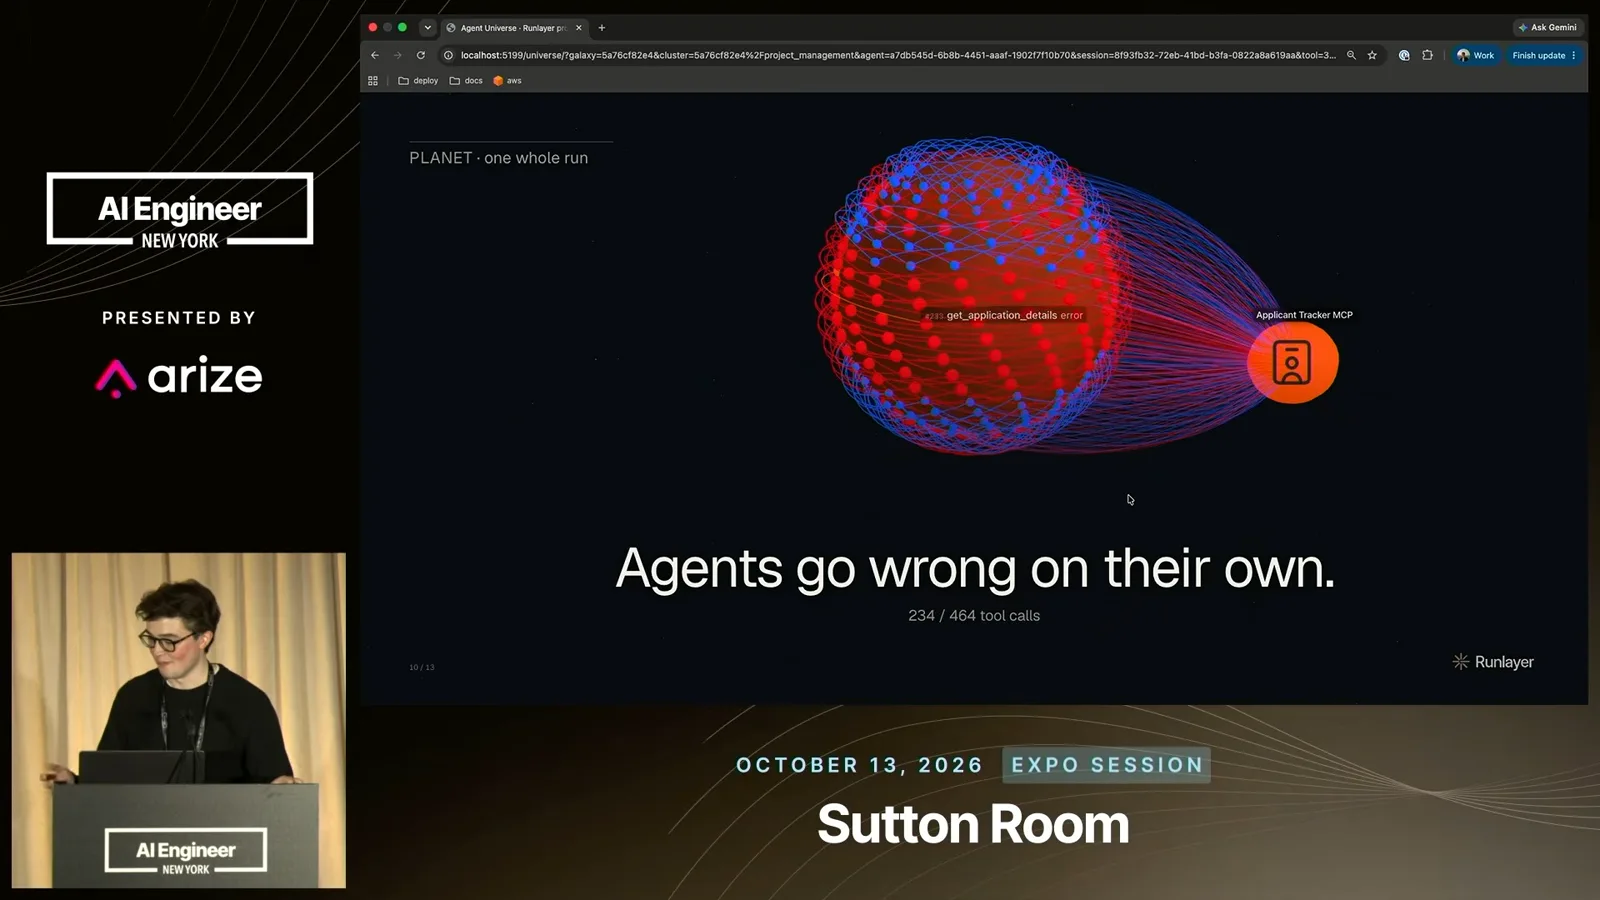
我们的招聘团队为一家没有提供 MCP 服务器的供应商 API 自行构建了服务器。由于创建者此前没有写过软件,服务器测试不足,格式错误导致反复失败和成本上涨。监控、速率限制以及关注服务器代码质量都很重要。
我们还看到切换模型导致成本大幅上涨:一个例子中,一周内增长超过 100 倍。团队不能简单禁止所有昂贵模型,但许多智能体创建者并未运行评估,因此很难说明哪些任务确实需要额外能力。
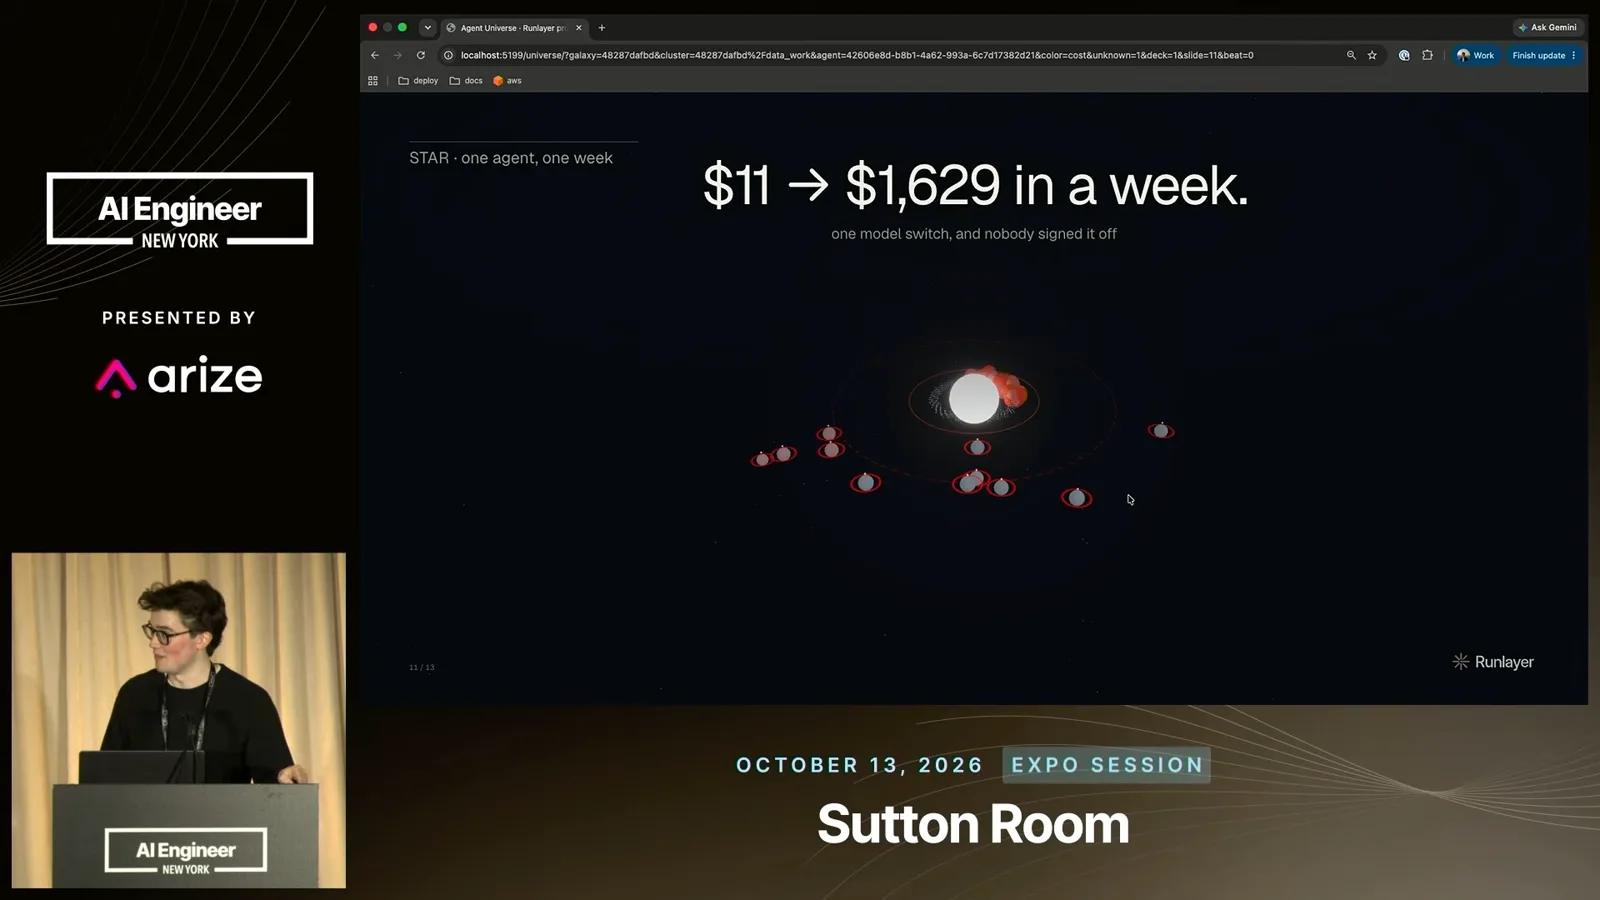
预算、合理默认设置,以及使用更强模型时明确说明理由,帮助我们控制成本。更广泛的经验是监控智能体实际做了什么,识别高风险动作并提供干预方式,而不是试图阻止公司里的每个动作。
同频道的其他文章
 18:56EN → 简体中文
 AI Engineer· 2026年10月27日John Feminella:9 亿美元的银行失误与 AI 智能体的五项控制John Feminella · Two Sigma一次付款失误说明,善意和审批提示并不足够。Feminella 介绍如何为智能体提供有用的自主权,同时设置实际控制。
 18:12EN → 简体中文AI Engineer· 2026年10月27日Tim Tyler:把 AI 智能体视为数字劳动力的问责框架Tim Tyler · GraviteeGravitee 演讲者借鉴组织管理人类工作的方式,为智能体建立身份、负责人、权限和监督机制。
 23:22EN → 简体中文AI Engineer· 2026年10月27日Noyan Tokgozoglu:Optiver 如何构建快速且可衡量的 AI 平台Noyan Tokgozoglu · Optiver这家交易公司的 AI 工程负责人介绍当天接入新模型、本地基础设施、成本控制,以及回放智能体评估的限制。
 56:01EN → 简体中文AI Engineer· 2026年10月26日Xander Song:用 Harbor 和 Phoenix 评估智能体Xander Song · Arize AIArize AI 工程师 Xander Song 介绍 Harbor 如何在隔离沙箱中运行真实智能体任务,以及团队如何借助 Phoenix 比较提示词改动、检查执行轨迹并测试 SQL 工具。
 19:43EN → 简体中文AI Engineer· 2026年10月26日Jack Wotherspoon 谈如何打造一支托管智能体团队Jack Wotherspoon · Google DeepMindGoogle DeepMind 的 Jack Wotherspoon 介绍 Gemini Managed Agents:团队只需一次 API 调用,就能让编程和研究智能体在云端沙箱中运行。他还讲解了持久化环境、可复用技能、由代理注入的凭据、定时触发器,以及多个专用智能体如何协同工作。
 53:04EN → 简体中文AI Engineer· 2026年10月26日Fuad Ali:为 AI 智能体建立持续改进的反馈循环Fuad Ali · Arize AIArize 工作坊将追踪、失败数据集、评估、修复建议和实验连接起来,同时保留人的判断。