30 秒看懂
Theo Browne 讨论 Anthropic 对受支持 Claude 模型输出的标记计划,以及欧盟的透明度框架。他借助一个简化的图像示例和 Sean Goedecke 对文本水印的讨论,解释内容变化后检测为何可能变得困难。 Theo 怀疑单靠水印能否遏制蓄意滥用,更看重来源记录和公众教育。他的演示没有测试商业水印的稳健性;检测到或未检测到标记,都不能确证作者身份。
- 1一项透明度计划Anthropic 为受支持的 Claude 模型介绍了文本水印和经过签名的文件凭据。
- 2耐受能力取决于方法Theo 的简化图像模式展示了一个难题,但不能证明商业水印的稳健程度。
- 3检测存在局限检测到标记不能证明完整作者身份,没有标记也不能证明内容由人创作。
- 4统计文本标记Token 采样可以形成可检测的统计信号;这个例子并不是对 Claude 实现的说明。
- 5签名来源记录C2PA 凭据可以验证来源声明和绑定内容,但不能独立保证声明或画面真实。
要点建议
- Anthropic 为受支持的模型描述了嵌入文本的标记和带签名的文件凭据,具体取决于模型和平台支持。
- 检测到标记意味着内容可能经过处理,并不能完整说明作者身份。
- 没有检测到标记,不能证明内容由人创作。
- 简单的图像演示不能证明商业水印一定有效或失效。
- 统计文本标记与签名文件来源记录是不同的方法,各有局限。
- 有效的来源签名能验证签名声明及其绑定关系,不能保证声明所描述的一切都是真实的。
按章节阅读整理后的全文
为何标记 AI 输出
Theo 介绍 Anthropic 的计划,以及他对检测 AI 生成文本和代码的担忧。
判断一段文字或代码是否由 AI 生成并不容易。熟悉的写作习惯并不能证明作者是谁,但这种困难让人担心误导性或低质量内容泛滥。Anthropic 的机器可读标记计划,让使用 Claude 写作和编程的人不得不正视这个问题。
这场讨论与欧盟《人工智能法案》的透明度框架有关。Anthropic 表示,受支持的 Claude 模型会在生成文本中嵌入水印,并在支持的文件中加入经过签名的来源元数据。我担心,给文本和代码添加标记并不能实现人们期待的目标。
欧盟透明度框架
他阅读《人工智能法案》和行为准则材料,包括其中的限定与例外。
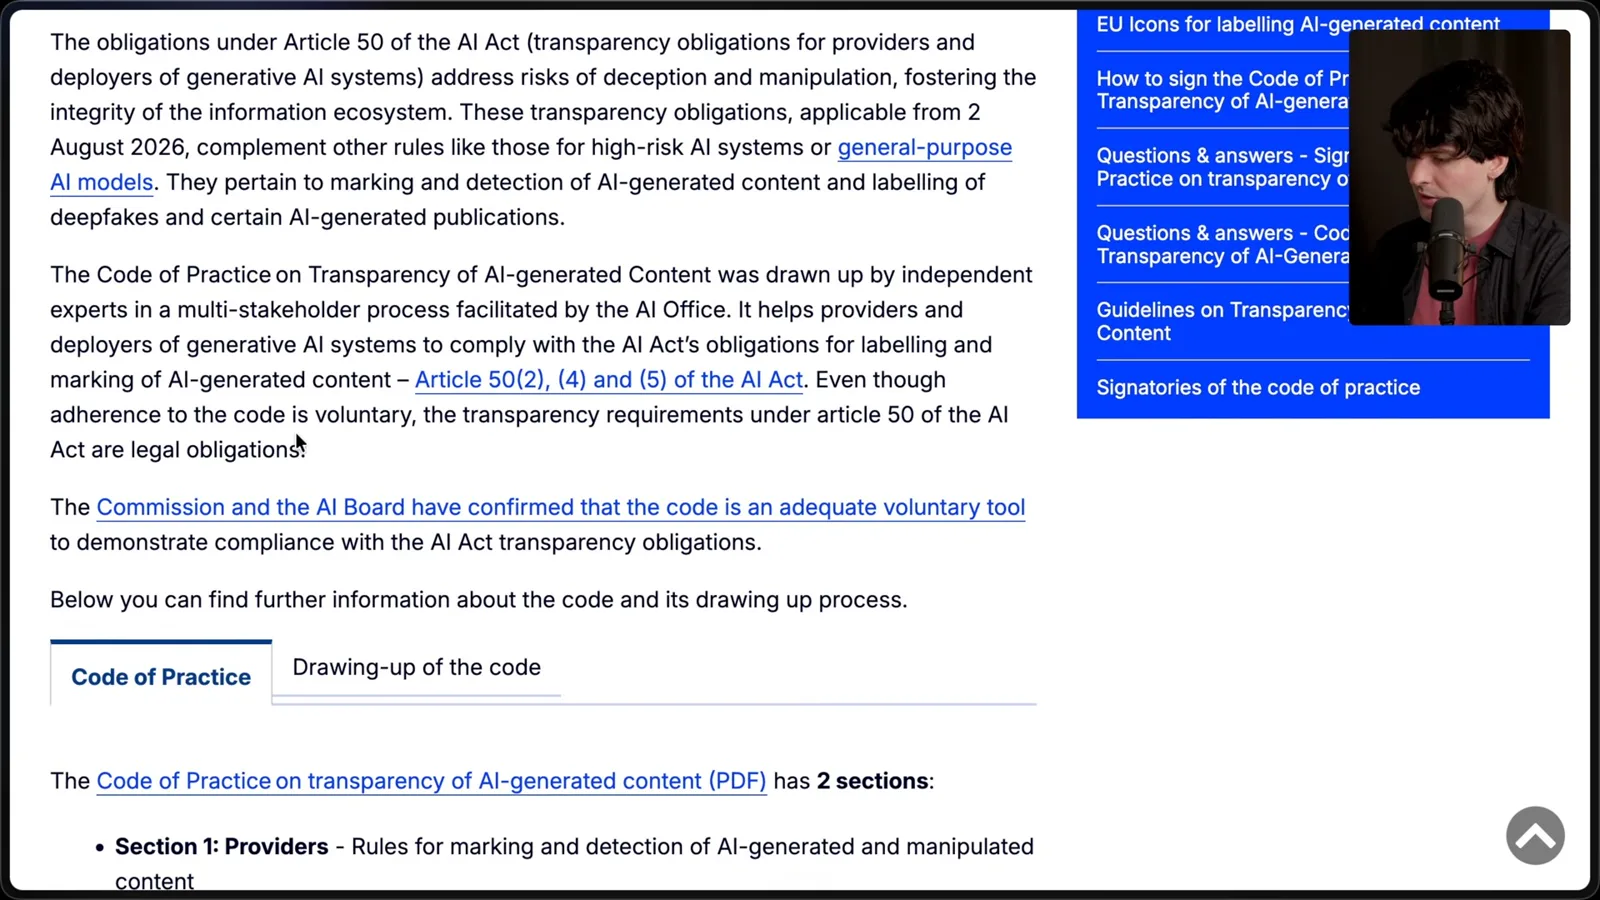
我展示的欧盟页面区分了自愿参加的行为准则和《人工智能法案》规定的透明度义务。准则的一部分面向提供商,讨论标记和检测;另一部分面向部署者,讨论披露。第 50 条第 2 款涉及机器可读标记,并对技术可行性等作出限定;具体法律适用取决于条文和实际情况。
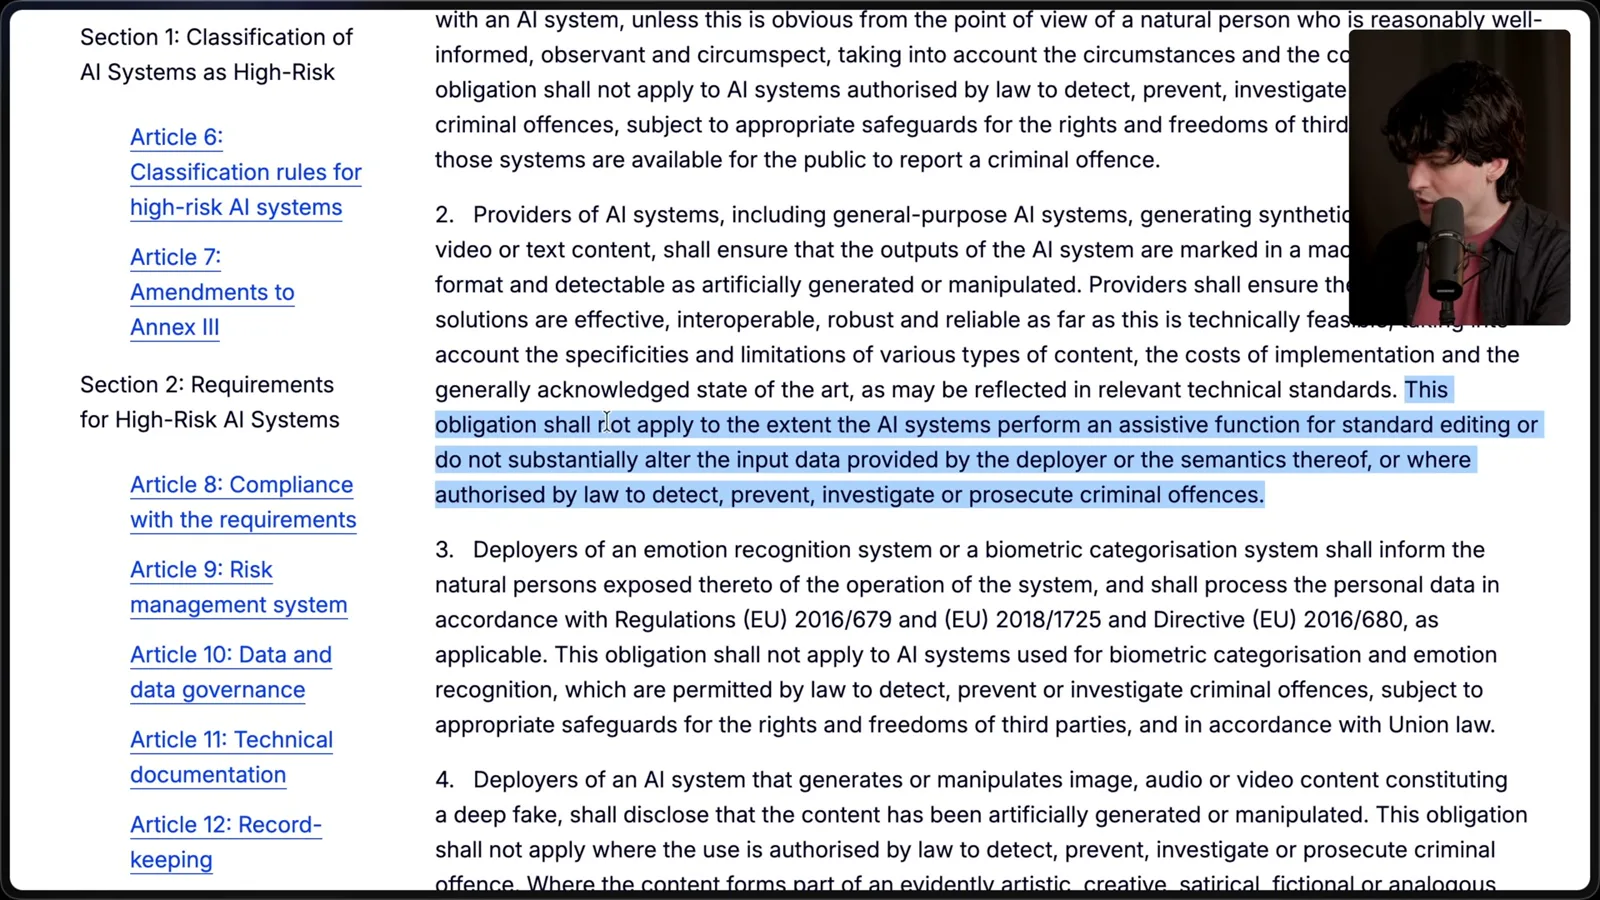
这一条款还列出例外,包括某些标准编辑辅助,以及输入数据或其含义没有发生实质改变的情况。我将其理解为轻度辅助编辑与生成输出之间的区别。判断具体场景时,需要依据实际条文,不能一概认为所有编辑都属于例外。
图像水印的类比
一个简单的像素示例说明隐藏信号与图像处理之间的张力。
为了说明技术问题,我先展示一张明显荒诞的图片,比较两种看起来相似但文件格式不同的版本。图片包含大量数据,编码变化不一定会带来明显的视觉差异。这让标记系统有空间嵌入信号,但也让信号的保留变得困难。
可以想象按重复模式修改少量像素,或极其轻微地调整颜色值。观看者可能察觉不到,而知道该模式的检测器可以寻找它。这是一个简化示例,并不是对某个商业水印的实现说明或测试。
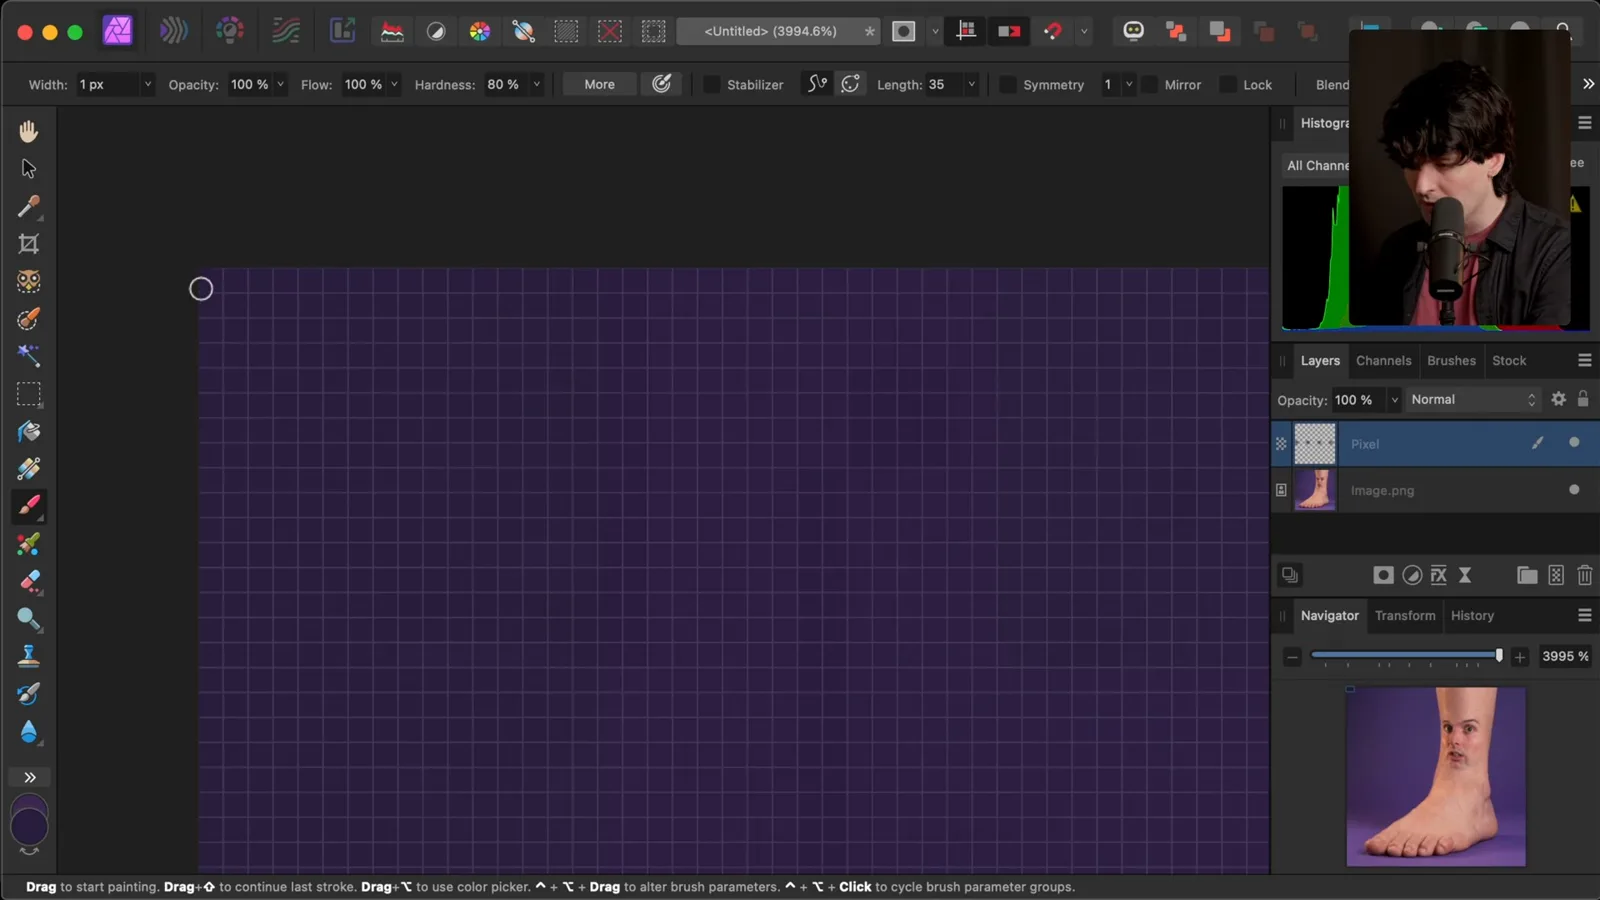
难点在于让信号经受住常见处理。有损压缩、缩放等操作会改变图像数据,同时尽量保留人们看到的内容。简单的像素模式可能因此受损。实际水印的耐受能力取决于设计和具体处理方式,这个玩具示例不能证明所有图像水印都会失效。
我提到了 Google 的 SynthID,并展示可见的噪声图案示例,但我不知道完整的检测方法。滤镜和缩放演示说明了示例图案可能发生什么,并没有独立测量 SynthID 的稳健性,也不能证明 Google 或其他公司的检测器如何工作。
Claude 标记及其局限
Theo 查看文本水印、签名文件凭据,以及 Anthropic 列出的限制。
文本面临不同的难题。与图像相比,它的冗余信息少得多,短句中的改动可能很显眼。长段落比短句提供更多可用于统计信号的材料,但如何在保留含义的同时让信号可检测,仍需要取舍。
Anthropic 的页面介绍了受支持模型和产品中的标记,包括 Claude Code 和 API,并称正在为较早的模型增加支持。这些说法针对受支持的模型、平台和发布进度,并不能证明历史上所有 Claude 输出都有标记。随着功能逐步推出,文档也可能变化。
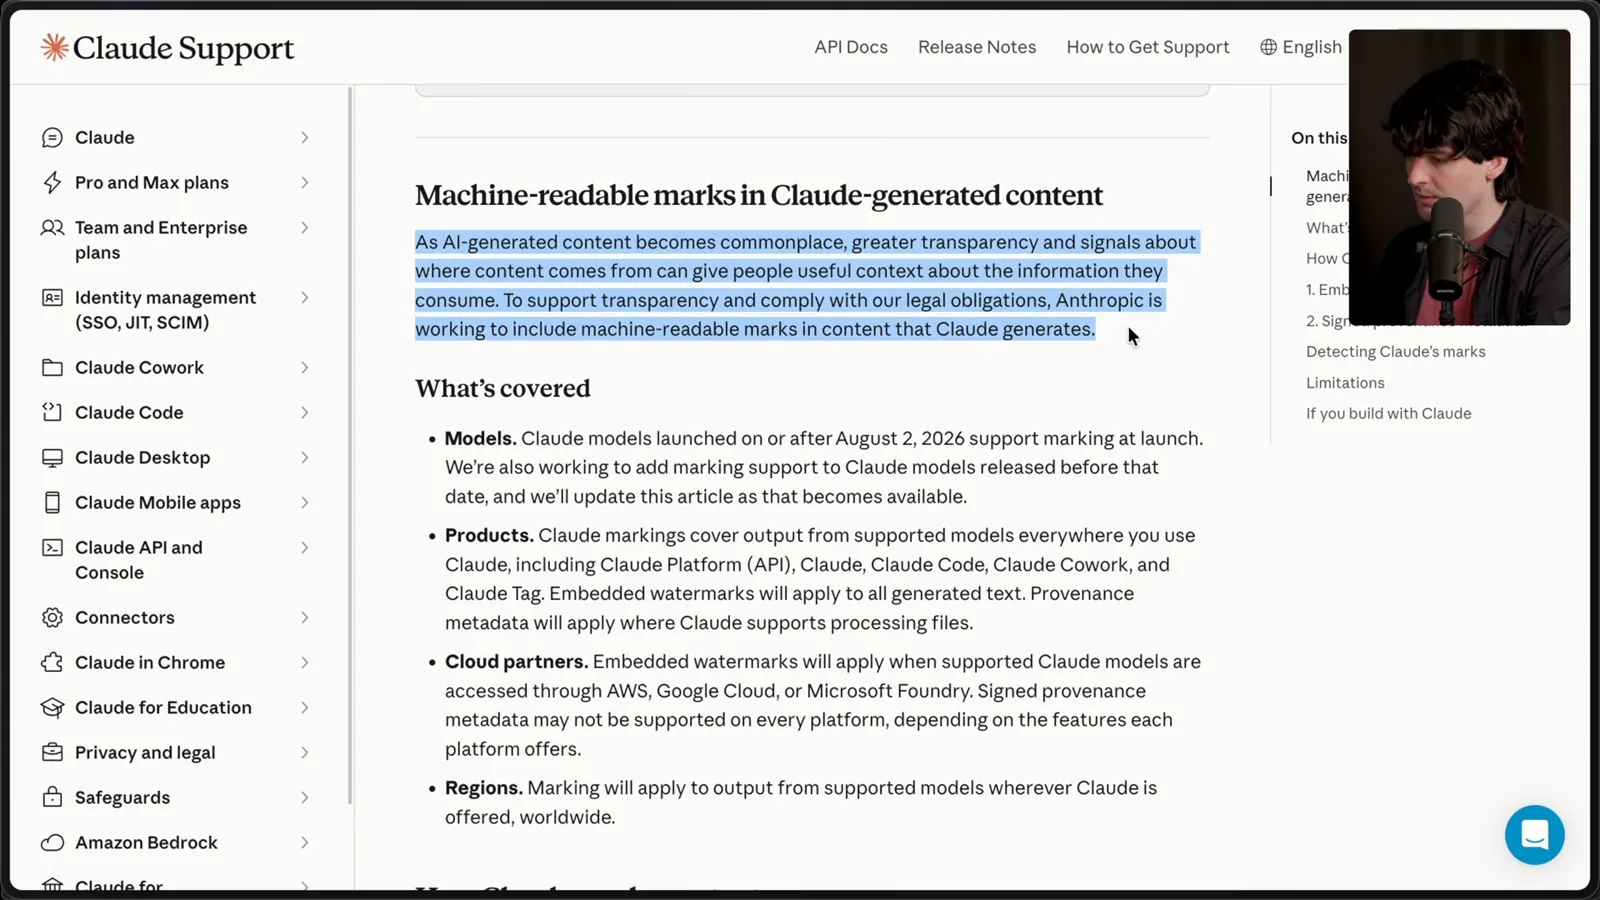
Anthropic 介绍了两种互补机制:在生成文本中嵌入水印,以及在支持的文件中附加经过签名的来源元数据。该公司表示,文本标记会随复制内容一起传播,也可能经受部分编辑。文件凭据则记录来源声明,并有助于检测与签名内容相关的变化。
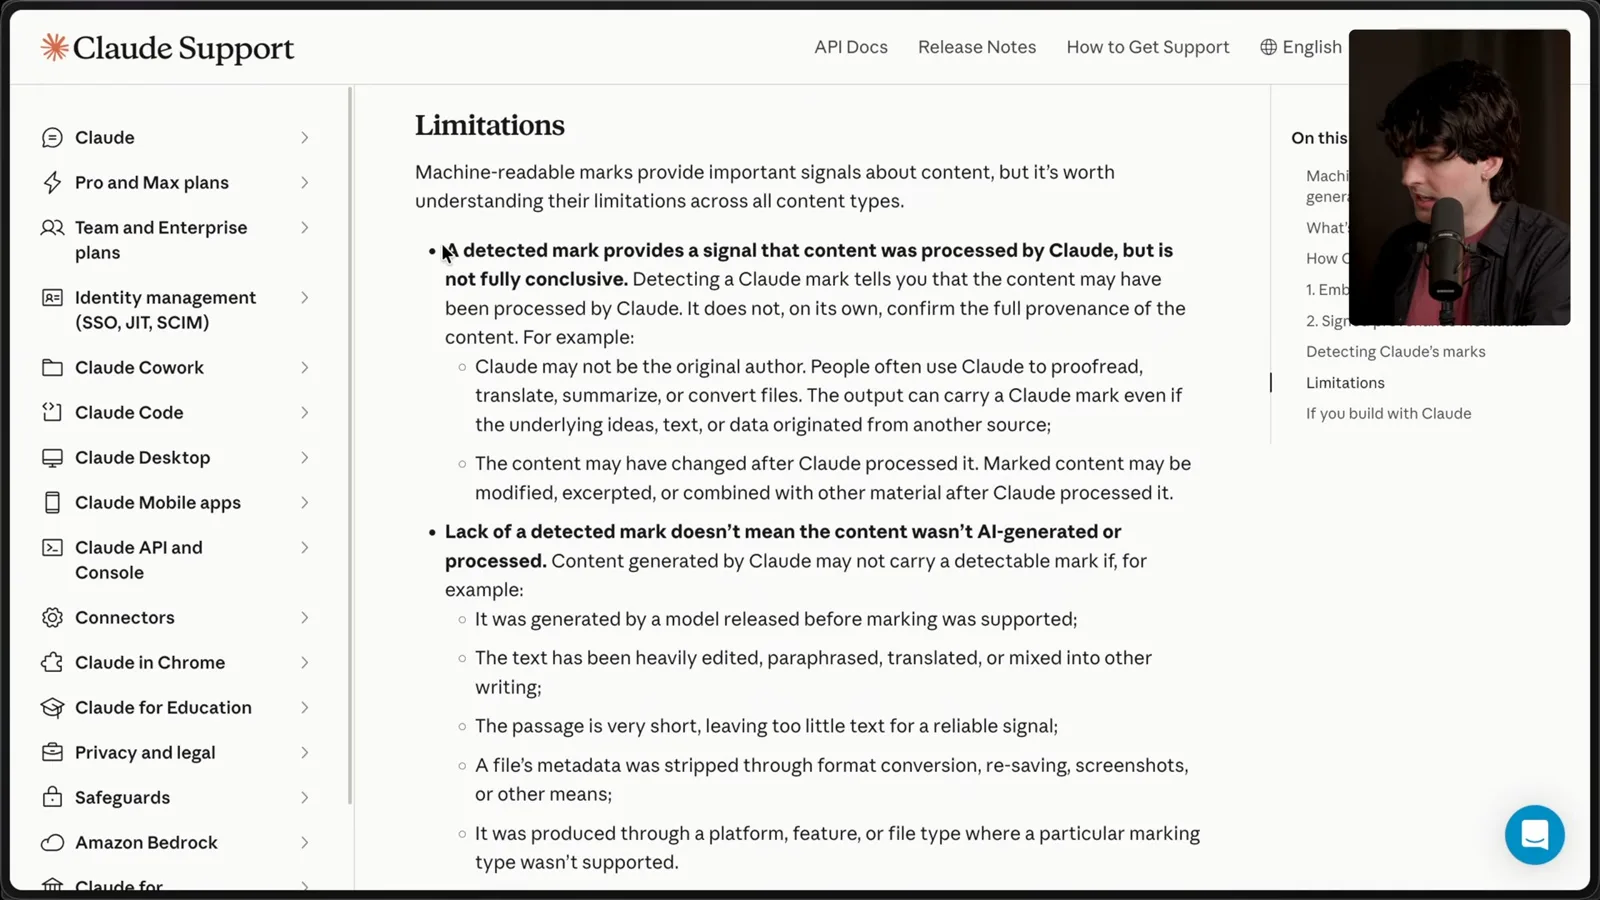
检测到 Claude 标记,表示内容可能经过 Claude 处理,却不能完整说明作者是谁。一个人可能提供了原始想法或文字,只用 Claude 翻译、总结或校对;内容也可能在处理后再次发生变化。
没有检测到标记,同样不能证明内容由人创作。Anthropic 列出的可能原因包括模型或格式不受支持、文本过短、经过大量编辑或翻译,以及文件处理过程中元数据丢失。因此,无论检测结果如何,都有局限。
我担心,有意规避的人可以改变内容或使用没有标记的模型,而直接复制粘贴可能更容易识别。我怀疑标记能否阻止复杂的滥用行为。这是对动机和稳健性的判断,并不是轻微编辑就能击败所有实现的实验证据。
文本水印可能如何工作
他讨论统计 token 选择、Unicode 猜测、检测成本和编辑的影响。
我还讨论了 Sean Goedecke 关于文本水印难题的文章。基本问题类似隐写术:如何将信号藏在普通文本中,又不让文本变得无法使用。明显的固定字母模式会破坏行文,更隐蔽的方法则有其他取舍。
另一种想法是把文本与模型预测进行比较,但风格相似可能造成误报,运行多个模型的成本也可能很高。人类自然写作时也可能使用模型常见的表达方式。专门的水印试图提供一种不同于普通风格检测的信号。
Goedecke 以 SynthID 为例解释统计标记。语言模型生成文本时会从可能的下一个 token 中进行选择;水印方法可以影响这些选择,形成可检测的整体统计模式。这是在说明一类技术,不代表 Claude 尚未公开的具体实现。
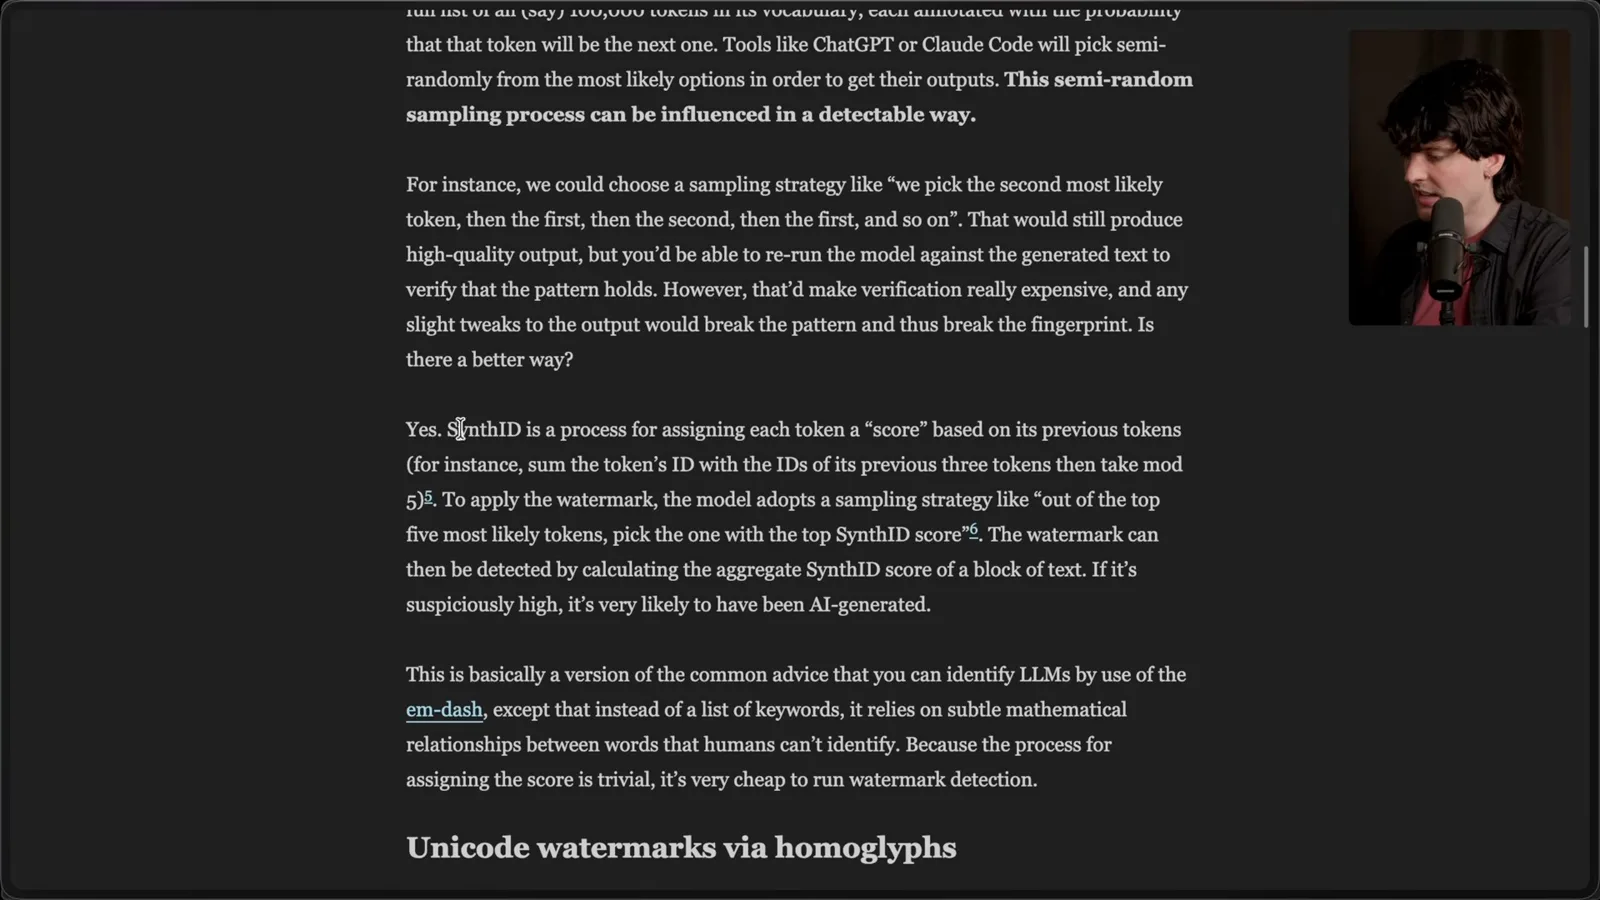
他还讨论了使用视觉上相似的 Unicode 字符隐藏信息的可能性。这种模式与统计水印不同,而出现一个不常见的空格本身并不能证明其原因。关于 Unicode 字符的猜测,也不能证明 Anthropic 宣布的 Claude 标记采用了这种机制。
编辑和改写可能削弱统计信号,文件格式转换也可能移除元数据。具体修改到什么程度会使某个检测器失效,需要通过实验回答。我认为,试图规避检测的人有动力继续尝试,而读者和平台则需要理解误报和漏报。
讨论还提出了一个张力:既要实现可互操作的验证,又要让标记方法难以规避。我认为这是尚待解决的设计问题。但互操作性本身并不能证明提供商必须公开密钥或实现的每一个细节。
来源记录和更广泛的目标
Theo 讨论 C2PA、规避行为及透明度工具可能解决的不同问题。
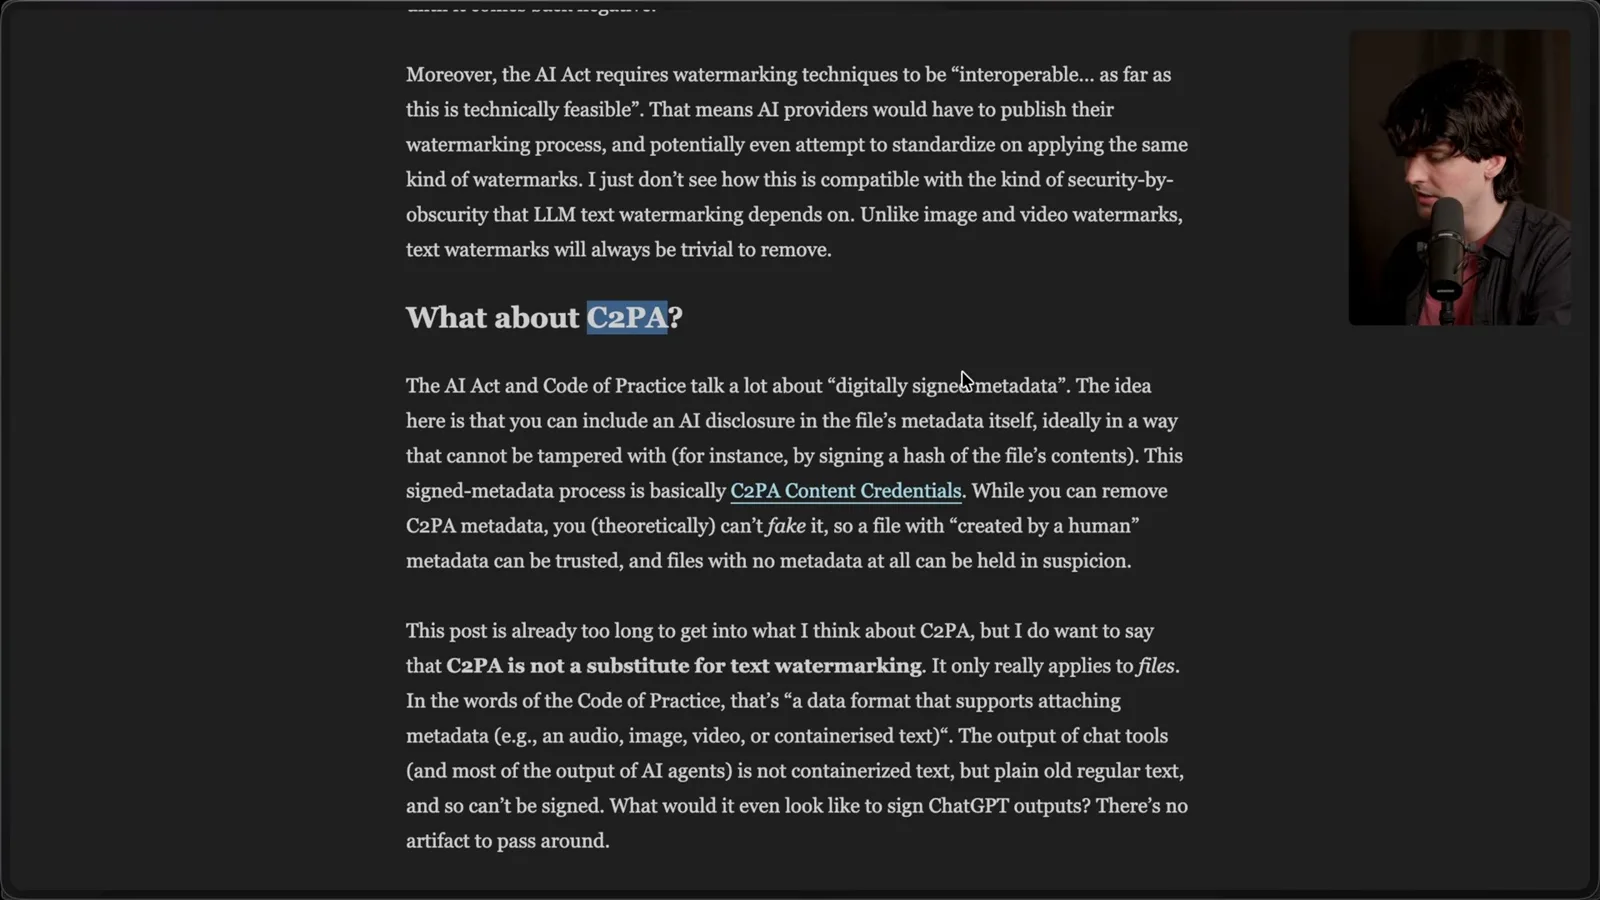
C2PA 采用另一种方法:文件可以携带经过数字签名的来源信息,有时称为 Content Credentials。有效签名有助于验证信息来自某个签名实体,以及绑定的内容没有发生导致凭据失效的变化。它不能独立证明元数据中的每项声明都是真的,也不能证明图像场景真实发生过。
相比试图检测所有伪造图片,我更看好记录相机或人类创作来源的方案。但缺少凭据不能证明图片是假的:真实内容可能从未签名,也可能在传播中丢失凭据。信任程度还取决于签发者以及拍摄和编辑链条。
经过签名的文件元数据,与嵌入纯文本中的水印也不一样。文件格式可以在内容旁携带凭据,而复制聊天文本时,文件的来源记录不会自动随之保留。哪些生成文件携带凭据,还取决于受支持的格式和平台。
我展示了一个声称能处理多种来源标记的仓库,以说明我的担忧:有意规避的人可能尝试修改或移除信号。但这个工具的存在,并不能证明它能击败所有水印,也不能证明它会保留每份文档的原意。不同方案需要独立测试。
我认为这是一个猫鼠游戏:要设计出成本低、能经受有用编辑、又难以规避的可靠信号,很困难。我对单靠文本水印阻止蓄意欺骗持悲观态度。但这并不意味着视频已经测试了某个具体实现,也不意味着所有检测都没有价值。
我们应该明确目标:是识别未编辑的复制输出、阻止学生作弊,还是限制有组织的宣传活动?这些是不同的问题,对手也各不相同。我预计,这种技术对低成本直接复制的帮助,会大于对愿意调整流程的人的约束。
我更看好的长期方向,是加强真实媒体的来源记录,同时教育公众认识逼真的合成内容。即便如此,来源记录也只是文件历史的证据,不能保证内容真实。我理解透明度工作的初衷,但仍怀疑仅靠水印能否达到人们赋予它的期望。
同频道的其他文章
 38:47EN → 简体中文
 Theo - t3․gg· 2026年10月28日Theo 的长时间 Agent 实验:验证、算力与成本Theo Browne · Ping Labs滑板游戏和两个编译器项目展示了反复检查与弹性算力如何支撑 agent 工作,也揭示了循环可能带来的高昂成本。
 36:07EN → 简体中文Theo - t3․gg· 2026年10月27日Theo 谈 Token 成本、编程智能体与 AI 能力的价格Theo Browne · Ping Labs一则关于 Lauren 的 AI 支出估算广泛传播,引出了对缓存计价、基准测试和编程智能体工作方式的讨论。
 30:37EN → 简体中文Theo - t3․gg· 2026年10月26日Theo 的三个技能:用编程智能体审查和交付代码Theo Browne · Ping Labssol-loop、full-send 和 full-stop 如何定义审查、验证以及不同程度的合并权限。
 0:43EN → 简体中文Theo - t3․gg· 2026年10月23日Theo 区分安全漏洞与实际攻击Theo Browne · Ping Labs一段简短讲解:软件漏洞披露和攻击事件为何属于不同类型的安全新闻。
 29:22EN → 简体中文Theo - t3․gg· 2026年10月22日Theo 谈安全漏洞、被盗 API 密钥与 AITheo Browne · Ping Labs从漏洞披露到补丁部署之间的风险窗口,以及被盗推理密钥为何可能有价值的推测。
 31:13EN → 简体中文Theo - t3․gg· 2026年10月20日Theo:更聪明的模型为何能帮助更多人Theo Browne · Ping Labs从游戏修改到编译器实验,Theo 重新思考谁能从更强大的 AI 中受益。