30 秒看懂
2024 年 2 月,Matthew Berman 回顾 OpenAI 早期的 Sora 视频生成演示,其中包括一个类似 Minecraft 的场景。他探讨 Jim Fan 和 Nando de Freitas 关于视频模型能否学习物理行为的有用表示的观点,并设想带合成音频、动态生成的游戏。 这些是对研究的解读和对未来的设想。视频不能证明已经有可靠的物理引擎、可实时游玩的世界、对现实的完美模拟,也不能证明模拟假说。
- 1视频模型作为世界模拟器OpenAI 的研究将扩大视频生成规模描述为通向模拟器的一条有前景的道路。Berman 看到了更广泛的影响,但单个视频示例不能证明世界模型忠实可靠。
- 2模拟假说Berman 解释了我们所体验的现实可能是模拟的这一哲学观点。Sora 和这些演示都不能证明该假说。
- 3类似 Minecraft 的视频Sora 生成了类似游戏及其界面的画面。Berman 提出的可玩、动态生成的游戏超出了演示范围。
- 4Fan 的物理类比Jim Fan 将 Sora 称为数据驱动的物理引擎,并推测可能使用了合成训练数据。这些是解读和假设,并非对 Sora 全部能力或训练集经过验证的结论。
- 5为生成场景配音Fan 讨论未来的视频转音频模型可能如何推断材料与交互。这里讨论的 ElevenLabs 示例被描述为由文本提示生成。
- 6对宇宙的假设性估算Fan 使用假设的模型参数,开展关于模拟代码大小的思想实验。这个数字既没有测量模拟宇宙的大小,也不能证明模拟宇宙存在。
要点建议
- Sora 的早期示例生成了类似熟悉场景的视频,包括一个类似 Minecraft 的环境,但没有展示完整可玩的游戏。
- OpenAI 将扩展视频生成规模描述为通向通用物理世界模拟器的一个有前景的方向,并非证明已经造出完美的模拟器。
- Jim Fan 所说的数据驱动物理引擎是对模型学习到的视觉行为的一种解读;片段没有证明其物理表现始终正确。
- Fan 推测可能使用了 Unreal Engine 合成训练数据,视频并未证实这一细节。
- 将生成画面、语言模型逻辑和音频结合成互动游戏,是 Berman 对未来的设想。
- 假设性的文件大小估算和生成图像不能证明现实是模拟的。
按章节阅读整理后的全文
Sora 与模拟世界
Berman 通过一个类似 Minecraft 的视频介绍 Sora,并概述其早期结果。他比较了生成视频和传统渲染,并讨论 OpenAI 对世界模拟器的表述。
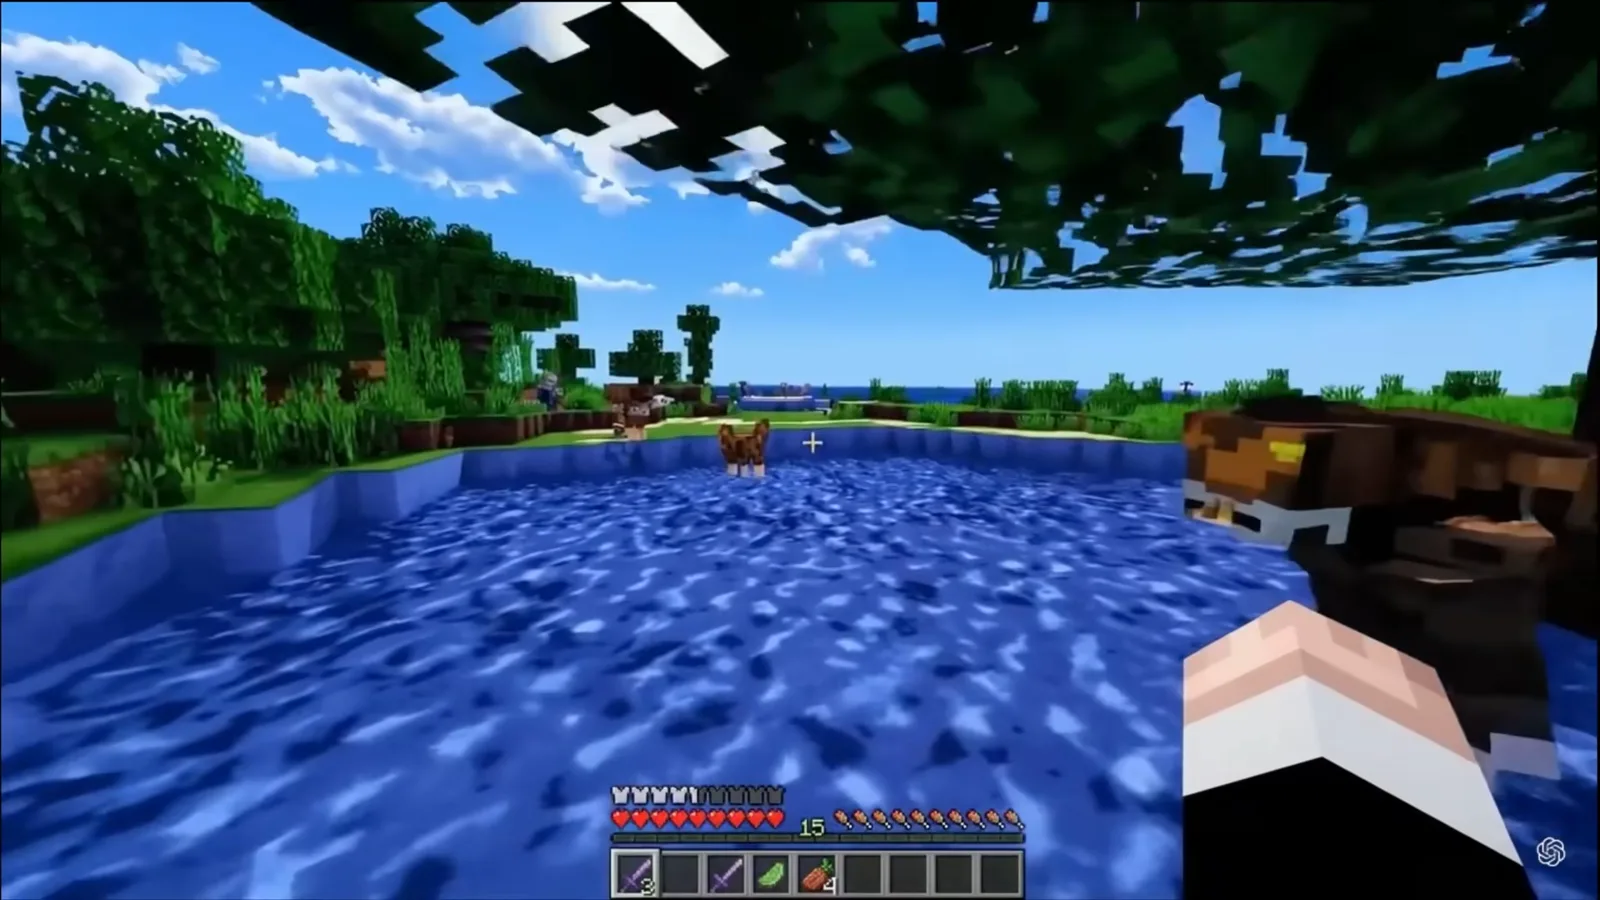
屏幕上类似 Minecraft 的场景被介绍为 OpenAI 的 Sora 生成的视频,而非可玩 Minecraft 游戏的录像。我觉得视频模型能生成这样的场景很了不起,也想探讨这可能对游戏和世界模拟意味着什么。进一步认为我们自己的现实也是模拟的,则是一种哲学假说,视频无法证明这一点。
我在 2024 年 2 月录制这期视频时,OpenAI 刚刚介绍 Sora 并分享了早期示例。我对画面的一致性感到惊讶,认为这项技术最终可能改变游戏。我提出 OpenAI 或许已经拥有更先进但未公开的系统,这只是猜测;公开示例无法证明这些系统能做什么。
OpenAI 将其研究讨论命名为“视频生成模型作为世界模拟器”,并将扩大视频生成规模描述为通向通用物理世界模拟器的一条有前景的道路。我将其与传统游戏引擎作比较,后者通过建模的物体、光照和其他计算来渲染场景。这一表述代表研究方向,并不证明生成的场景遵守所有物理规律。
我提出,Sora 通过学习生成整个场景的方式可能不同于传统图形流水线,最终也可能成本更低。视频没有提供成本或延迟比较,因此这一经济性说法尚未经验证。同样,某个物体令人信服地消失在另一物体后面,也不能证明模型具有完美的物体持续性或始终正确的运动表现。
模拟假说与游戏
他解释模拟理论,并设想实时动态生成和改变的游戏。展示的例子是视频,并未演示这一未来工作方式。
模拟假说认为,我们体验的世界本身可能是一种模拟现实,而人类是模拟的一部分。我喜欢思考足够详细的模拟世界是否能与现实区分,并提到相关虚构剧集 Devs。更好的视频生成技术不能证明这种完整模拟可行,更不能证明我们生活在其中。
当时的游戏画面能够近似环境,但仍与现实不同。我设想一种不同的方法:使用基于扩散和 Transformer 的视频生成,而不是明确指定每一个视觉细节。Sora 生成的是视频;这次介绍并不能证明它一次性计算了整个物理上准确的世界。
类似 Minecraft 的例子不仅有场景,还呈现出游戏界面的外观。我设想将视觉生成器与了解游戏规则的语言模型结合,让人们只需描述游戏就能玩,而不必手写每一条规则。不过,该片段是生成的视频,并未展示实时控制、持续保存的状态或可玩的 Minecraft 实现。
尽管模型仍处于早期阶段,我觉得这些早期视觉结果令人印象深刻。看起来像生成世界的画面提供了一种思考游戏构建的新方式,但不应假定它实现了准确的游戏物理,或能可靠地保持所有物体。单看输出,也不能直接确定模型如何生成每个看似存在的细节。
一段车辆穿越山地的视频让我想到另一种游戏形式。未来的系统可能不使用固定的预渲染环境,而是随着玩家移动生成场景。它甚至可能根据请求将山地变成沼泽,或改变重力规则。这些都是设想中的能力,而非 Sora 视频已经展示的功能。
我还想起一项在模拟环境中放置 25 个 AI 智能体的实验,智能体形成了日常活动和关系。将类似方法与生成画面结合,可能产生反应更加灵活的非玩家角色。我称它们实际上像活着一样,是表达我感兴趣的一种可能性,并非证明这些智能体有生命或意识。
Jim Fan 对 Sora 的解读
Berman 阅读 Fan 关于学习得到的物理引擎的观点,并分析一段海盗船视频。Fan 关于 Unreal Engine 合成数据的说法仍属推测。
NVIDIA 研究员 Jim Fan 将 Sora 描述为“数据驱动的物理引擎”:按照他的解读,训练视频模型可能使其学习视觉渲染、直观的物理规律和语义背景。这是思考这些示例的一种有用方式,但逼真的视频不能证明模型始终正确地推理或模拟物理规律。
Fan 推测,Sora 的训练数据中可能包含用 Unreal Engine 5 生成的合成视频。这种可能性并不代表已经证实使用了它们。我想知道,学习式视频生成有朝一日能否取代传统游戏制作的某些环节,不过视频没有证明它更便宜或效率更高。
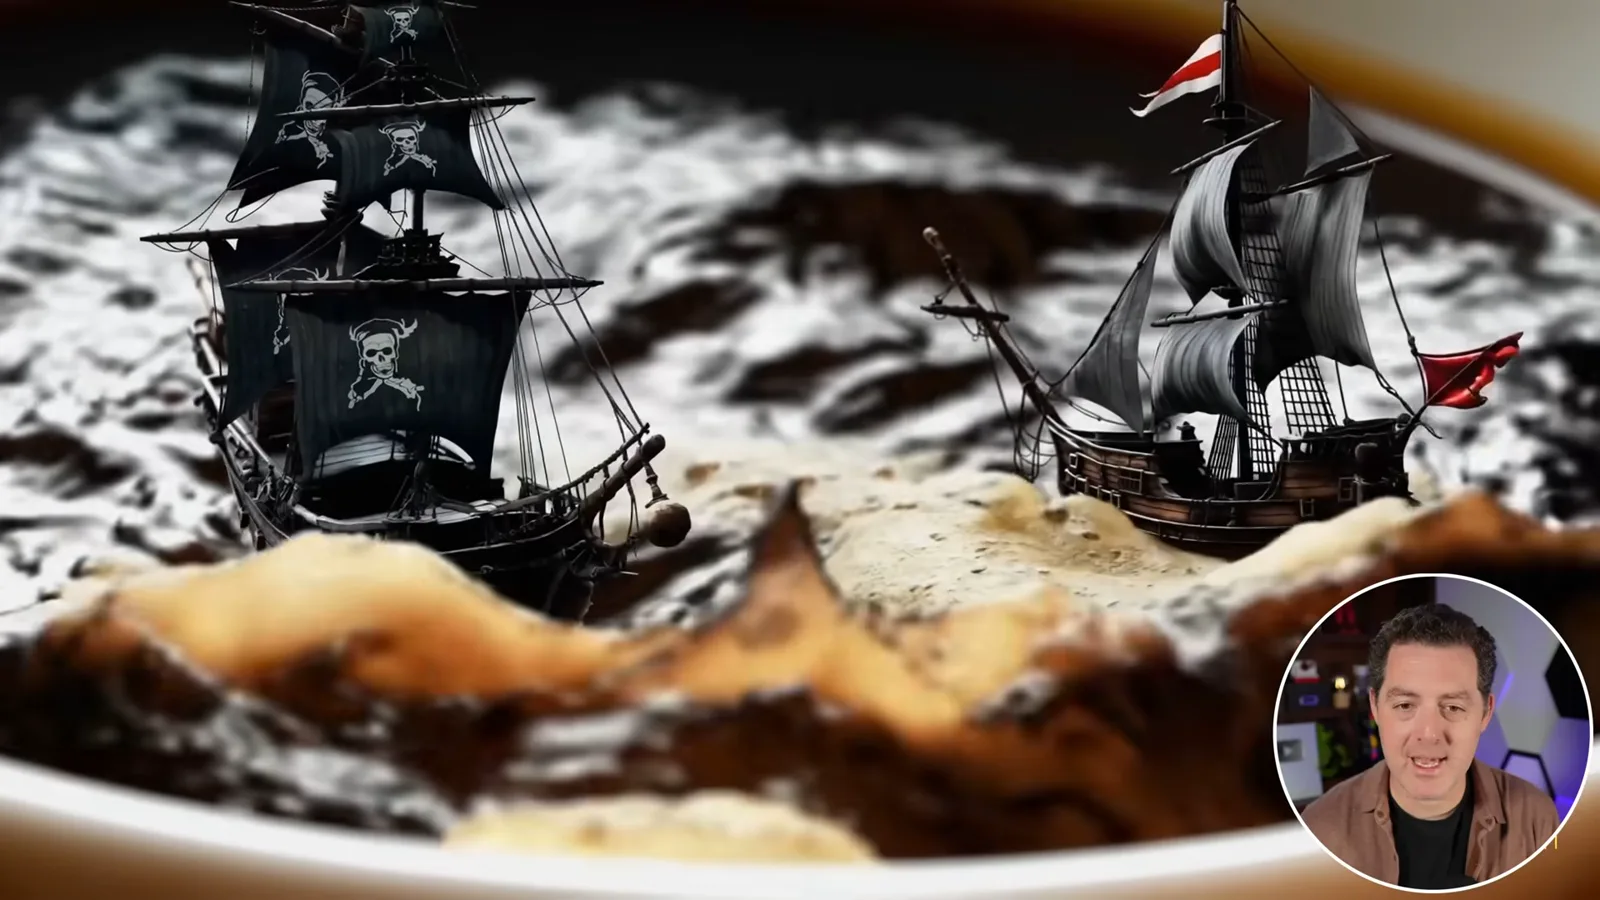
Fan 分析了一个生成场景:两艘海盗船在一杯咖啡中航行。他指出船只不同的外观、它们的运动、咖啡和泡沫,以及微缩摄影般的效果。这些特征可以用来讨论看似合理的视觉行为,但不能证明模型内部存在明确的 3D 资产或经过验证的流体模拟。
在后续说明中,Fan 解释说,他指的是一种以文本或图像为条件生成视频的端到端扩散 Transformer,其规律学习在模型参数中。他说生成时不需要运行 Unreal Engine,并提出其合成数据可能用于训练。这仍是对训练集的假设。
合成音频与学习到的物理线索
ElevenLabs 的音频与 Sora 示例结合。Fan 思考更充分地以视频为条件的音频模型可能需要推断什么。
后来,ElevenLabs 将合成音频与 Sora 示例结合,包括音效和带旁白的场景。我可以想象未来的系统将生成画面、游戏逻辑和音频结合起来。这些例子展示了媒体的组合,而非完整的互动世界模拟。
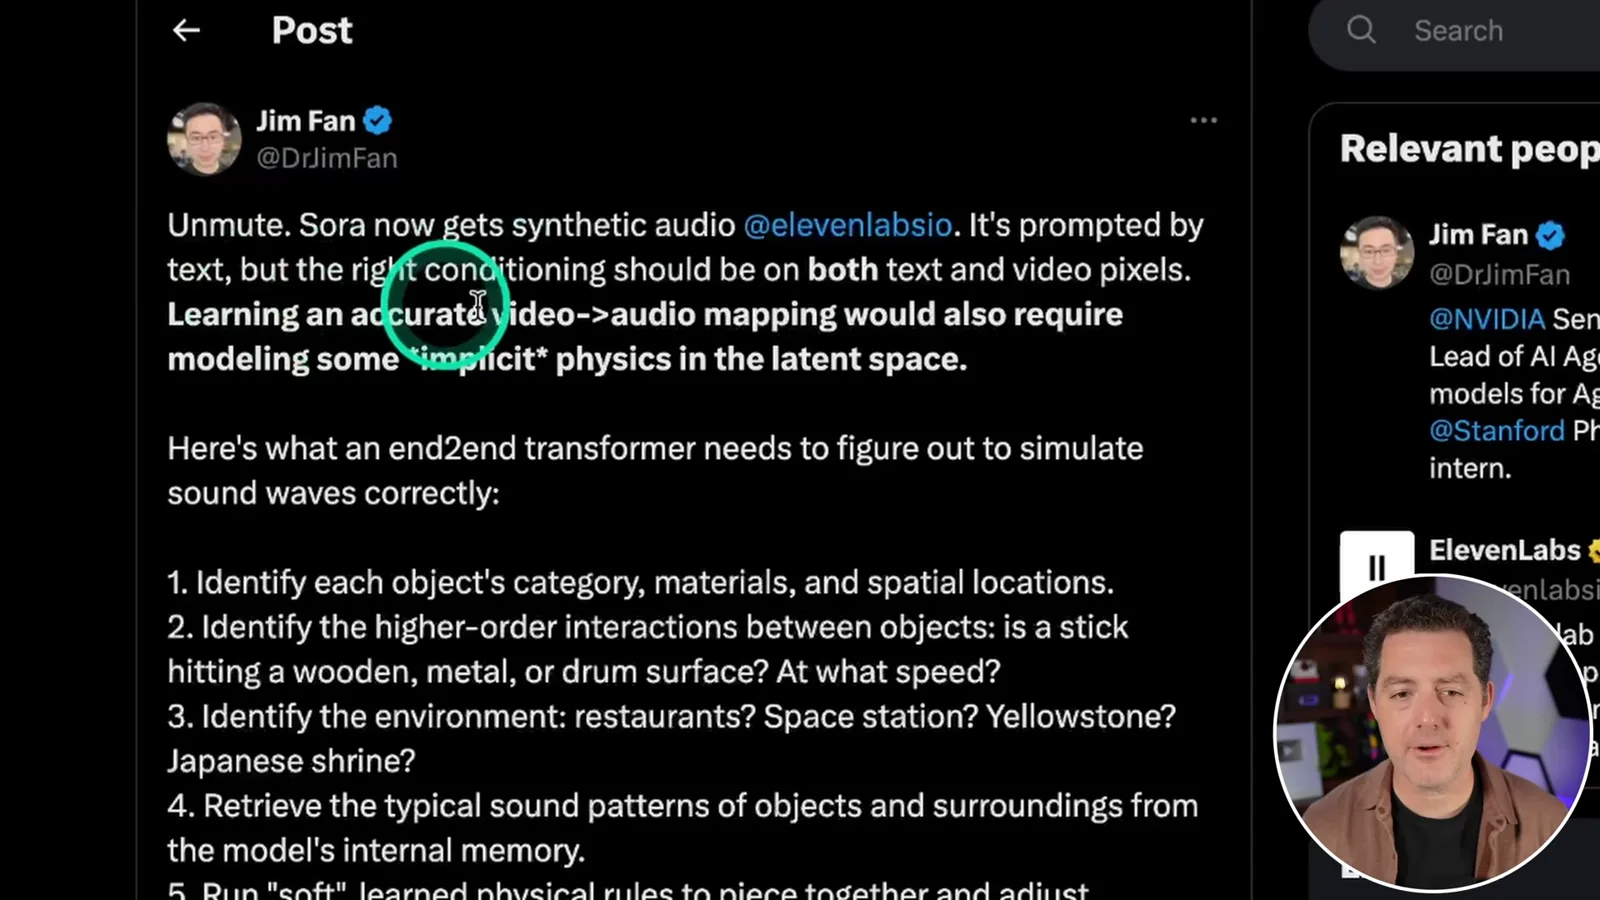
Fan 指出,音频示例由文本提示生成,并提出准确的视频转音频系统还应该以视觉信息为条件。按照他的说法,系统可能需要推断物体类别、材料、位置、交互和周围环境:棍子敲击木头、金属或鼓面时,声音应该不同。
他设想模型可以组合学习到的声音模式,针对场景调整它们,或合成新声音,并在繁忙环境中叠加声音。他将这些描述为端到端模型可能学到的能力,而不是 ElevenLabs 演示中已经独立验证的模块清单。
假设中的模拟及其大小
Berman 讨论 Fan 的假设性大小计算和柯尔莫哥洛夫复杂度。最后,他介绍 Nando de Freitas 的观点以及自己对动态游戏的期望。
随后,Fan 就假设中的现实模拟提出一个思想实验。他以 Meta 拥有 60 亿参数的 Emu Video 为起点,假设模型规模大十倍、权重为 16 位,粗略算出假设二进制文件约为 111 GB。假定的模型大小并非已证实的 Sora 规格,这一计算也不是对模拟宇宙所需信息量或算力的测量。
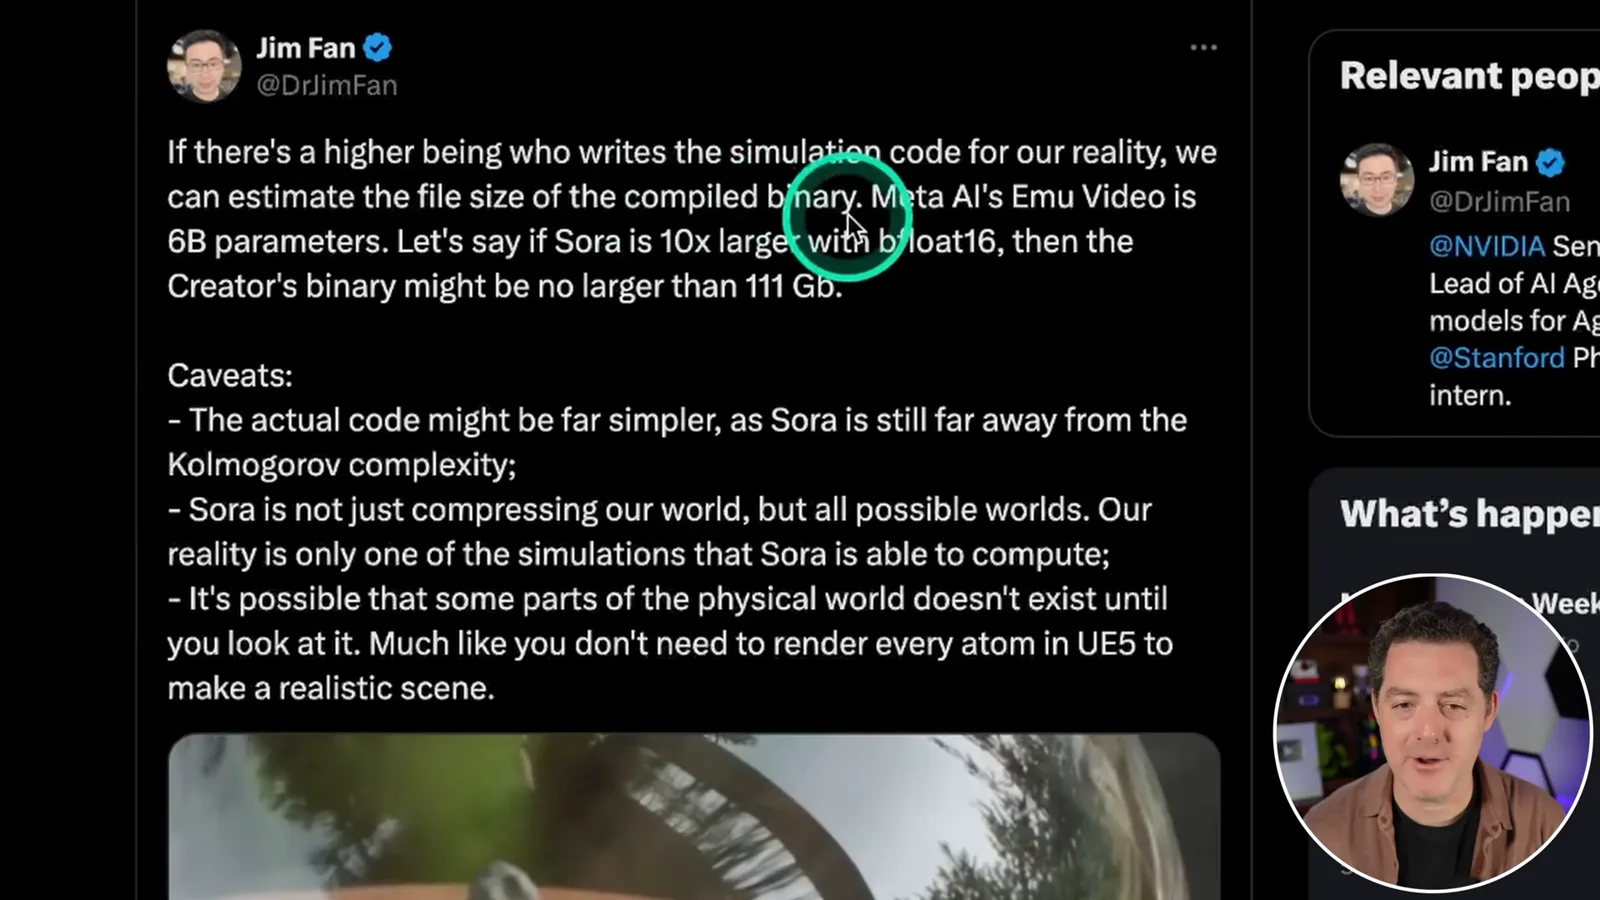
Fan 补充了一些限定,包括最短描述可能更简单的想法,并提到柯尔莫哥洛夫复杂度:在选定框架下,生成给定对象的最短程序的长度。他还推测,世界中未被观察的部分可能不需要渲染。这些是类比和猜想;视频没有证明物理现实是这样生成的。
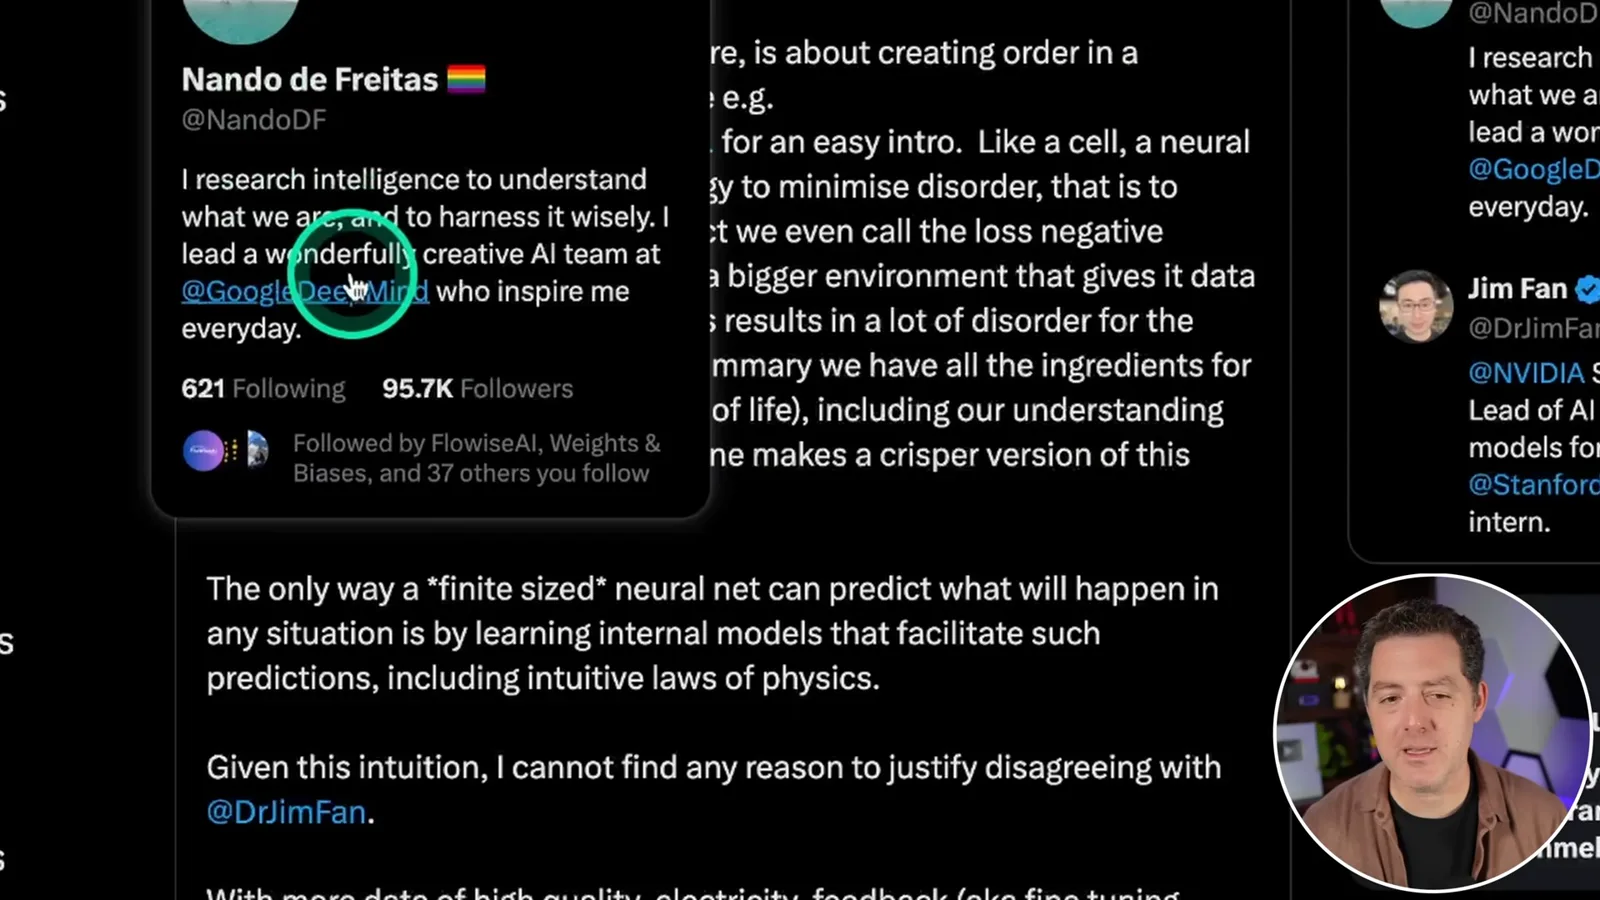
Nando de Freitas 认为,有限规模的神经网络要预测事件,就必须学习有助于预测的内部模型,包括直观的物理规则;他说自己认同 Fan 的大体直觉。他预计,更好的数据、反馈和训练可能带来更强的物理推理能力。我对能够适应玩家描述的游戏前景感到兴奋,同时也认识到展示的演示尚不能证明这样的未来。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。