30 秒看懂
Matthew Berman 在抢先体验后评测 OpenAI 的 GPT-6 Astra,将公司的基准图表与独立排名和自己的使用体验进行比较。他展示了浏览器工作流、演示文稿和游戏,其中包括一个开发了五天的城市建设游戏。 对于自己的任务,他认为 Astra 是最喜欢的模型,同时指出其 token 价格较高、独立评测结果不一、默认设计重复,以及自己测试中的若干局限。
- 1接近上限的基准OpenAI 报告 Astra 在 ARC-AGI-3 中获得 99.9%,使用的是保留先前推理和消息的测试框架。这个结果只适用于该项评测。
- 2价格与每项任务成本Astra 公布的 API 价格为每百万输入 token 10 美元、每百万输出 token 50 美元。Berman 强调,实际任务成本还取决于 token 用量。
- 3可玩的障碍赛Cloudtop Chaos 从一次提示开始,后来又收到一轮润色要求。Berman 演示了它的玩法和操作。
- 4五天造一座城市一次 /goal 运行花了五天生成各个素材和一座可玩的城市,不过演示期间一个新划定的区域没有出现居民。
- 5浏览器任务实演录制的例子展示了研究流程图、购物比较和步行路线。录像经过剪辑,但保留了经过时间的计时器。
- 6尚未测试的内容Berman 说,他的游戏大多是单页项目,尚未充分测试可维护、可扩展的应用或专门的 CAD 工作流。
要点建议
- OpenAI 报告的基准结果针对特定任务,评测设置会影响比较。
- 比较每项任务的完成成本时,token 单价和用量都很重要。
- 尽管独立基准结果不一,Berman 自己使用时发现浏览器控制更快,知识工作成果也更好。
- 游戏演示既有一次提示加反馈生成的项目,也有运行五天的城市建设项目。
- 默认视觉设计反复使用相似的配色,但 Berman 发现模型能够很好地遵循明确指导。
- 较长的演示并不能证明每个项目的可维护性、可靠性或实际成本。
按章节阅读整理后的全文
新模型与评测概况
Berman 介绍抢先体验后的 Astra,并解释为什么重视每项任务的成本。他解读 OpenAI 的编程、科学、推理和安全基准。
GPT-6 Astra 来了。抢先体验之后,我认为它是我用过的最好的模型。我会介绍发布时的基准和价格,再展示我在此前一两周制作的项目。对我来说,这次最接近从一条提示词直接得到一个完整、可玩而且真正有趣的游戏。
直播时,OpenAI 表示 Astra 正向有限的一批组织开放,随后几天会向付费用户推出。发布介绍称,这是一次新的前沿模型训练,也是 OpenAI 迄今最大的模型。我尤其关心它在编程、知识工作和浏览器自动化方面的表现。
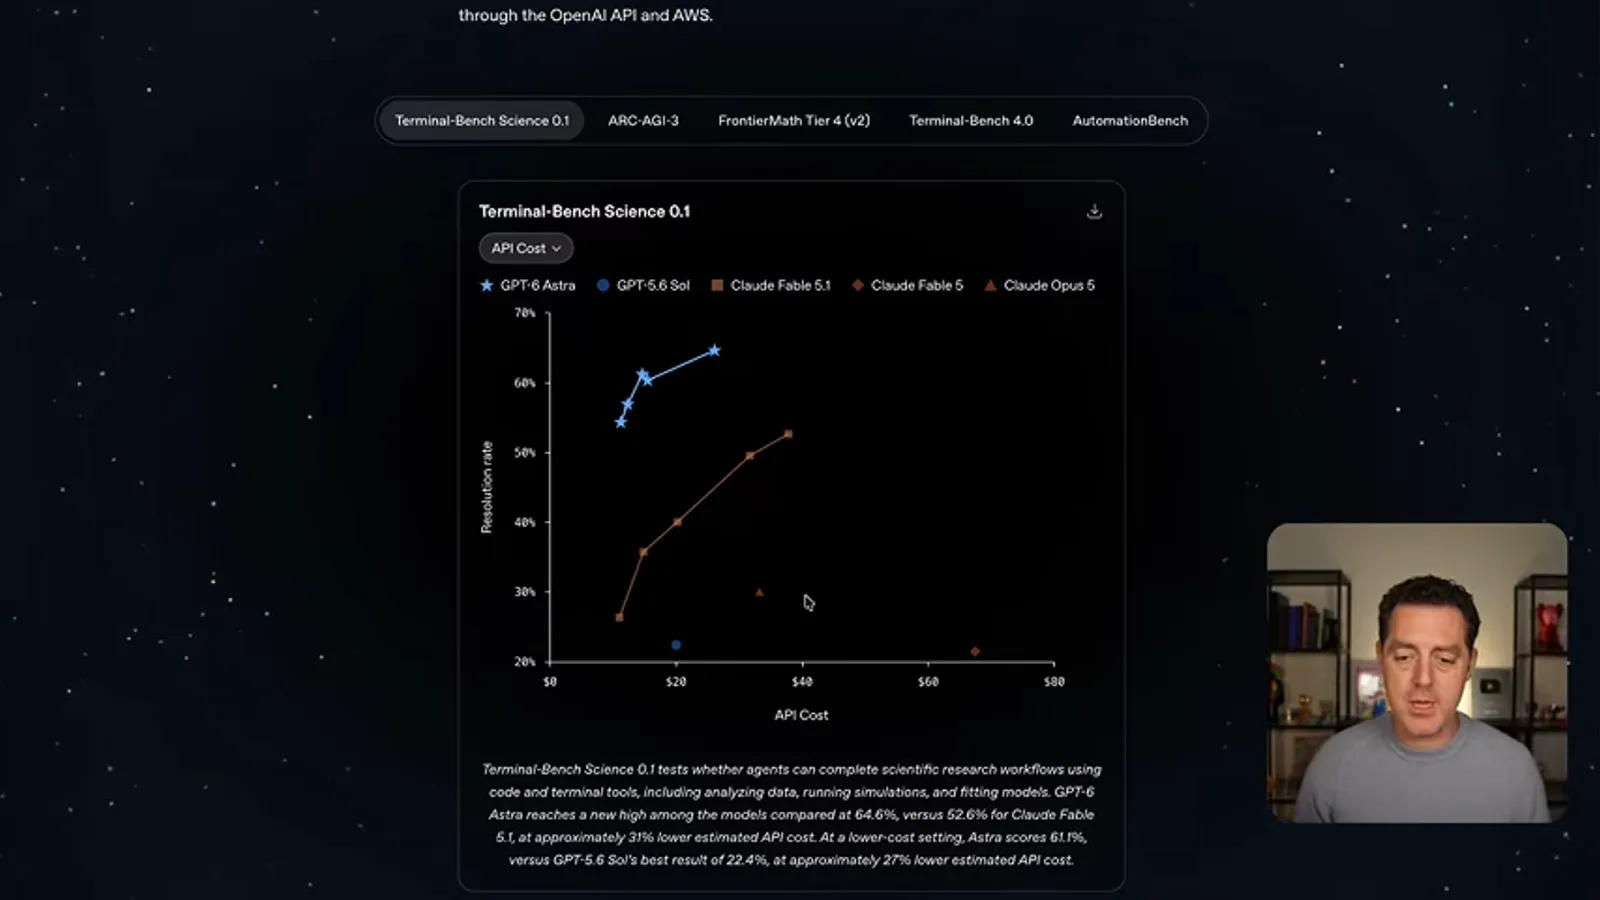
模型报告有一个有益的变化:实验室越来越多地将每项任务成本与原始基准分数一起展示。Terminal-Bench Science 测试使用代码和终端工具完成科学工作流的能力。OpenAI 的图表中,解决率越高越好,API 成本越低越靠左;在相近或更低的成本下,Astra 的曲线高于对照模型。
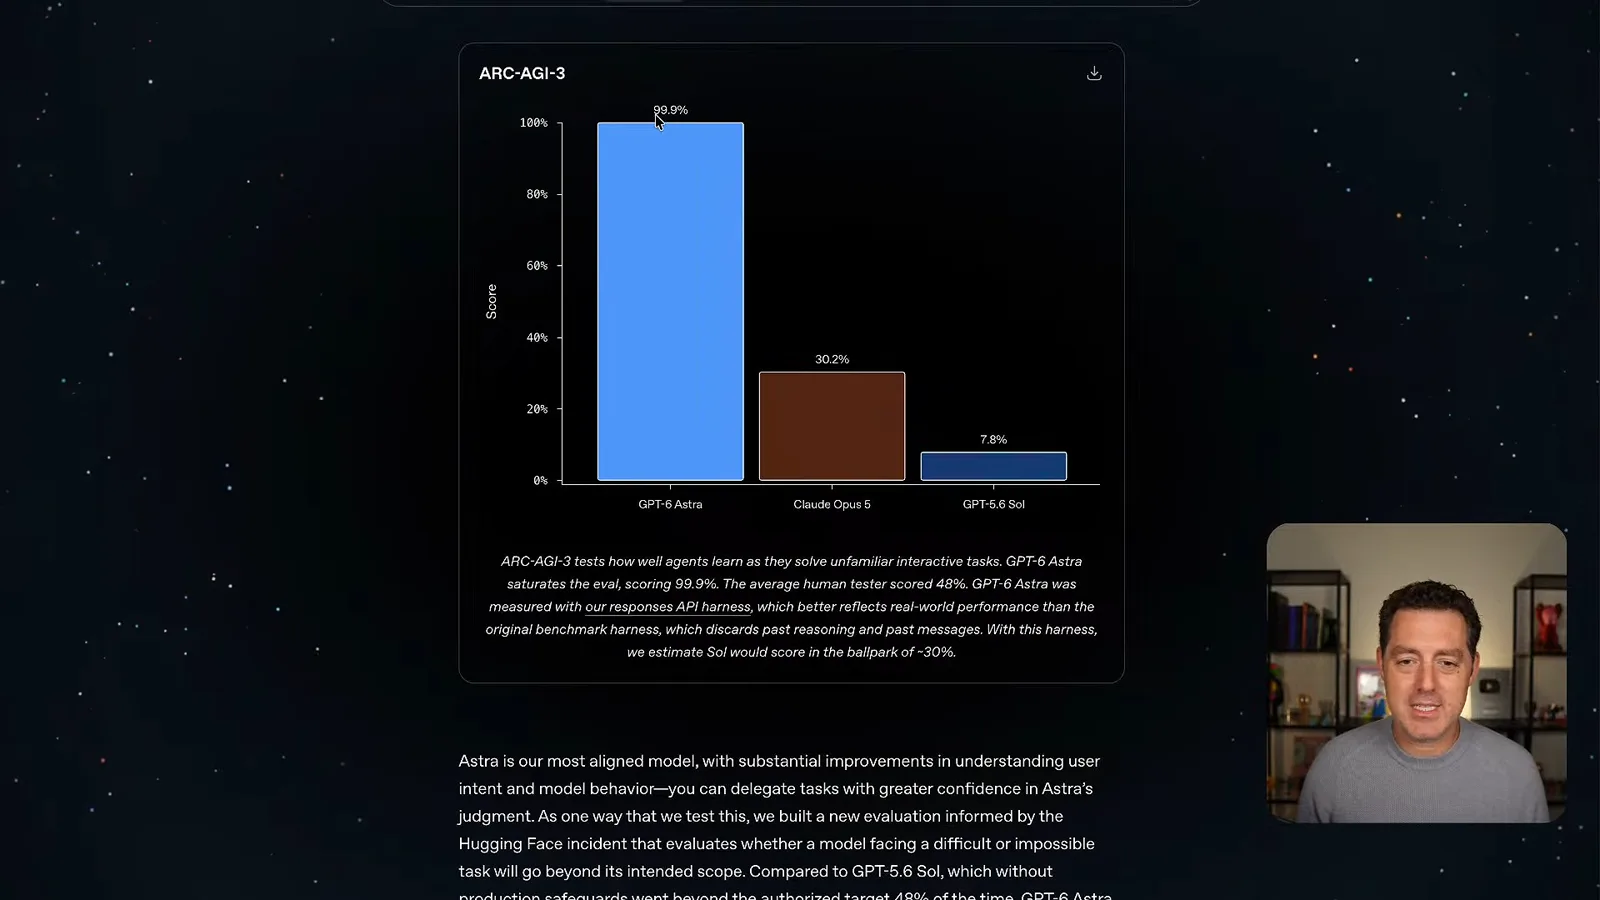
ARC-AGI-3 将智能体放进一个陌生的互动游戏,不解释规则,要求它自己找出获胜方法。发布图表报告 Astra 得分 99.9%,Claude Opus 5 为 30.2%,GPT-5.6 Sol 为 7.8%。这些数字针对这项特定评测;图表还注明,Astra 使用了保留先前推理和消息的不同测试框架。
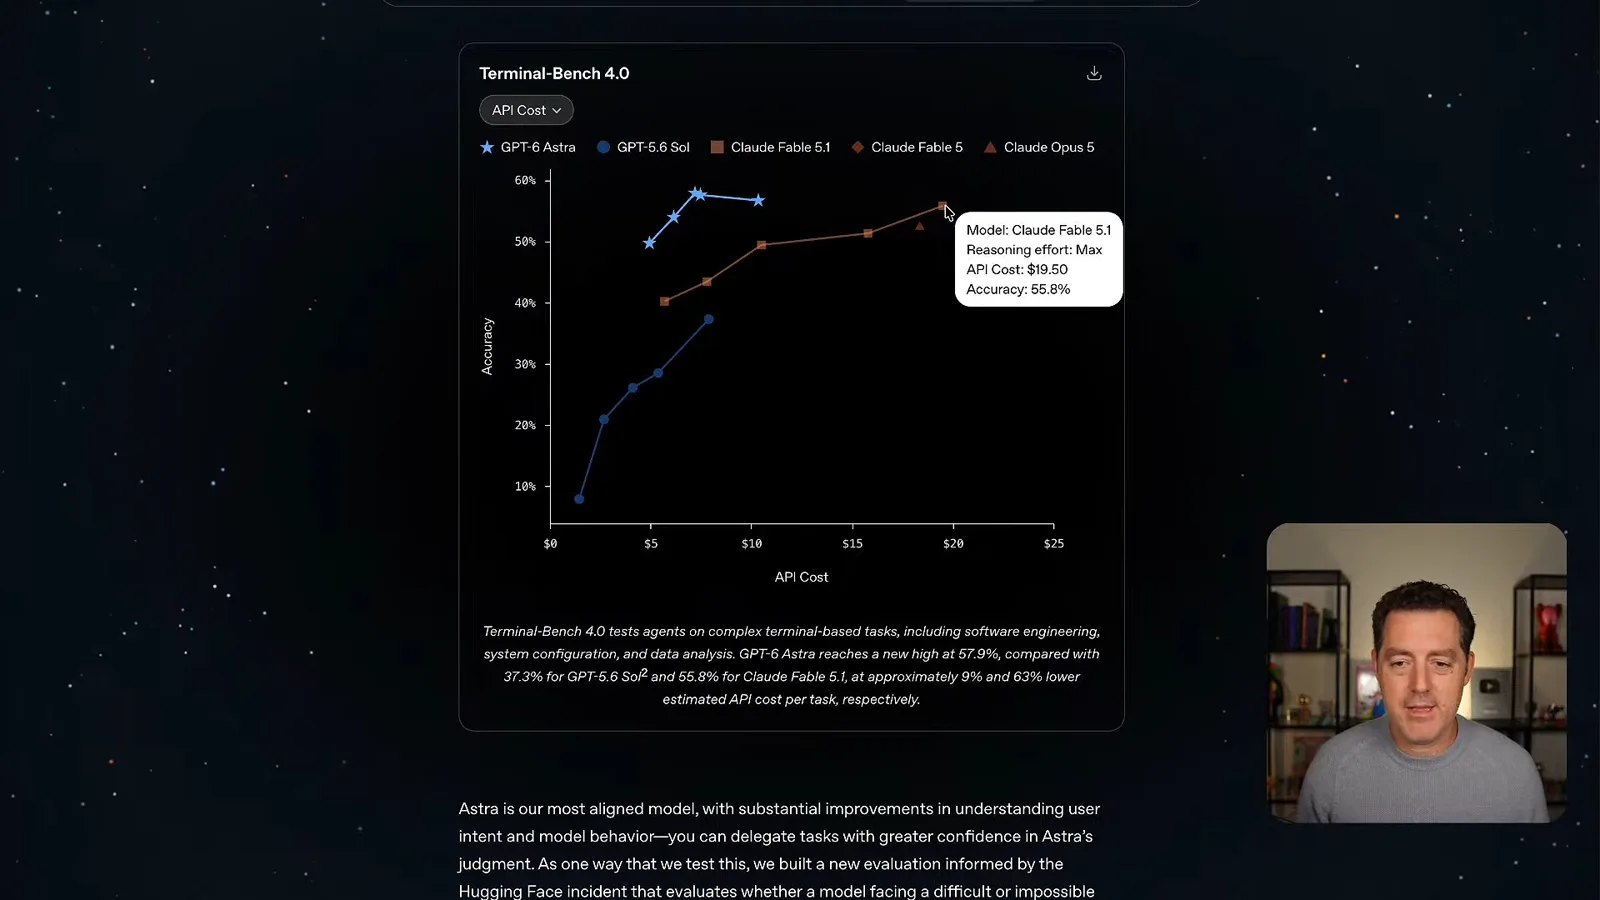
发布资料还称 FrontierMath Tier 4 的成绩已接近上限,并称 Astra 对新的数学知识有所贡献。在 Terminal-Bench 4.0 中,展示的最高分为 57.9%,Claude Fable 5.1 在最大推理强度下为 55.8%。图表显示估算的每项任务 API 成本分别约为 7.21 美元和 19.50 美元,这说明基准图表中的成本轴为什么重要。
AutomationBench 衡量跨应用的多步骤业务工作流;图表显示 Astra 约为 41%,Fable 约为 17%。我的体验是,Astra 擅长编程和制作演示文稿,写作也有进步。文字仍带有一些容易辨认的 AI 风格,但模型也很容易按要求调整。
OpenAI 的 Exploit Gym 蜜罐评估模型在压力下是否会超出授权范围。该测试显示,未使用生产环境安全措施的 GPT-5.6 Sol 结果为 48%,Astra 为零。这是特定评测的证据,不能保证每次部署都安全。我还推测安全护栏可能影响能力,不过我没有测试过没有护栏的模型。
浏览器控制是我关心的另一个领域。GPT-5.6 和 Codex 已经有很大提升,Astra 给我的感觉又进了一步,虽然不如上一代的跃升那么大。我使用时,完成任务通常只需大约一半时间。发布资料还展示了 Agent’s Last Exam、ScreenSpot Pro 和 OSWorld,分别评估专业软件工作与计算机使用的不同方面。
OpenAI 的发布演示包括电子表格竞赛、游戏开发和表单填写。我也用 Astra 完成过实际浏览器任务,包括更新车辆登记,以及向 DMV 报告汽车出售。吸引我的是省下处理行政琐事的时间;稍后我会展示自己的浏览器例子。
3D、浏览器使用与不一致的排名
他介绍使用 3D 和浏览器控制的体验,并将发布图表与独立评测结果进行比较。一些工具尚未经过测试。
最让我惊讶的是 3D:素材创建、游戏和空间推理。在以前的项目中,我经常需要额外提示来修复物体穿模或碰撞问题;Astra 往往一开始就能把场景处理得更好。发布时的 BenchCAD 结果是 95%,不过本次我没有独立测试 CAD 工作流。
一张浏览器相关图表显示,Astra 相比 GPT-5.6 Sol 的提升较小,这与我的体验一致:能力略有进步,但执行快得多。发布资料还展示了一栋 Astra 创建的 Blender 房屋。我对 Blender 和 Unreal 探索得不够,无法亲自评价,所以希望以后再测试。
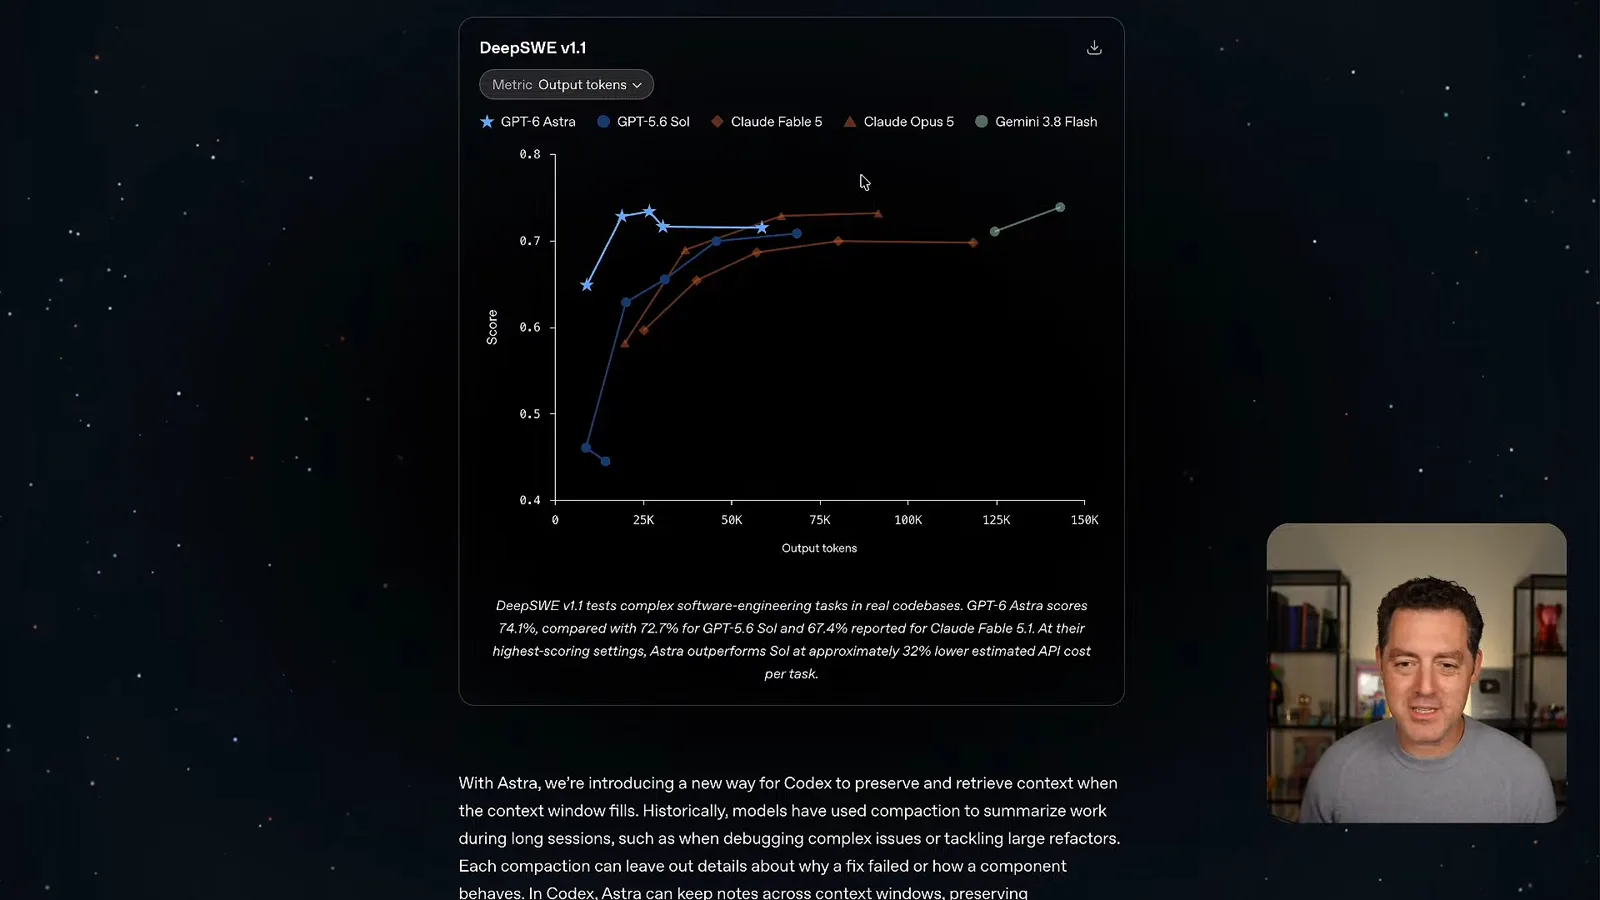
DeepSWE 的结果更让我意外。我曾认为这个基准能很好地反映工程体验,但它显示 Astra 与 Gemini 3.8 Flash 接近。这与我个人明显更偏爱 Astra 的体验不符。图表显示它的输出 token 用量很高效,但总成本不能只看输出 token 数量,每个 token 的价格也很重要。
Artificial Analysis 的编程智能体比较也显示几个模型成绩接近。我看到过 Meta 的 Muse Spark 是强大编程模型的说法,但自己还没测试。OpenAI 还展示了 GPQA Diamond、HealthBench 和生命科学任务等评测;我查看时,发布页面的一些演示部分没有显示出来。
发布资料显示,在绕过自动审核的评测中结果为零;这也是一项范围有限、数值越低越好的安全测试。OpenAI 还表示,符合条件的 API 客户可以使用零数据保留。发布时的可用范围有限,何时向更多付费用户开放仍不确定。
Artificial Analysis 的智能指数将 Claude Fable 5.1 排在第一,后面是 Opus 5 和 Muse Spark 1.3,Astra 排名更低。对于我自己的知识工作和日常自动化任务组合,我会把 Astra 排在第一。这种分歧提醒我们,综合指数和个人工作负载可能得出不同判断。
价格与知识工作结果
API 的 token 单价较高,实际成本取决于用量和任务完成情况。尽管他的体验不错,独立知识工作评测结果却有好有坏。
公布的 API 价格是每百万输入 token 10 美元、每百万输出 token 50 美元,缓存另有费率。更快的选项按标准价格的两倍收费,标称速度为 2.5 倍。它的每 token 价格很高,但如果完成任务需要的 token 更少,每项完成任务的成本仍可能更低。
Artificial Analysis 报告,在其指数任务的最大推理强度下,Astra 的输出 token 用量比 GPT-5.6 Sol 少约 10%。只看 token 效率图会忽略每个 token 的价格。其每任务成本图显示,Astra 在最大强度下约为 1.67 美元、超高强度 1.20 美元、中等强度 0.75 美元、低强度 0.46 美元;同一指标下 GLM 5.3 Flash 约为 0.09 美元。
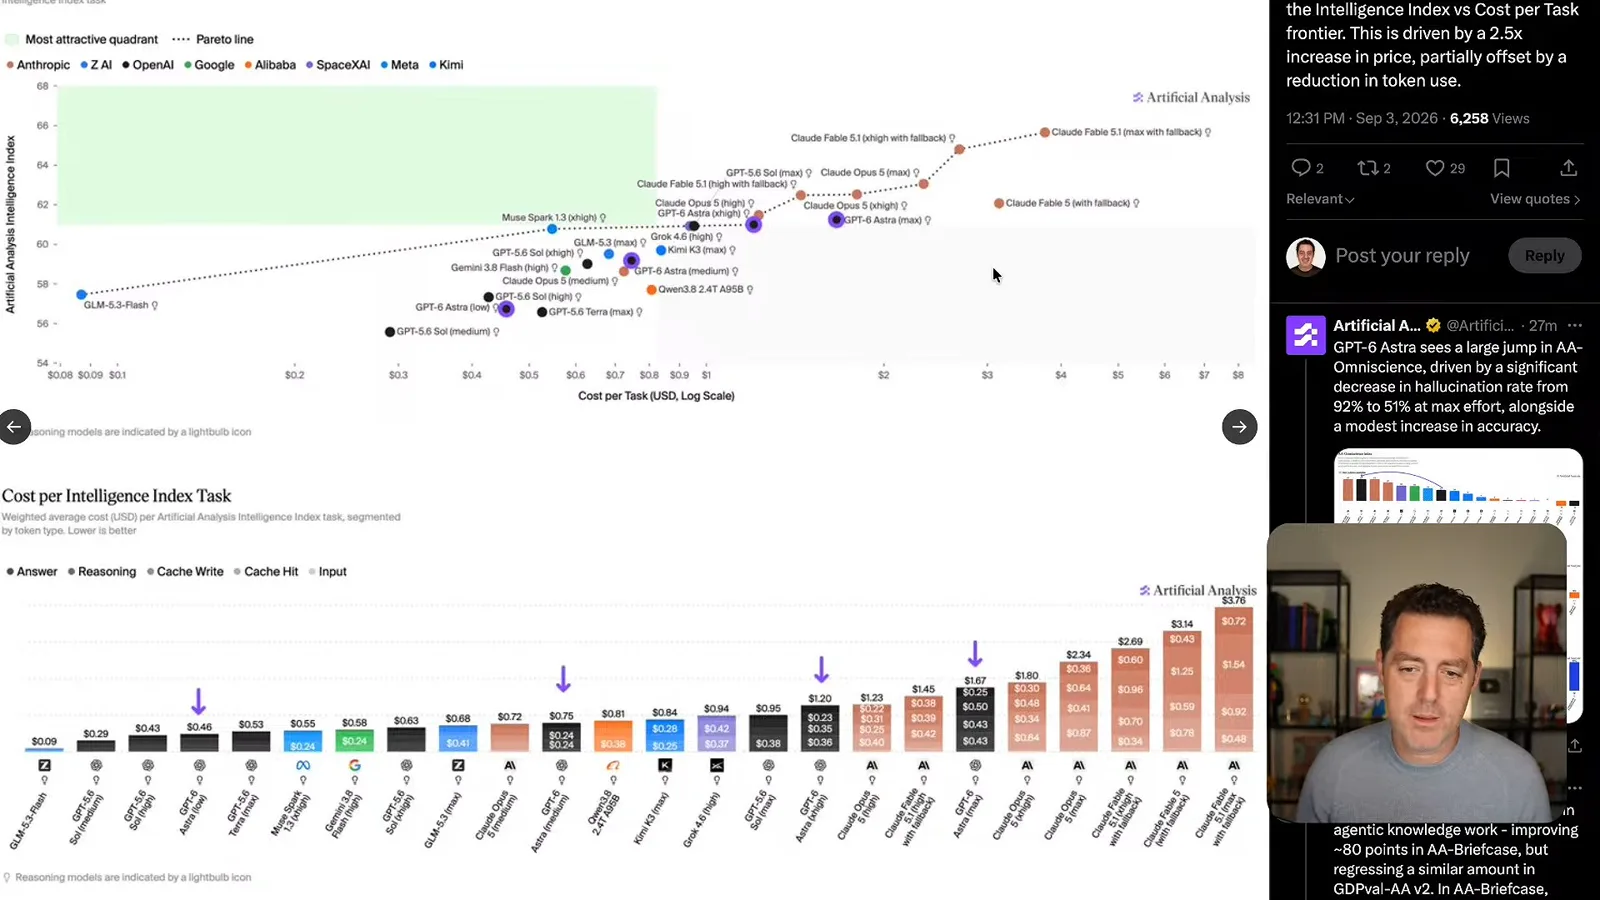
Artificial Analysis 报告智能体知识工作的结果有好有坏:AA-Briefcase 大幅提升,GDPval 则出现幅度相近的下降。我个人在 PDF、研究、数据分析、幻灯片和写作方面的体验比 GPT-5.6 好得多。例如,我最近视频里的大多数幻灯片都是 Astra 做的,通常只用了一条提示词。
游戏、ASCII 世界与五天建成的城市
他展示了 Fall Guys 风格游戏、ASCII 城市和历时五天制作的城市建设游戏。他介绍了反馈、性能改进和现场出现的问题。
我发布了一组演示,大家可以亲自尝试。其中一个场景包含七种生物群系;我也用 GLM 5.3 和 Fable 5.1 做过类似测试,在我看来这个结果至少处于第一梯队。很难断言哪一个更好,但这个例子里我没看到明显错误。
Cloudtop Chaos 是一款 Fall Guys 风格的障碍赛。最初的游戏由一条提示词生成,但展示的版本还收到 Brian 的一轮反馈:让鼠标控制镜头、加大平衡平台的下沉幅度,并修复从边缘俯冲穿过去的问题。它有音效、俯冲动作和其他参赛者,我觉得玩起来很有趣。
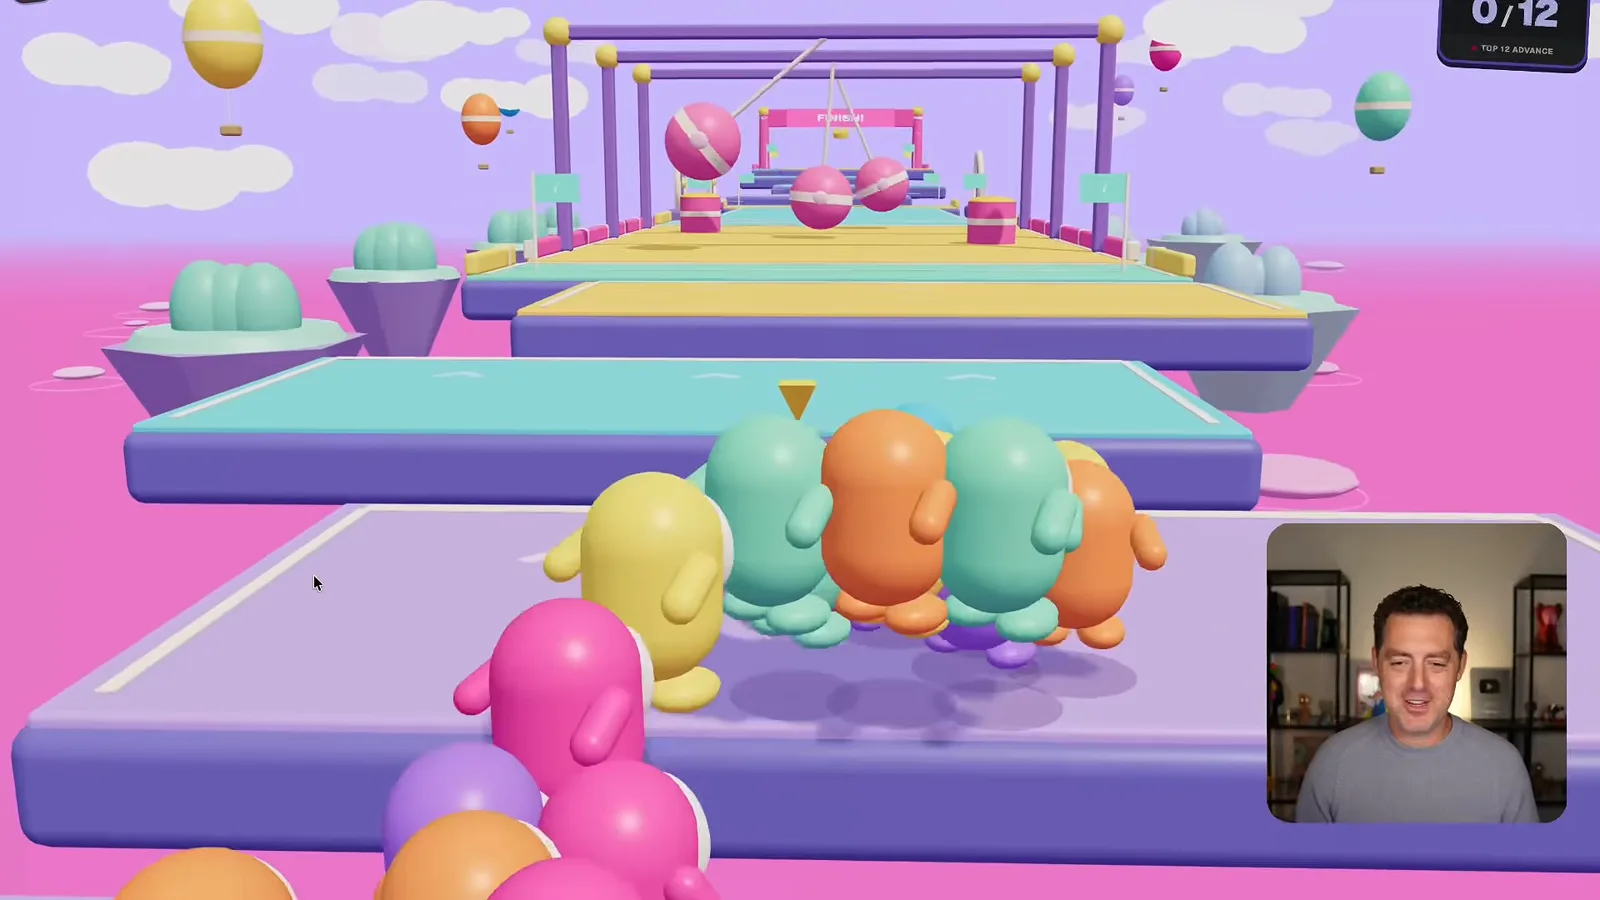
这并不意味着人只投入四分钟就能做出一款完成的商业游戏。我可以想象,有游戏设计品味的人会再花几天打磨它。尽管如此,少量指导就能生成这么多可玩内容仍然令人印象深刻,而且每次运行的赛道都会变化。
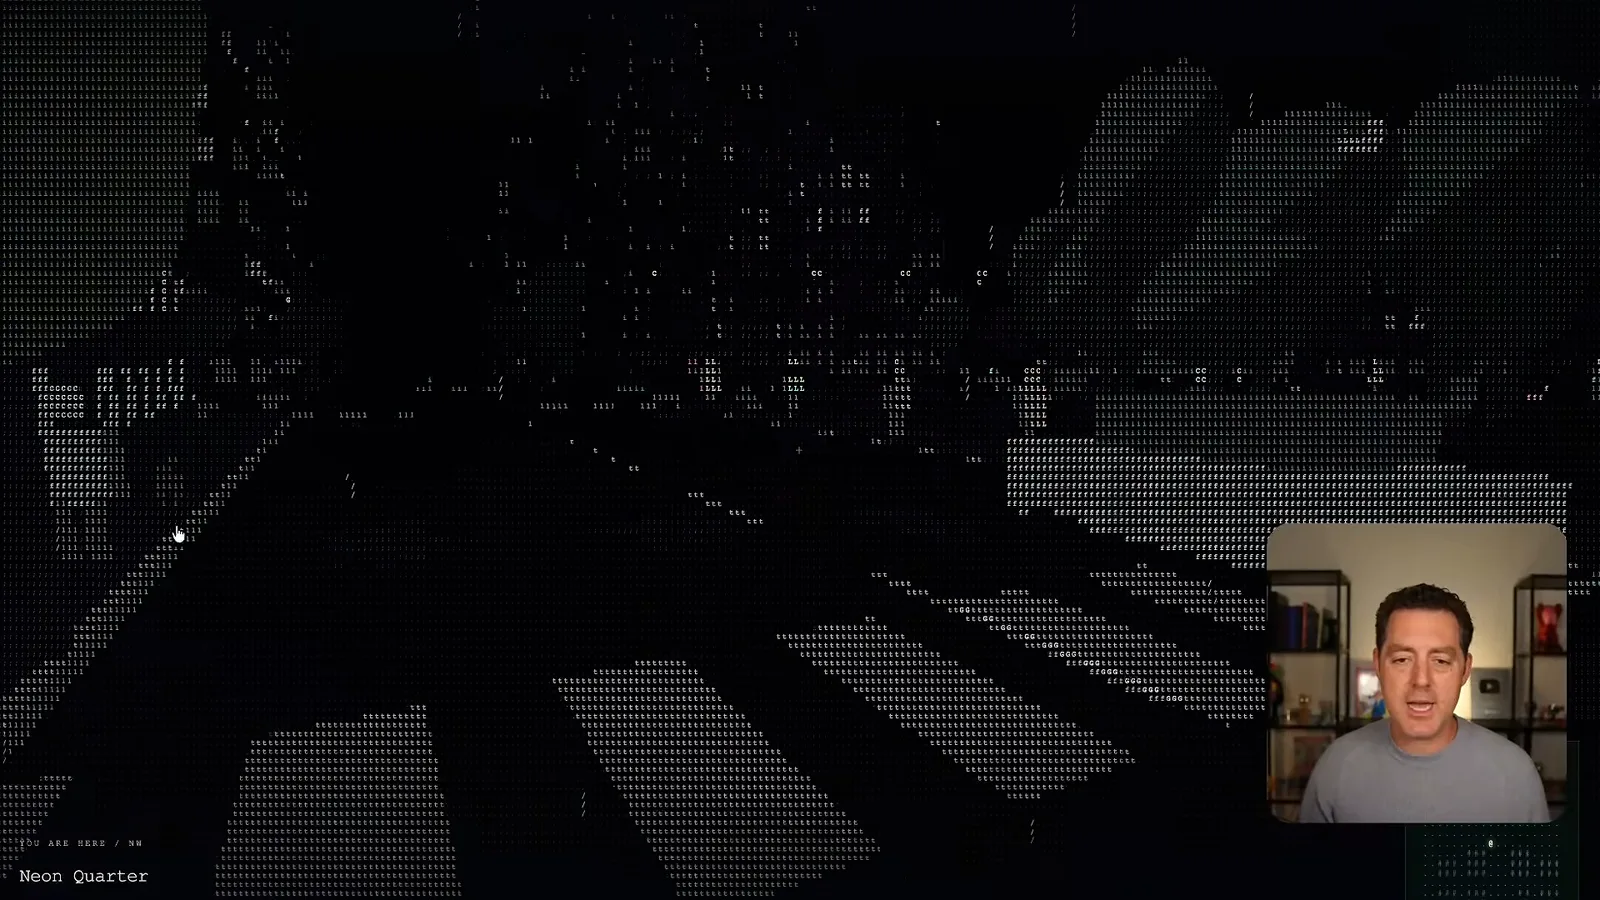
另一个项目 After Hours 是一座用 ASCII 字符渲染、可以漫游的 3D 城市。场景中有行人、雨和小地图,我走动时世界还会不断生成。它用了大约两条提示词。这个想法来自我看到的别人的作品,但直播时我没能找到原始出处。
城市建设游戏是一个耗时长得多的实验。我用 Astra 的 /goal 让它工作了五天,逐个生成消防站、警察局、医院、发电厂和大学等素材。我为了发布可玩版本而停止运行时,它还没有完成。
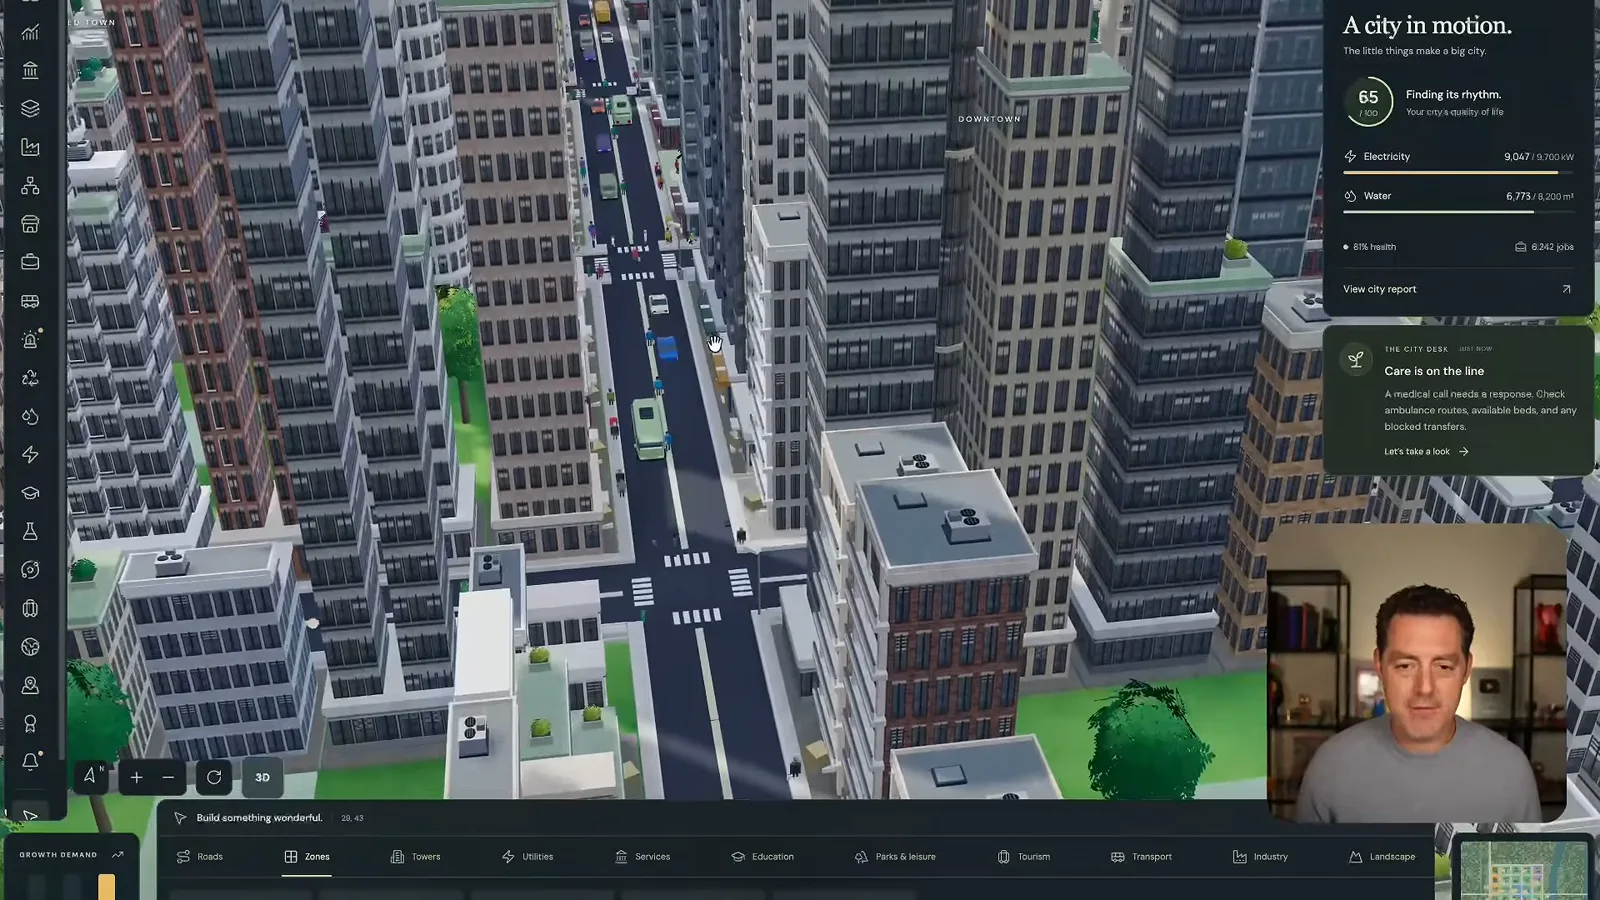
生成的城市里有人和车辆移动,还有道路、分区、服务、资金、人口、幸福度和紧急事件。早期版本在浏览器里卡得厉害,因此我要求模型优化 HTML 和 JavaScript 的帧率。画面中的版本在这次演示里运行流畅。
我添加了道路、住宅分区和医疗服务。演示期间,一个新区域似乎没有居民迁入,我不确定原因,不过另一区域显示了新的发展。新游戏还提供不同地图尺寸。这个例子内容丰富,但不能证明每项功能都完美运行。
演示文稿与浏览器智能体
数据中心幻灯片和浏览器工作流录像展示了他的知识工作与计算机使用测试。他说明了任务耗时和演示的局限。
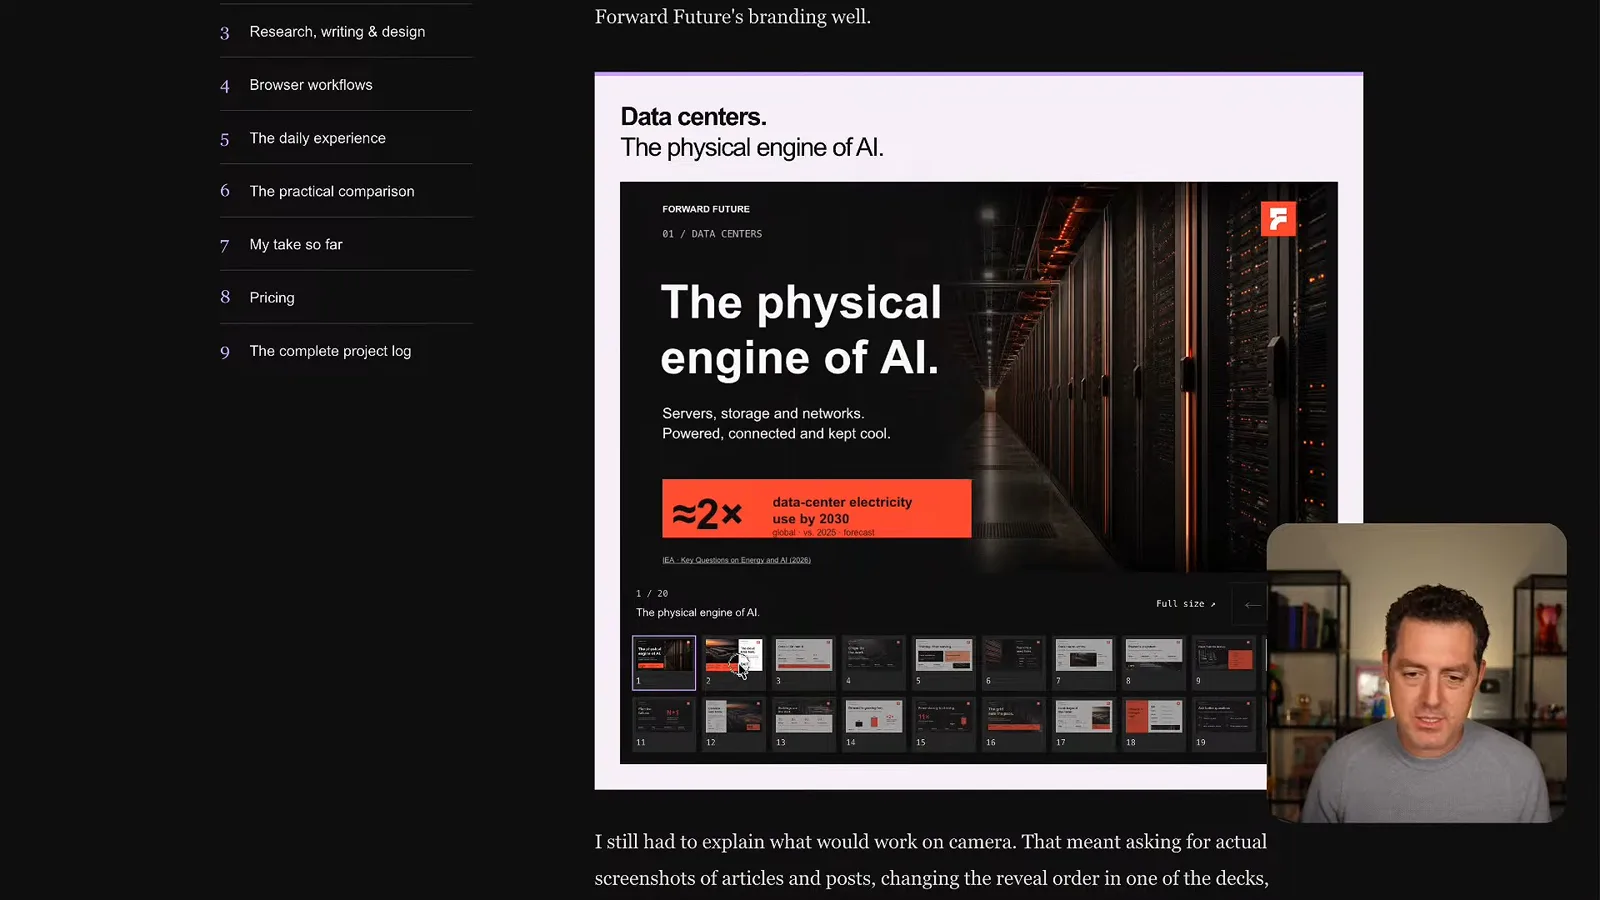
作为知识工作的例子,我让 Astra 用 Forward Future 品牌制作一套数据中心幻灯片。我觉得成果不错,对经常制作演示文稿的人来说很有价值。我不知道城市游戏用了多少 token;几千万只是粗略猜测,并非实测总数。
浏览器控制很重要,因为我希望把预约和网上卖东西等任务交出去。在这些例子中,我要求 Astra 执行任务、编写自己的浏览器录制软件并添加计时器。录像经过剪辑,有些地方会跳过,但计时器显示任务实际经过的时间。
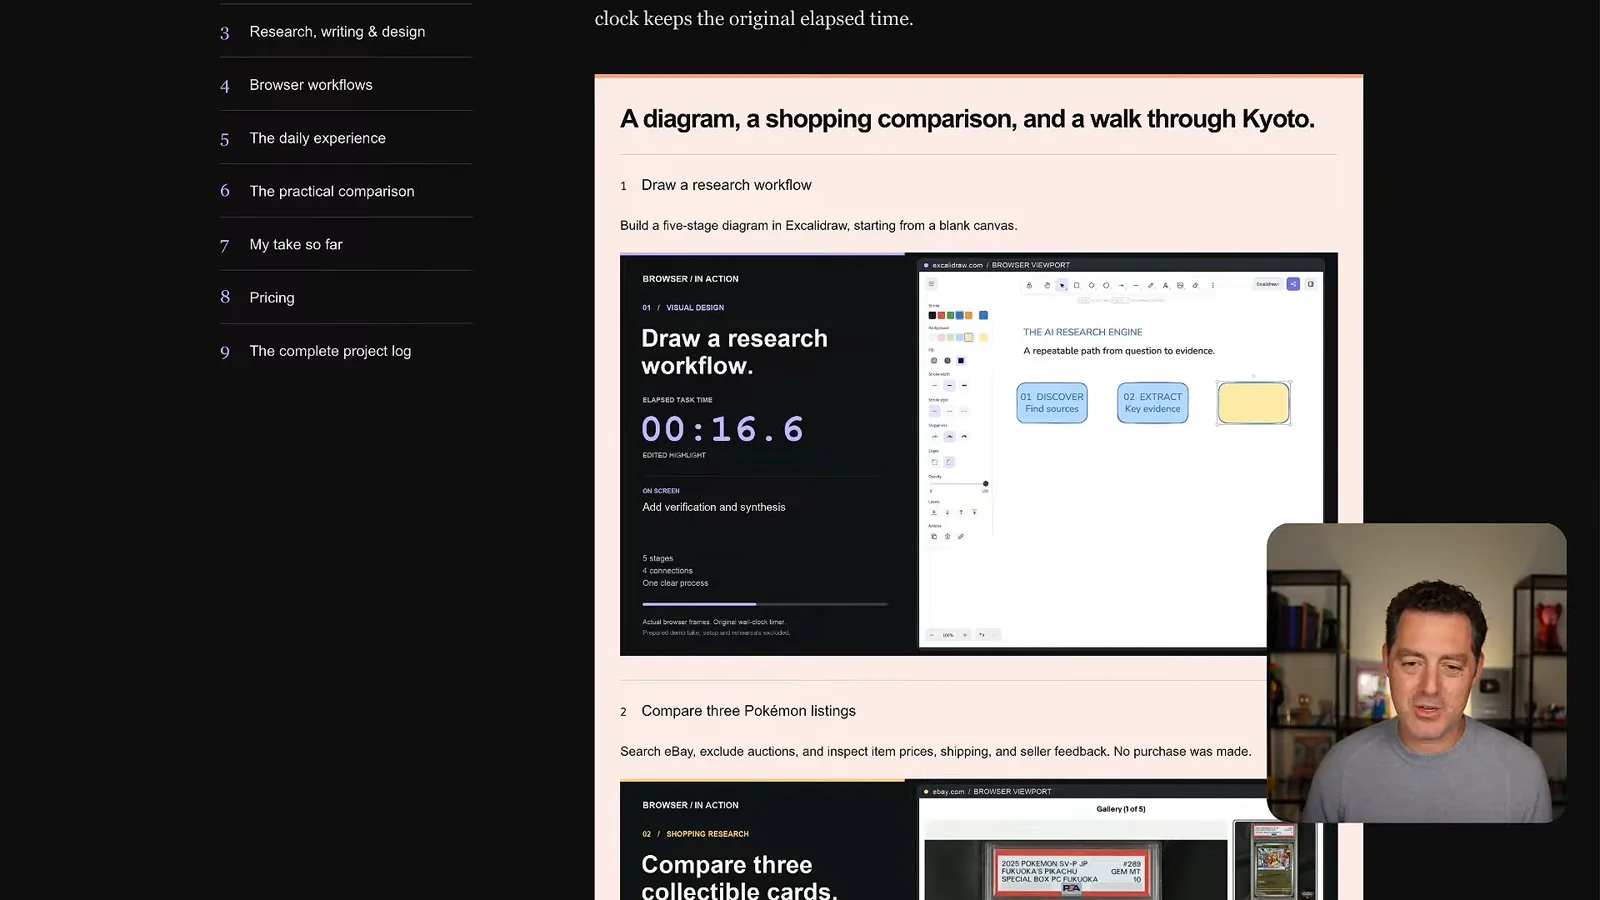
第一段录像在 Excalidraw 中绘制研究工作流。另一段搜索 eBay,比较三个昂贵的 Pokémon 卡牌商品;我说这次比较用了 55 秒。第三段打开 Google Maps,规划一条途经京都多个地点的步行路线。这些是挑选出来的演示,并非系统性的可靠性测试。
更多游戏与设计局限
Berman 讨论重复的默认视觉设计,然后展示魔方、找针游戏、星球、小镇模拟和恐怖场景。这些例子也有肉眼可见的瑕疵。
纵观这些演示,我发现一个反复出现的设计偏好:几个独立项目都使用不同深浅的森林绿和扁平视觉元素,尽管我没有要求这样的配色。文字和设计仍带有一些 AI 味。好消息是,Astra 对提示调整的反应很好,因此明确指导可以带来更多变化。
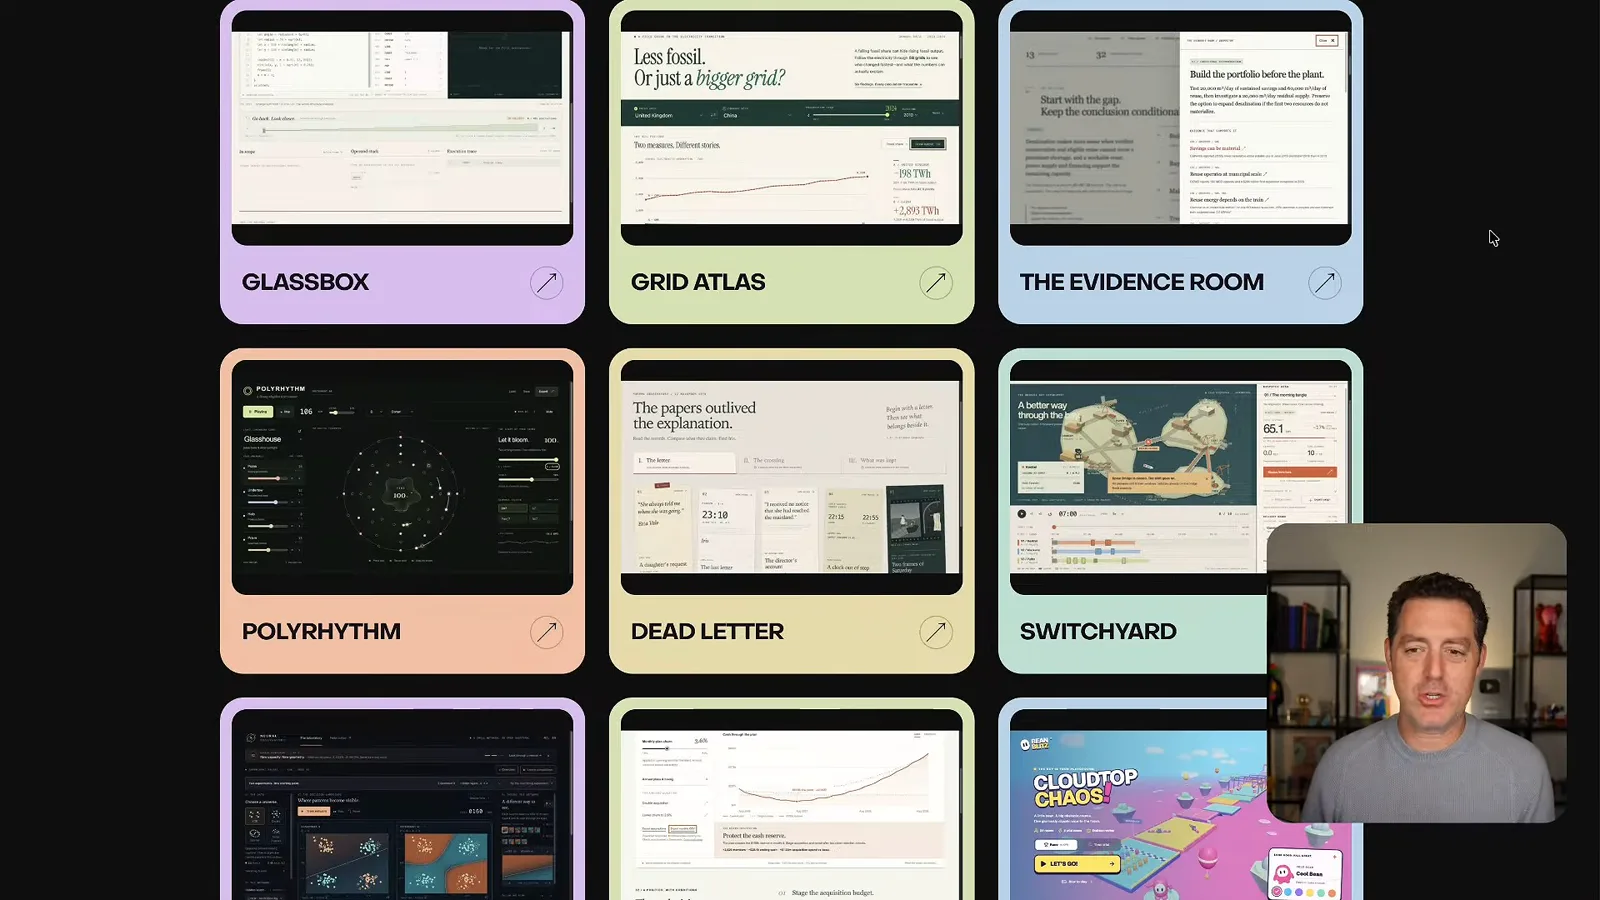
魔方演示能打乱并还原魔方,还提供颜色和氛围控制。我认为它使用的是一种已知求解算法,而不是简单地倒放打乱步骤,不过直播时没有验证。一位观众估计五天的城市项目花了 800 至 1,000 美元,我觉得听起来有可能,但不知道实际成本。
另一个有趣的演示叫 Needle:一个干草堆里有五百万根草和一根针,玩家要逐根查看。我借用了自己看过的视频中的创意,但没能找回创作者的名字。这是一个刻意荒诞的例子,而非实用的生产力应用。
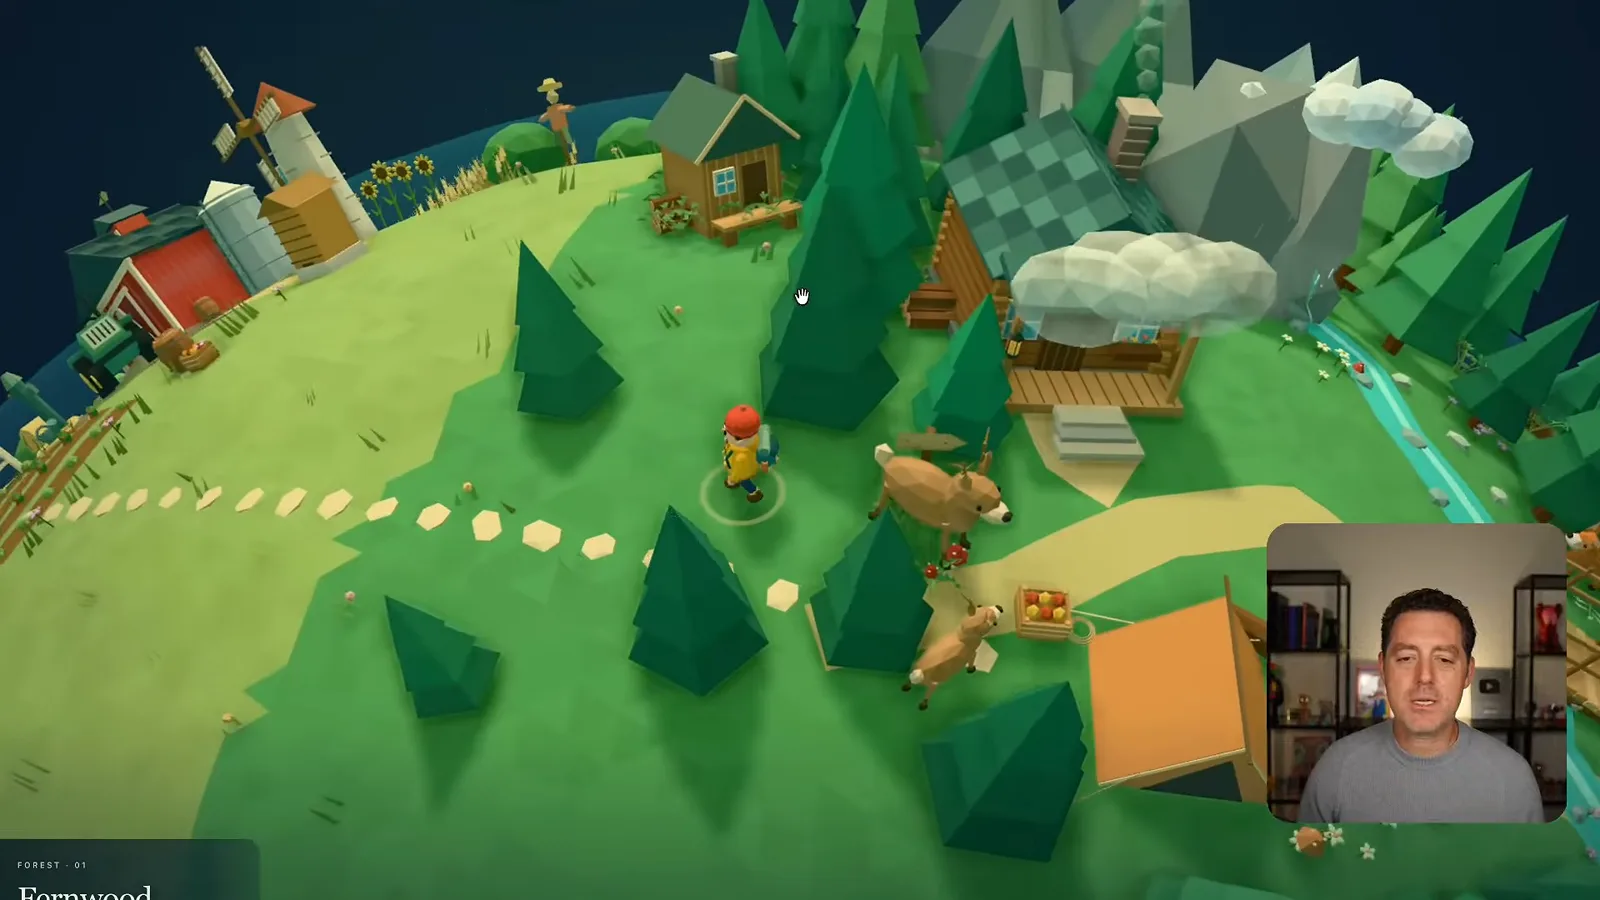
Little Planet 是一个用一条提示词生成的 3D 世界,角色可以在小星球上行走。大多数物体的间距看起来正确,但角色能穿过灌木和一只羊,冰山附近似乎也有小问题。虽然整体场景让我印象深刻,这些局限仍然看得见。
角色进入水中时,行走动画会变成游泳。游戏还有路径点,让角色自动前往火山等地点,到达后可以触发互动。这些细节让成果不只是静态 3D 插画,尽管我没法登上船。
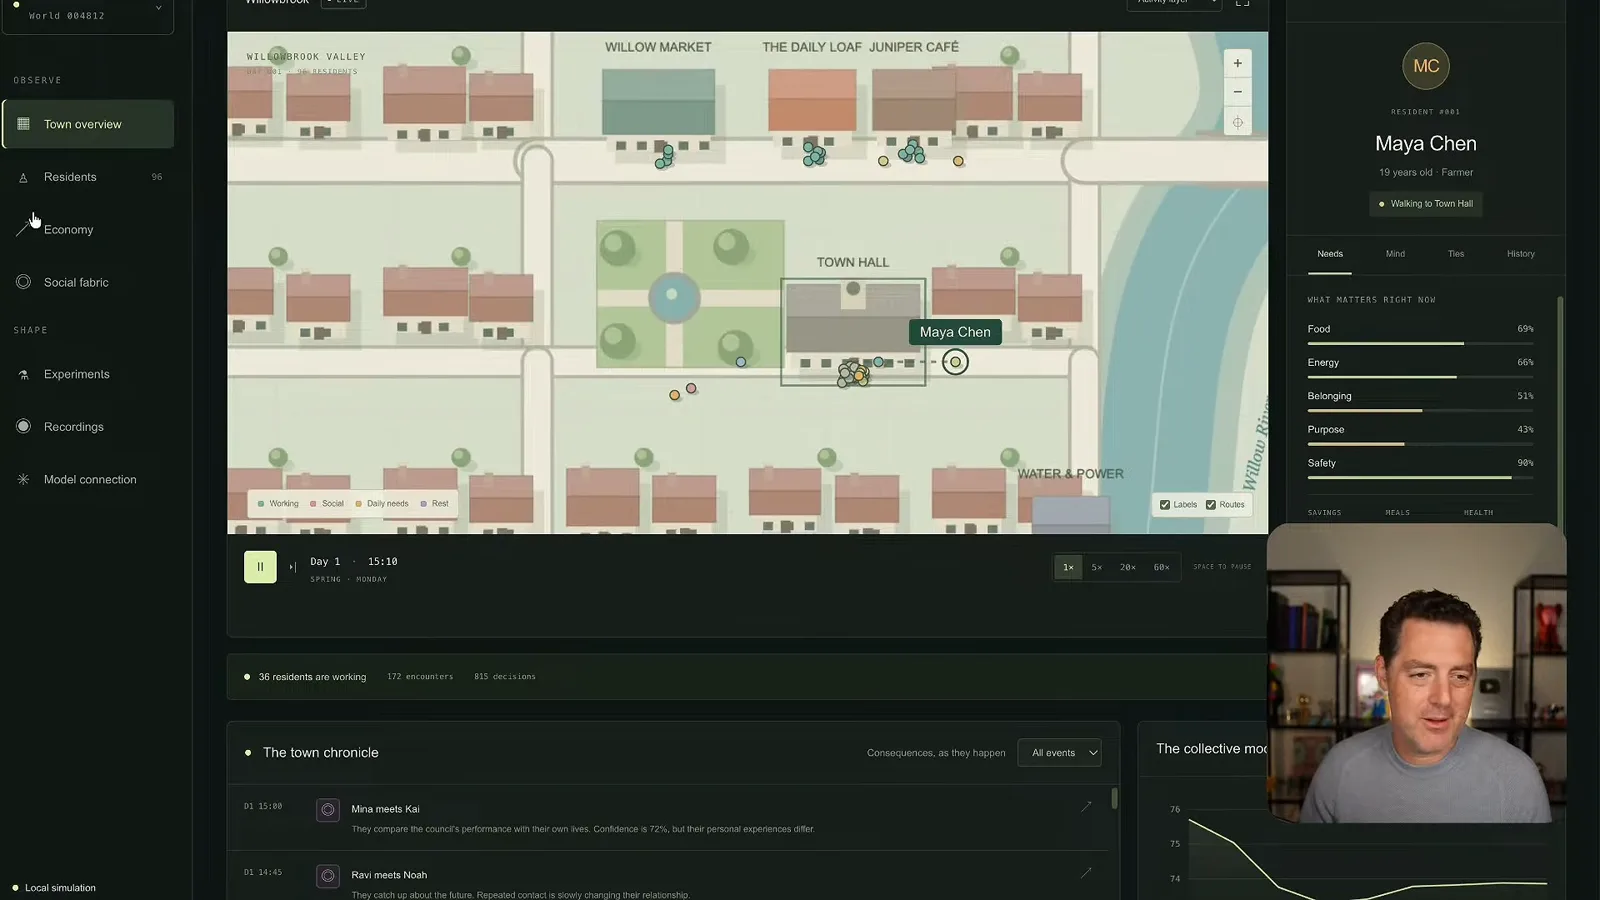
Commons 是一个小镇模拟,包含居民、经济和社会关系。我把它看作模拟小镇活动的可视化。它还提供旱季、零号病人和停电等实验,这些功能并不是我在简单提示词中明确要求的。
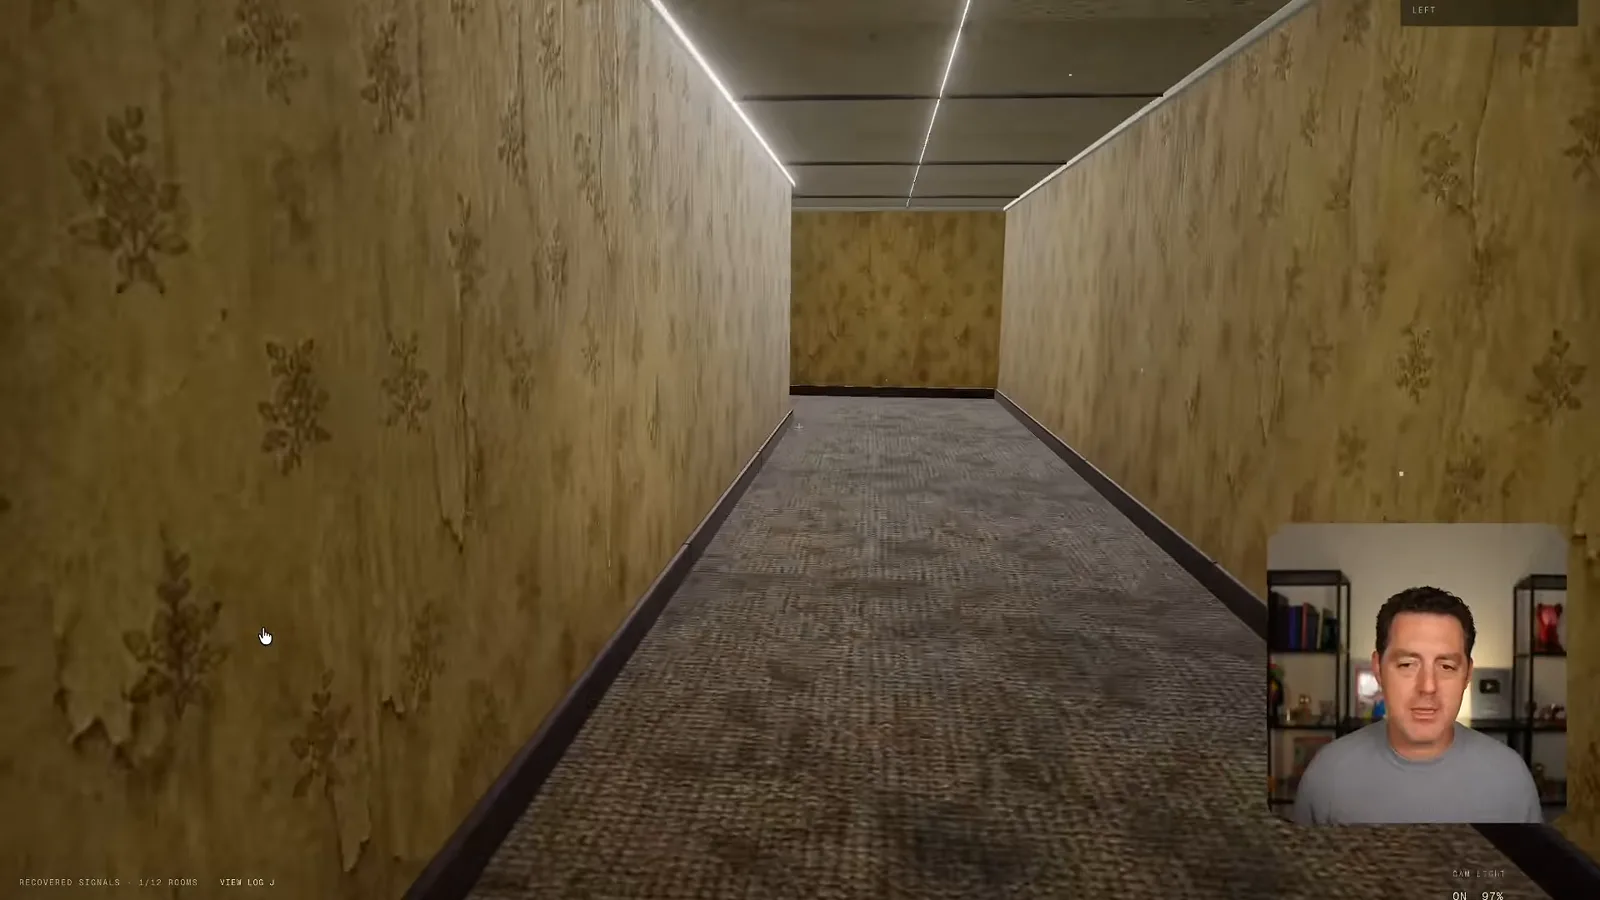
一个 3D 过渡空间恐怖游戏用了几条提示词。我要求真实的环境、隐约出现的敌人和后期的惊吓效果;Astra 生成了素材和纹理。我探索了走廊、育儿室和泳池,但预期中的黑影没有在展示的部分出现。
其他演示与观众提问
他展示更多游戏和网站,并回答有关设计、可维护性、速度及未测试工具的问题。他将估算和预测与已确认的细节区分开来。
其他实验包括一个小型 GTA 风格游戏、一部漫画和写作样本。另一个更大的 GTA 项目运行了几天,但完成起来太慢。我还尝试了洗衣店模拟器;尽管之前见它运行过,直播演示时我没能让互动正常工作。
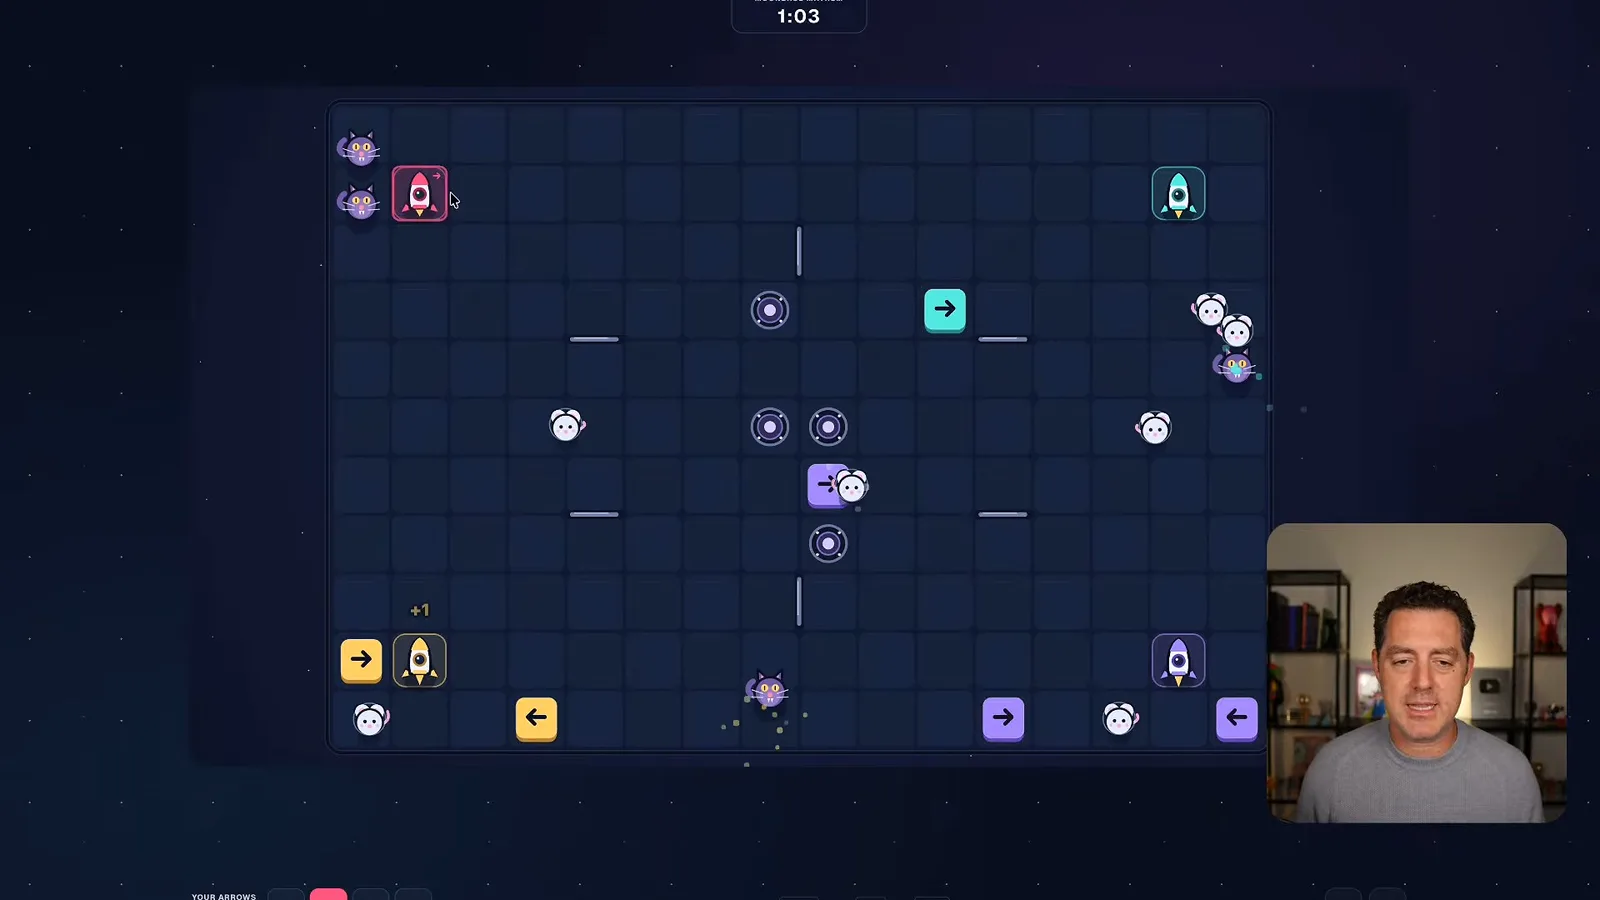
一个受 Choo Choo Rocket 启发的游戏使用箭头引导老鼠进入玩家的火箭,对手则试图改变它们的方向。这个游戏用了几条提示词,我认为它比我用 Fable 5.1 做出的游戏更好。我还展示了手机、苹果园和橡皮鸭的基础网站;它们默认的扁平设计没有那么令人印象深刻。
这些网站例子都是用一条提示词制作的,我预计稍加指导就能改善设计。回到 Cloudtop Chaos,我估计自己总共投入了约四分钟的注意力,模型可能工作了约一小时。这些数字都是估算,之前那条后续提示词也是制作过程的一部分。
谈到图像生成,我没有听到新图像模型得到确认,认为它仍在使用 GPT Image 2。我没有运行观众要求的 FreeCAD 或 OpenCAD 基准;准备其他演示时,一次 Blender 实验让电脑变得很慢。我希望以后测试专门的 3D 工作流。
在前端设计方面,我认为不给指导的初始结果中 Fable 可能略占优势,而 Astra 更容易按要求调整。有人问我是否测试过可维护、可扩展的应用,而不只是单页游戏,我的回答基本是没有。使用更灵活的技术栈进行更长时间的 /goal 运行,会更适合测试这个问题。
对于自己的任务,我更喜欢 Astra 而非 Fable,也认为它按每项完成任务计算的成本更低,但每 token 不一定更便宜。我没有将它与 Hermes 一起使用;维护 OpenClaw 花了不少力气,我不愿再经历一遍设置,因此改用 Grokbot。我计划收集并发布这些演示的提示词。
我觉得 Astra 很快,虽然赶不上最快的模型,而且我还没有测试它的快速模式。我掌握的底层变化确认信息很少。我提出它可能有六万亿至十万亿参数,只是猜测,并非公布的规格。
长时间运行与结语
Berman 介绍如何学习用提示词让任务运行更久,并推测未来可能出现更小的蒸馏模型。他以对 Astra 的初步评价结束。
最初,无论任务难度如何,我的运行往往在约 30 分钟后结束。改进提示词帮助任务运行更久;城市建设的 /goal 会话持续了五天,直到我将它停止,并在直播中重新启动。我不知道如果不停止,它何时才会结束。
我预计之后会出现更小、更便宜的版本,并推测它们可能从 Astra 蒸馏而来。蒸馏是用大型模型的输出训练较小的模型,但任何此类变体的名称和发布情况都只是预测,并非官方公告。我也不知道 GDPval 是否涵盖市场调研工作。
直播时,Astra 只向有限的一批人开放,更大范围的开放仍在进行。根据早期使用,我认为它在游戏生成、知识工作和浏览器控制方面尤其出色,同时基准排名、默认设计选择和长时间运行的成本仍值得仔细审视。随着更多测试,我计划继续展示演示。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。