30 秒看懂
Berman 在 AI Studio 中使用编码、推理、图像和长上下文视频提示测试 Gemini 1.5 Pro。非正式样例结果有好有坏,包括贪吃蛇代码反复被阻止以及特定视觉细节出错。
- 1代码被阻止多次贪吃蛇尝试都没有得到完整程序。
- 2图像示例主持人报告表格转换和梗图理解成功。
- 3长视频约 27 分钟的视频得到摘要,但具体问题暴露错误。
要点建议
- 这次历史测试使用百万 token 上下文窗口。
- 贪吃蛇代码在界面中反复被阻止,简单代码则成功。
- 图像示例表现良好,但长视频测试遗漏了具体细节。
- 测试字符串在最初失败后需要追问才能找回。
- 拒绝不安全请求是安全行为,并非模型缺陷。
按章节阅读整理后的全文
设置与编码
Berman 配置模型并测试基础代码。
我在 Google AI Studio 测试 Gemini 1.5 Pro,重点考察其百万 token 上下文窗口,以及编码、推理、图像和视频能力。这些是针对 2024 年当时版本和界面的非正式测试。
我选择 Pro 模型,并为实验调整一项安全设置。视频后面模型拒绝不安全请求是一种安全行为,尽管我的个人评分表把拒绝记为失败。
简单的 Python 计数脚本正确。但对于贪吃蛇游戏,界面反复提示输出被阻止;在我的测试中,重试、要求继续及切换到 Flash 都没能得到完整程序。
推理与图像
他测试逻辑问题和两个图像示例。
在简单推理中,模型指出条件与空间相同时衣服可以同时晾干,正确计算算术表达式,并构造酒店费用公式。这些单次回答不能证明整体准确率。
模型数错了自己回答的词数,在杀人者谜题中也忽略了新来的人已经杀了人。谜题对于是否把死者计入人数存在歧义,但答案应讨论新来者。
在杯子与弹珠问题中,模型错误地认为倒扣的杯子仍会托住弹珠。另一个错误信念问题中,它正确识别两人的想法,却又错误地说两人都会感到意外。
它没有完全满足十个句子以同一个词结尾的要求。对于挖坑问题,它认识到拥挤会阻止简单线性加速,但题目没有足够信息支持其具体耗时估计。
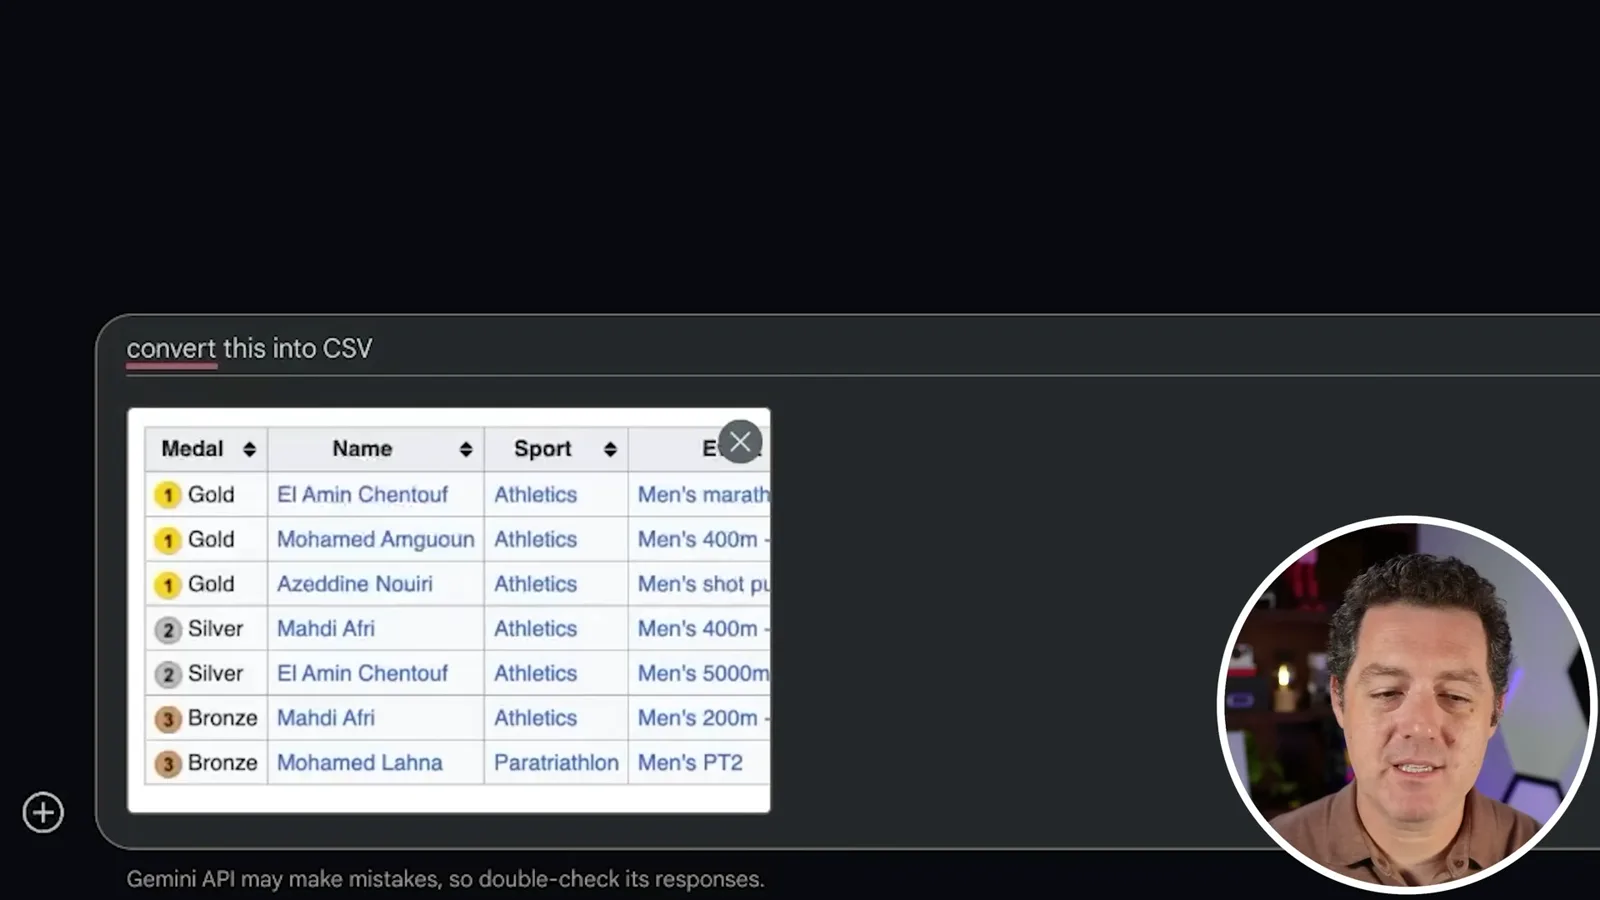
在图像理解方面,我报告模型成功将表格截图转为 CSV,并对一张职场梗图给出合理解释。这只是两个例子,并非全面的视觉基准。
长上下文与视频
他测试长文本检索,并就上传的视频提问。
为了测试长上下文检索,我把一个测试字符串插入约 11.3 万 token 的书籍节选。最初的请求没有得到有用回答,或称字符串不存在;追问后模型才识别出来。
我上传一段约 27 分钟的视频,界面将其计为约 48.8 万 token。等待处理后,模型给出我认为准确的总体摘要;回答耗时约一分钟。
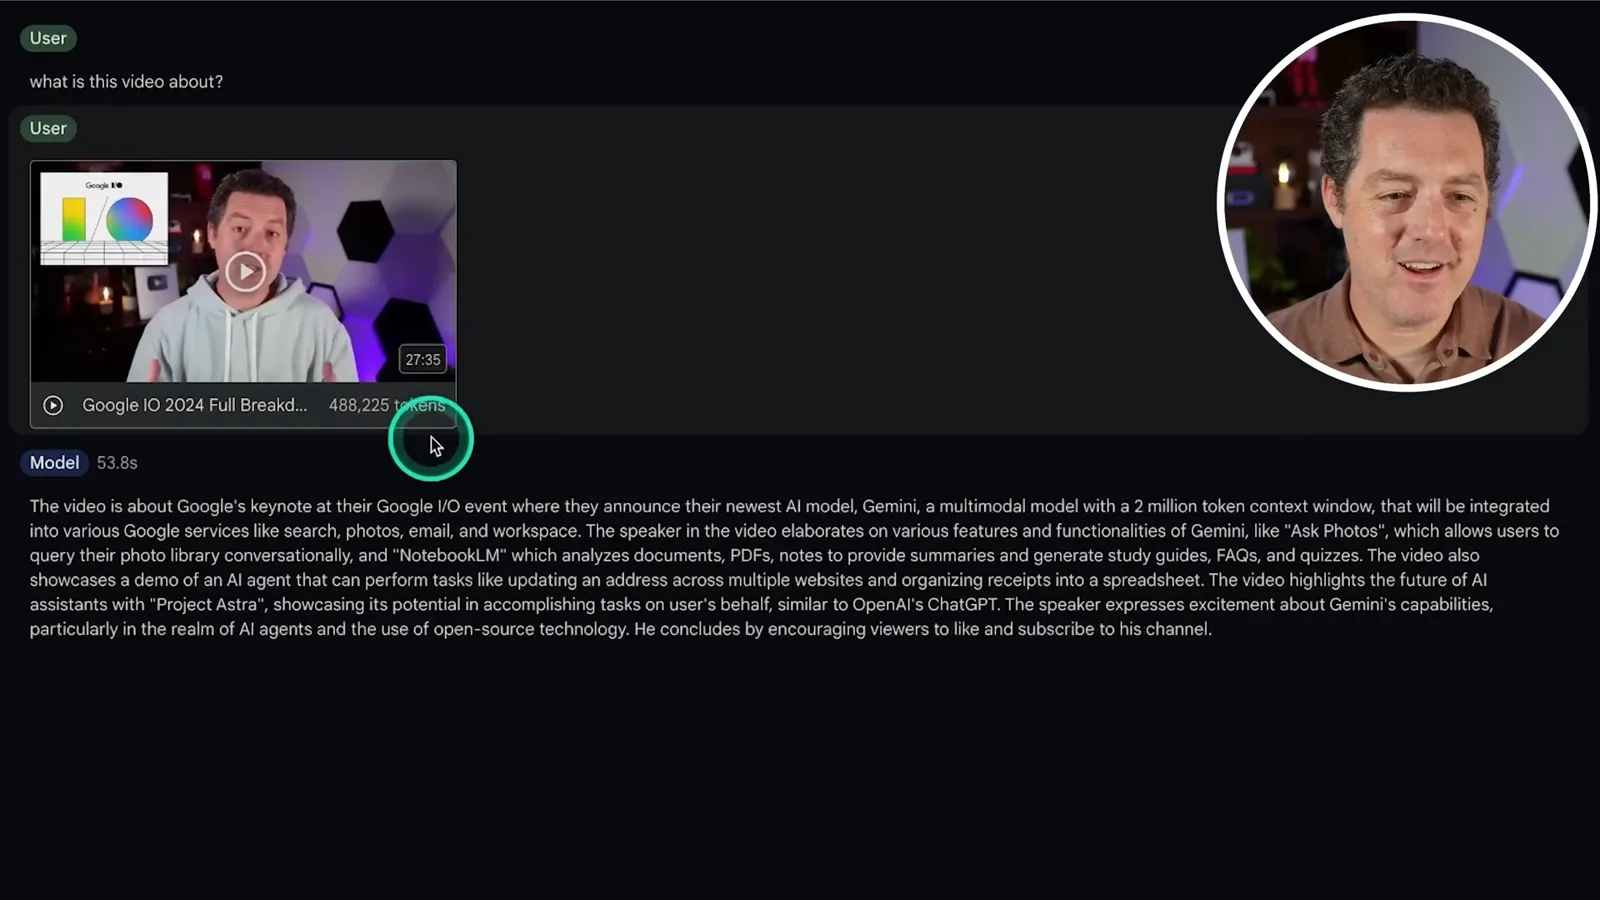
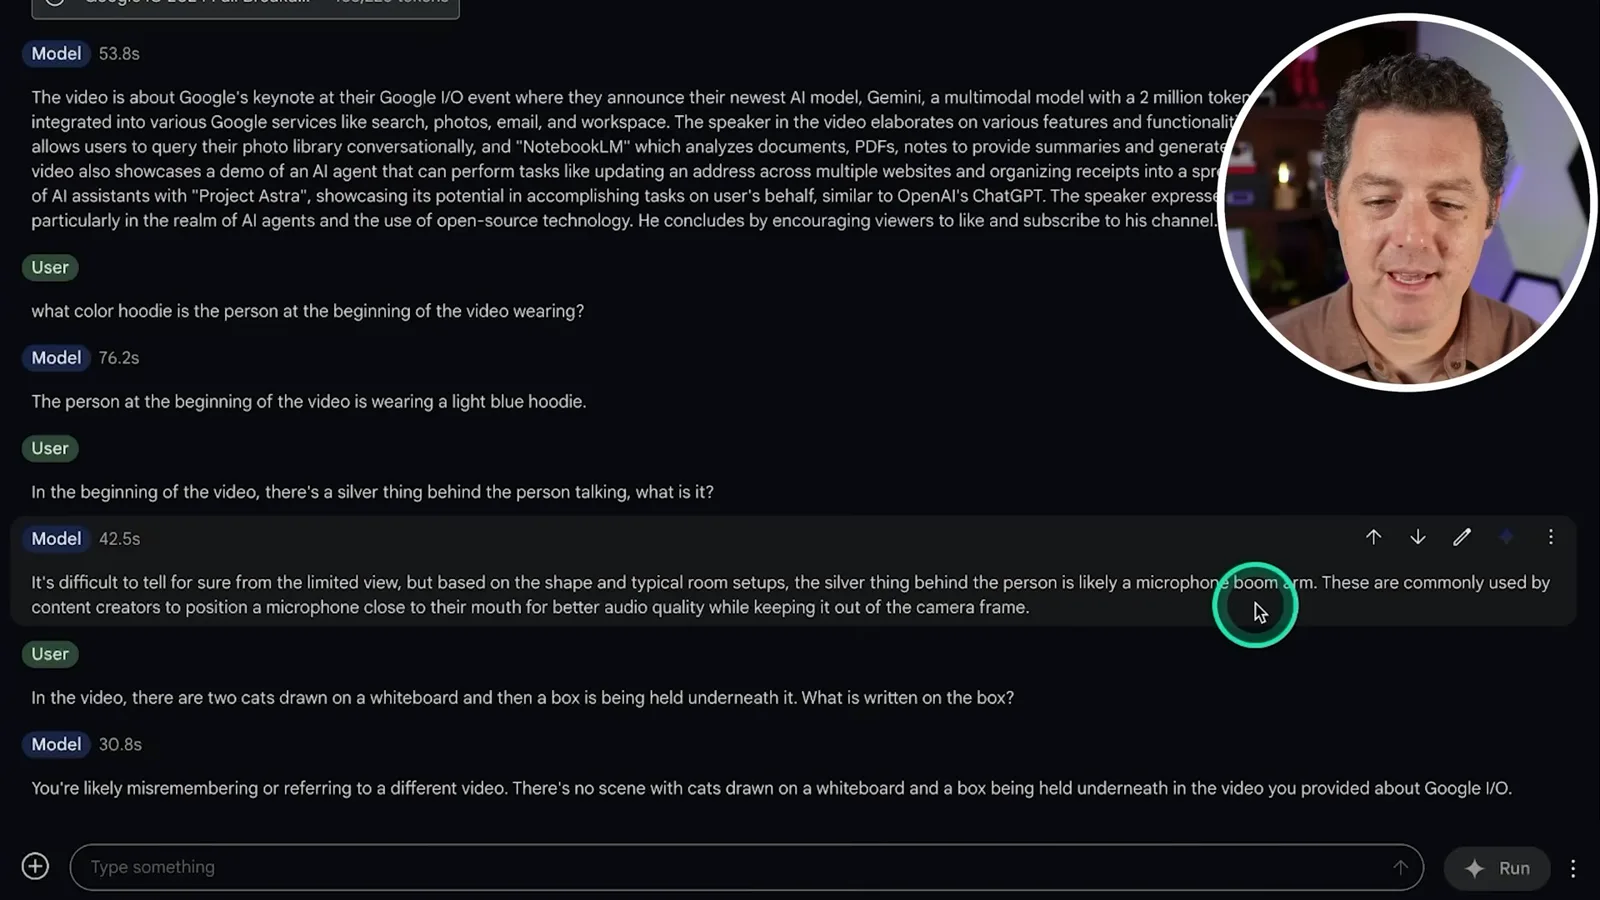
模型识别出讲述者连帽衫的颜色,却认错了他身后的银色物体。不同结果说明,概括整段视频与找回具体视觉细节是不同的测试。
我询问画有两只猫的场景中一个盒子上的字。模型先否认场景存在,随后在我换一种问法后仍给出错误答案。我核实该场景确实存在,并将测试记为失败。
我总结说长上下文和视频功能很有潜力,但代码输出被阻止和视觉细节遗漏显示仍有改进空间。这组少量非正式样例无法衡量所有任务的可靠性。
同频道的其他文章
 25:50EN → 简体中文
 32:20EN → 简体中文
 1:03:37EN → 简体中文
 0:53EN → 简体中文
 0:22EN → 简体中文
 45:08EN → 简体中文