30 秒看懂
Berman 回顾 Pixtral 12B 的发布,并测试图像描述、截图读取、代码生成和视觉定位。他发现了一些有用的结果,也遇到多次失败;测试是非正式的,Vultr 赞助了视频并托管模型。
- 1Pixtral 发布这款 120 亿参数模型结合文本和图像输入,以 Apache 2.0 协议发布。
- 2文本测试失败一个俄罗斯方块程序报错,一道字母计数题也答错。
- 3读取截图模型读出部分存储总量,却误解了下载图标。
- 4更难的页面生成的页面缺少图像,也没有保留原来的横向布局。
- 5视觉定位经过追问,主持人认为模型给出的 Waldo 大致坐标正确。
要点建议
- Pixtral 12B 发布时被介绍为采用 Apache 2.0 协议、支持不同图像尺寸的多模态模型。
- Mistral 报告的基准结果和主持人的示例针对的是特定的 2024 年模型与任务。
- 模型读出了部分手机存储截图内容,但误解了下载图标。
- 生成的代码可以实现简单界面草图,但在更复杂的页面中遗漏重要细节。
- 单个 CAPTCHA 或定位示例不能证明模型在全部此类任务上的表现。
按章节阅读整理后的全文
Pixtral 与测试环境
Berman 介绍 Mistral 的发布和赞助商提供的云 GPU。他查看报告的基准结果,并尝试两个文本任务。
在这段 2024 年 9 月的视频中,我使用由视频赞助商 Vultr 托管的云 GPU 试用 Mistral AI 的视觉语言模型 Pixtral 12B。我回顾发布内容,并运行一组非正式文本和图像提示;赞助关系是理解这次托管演示的相关背景。
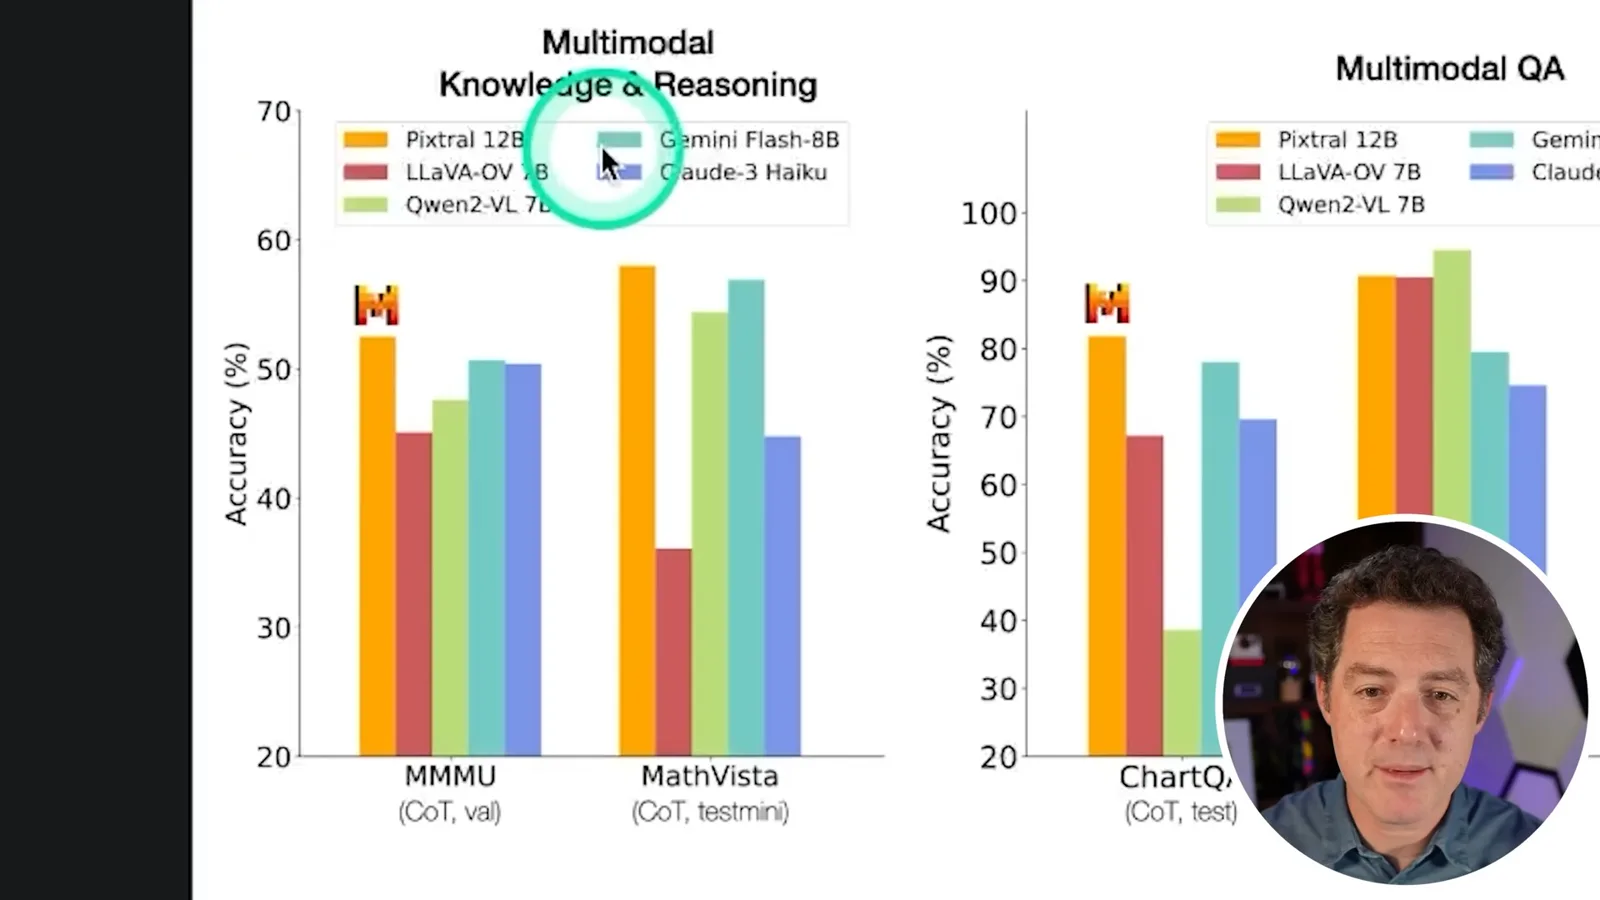
Mistral 将 Pixtral 描述为采用 Apache 2.0 协议发布的 120 亿参数多模态模型,支持不同尺寸的图像以及长上下文中的多张图像。我查看公司提供的与同期模型的基准比较;这些数字只适用于报告的测试和设置。
我通过兼容 API 的后端和 Open WebUI,在一块 48 GB Nvidia L40 上运行模型。这是云端托管测试,而不是普通本地设备上的性能测量。
纯文本提示要求编写 Python 俄罗斯方块游戏,生成的代码出现属性错误。模型还数错了“strawberry”中的字母。这两个孤立的失败不能全面评估它的编码或推理能力。
图像理解
他测试图像描述、截图读取和一张网络迷因。结果既有看似正确的回答,也有图标识别错误。
在图像描述测试中,模型描述了一只在田野中休息的羊驼。据我的测试,它还识别出另一张图片中的公众人物;这是单个例子,不能保证视觉身份识别可靠。
视频包含一次 CAPTCHA 读取测试,我报告说它似乎成功了。单个例子不能证明 CAPTCHA 这一整类挑战都被攻破,也不能证明模型在不同挑战中会有同样表现。
我拿一张手机存储截图询问容量和已用空间,模型读出了显示的总量。随后我问哪个应用尚未下载,它回答错误,没有按我的预期理解云朵图标。
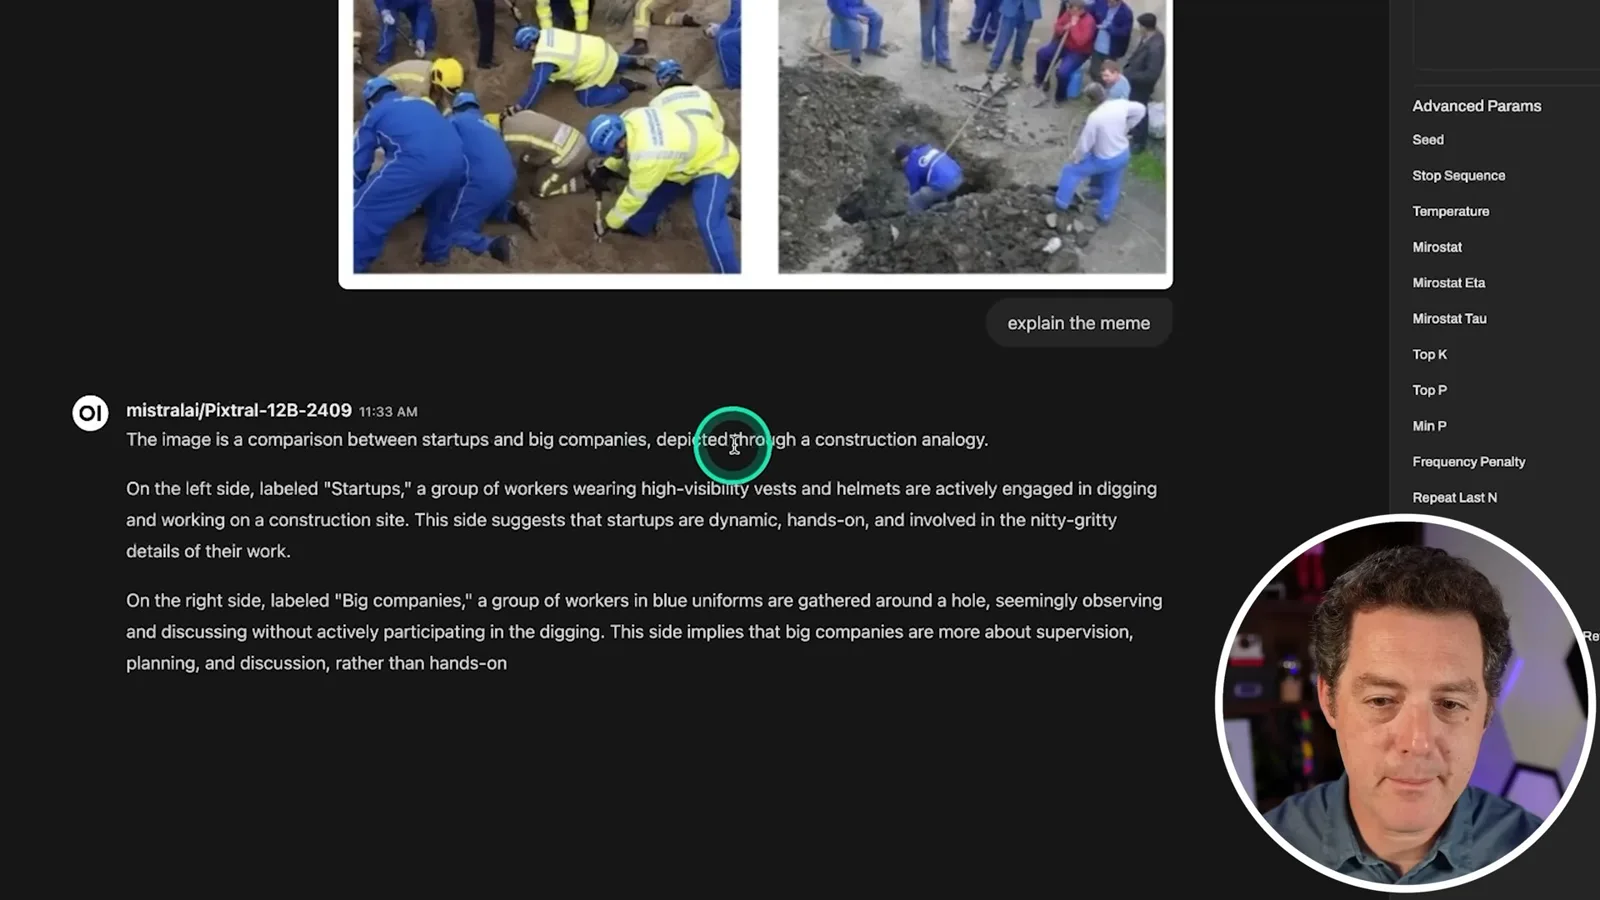
模型列出了截图中的应用和存储用量,随后描述一张对比初创公司和大公司员工的网络迷因。我认为它对视觉笑点的解释说得通;这仍是一个很小且带有主观判断的样本。
我推测,人们可能越来越多地按照能力、成本和延迟,将视觉任务交给一个模型,将推理或编码交给另一个模型。这是我的预测,不是单次模型测试所证明的结果。
表格、界面与定位
他尝试二维码、表格、两个界面草图和一张拥挤的图像。不同示例的结果差异很大。
当我询问二维码指向哪个网址时,模型说它无法从图像中确定目的地。在另一个测试中,它将表格截图转换为 CSV,我认为大体正确。
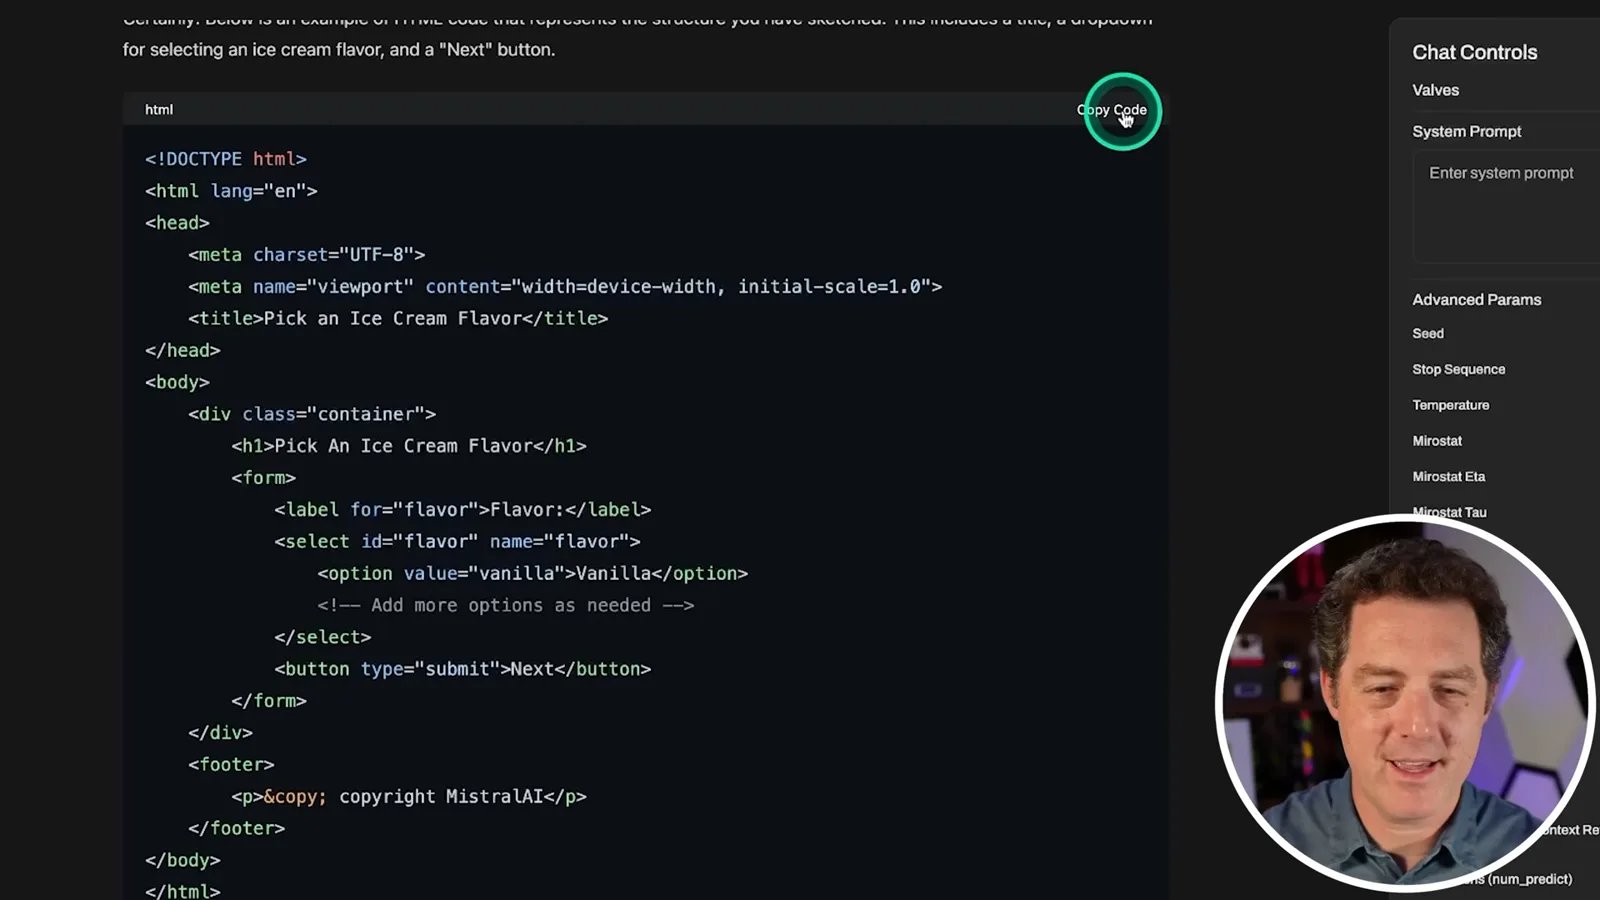
我让 Pixtral 根据手绘界面生成 HTML。生成的简单页面包含下拉菜单和按钮,在我的简短测试中似乎可以运行,但这不能证明代码已经达到生产使用的标准。
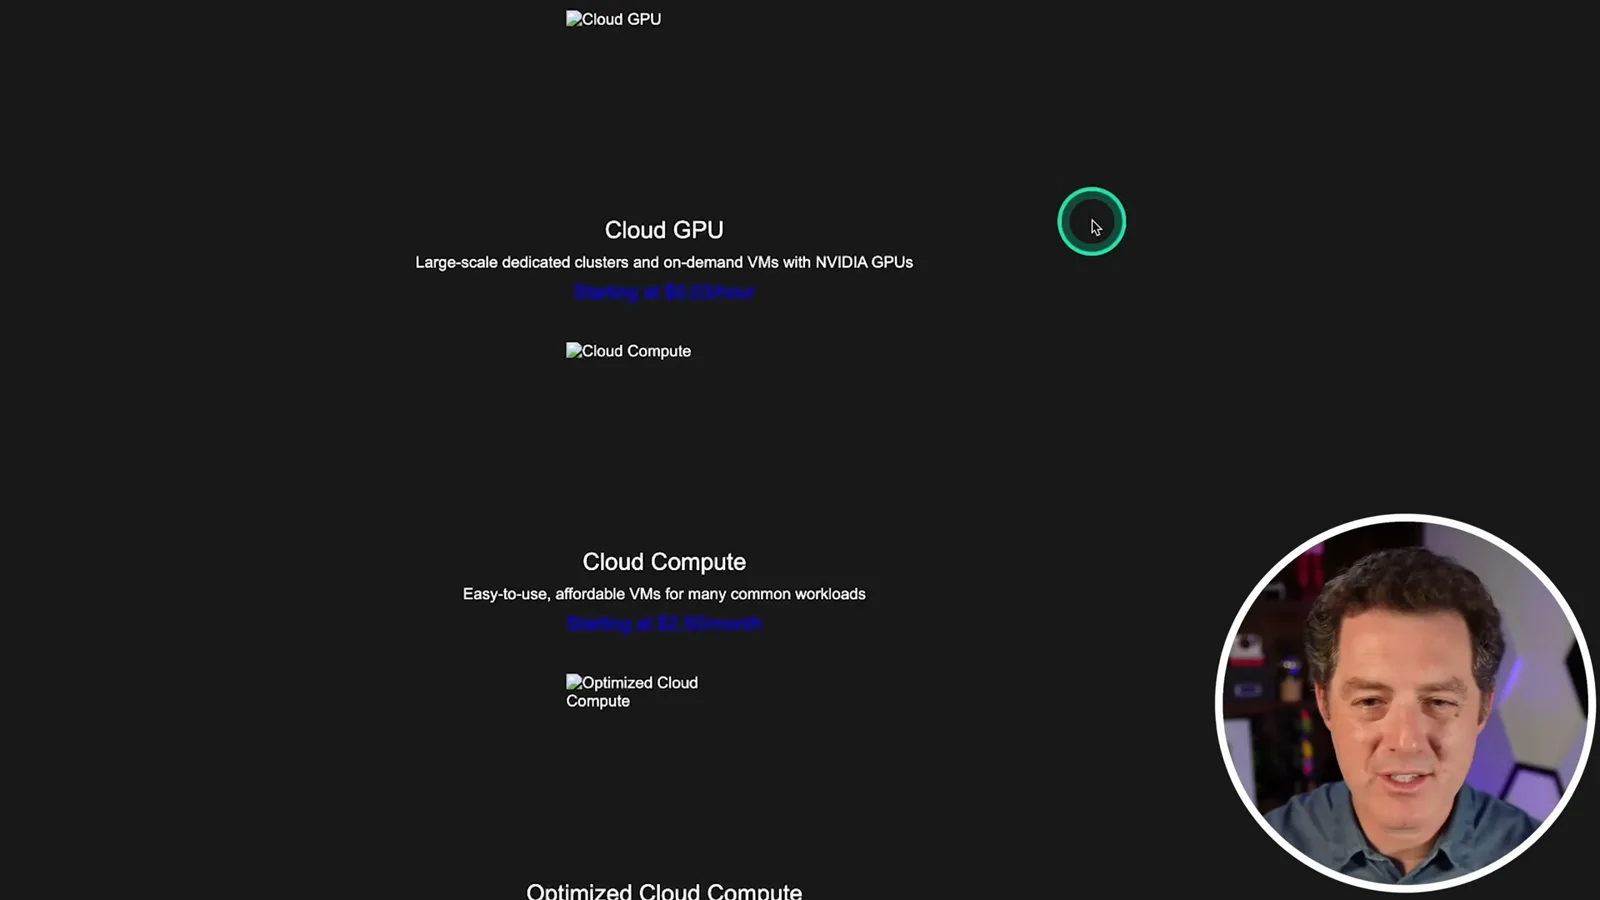
对于更复杂的网站截图,复现效果较弱:生成的页面保留了一些文字,却没有图像,还将项目纵向排列,而不是采用原来的布局。我认为这次尝试只部分成功。
面对一张内容拥挤的《威利在哪里》图像,第一次回答解释了游戏规则,却没有找到人物。经过追问,模型提出了大致坐标;我认为这些坐标指向 Waldo,但单张低分辨率示例并不是可靠的定位基准。
我的结论是,Pixtral 的视觉能力很有前景,但也要看到文本和界面生成任务中的失败。这些结果是个别观察,针对的是视频中展示的 2024 年模型版本、提示和部署方式。
同频道的其他文章
 25:50EN → 简体中文
 32:20EN → 简体中文
 1:03:37EN → 简体中文
 0:53EN → 简体中文
 0:22EN → 简体中文
 45:08EN → 简体中文