30 秒看懂
Every 的提前体验团队发现,Astra 6.2 提供的编辑反馈不如前代实用:它常常直接给出替换文案,并把句子压缩得难以理解。在团队的高级工程师基准测试中,它与 Astra 6 得分相同,但测试者说端到端构建有时过早停止。设计默认风格精致却重复;不过,一个生成的小镇展示了把二维图像投射到 3D 场景上增加细节的意外做法。讲者将这些作为团队的实际测试结果,并明确表示对模型谨慎原因的解释是推测。
- 1简洁文字可能丢失含义讲者说,更新后的模型把一些段落压缩得过于简短,导致句子之间的联系难以理解。
- 2替换文案取代了要求提供的编辑意见对同一篇文章的反馈比较显示,Astra 6 先给评论,6.2 则先给替换文案。
- 3基准分数相同,编程体验却不完全相同团队报告其高级工程师测试得分约为 39,但发现一些端到端工作过早停止。
- 4设计默认风格不错,但结果重复在指引较少的设计任务中,讲者看到的变化少于一个竞争模型。
- 5模型小镇结合了 3D 几何与投射的二维细节讲者把可缩放小镇作为例子,展示额外提示后出现的一种意外做法。
要点建议
- 当模型直接给出替换文案而不是编辑分析时,可以明确要求它提供更深入的意见。
- Every 的高级工程师测试中,Astra 6.2 得分约为 39,与 Astra 6 相同;测试者仍发现一些完整构建过早停止。
- 团队看到视觉输出变化有限,但也发现模型在 3D 场景中有创造性地使用了二维图像投射。
按章节阅读整理后的全文
团队提前体验的评价
Every 用真实工作测试了模型,报告结果有好有坏。
Every 团队用真实的编程、写作、设计和知识工作任务测试 Astra 6.2。讲者说,测试者总体上都没有偏爱它:写作有所退步,设计缺少变化,一些编程项目过早停止。
Every 从 OpenAI 和其他模型开发商获得提前体验和免费 token,用于这些测试。讲者说,团队的评价保持独立。
编辑反馈为何没有达到预期
一项比较展示了直接给出文案与提供深入评论之间的取舍。
讲者更喜欢 Gemini Argon 和 Hydrogen 的叙事及详细论证能力,通常则欣赏 OpenAI 模型清晰简洁的文字。在这次测试中,Astra 6.2 的简洁有时牺牲了含义和可读性。
在一项编辑测试中,团队要求模型审阅 Laura Entis 一篇关于 token 用量的文章标题和开头。旧版 Astra 先给出评论,6.2 则先给出替换文案,把意见放在次要位置。
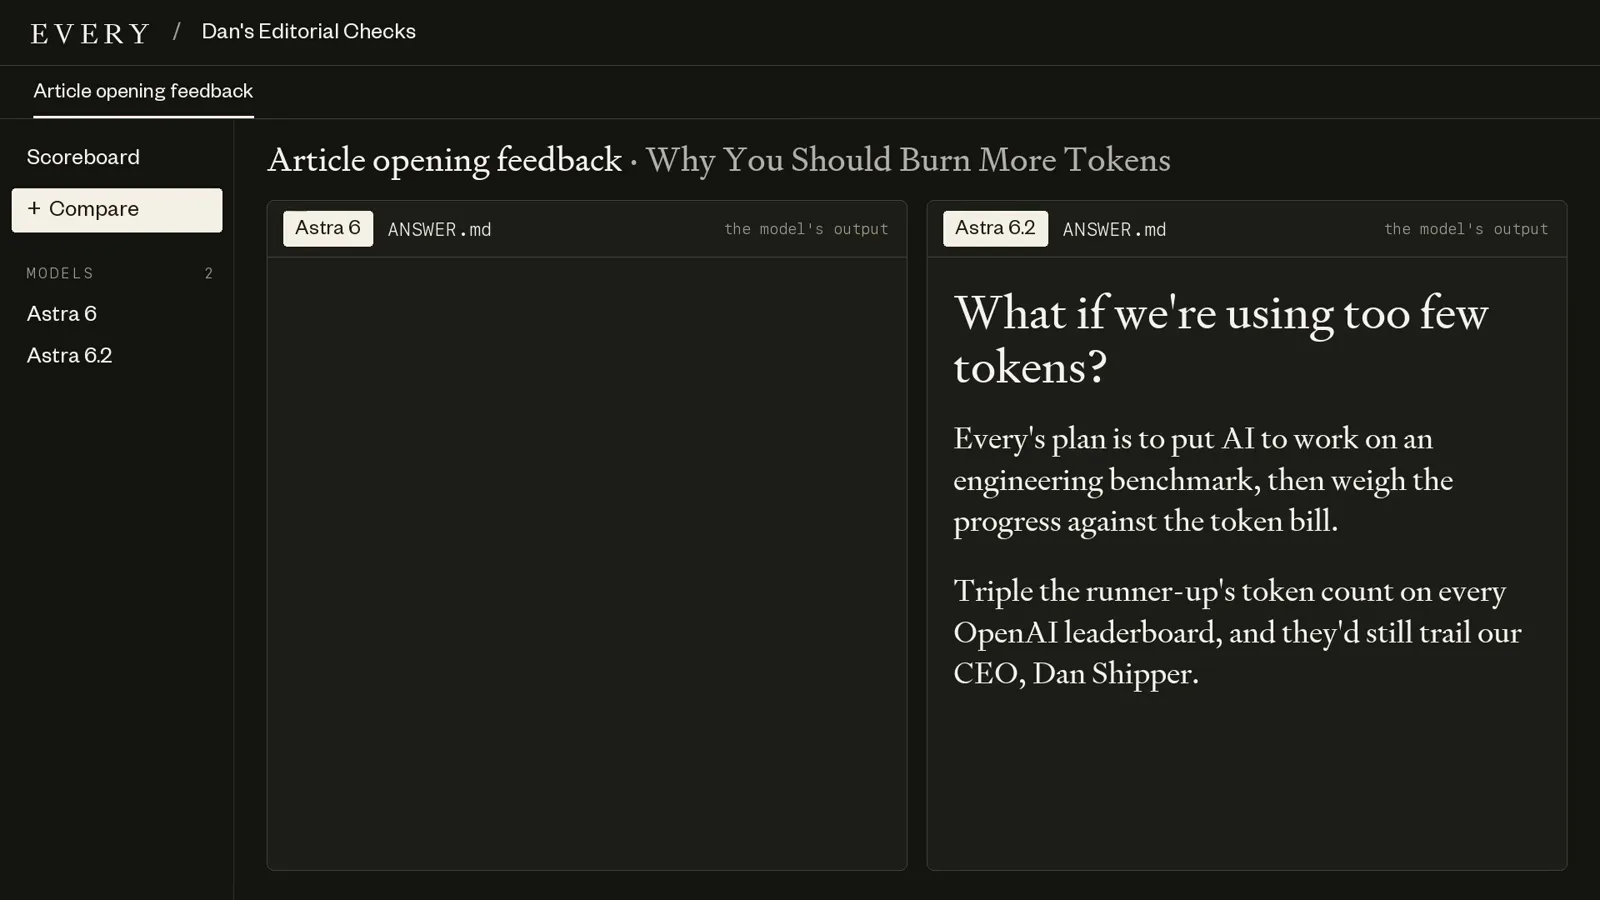
提示词确实要求提供建议文案,但主要要求的是反馈。讲者理解优先给出可执行结果的做法,却更喜欢 Astra 6 提出的标题,并认为 6.2 的一个句子过于压缩,难以理解。
编程分数与未完成的构建
团队将基准测试结果与实际开发体验进行比较。
在 Every 的高级工程师基准测试中,Astra 6.2 得分约为 39,与 Astra 6 相同,略低于得分 40 至 41 的几个其他模型。这是该团队自己的测试结果。
在初级工程师任务中,它会检查待办事项是否已经完成,并做了充分研究。但团队认为 Fable 的代码更容易合并、也更可信,并说 Astra 6.2 在端到端构建中经常提前停止。
讲者猜测,模型更谨慎可能与 OpenAI 在安全和对齐方面的工作有关。这只是推测;讲者预计,原本喜欢用 Astra 编程的人仍可能喜欢这次更新。
设计变化和 3D 实验
模型的默认设计重复,但生成了有创意的投射图像场景。
设计师 Tyler Nishida 用较少设计指引测试模型,观察默认风格和输出差异。讲者说,Astra 6.2 的默认结果不错但外观相似,Fable 5.2 则更有变化。
在团队的千年隼 3D 测试中,6.2 是他们迄今测试过的 OpenAI 模型中最强的,但不是所有模型中最强的。团队说,它的结果包含了早期 OpenAI 模型经常遗漏的细节。
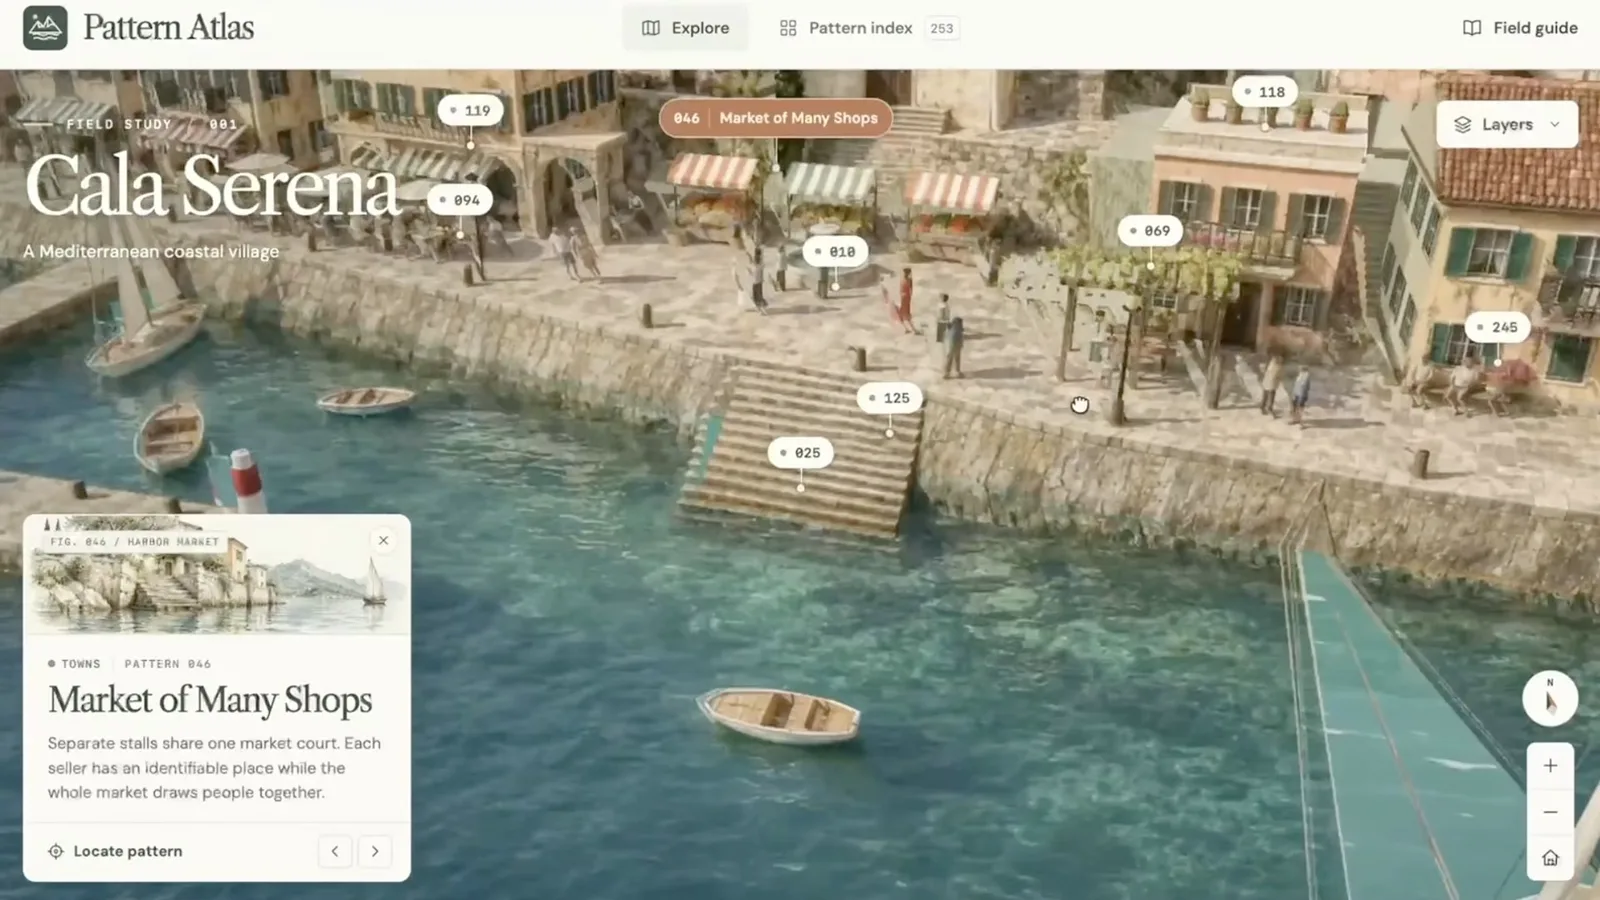
高级编辑 Jack Cheng 测试了一个可缩放的模型小镇。讲者说,模型把生成的二维图像投射到 3D 场景上以增加表观细节;改变视角后就能看出这种做法。
过度追求简洁的局限
讲者认为实用性需要兼顾清晰度和创造力。
讲者总结说,如果过度优化简洁和实用,可能损害清晰度或创造力。他们认为模型仍有潜力,但需要更多提示才能发挥出来。
同频道的其他文章
 31:06EN → 简体中文
 Every· 2026年11月16日播客 · 3 人对谈推广 AI,要从专家难以说清的工作入手嘉宾 Hugh Wimberly, Jeremy Hadfield · 主持 Willie WilliamsHugh Wimberly 和 Jeremy Hadfield 谈如何观察真实工作流、衡量错误,以及让早期使用者展示 AI 的能力。
 31:31EN → 简体中文Every· 2026年11月13日播客 · 5 人对谈Nursa 向每位员工提供 AI 开发工具:首批原型变成了实际产品嘉宾 Lauren Rhode, Curtis Anderson · 主持 Brian Dell这家护理人员排班公司表示节省了成本并开发出新应用,同时管理者也在应对治理、质量和阻力。
 26:47EN → 简体中文Every· 2026年11月11日播客 · 2 人对谈Dan Shipper:AI 让生成想法变便宜,人仍要选择什么重要主持 Natalia QuinteroEvery 联合创始人通过一份客户调查,解释不同视角如何借助同一模型产生不同成果。
 16:57EN → 简体中文Every· 2026年11月9日播客Fable 5.2 擅长大型创作,但 token 成本不容忽视Every 的提前测试显示,它在编码和创作任务上表现突出;一次纪录片制作消耗了 14 亿个 token。
 46:14EN → 简体中文Every· 2026年11月4日播客 · 2 人对谈Kevin Roose:记录 AI 历史,以及决定把什么交给 AI嘉宾 Kevin Roose · 主持 Natalia Quintero这位记者谈论《The AGI Chronicles》、采访高度保密的行业、AI 辅助研究,以及“举重与叉车”的区分。
 50:51EN → 简体中文Every· 2026年10月29日播客 · 3 人对谈Fred Graver:把 AI 当作编剧室,而不是代笔人嘉宾 Fred Graver · 主持 Dan Shipper, Natalia Quintero编剧兼制片人介绍如何发展想法并利用 AI 反馈。