30 秒看懂
Dan Shipper 认为,随着 AI 模型广泛普及,其默认答案会成为共同的基础水平。真正的区别在于人的职责与视角:提出什么问题、注意到什么,以及选择采取什么行动。在 Every,同一份客户调查让 Shipper 和同事借助相同的 AI 工具发现不同机会、做出不同成果。他还介绍了一项内部实验:生成可能的答案,比把他实际会选的答案排到前面更容易。
- 1一个人在一周内用智能体承担多个角色的工作Shipper 在处理其他工作的同时,分析了一份调查、制作游戏并构建客户管理工具。
- 2同一份调查让同事采取不同的行动Shipper 看到了团队销售机会;Yash 关注订阅用户流失,Douglas 则注意到读者的孤独感。
- 3生成可能的答案比给它排序更容易Shipper 说,在一项内部实验中,他的 Slack 回答出现在 400 个候选答案中的频率,高于它排进前十分之一的频率。
- 4未来的工作人员也会使用未来的模型Shipper 反对只把能力更强的未来模型与能力停留在今天的人比较。
- 5衡量模型是否帮助使用者完成自己的工作他建议除了通用基准任务,也按照个人目标和视角评估模型表现。
要点建议
- 思考 AI 输出如何服务于具体职责,不要停留在泛泛的总结。
- 让不同岗位的人审视同一份信息;他们可能发现不同机会并采取行动。
- 把生成候选答案与排序、选择值得推进的答案分开看待。
- Shipper 认为,比较时应考虑人也会使用更新的工具,而不是把人的能力固定在今天。
- 除了通用基准,也要根据使用者的工作和视角评估模型。
按章节阅读整理后的全文
从总体曲线走近真实工作
Shipper 对比了基准测试趋势与对真实案例的观察。他介绍了自己如何在忙碌的一周里用智能体分析调查并构建工具。
Every 的会议提出了一个问题:自动化之后,出色的人类工作会是什么样?Natalia Quintero 在介绍闭幕演讲时说,Every 联合创始人 Dan Shipper 借助 Claude 订阅分析了一份客户调查,构建了一个简单的客户管理工具和一款游戏,并联系了客户。
Quintero 说,这些工作过去可能需要几位不同领域的专业人员;但如果只向模型笼统地询问调查结果,得到的输出可能与其他人差不多。她由此引出 Shipper 的观点:人带给模型的视角会让工作产生独特之处。
Shipper 对比了两种思考未来的方式。总体视角收集大量观察结果并推演趋势;近距离视角则仔细研究一个具体情境,包括其中错综复杂的细节,再由此向外推理。他说,前一种方法很有力量,但任何一种视角单独使用都无法呈现全部情况。
作为总体视角的例子,他提到模型能力与训练所用数据、算力之间的关系。他还引用 OpenAI 的 GDPval 基准测试:专家比较模型和人在真实工作任务中给出的结果。
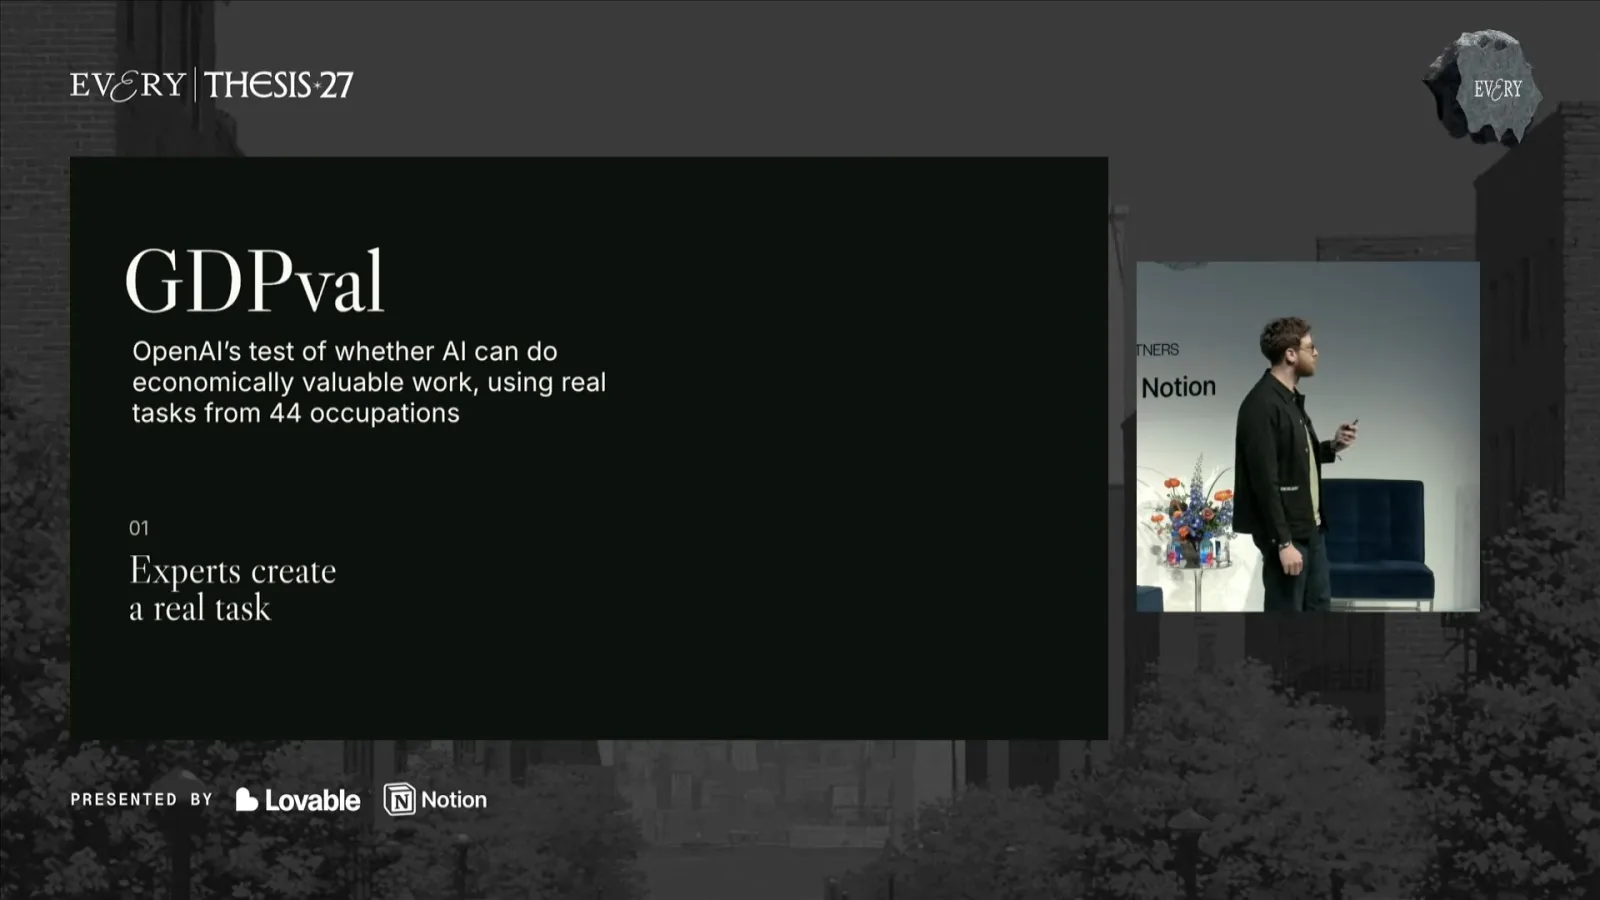
Shipper 展示了 2024 年至 2026 年的基准测试数据,说明模型进步迅速。他说,如果只看这些结果,人类工作的未来可能显得不容乐观。这项测试比较的是模型输出与没有使用 AI 的人完成的工作。
在他自己的一周中,Shipper 用智能体围绕季度客户调查提出许多问题,为全员会议制作游戏,并构建客户关系管理工具开展联系。他说,按过去的方式,这些工作会涉及数据科学家、游戏开发者、营销人员、工程师和业务拓展人员。
他把看到模型完成自己熟悉的工作所带来的感受称为“能动性断裂”:人们常通过自己的工作认识自己,而自动化可能动摇这种自我认知。在他看来,要了解总体图表遗漏了什么,就需要仔细观察真实的人如何使用这些工具。
Shipper 说,这种工作方式——一个人在其他职责之间指挥智能体——对许多与会者已经很熟悉。几年前,有人认为语言模型不太可能取得多大进步,也有人预测工作岗位几乎会立刻消失。
2022 年使用 GPT-3 时,Shipper 曾预测,改进后的 AI 或许能让一个人产生相当于大型组织的影响。他现在把自己的工作看作一个例子,并追问这对团队的价值意味着什么。
团队从同一份调查中发现什么
几个人使用相同的数据和模型,却选择推进不同的发现。Shipper 认为,他们的岗位与视角帮助决定了他们会选择什么。
他说,尽管智能体能够完成不少工作,Every 仍有约 30 名员工。为了解释原因,他回到同一份客户调查:团队每个人都可以查看数据并用 AI 分析,但他们选择的问题和结果并不相同。
Shipper 发现了向团队销售 Every 产品的机会,并为客户联系构建了自己的工具。专注订阅增长的市场拓展工程师 Yash 则发现,一些首次订阅者在第一个月后流失,因为他们收到的邮件太多。
负责营销并组织这次会议的 Douglas 发现了另一种情况:一些读者使用 AI 时感到孤独,因为身边的人并不分享他们的热情。高级编辑 Jack 则制作了一档黏土动画游戏节目,来呈现调查结果。
每个人面对相同的数据,也都能使用 Claude,却强调了不同的事情。以默认方式向模型提问,得到的观察包括写作内容和组合服务的价值;Shipper 认为这些发现确实存在,但团队里没有人只是提交那份泛泛的回答。
团队在筹备会议期间完成了这些分析。Shipper 说,Yash 不仅找到了一个增长问题,还提出了代码修改,同时帮助构建活动的直播体验。工具让个人能在有限时间内探索更多想法并付诸行动。
生成候选答案比从中选择更容易
一项内部实验考察模型能否预测并排列 Shipper 的 Slack 回答。他用这个例子解释自己看到的人类判断的价值。
模型本身能否提出团队发现的想法?Shipper 说,它可以生成许多候选答案,但选出有用的答案更难。Every 的评测负责人 Mike Taylor 测试了 Claude 能否预测 Shipper 会在 Slack 上说什么。
Shipper 说,在实验中,当模型可以提供 400 个候选答案时,约有 93% 的情况下会包含他的回答。但让模型给候选答案排序时,他的回答约有 60% 的时候排在前十分之一。他用这个结果区分成本较低的生成与更困难的选择。
团队成员负责业务的特定部分,对那里什么重要也有自己的看法。这些条件缩小了他们寻找的范围,帮助他们决定哪些输出值得关注、由谁负责并采取行动。因此,不同的人可以探索同一组可能性中的不同部分。
比较不断变化的人和模型
Shipper 预计模型会进步,但人也会积累经验并使用改进后的模型。他认为默认输出会成为共同的基础水平。
Shipper 预计模型的排序能力也会提高。但他认为,把未来的模型与能力固定在今天的人相比会产生误导:到了未来,人也会积累更多经验,并能使用更新的模型。
他把使用未来模型的未来团队成员,与对同一模型提出的默认请求进行比较。他说,既然双方都能使用这个工具,区别就在于人的职责和视角:选择研究什么、如何引导模型,以及对哪个结果采取行动。
Shipper 预计,随着模型广泛普及,其默认能力会提高所有人的基础水平。一个不寻常的发现日后可能也会成为基础水平的一部分,但持续使用改进模型的人也可以在此基础上继续推进。他认为,人们引导这些共同能力的方式有价值。
把智能资源分配到重要的工作上
他的“分配经济”强调引导资源并确保工作完成得好。他建议既根据个人工作,也根据通用任务评估模型。
这引出了他所说的“分配经济”。在 2024 年的一篇文章中,他提出,人们将越来越多地依据自己如何把智能和其他资源分配给任务、并确保工作完成得好来接受评价,而不只是看自己知道多少。
Shipper 建议,除了测试数学或编程等公认的问题,也要从个人视角测试模型完成其工作的能力。他认为,一旦某种能力变得广泛可用,独特的观点对于一个人选择推进什么成果就可能更加重要。
他的结论是,总体能力图表可能把模型与某一时间点的人进行比较,而近距离观察能让人看到,自己使用这些工具时工作可能如何改变。演讲最后,他请与会者分享使用 AI、与他人协作的收获。
同频道的其他文章
 16:57EN → 简体中文
 Every· 2026年11月9日播客Fable 5.2 擅长大型创作,但 token 成本不容忽视Every 的提前测试显示,它在编码和创作任务上表现突出;一次纪录片制作消耗了 14 亿个 token。
 46:14EN → 简体中文Every· 2026年11月4日播客 · 2 人对谈Kevin Roose:记录 AI 历史,以及决定把什么交给 AI嘉宾 Kevin Roose · 主持 Natalia Quintero这位记者谈论《The AGI Chronicles》、采访高度保密的行业、AI 辅助研究,以及“举重与叉车”的区分。
 50:51EN → 简体中文Every· 2026年10月29日播客 · 3 人对谈Fred Graver:把 AI 当作编剧室,而不是代笔人嘉宾 Fred Graver · 主持 Dan Shipper, Natalia Quintero编剧兼制片人介绍如何发展想法并利用 AI 反馈。
 43:01EN → 简体中文Every· 2026年10月21日播客 · 8 人对谈Every 的前沿团队如何把 AI 实验变成有用的工作嘉宾 Mike Taylor, Arielle Shipper, Jack Cheng, Katie Parrott, Jannik Jung, Kieran Klaassen · 主持 Natalia Quintero, Dan Shipper团队成员分享如何测试模型、整理实验,并将有用的工具带回公司日常工作。
 51:02EN → 简体中文Every· 2026年10月14日播客 · 2 人对谈Matt Hartman 谈 Hugging Face、技术创始人与产品洞察嘉宾 Matt Hartman · 主持 Natalia QuinteroFactorial Capital 投资人谈转型、创始人网络,以及亲自开发 AI 应用对软件的认识。
 33:46EN → 简体中文Every· 2026年10月7日播客 · 2 人对谈Every 如何从个人机器人转向共享公司智能体嘉宾 Willie Williams · 主持 Dan ShipperDan Shipper 与 Willie Williams 讨论智能体实验、管理信息流以及工作和个人工具的边界。