30 秒看懂
Berman 解释 Meta-Harness 如何提出、评估和记录候选智能体 harness。他回顾分类、数学检索和 Terminal-Bench 结果,随后预测更广泛的自我改进软件;论文结果针对的是特定实验设置。
- 1提议器编程智能体检查文件并提出 harness 修改。
- 2分类结果论文报告平均提升,但 ACE 在一个数据集上获胜。
- 3数学检索发现的策略改善论文中的留出模型比较结果。
- 4终端任务文章比较 Terminal-Bench 2 报告的通过率。
要点建议
- Harness 控制模型周围的工具、记忆和上下文。
- Meta-Harness 使用编程智能体检查先前运行并提出候选修改。
- 论文报告多个评估任务的改进,但存在例外,比较也受实验设置限制。
- 运行时上下文较少本身不能反映完整搜索成本。
- 关于 AGI 或所有软件自我演化的说法是预测,并非基准证明的结论。
按章节阅读整理后的全文
Harness 与自我改进
Berman 介绍论文,并区分模型与其 harness。
我解读 Meta-Harness 研究:它搜索语言模型周围代码的改进方案。我预测所有软件很快都会自我演化,这是预测;论文评估的是特定任务,并未证明这一广泛结论。
Harness 为模型权重提供周边基础设施:工具、记忆、检索、文件访问和系统运行规则。不同 harness 的选择可以改变同一底层模型的表现。
我把这一思路与 Andrej Karpathy 的 autoresearch 项目比较;后者反复提出并测试训练实验。Meta-Harness 则使用外层搜索循环,改进面向目标任务的 harness 代码。
研究者认为系统表现不只由模型权重决定。我认为现有模型配合合适的 harness 就能达到 AGI,但这是我的观点,基准结果并未证明这一点。
优化循环
编程智能体检查先前运行、提出修改并接收反馈。
论文追问能否自动化 harness 工程。一个困难是,存储或检索信息的决定可能在许多步骤之后才影响行为,因此把长执行轨迹压缩成单一分数可能掩盖失败原因。
该方法没有把全部历史塞进一个提示,而是让智能体有选择地访问外部上下文。目标是在需要时查看相关信息,包括先前实验及其执行轨迹。
提议器是一个能使用开发工具并修改代码的编程智能体。它通过文件操作检查先前的 harness、分数和执行轨迹,决定修改内容,再提交新的候选方案进行评估。
文件系统保存源代码、评估分数以及提示、工具调用和输出等细节。智能体可以检查的不只是最新或最佳候选方案,也能从失败中寻找信息。
该方法借鉴了外部记忆、检索和可执行程序搜索。外层循环相对简单:提出 harness、评估、保存证据,并在固定次数内重复。
提议器选择检查什么,以及进行小修改还是大规模重写。Berman 预计更强的编程智能体会改善这个过程,但递归加速的说法属于解释和预测,并非实验确立的规律。
分类与迁移
论文在分类和留出数据集上比较不同 harness。
实验使用搭配 Opus 4.6 的 Claude Code 作为提议器,并评估文本分类、检索辅助数学推理和终端任务。比较对象包括人工设计的 harness 和其他搜索方法。
在三个分类数据集上,论文报告其选出的 harness 平均准确率为 48.6,ACE 为 40.9;额外上下文分别为 1.14 万和 5.08 万 token。ACE 在 USPTO 上表现更好,因此并非每个数据集都获胜。
论文将 USPTO-50k 定义为根据产物分子预测反应前体的化学任务,并非简单的专利局通用分类任务。另两个数据集涉及症状和法律罪名。
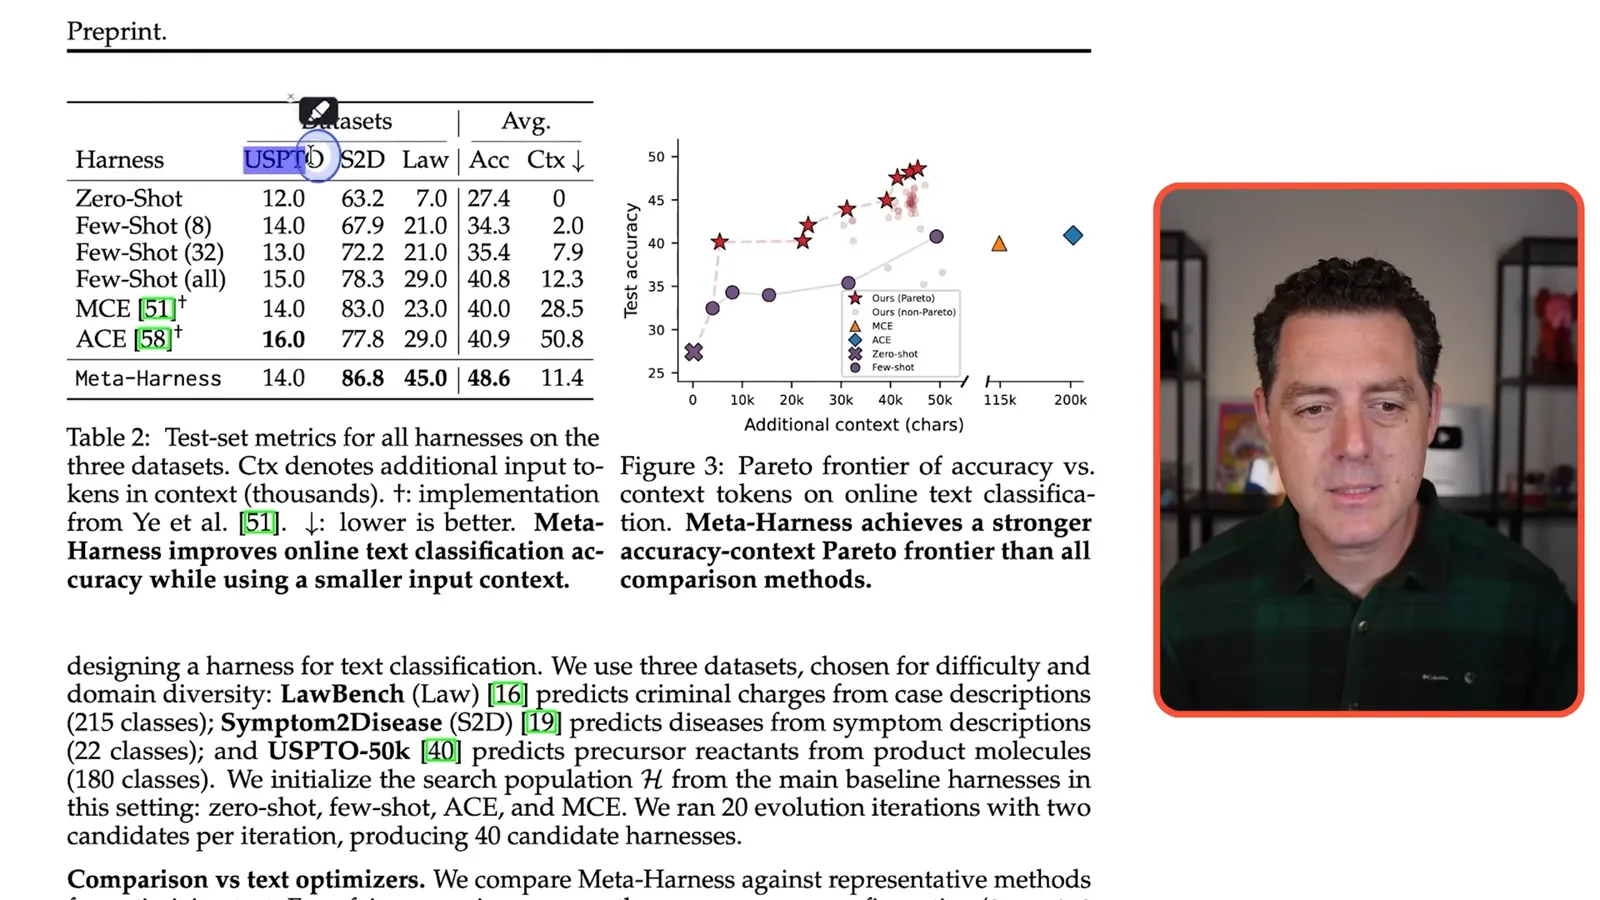
作者还与其他优化方法比较,称在其设置下使用更少完整评估取得较强搜索结果。上下文用量较低本身并不能完整反映搜索和评估候选 harness 的总成本。
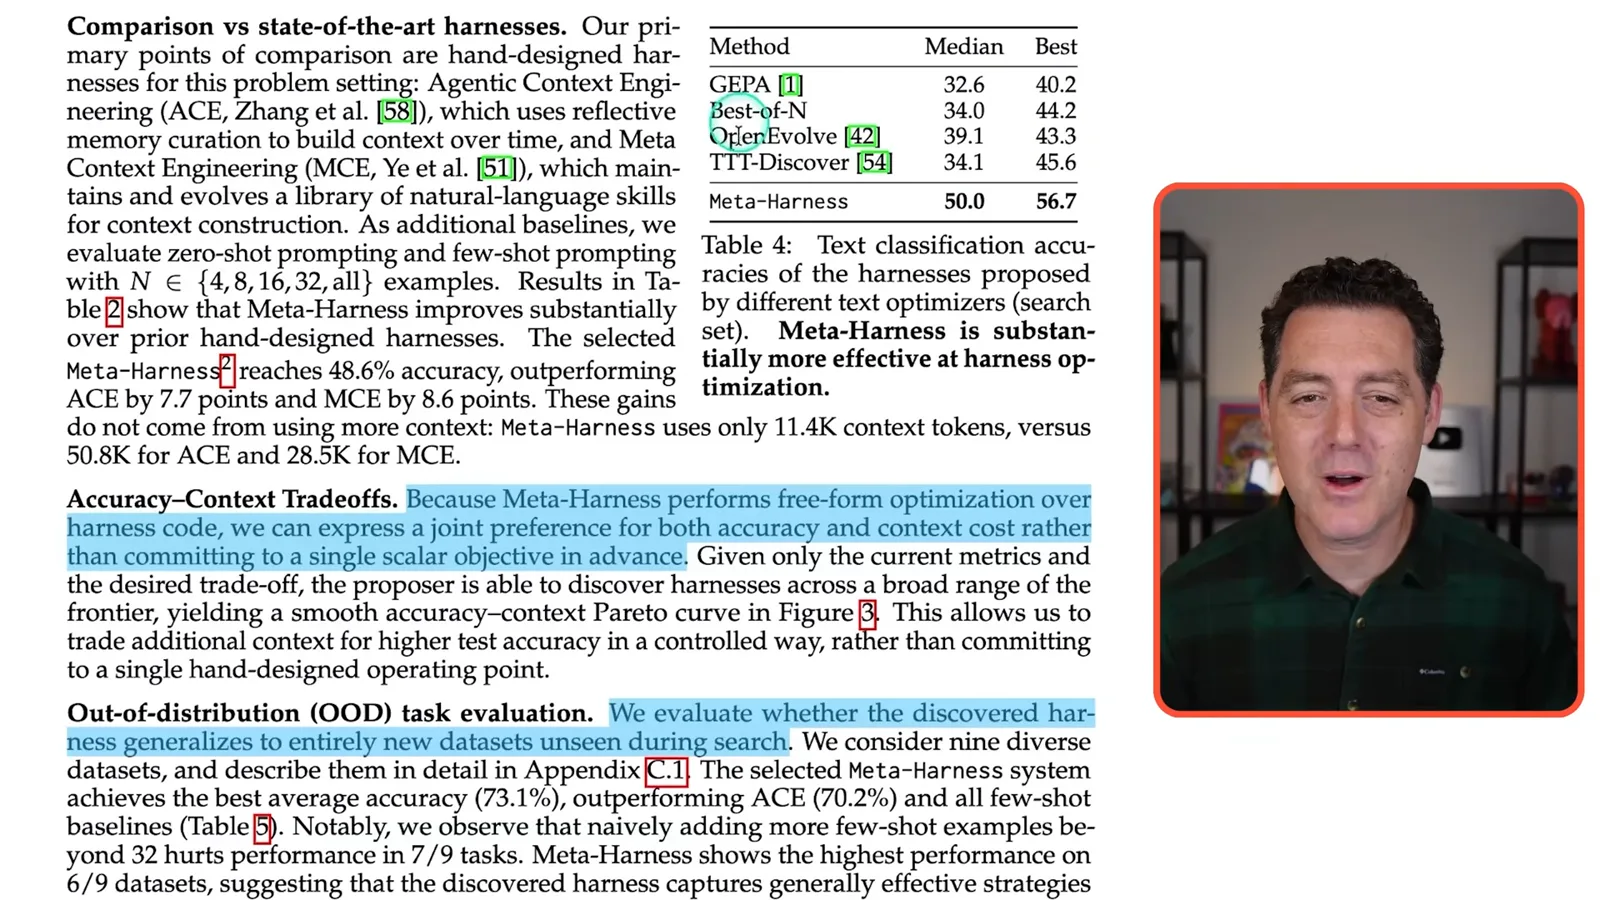
在搜索时未见过的九个数据集上,论文报告平均准确率为 73.1,ACE 为 70.2;其中六个数据集取得最佳结果。这说明在该评估中存在迁移能力,并不能证明普遍泛化。
数学和终端基准
Berman 解读检索与终端结果,并提出预测。
在奥林匹克级别数学推理中,发现的检索策略相对不使用检索的基线,在五个留出模型上平均提高 4.7 个百分点。论文提出的直觉是,先前解答可能包含可复用的证明模式。
Terminal-Bench 2 测试需要终端交互的长流程任务。论文报告 Opus 4.6 的通过率为 76.4%,低于表中 ForgeCode 的结果;Haiku 4.5 为 37.6%,表中下一个 Haiku 智能体为 35.5%。
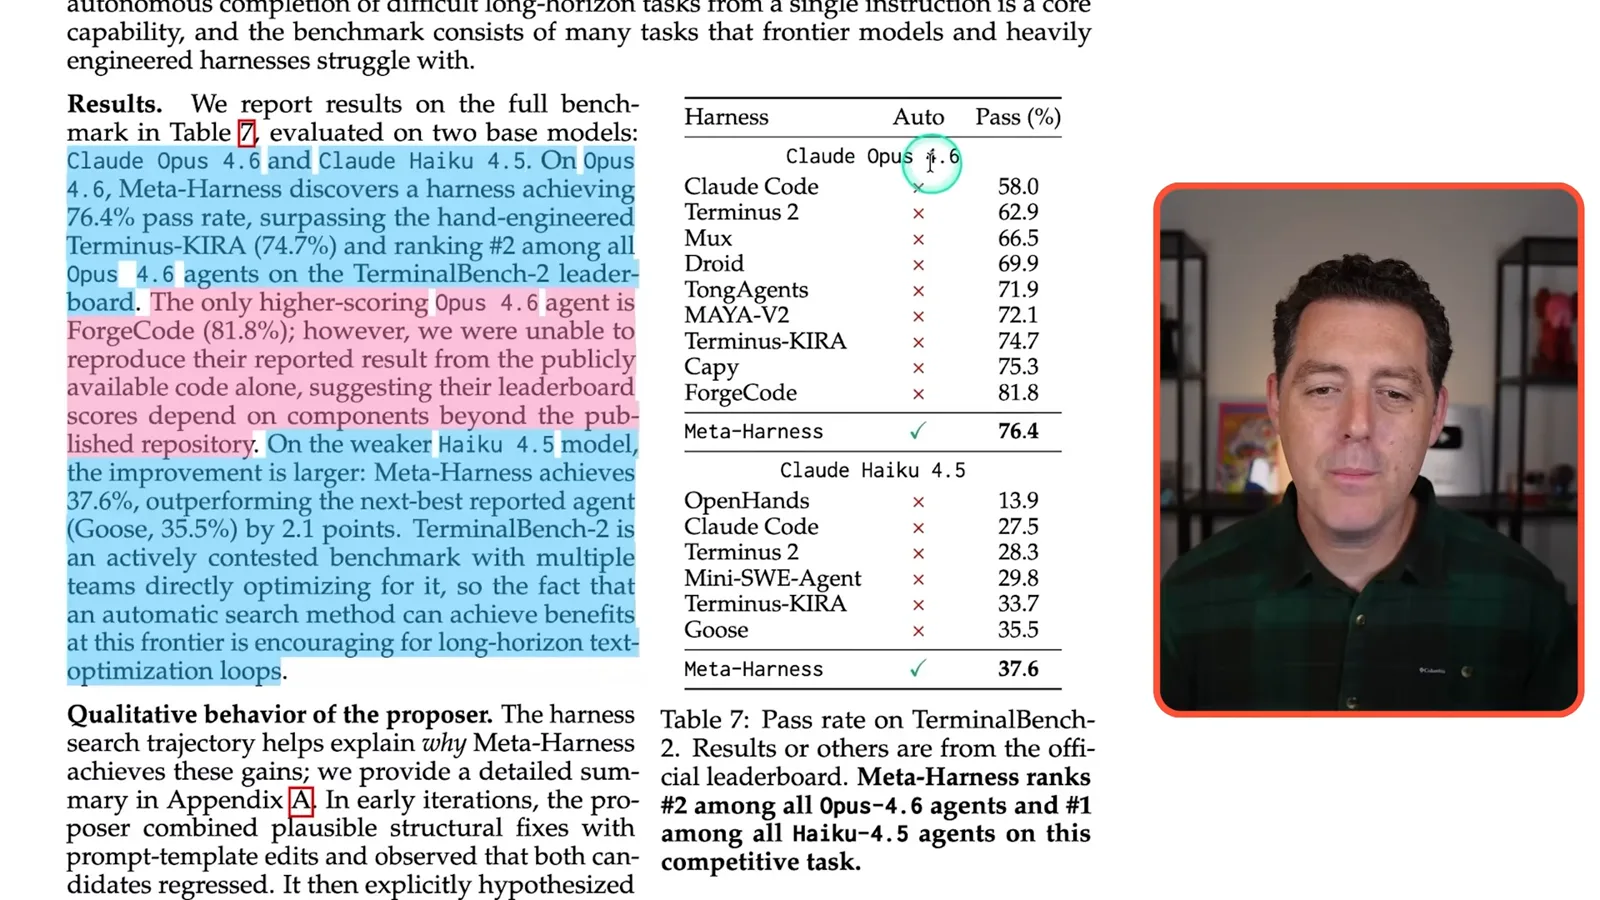
我将结果与“苦涩的教训”联系起来,认为学习方法会取代手写启发式。这是我的广泛解读;这些特定比较不能证明 AI 编写的系统总是优于人工设计的系统。
我预计更多软件和 harness 会通过反复的自动化实验改进。论文为其测试过的搜索过程提供了证据,而实际部署仍需要合适的评估、成本核算和监督。
同频道的其他文章
 25:50EN → 简体中文
 32:20EN → 简体中文
 0:22EN → 简体中文
 45:08EN → 简体中文
 0:32EN → 简体中文
 1:02EN → 简体中文