30 秒看懂
2024 年 9 月,Matthew Berman 采访 Reflection 70B 创作者 Matt Shumer 和 Sahil Chaudhary,讨论如何训练模型检查和修正回答。他们最初的基准声明后来受到质疑,因为独立评估难以复现部分宣传结果。
- 1提出的方法Shumer 描述训练模型识别并修正中间文本中的错误。
- 2选择性反思Chaudhary 说样本重点放在困难情况,也包括检查正确步骤。
- 3Token 开销嘉宾给出非正式估计,而非测量过的成本数字。
- 4基准声明需要背景创作者最初的性能声明后来受到独立评估者质疑。
要点建议
- 创作者描述了使用包含中间步骤检查的合成样本进行微调。
- 他们希望选择性地使用反思,避免鼓励不必要的错误。
- 他们估计难题的 token 消耗更高,但没有提供精确测量。
- 若干想法、数据集发布和模型变体在当时只是未来计划。
- 后续独立评估报告称,最初的性能声明难以复现。
按章节阅读整理后的全文
介绍与发布声明
Berman 介绍嘉宾及其模型公告。
Matthew Berman 欢迎 HyperWrite 的 Matt Shumer 和 Glaive 的 Sahil Chaudhary,讨论前一天宣布的 Reflection 70B。这是发布初期的采访:后续独立评估报告称,部分最初的基准声明难以复现。
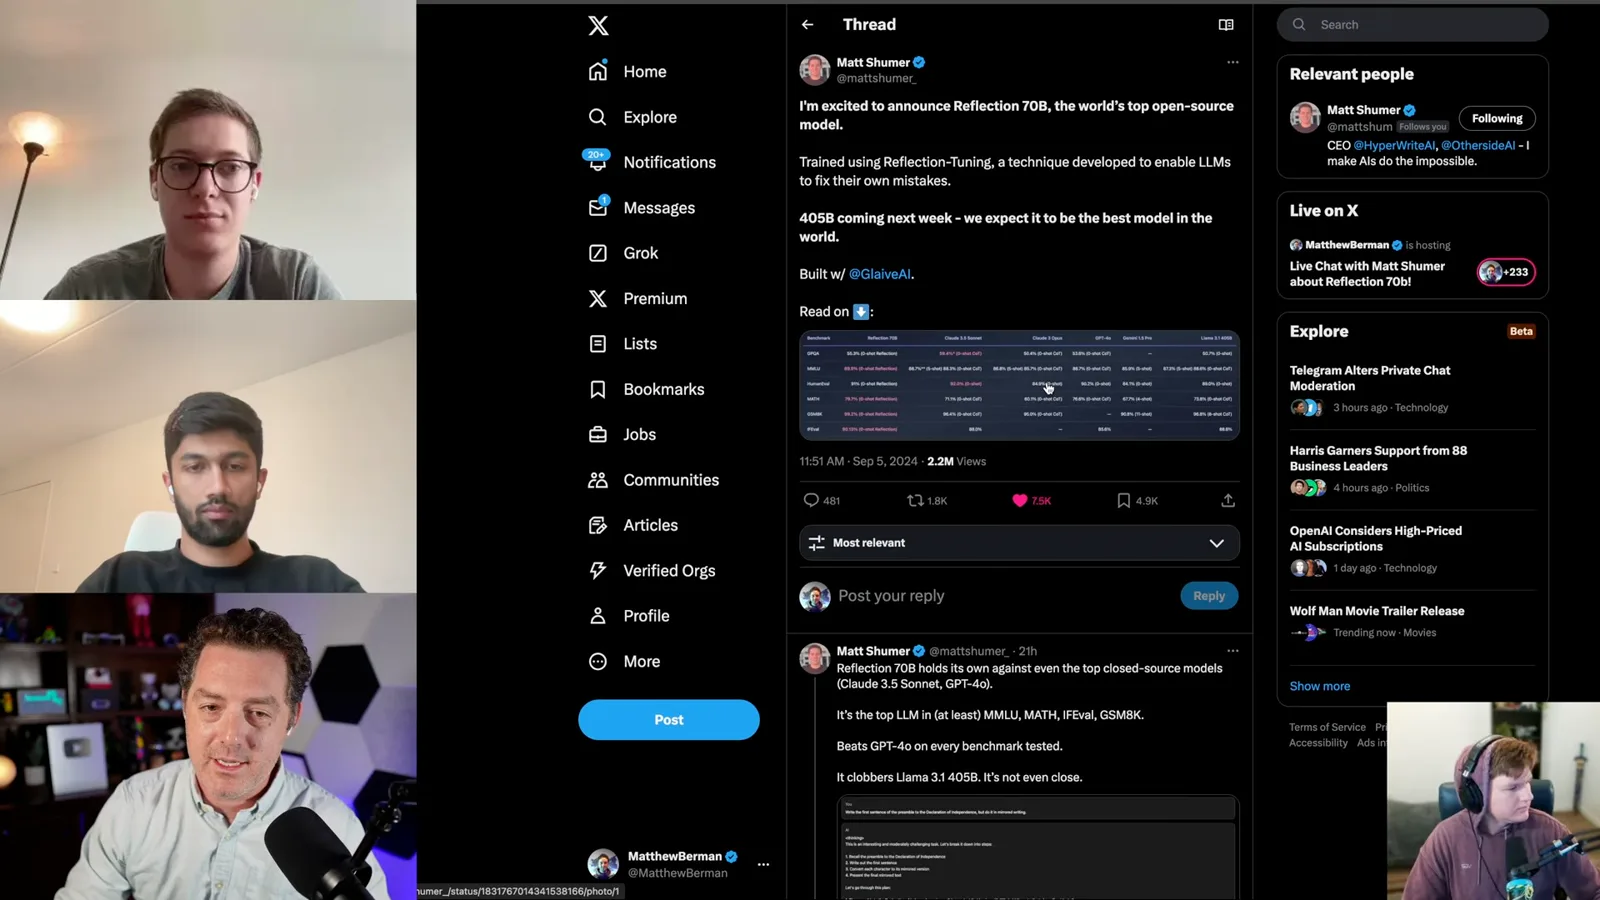
Berman 阅读 Shumer 的公告及其与更大模型的基准比较声明。他还提到计划中的 405B 版本;采访中的未来计划不能证明它后来已经发布。
Shumer 介绍 HyperWrite 如何从邮件写作想法发展为更广泛的写作产品。他说,Reflection 项目始于自己联系 Chaudhary 探讨合作。
嘉宾说,他们约用三周完成数据集、微调并发布模型。Shumer 认为小团队有时不需要大型实验室的资源也能取得进展;这是创作者对自己工作的描述。
Chaudhary 介绍,Glaive 帮助组织生成面向特定用途的合成数据集,并迭代定制模型。他认为数据质量和快速迭代是项目的核心。
反思微调与数据
创作者解释他们提出的方法和合成数据集。
Shumer 将“反思微调”描述为训练模型识别并修正中间回答里的错误。他将其类比为人发现错误后回头检查;不过,可见的自我修正本身不能证明模型内部如何推理。
他认为模型可能把早期错误带入后续步骤,并说目标是在不教模型故意制造新错误的情况下发现问题。他承认第一版仍不完善。
Chaudhary 说团队从约 1 万个样本开始,扩展到约 10 万个,覆盖代码、数学、推理、函数调用和多轮任务。这些数据集数字来自嘉宾描述,采访中没有独立验证。
他说仅靠提示可以带来一些收益,但合成数据生成遇到一个问题:要求模型先犯错再纠正时,它未必能可靠地生成所需样本。团队表示,为此设计了训练样本。
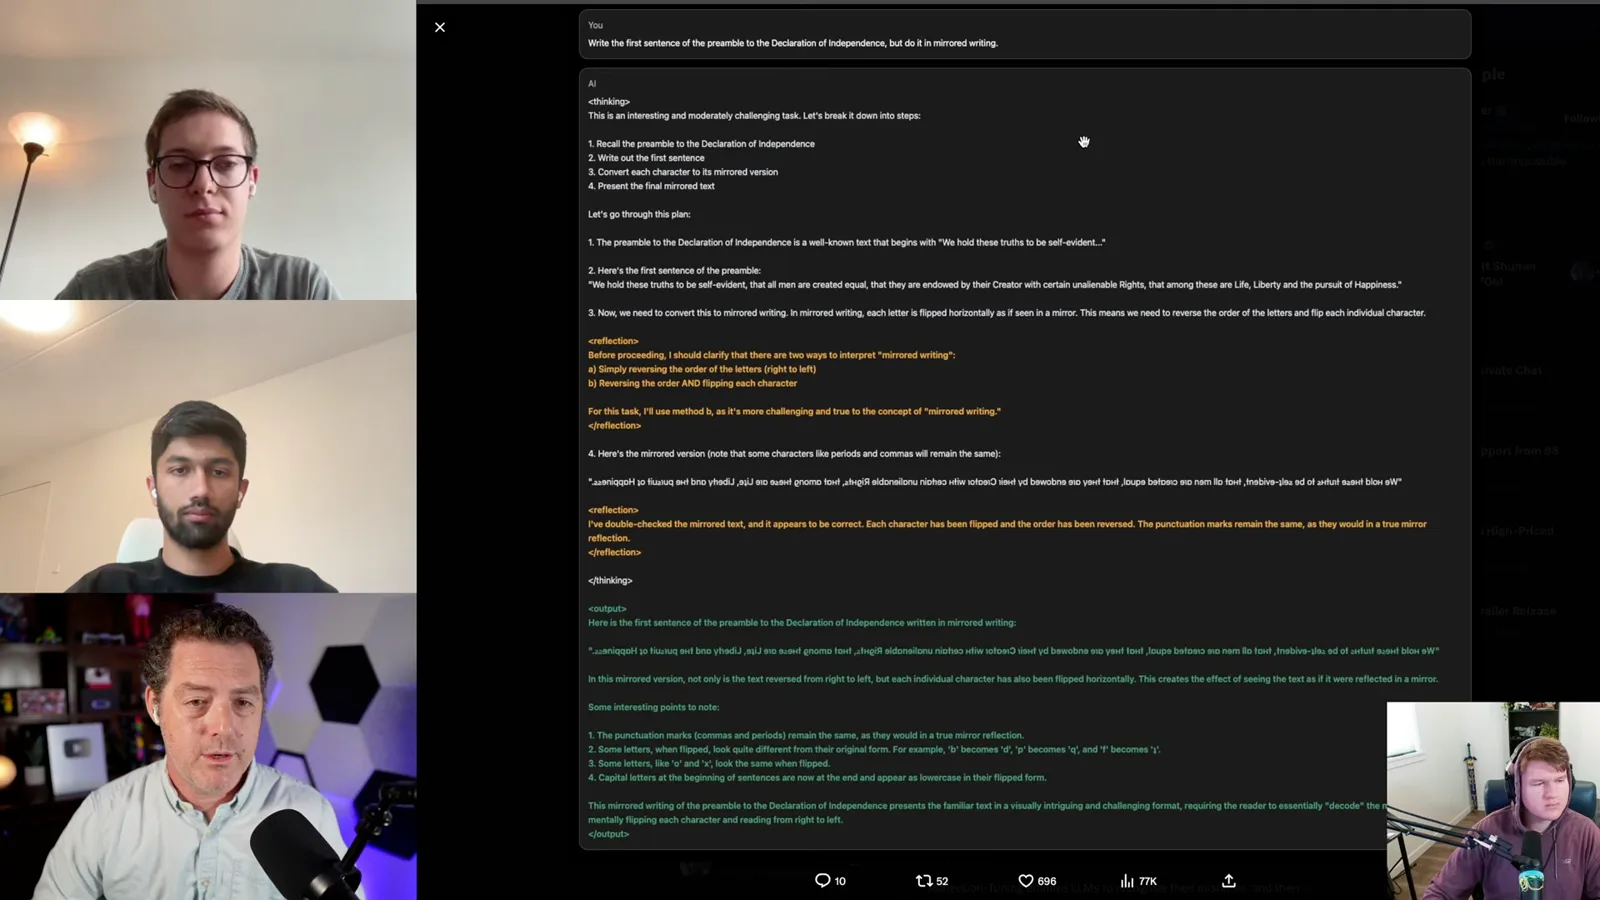
Shumer 补充说,反复要求模型反思可能促使它为了服从提示而引入错误。他说团队目标是有选择地反思,但也承认模型有时反思过于频繁。
Shumer 声称与基础模型相比取得了显著基准提升,并认为仅靠提示无法获得同样的改进。这些是创作者最初的说法;后续独立测试并未稳定复现宣传的分数。
训练与界面设计
几人讨论选择性反思、标签和组合多个模型。
Chaudhary 介绍按难度分类问题,并主要在较难的案例中加入反思样本。他还说,一些样本会确认中间步骤正确,然后不加修改地继续。
团队说,他们在平衡这些样本的同时迭代了多个模型版本。当时他们计划发布技术报告解释细节;计划本身不是已发表的方法,也不等于他人复现。
Shumer 介绍用标签将中间文本与最终回答分开。他建议界面可以选择性展示中间内容,减少用户需要阅读的文字。
Berman 问,推理期间的自我修正是否与多个模型相互审查相冲突。Shumer 说两种方法可以结合,让多个模型分别反思并处理不同角度。
成本与观众问题
嘉宾回答 token 开销、小模型、量化和上下文长度问题。
谈到开销时,Chaudhary 根据非正式测试估计,较难问题的输出 token 约增加到 1.5 至 2 倍,同时强调没有精确测量结果可分享。生成更多 token 可能影响延迟和成本。
观众问该方法能否用于其他模型。嘉宾预计标准微调可以应用于开放权重模型,同时指出闭源服务商的微调接口可能存在限制。
嘉宾说最初的 8B 实验改善了部分基准,但不是全部。Shumer 不确定提升差异的原因,并权衡继续优化小模型还是尝试其他想法。
Shumer 介绍未来可能把有用的提示技巧融入训练。嘉宾说可能公开数据集,但当时尚未最终决定,并将此与后续工作计划联系起来。
Chaudhary 解释,模型被训练为在难题或较难的中间步骤更常使用反思,简单问题则未必需要。这描述的是预期行为,并不能证明它判断难度一定可靠。
被问到混合专家模型时,嘉宾说尚未在这种模型上测试该技术,无法保证性能提升。他们指出推理速度可能影响成本与收益的权衡。
关于量化,Shumer 说有限测试暗示质量或一致性可能下降,但不知道下降幅度。Chaudhary 说模型保留了基础模型的上下文长度,同时训练中没有充分测试长上下文表现。
Berman 最后感谢嘉宾,并欢迎开放模型实验。这场发布采访记录了创作者设想的方法和声明;评估性能仍需要独立测试和可复现结果。
同频道的其他文章
 25:50EN → 简体中文
 32:20EN → 简体中文
 0:22EN → 简体中文
 45:08EN → 简体中文
 0:32EN → 简体中文
 1:02EN → 简体中文