30 秒看懂
Theo 讨论 Sean Goedecke 的观点:在大型代码库中,局部理解不可避免。他探讨 Peter Naur 的理论构建思想、重写的风险,以及开发者如何重新建立对陌生系统的认识。 他结合 Twitch、TypeScript 和 AI 辅助移动端重写的例子,认为工具可以减轻认知负担,同时工程师仍需保留做出和验证修改所需的上下文。
- 1易于查找比记忆更重要Theo 看重的是不太熟悉项目的开发者也能快速定位正确区域的代码库。
- 2编程作为理论构建讨论借鉴 Naur 的观点:开发者掌握的知识,代码和文档只能部分承载。
- 3逐步重写Theo 同意新系统可能丢失重要边界情况,而修改旧系统是替换它的一部分。
- 4不完美的心智模型一个 Twitch 例子说明,优秀工程师也可能不了解某个特定的生成步骤。
- 5AI 带来取舍语言模型可能帮助人快速建立局部理解,也可能让详细理论更难维持。
- 6移动端重写实例Theo 介绍如何通过行为观察和对整体系统的了解,引导 AI 辅助的 SwiftUI 重写。
要点建议
- 在大型代码库中,架构直觉和查找相关代码的能力可能比记住每一行更重要。
- 重写可能丢失长期积累的特殊行为和用户依赖;替换前应先理解并能够修改现有系统。
- 团队可以从追踪一条流程、谨慎修改开始,逐渐重建知识。
- 类型检查等工具能让人从例行细节中释放注意力,但不能取代完成特定任务所需的理解。
- AI 可能加速建立局部模型,也可能让人更难维持详细理解。
- 关于完全放手编码的预测只是预测,并非已经确定的结果。
按章节阅读整理后的全文
为什么完全理解并不现实
Theo 区分记忆代码与架构直觉,并介绍 Goedecke 关于有效运用局部理解的观点。
如果你理解项目中的每一行代码,你所面对的系统可能比支撑操作系统、平台和数据库的系统更小或更简单。没有人能把足够庞大的代码库全部装进脑子。那些看起来什么都知道的工程师,往往拥有的是另一种能力:根据架构直觉判断某个功能或故障可能在哪里。
有用的代码库不要求每个人记住每个文件,而是让不太熟悉项目的人也能比较快地找到正确位置。有些部分我比以往任何时候都更了解,有些部分却几乎不了解;我想探讨这种张力,而不是为完全不知情、草率开发辩护。
Sean Goedecke 的文章《In defense of not understanding your codebase》探讨工程师需要理解代码到什么程度。他对比了规模较小、人员稳定的项目,以及团队不断变化、没人能掌握每个细节的大型系统。他认为,在大型系统中只有局部理解是常态。我大体同意,同时认为修改局部之前,应该对整体关系有足够了解,知道自己身处何处。
理论构建与重写
讨论考察 Naur 的理论构建思想,并质疑知识流失后整体重写的做法。现有系统包含许多用户可见的边界情况。
文章讨论了 Peter Naur 的《Programming as Theory Building》。按照 Goedecke 的介绍,程序员会建立关于程序做什么、为什么这样做的直觉性理论,而代码和文档只能承载其中一部分。对特定系统的经验还会形成关于故障模式和历史的直觉,这些知识无法简单地写进一份完美文件。
一个代理线程就像一位新开发者到来时没有前一个线程积累的上下文。这带来了一个有趣的设计问题:如何安排代码库和工具,让一位能力很强的新来者也能有效调查并贡献?即使文件和其他持久信息仍然可用,每个新线程都必须重新建立相关上下文。
Goedecke 反对他所理解的 Naur 的建议:知识流失后,新团队应该丢弃程序并重建,而不是重建旧理论。在大型用户系统中,长期积累的边界情况、集成和特殊行为很难重现。即使是原本无意的行为,也可能已经成为某个用户工作流的一部分。
一个经典的空格键笑话说明了这个问题:用户奇怪地依赖某个 bug,修复它反而破坏了用户的配置。真实系统里有许多没那么好笑的类似情况。如果记得某个特殊情形的人已经离开,全新重写很容易遗漏现有用户依赖的行为。
Goedecke 提出的模式是隔离旧系统中的部分功能,再逐块替换。即使我赞成重写,也希望先在现有代码上工作,理解故障、团队和用户在意的事情。如果你连旧系统都无法有效修改,我很怀疑你能安全地替换它。
最近有人声称 T3 Code、VS Code 和 Cursor 注定失败,因为 Electron 据说会为每个代理线程启动一个独立应用。这个前提是错的,但他仍用 AI 生成的论证来推广自己的 Rust 替代品。基于虚构诊断的重写,与扎根于现有系统的审慎重写不是一回事。
重新建立知识
团队可以逐步学习无人维护的系统。Theo 分享 Twitch 的例子,并解释类型检查如何减轻认知负担。
Goedecke 的第二个反对理由是,看似无人维护的系统确实经常被重新接手。他描述的方法是从一条端到端流程开始,谨慎修改,再逐渐扩展理解。我认为 AI 可以通过回答问题和检查代码帮助开发者更快熟悉系统,但它不会自动找回每位前维护者的历史知识。
文章认为,在足够大的代码库中,每个人的心智模型都不完整,有时甚至不正确。我在 Twitch 共事过的一位优秀全栈工程师,曾在添加 GraphQL 查询后遇到客户端类型错误。他了解前端和后端,却此前没有同时需要为两端生成更新的 TypeScript 定义。
我问他是否运行了 GraphQL 生成命令,他意识到漏了这一步,很快修好了。不了解这个特定步骤,并不意味着他不是优秀工程师。没有人能在完成有价值工作的同时,把每个操作细节都放在工作记忆里。
TypeScript 是减轻这种认知负担的例子。类型检查器能发现许多错误的参数类型和简单失误,让我不必每次调用函数时都手动重复这些检查。某种意义上,我对某个细节想得更少了;但另一方面,这也释放了注意力去处理更大的修改。编译器、linter 和其他检查也能起到类似作用,前提是我们保留完成任务所需的理解。
新开发者从自己写过每一行的项目进入比自己职业生涯还古老的代码库时,常会感到困难。在大型系统中,等待某个拥有完美心智模型的人来解答不是可靠策略。Goedecke 主张根据现有信息做出最有依据的决定,并在学习过程中负责任地处理后果。
解读 Naur 1985 年的论文时,规模也很重要。Goedecke 提到约 10 万至 20 万行的程序例子,并与后来大得多的 GCC 比较。编译器有输入和输出,可以支持广泛的行为测试;面向用户的软件还涉及交互和数据预期,这些可能更难全面覆盖。
理解是一种取舍
Goedecke 认为语言模型和其他必要工具会以不同方式影响心智模型。讨论也考虑了不同工程工作的限制。
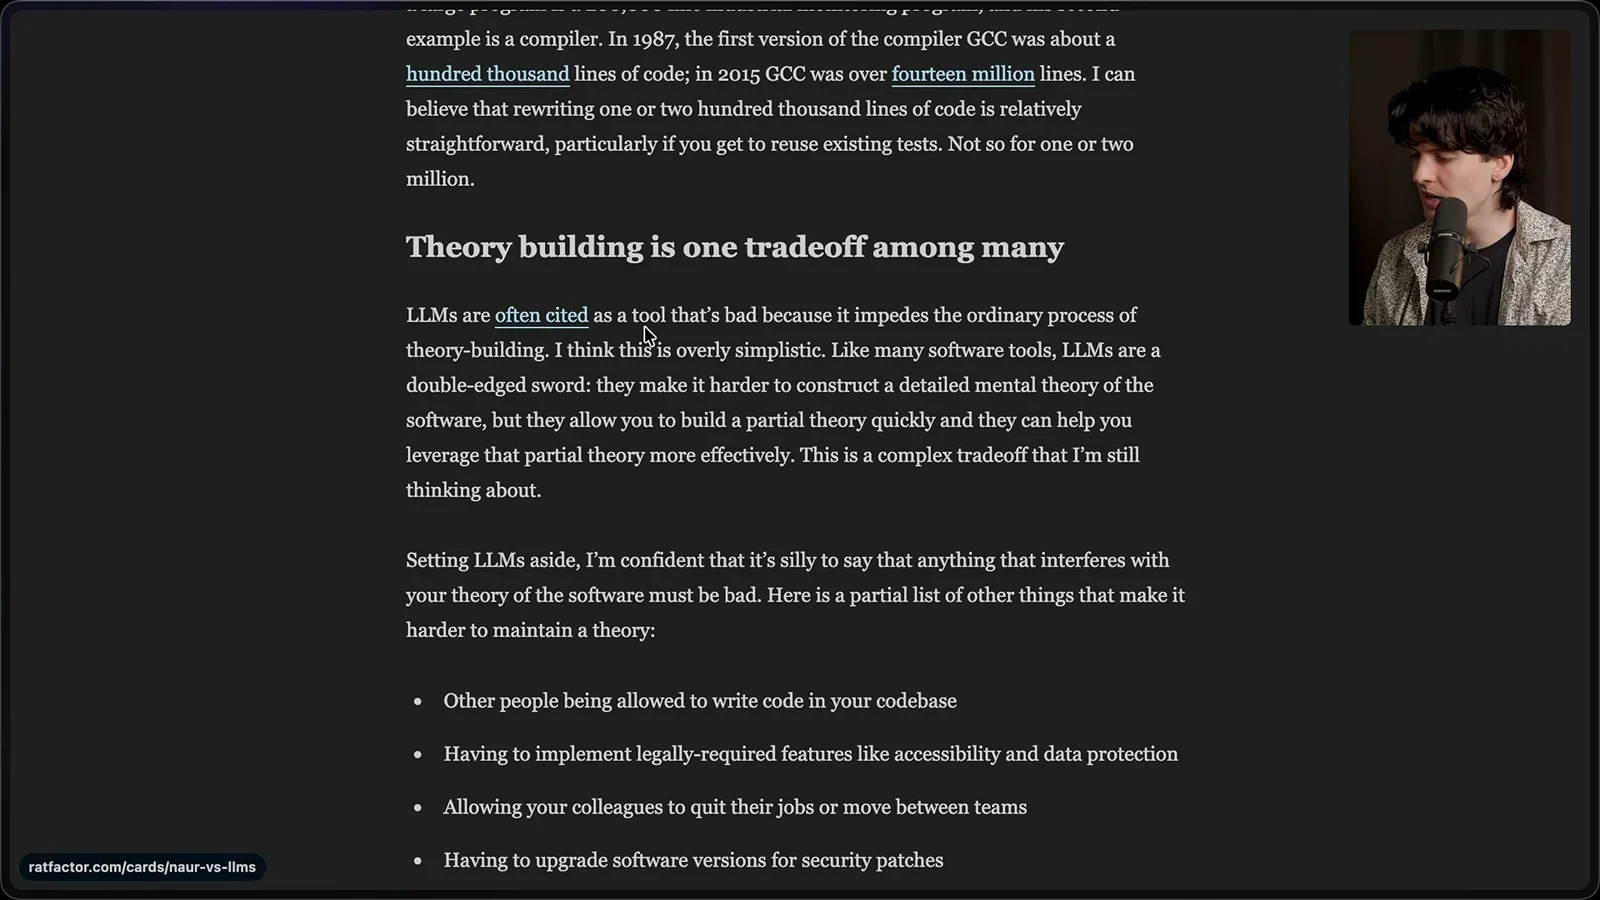
Goedecke 把理论构建视为众多取舍之一。语言模型可能让人更难维持详细的心智模型,也可能帮助人更快建立并使用局部模型。他和我都还在思考这种取舍;不能简单地说,任何改变你所记住内容的工具都必然不好。
许多日常必需的事情也会让完整的心智模型更难维持:同事写代码或离职、安全升级、外部依赖,以及无障碍和数据保护要求。团队仍然需要履行这些义务。有时理解是第一优先级;有时它必须与交付、合规或支持其他平台竞争。
Goedecke 把“纯”工程描述为尽可能完美地解决技术问题,把“非纯”工程描述为在限制下交付真实需求的解决方案。这是对不同工作的解释方式,并非给人排名。库或游戏引擎项目与按截止日期交付的产品团队,可能会奖励不同的决策。
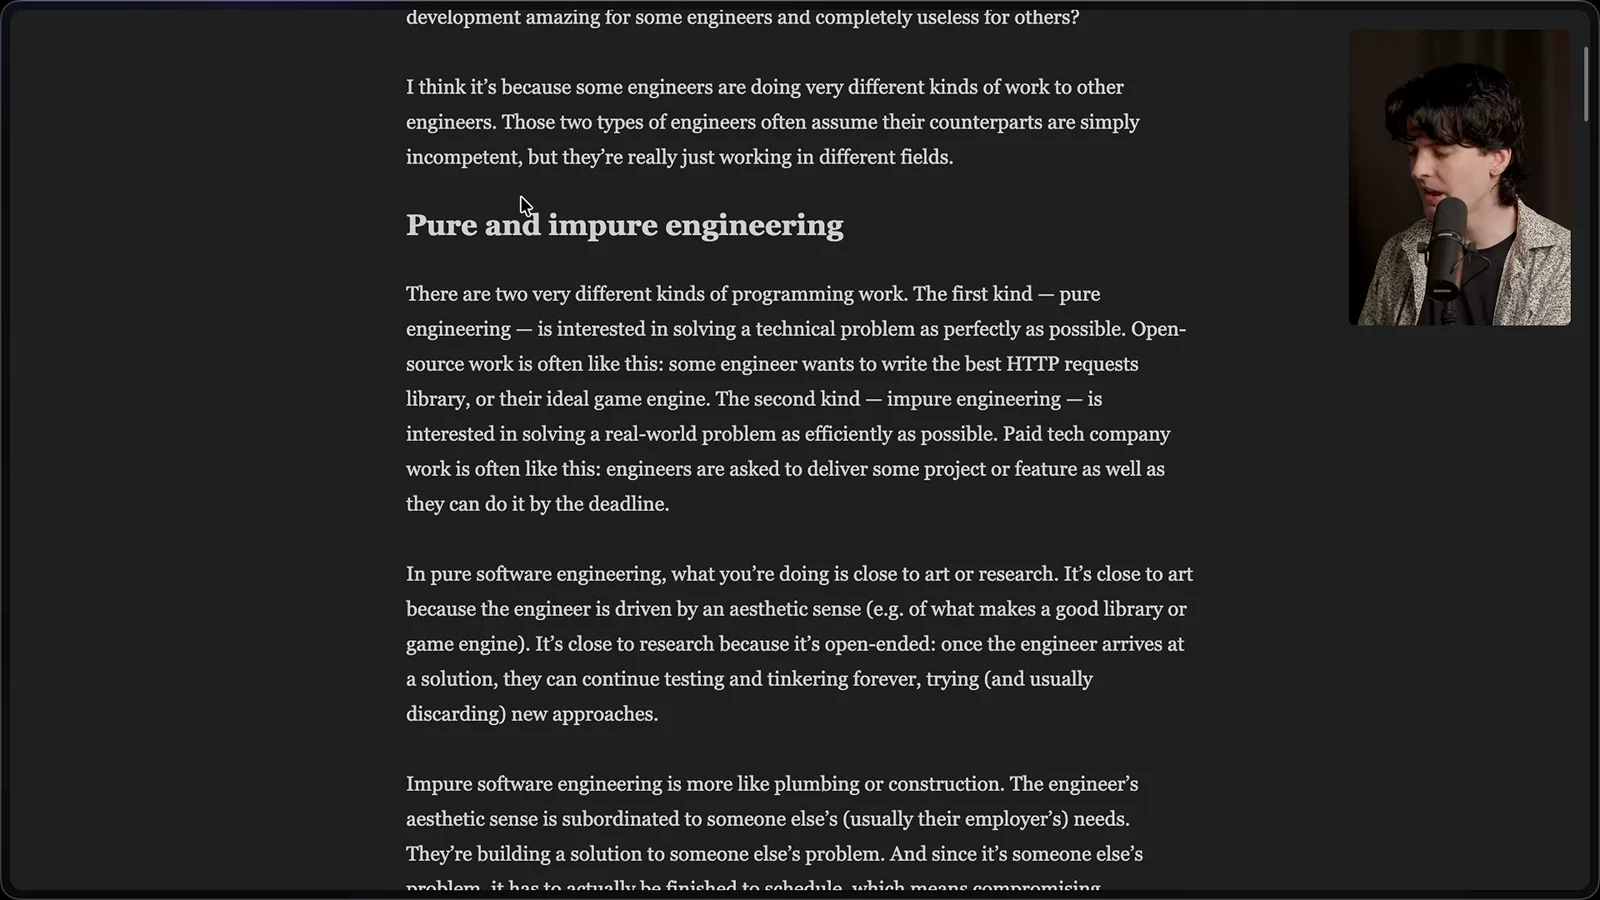
我能理解其中的张力:建立优雅的心智模型可能让人觉得这才是工程的本质,而有偿工作往往要求为了按时满足用户需求做出妥协。为了乐趣去做小型、理解透彻的项目没有问题。在工作中,代码库的理论只是众多价值之一,还要考虑团队目标和限制。
对 Goedecke 文章的讨论也强调了局部推理:工程师一直在尝试有效处理系统的一部分,而不必理解其他每一部分。我同意,与团队成员沟通、理解项目需要什么,都是实际的工程能力,而不是偏离“真正工作”。
AI 与移动端重写
Theo 讨论对 AI 生成代码的预测,以及自己的 SwiftUI 项目,最后谈到整体理解与未阅读的实现细节之间的张力。
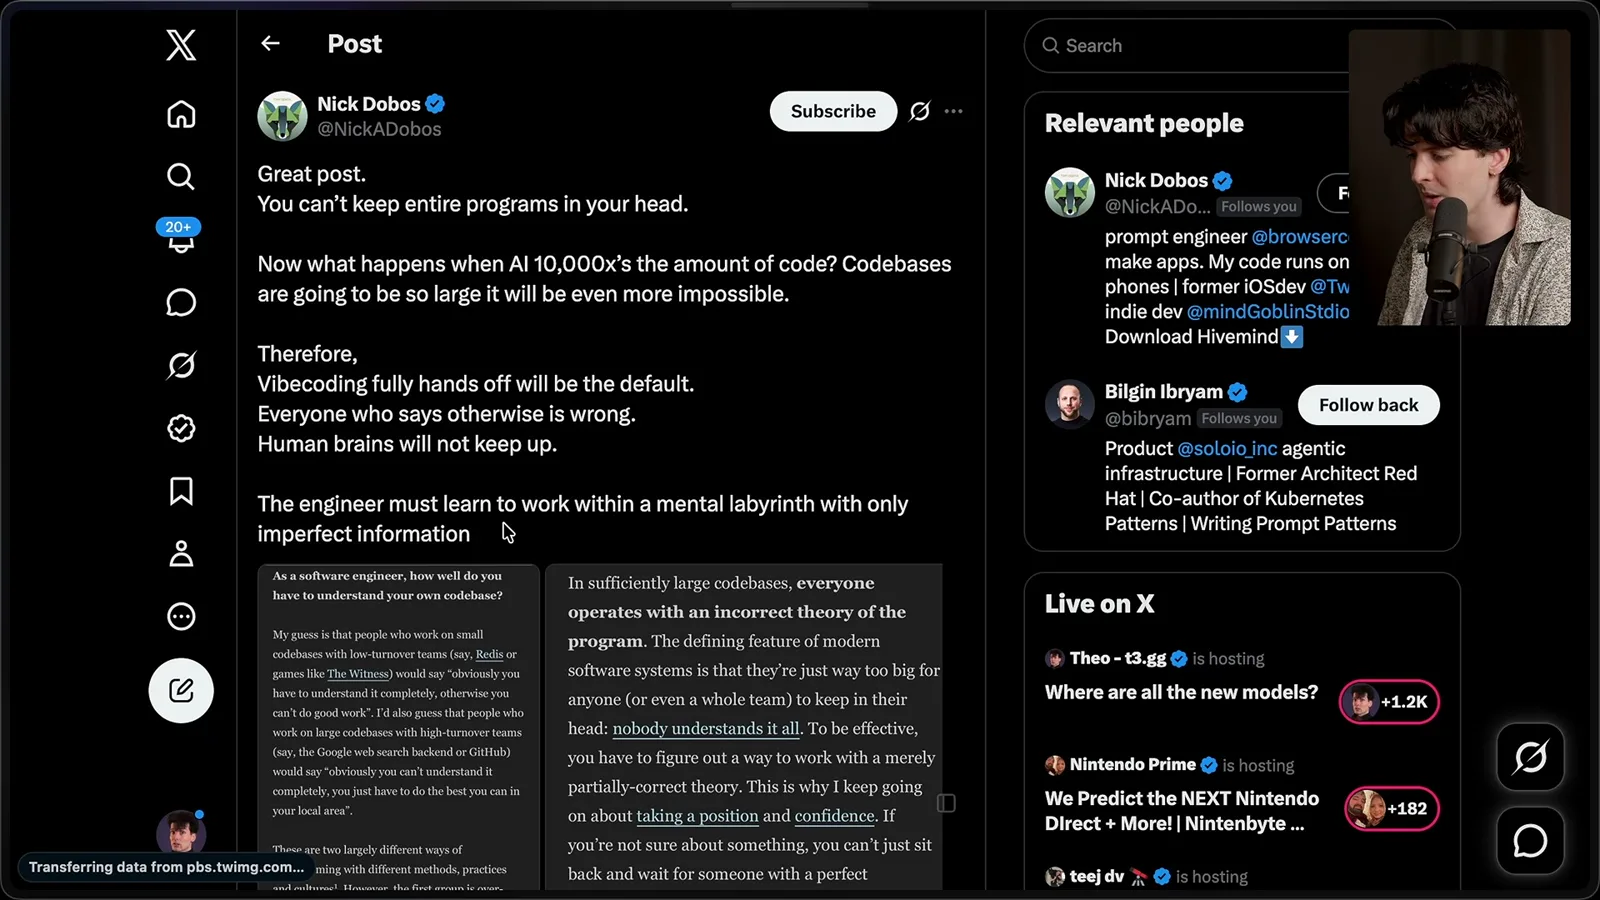
Nick Dobos 预测,AI 生成代码的数量迅速增长,会让完整的心智模型更加难以维持,高度放手的编码可能成为默认方式。这是预测,不是已经证明的必然结果。我在把 T3 Code 移动应用从 React Native 迁到 SwiftUI 时,已经体验到这个问题的一个版本。
我说自己没有读过这份移动端实现的六万多行代码。我通过使用应用、观察故障并与现有系统的行为比较来引导修改。我从 T3 Code 其他部分积累的数据流和故障知识仍然重要;有一两个 bug 不能仅靠让代理照搬旧行为解决。
结果是一种奇怪的平衡:某些方面,我比以往更理解代码库;另一些方面,我又理解得更少。我仍在摸索这种平衡。对我来说,学会驾驭它很有收获,虽然也会感到压力;我预计工作流还会继续变化。
同频道的其他文章
 36:07EN → 简体中文
 Theo - t3․gg· 2026年10月27日Theo 谈 Token 成本、编程智能体与 AI 能力的价格Theo Browne · Ping Labs一则关于 Lauren 的 AI 支出估算广泛传播,引出了对缓存计价、基准测试和编程智能体工作方式的讨论。
 30:37EN → 简体中文Theo - t3․gg· 2026年10月26日Theo 的三个技能:用编程智能体审查和交付代码Theo Browne · Ping Labssol-loop、full-send 和 full-stop 如何定义审查、验证以及不同程度的合并权限。
 0:43EN → 简体中文Theo - t3․gg· 2026年10月23日Theo 区分安全漏洞与实际攻击Theo Browne · Ping Labs一段简短讲解:软件漏洞披露和攻击事件为何属于不同类型的安全新闻。
 29:22EN → 简体中文Theo - t3․gg· 2026年10月22日Theo 谈安全漏洞、被盗 API 密钥与 AITheo Browne · Ping Labs从漏洞披露到补丁部署之间的风险窗口,以及被盗推理密钥为何可能有价值的推测。
 31:13EN → 简体中文Theo - t3․gg· 2026年10月20日Theo:更聪明的模型为何能帮助更多人Theo Browne · Ping Labs从游戏修改到编译器实验,Theo 重新思考谁能从更强大的 AI 中受益。
 31:47EN → 简体中文Theo - t3․gg· 2026年10月18日Theo:向智能体请求结果,再构建它需要的工具Theo Browne · Ping Labs从工具耗时报告、排障手册到数据连接,看提示如何改变产品工程。