30 秒看懂
Nathan Lambert 将指令微调、奖励模型和拒绝采样串成一条实用的后训练流水线。他解释偏好模型损失及其变体、数据设计,以及用筛选答案训练和推理时 best-of-n 的区别。
- 1聊天模板模型专用 token 编码角色、消息边界和生成过程。
- 2提示词决定分布即使回答非常好,如果提示词没有覆盖目标任务也无济于事。
- 3Bradley–Terry 偏好奖励差的 sigmoid 用于对成对选择建模。
- 4奖励模型变体成对、结果和过程模型的标签及预测粒度不同。
- 5拒绝采样生成、评分、选择,再用偏好的回答进行微调。
要点建议
- 聊天模板和损失掩码决定指令数据如何进入模型。
- 提示词质量和任务覆盖是构建实用 SFT 数据集的核心。
- 成对奖励模型从选中和被拒的回答中学习。
- 结果奖励模型和过程奖励模型提供不同类型的监督。
- 拒绝采样用高分输出进行微调;best-of-n 则在推理时选择。
按章节阅读整理后的全文
指令微调
聊天模板、掩码和高质量数据教会模型如何回答。Lambert 介绍实际的数据混合与整理。
本讲将指令微调、奖励建模和拒绝采样联系起来。它们构成一个有用的顺序:教会模型回答、学习偏好信号,再选择高分回答进行训练。讲座尤其侧重奖励模型。
指令微调将基础模型的文本续写能力转化为实用的指令—回答形式。现代训练阶段相互重叠,但这种抽象有助于解释模型如何学会充当助手或智能体。
早期研究从任务专用微调转向文本到文本的多任务学习,以及 FLAN 和 T0 等指令数据集。ChatGPT 出现后,Alpaca、OpenAssistant 和 Tülu 帮助普及了开放指令微调数据与助手模型。
聊天模板使用模型专用标记组织 system、user 和 assistant 消息。它告诉模型谁在说话、回答从哪里开始以及何时停止。这些细节将普通消息对象转化为模型预期的 token 序列。
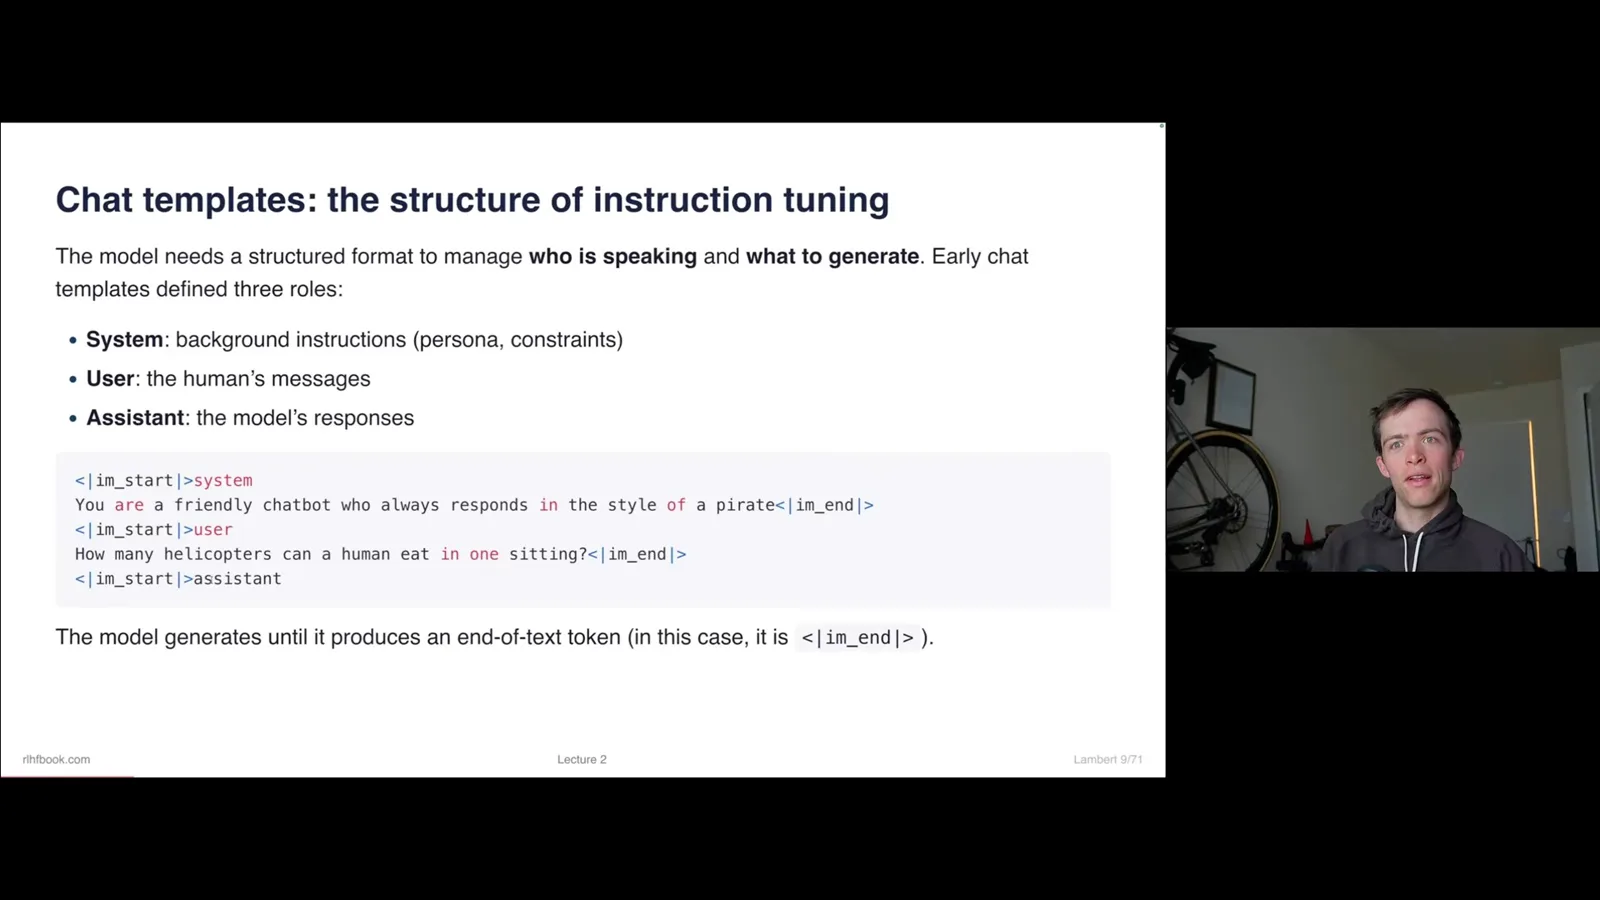
一个提示可以包含多轮交替的 user 和 assistant 消息。训练数据还包含模型应该学习的 assistant 回答。Tokenizer 工具应用相应模板,将结构化消息转换为模型专用文本。
模板经常使用 Jinja,而且不同模型家族的模板各不相同。特殊 token、换行、系统消息或工具格式中的小错误,都可能破坏训练或推理流水线。推理模式和工具使用又增加了复杂性。
Lambert 提到了一些让消息格式更容易处理的新尝试,但表示替代方案的普及进展缓慢。根本需求是在训练和推理中一致处理角色、token 和模型专用格式。
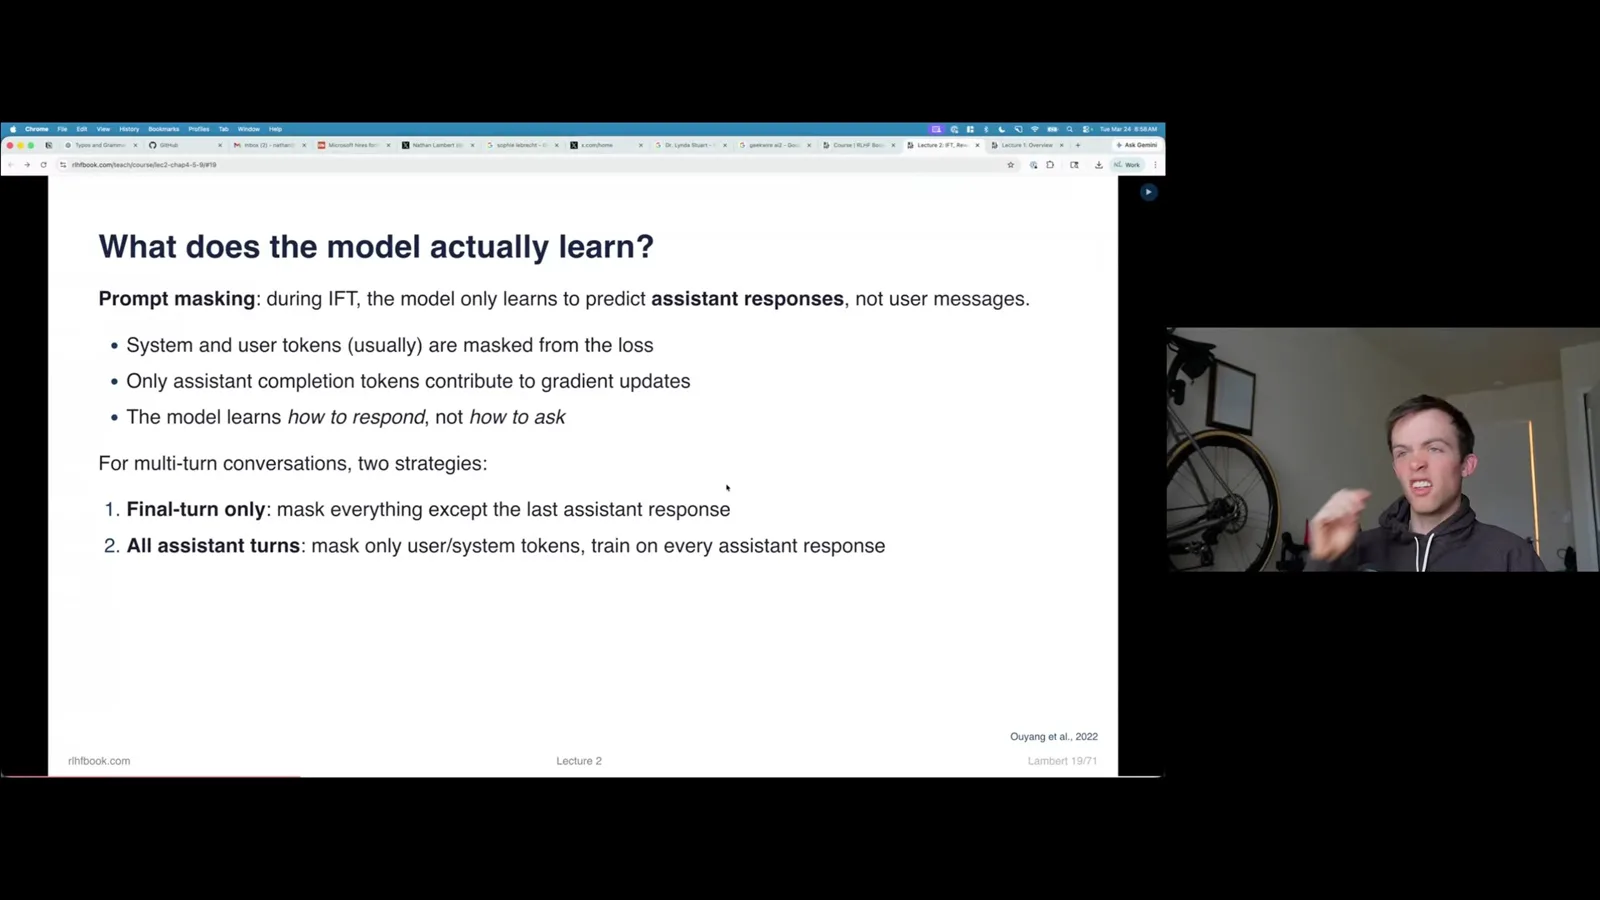
指令微调时,提示词 token 通常被损失掩码排除,让模型学习预测 assistant 回答。对于多轮对话,团队可以只训练最后一个 assistant 回答,也可以训练所有 assistant 轮次。
高质量回答很重要,但其价值取决于提示词。Lambert 称提示词是后训练的基本单位,因为它决定任务分布。给错误的提示词配上优秀回答,也无法教会模型所需能力。
指令微调通常使用比预训练更小的学习率和批次,同时保留下一 token 损失。分布更窄使过拟合和泛化能力下降成为重要问题。
Lambert 描述了从早期约一万个人工编写示例的数据集,转向规模大得多、经过严格筛选的合成数据集的过程。推理轨迹改变了比较方式:即使提示数量没有增加,token 数也可能大幅上升。
一百万个提示词不是神奇数字。通用模型可能需要多个领域的数据,合适的混合取决于任务。提示词可以在训练阶段之间复用,但每个阶段也可能需要不同示例。
Self-Instruct 从优质种子提示开始,让语言模型生成变体,再生成回答。这有助于扩展相似数据,但为专业真实任务获取高质量提示仍然困难。
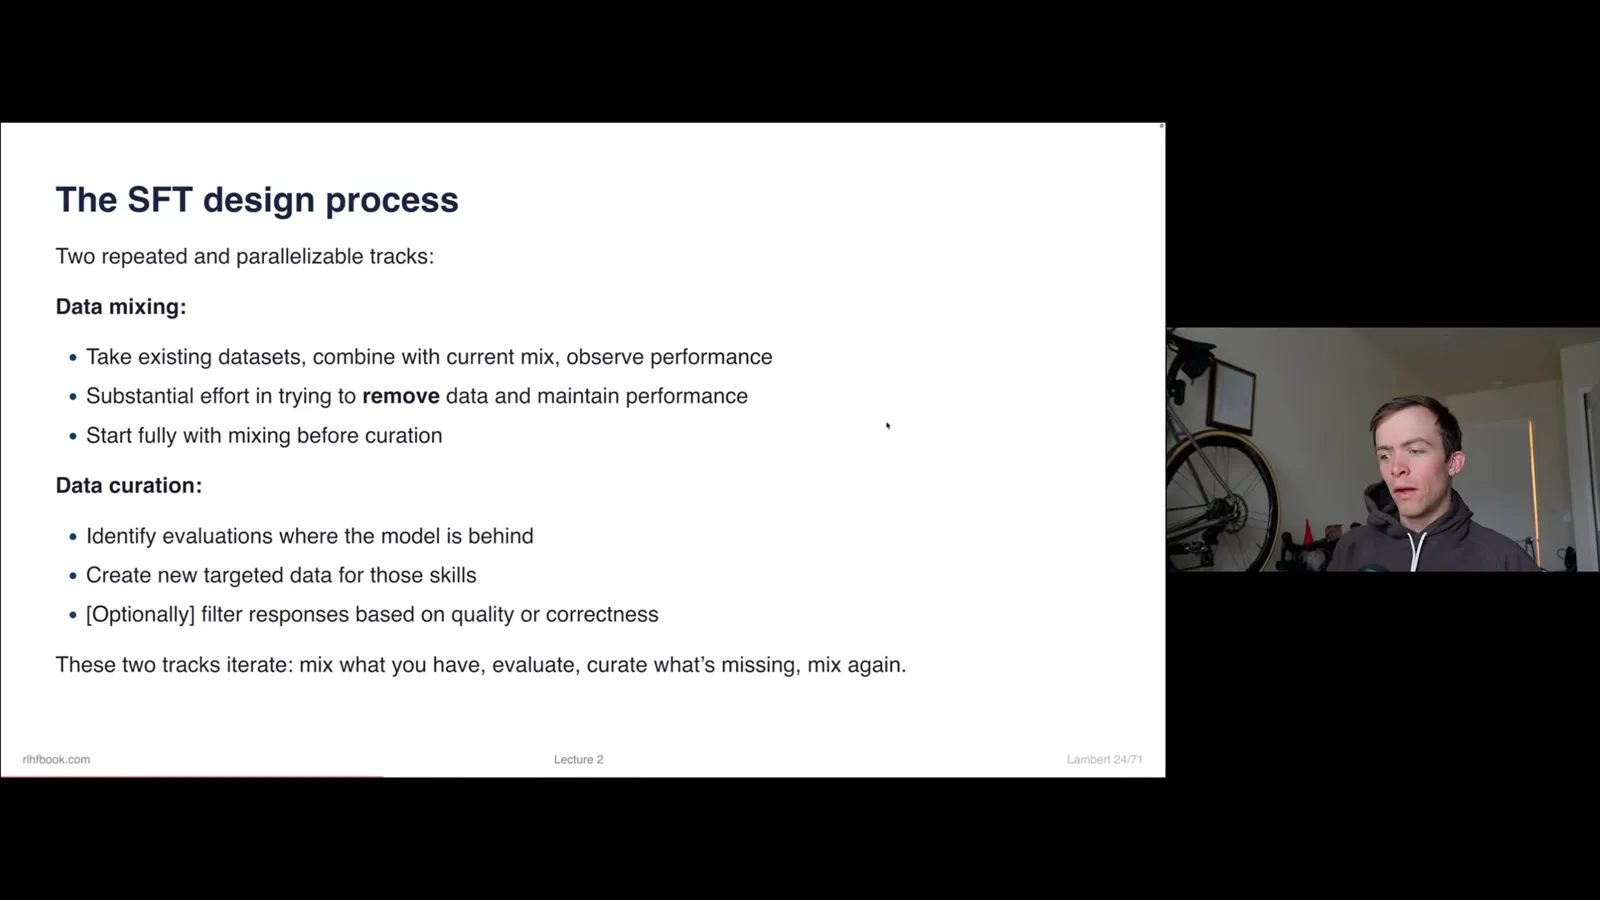
构建实用 SFT 方案时,先确定评估目标,混合相关现有数据集作为基线。然后找出薄弱技能、创建针对性数据、重新混合并评估。即使最终微调相对便宜,这种迭代开发也可能需要许多次训练。
奖励模型基础
成对偏好和 Bradley–Terry 模型导出奖励模型损失。Lambert 指出需要对数据集求平均。
奖励模型训练是一门工业技艺,公开研究尚未完全涵盖。Lambert 说,RewardBench 2 等工作加深了理解,却没有彻底解决如何为下游训练确定最佳奖励模型的问题。
在简化的 RLHF 循环中,奖励模型为生成回答提供学习得到的信号。由于分数只是有缺陷的代理,优化通常使用参考模型 KL 惩罚加以约束,以减少过度优化。
偏好数据通常包含同一提示的两个回答,其中一个被选为更好。奖励模型通过大量此类比较,学习为更受偏好的回答给出更高分数。
Bradley–Terry 模型使用潜在强度表示成对偏好概率。用标量奖励重新参数化这些强度,就得到两个分数之差的 sigmoid。
学习得到的奖励函数根据同一个提示,为选中和被拒回答评分。训练最大化观察到的偏好似然,等价于最小化分数差的负 log-sigmoid 损失。
损失必须对偏好样本数据集求平均。Lambert 后来更正了一张早期幻灯片:它从单个样本的最大化开始,却没有明确写出数据集层面的期望。
典型成对奖励模型在语言模型骨干上添加标量头,并读取每个回答末尾的分数。训练时比较选中和被拒回答;推理时模型可以为单个回答评分。
奖励模型变体
间隔、排序、结果和过程模型表示不同反馈。评估其下游价值仍然困难。
变体可以用间隔表示偏好强度,或利用同一提示的多个比较。Plackett–Luce 对多个答案之间的排序建模;只有两个选项时,它退化为 Bradley–Terry 的两项形式。
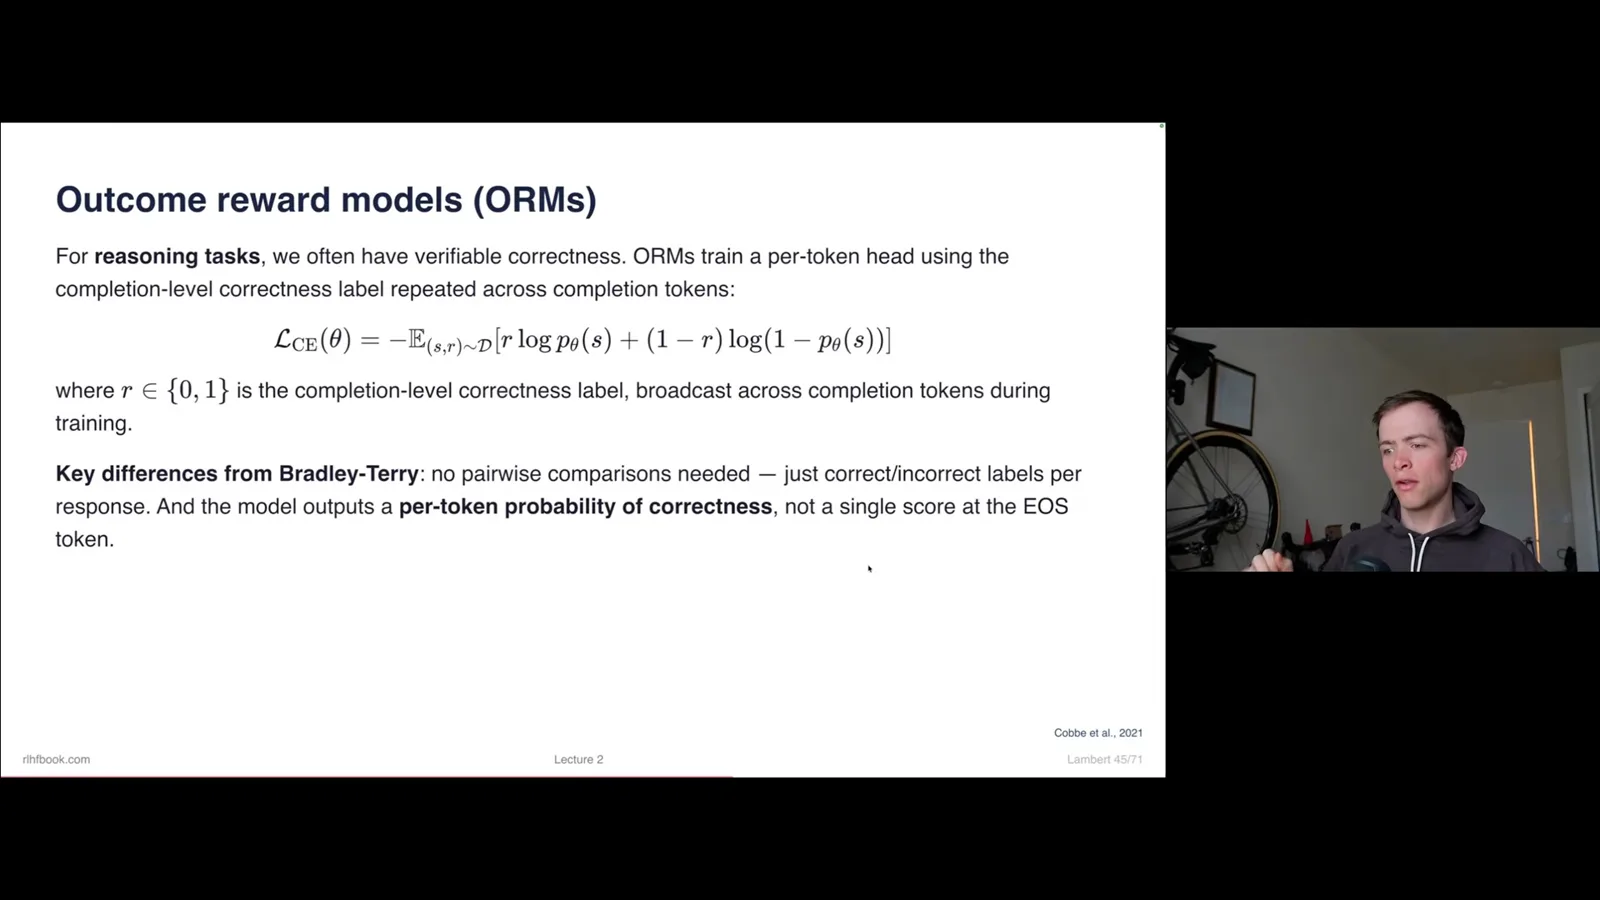
Lambert 将他介绍的结果奖励模型形式,与仅仅用正确性标签训练的成对分类器区分开来。在该形式中,模型在每个 token 位置预测最终结果正确的概率,训练时将结果标签重复到整个回答。
可以检查结果模型逐 token 的预测,观察明显推理错误之后概率是否发生变化。这与价值模型类似,但价值模型预测的是未来回报,而不只是最终答案正确的概率。
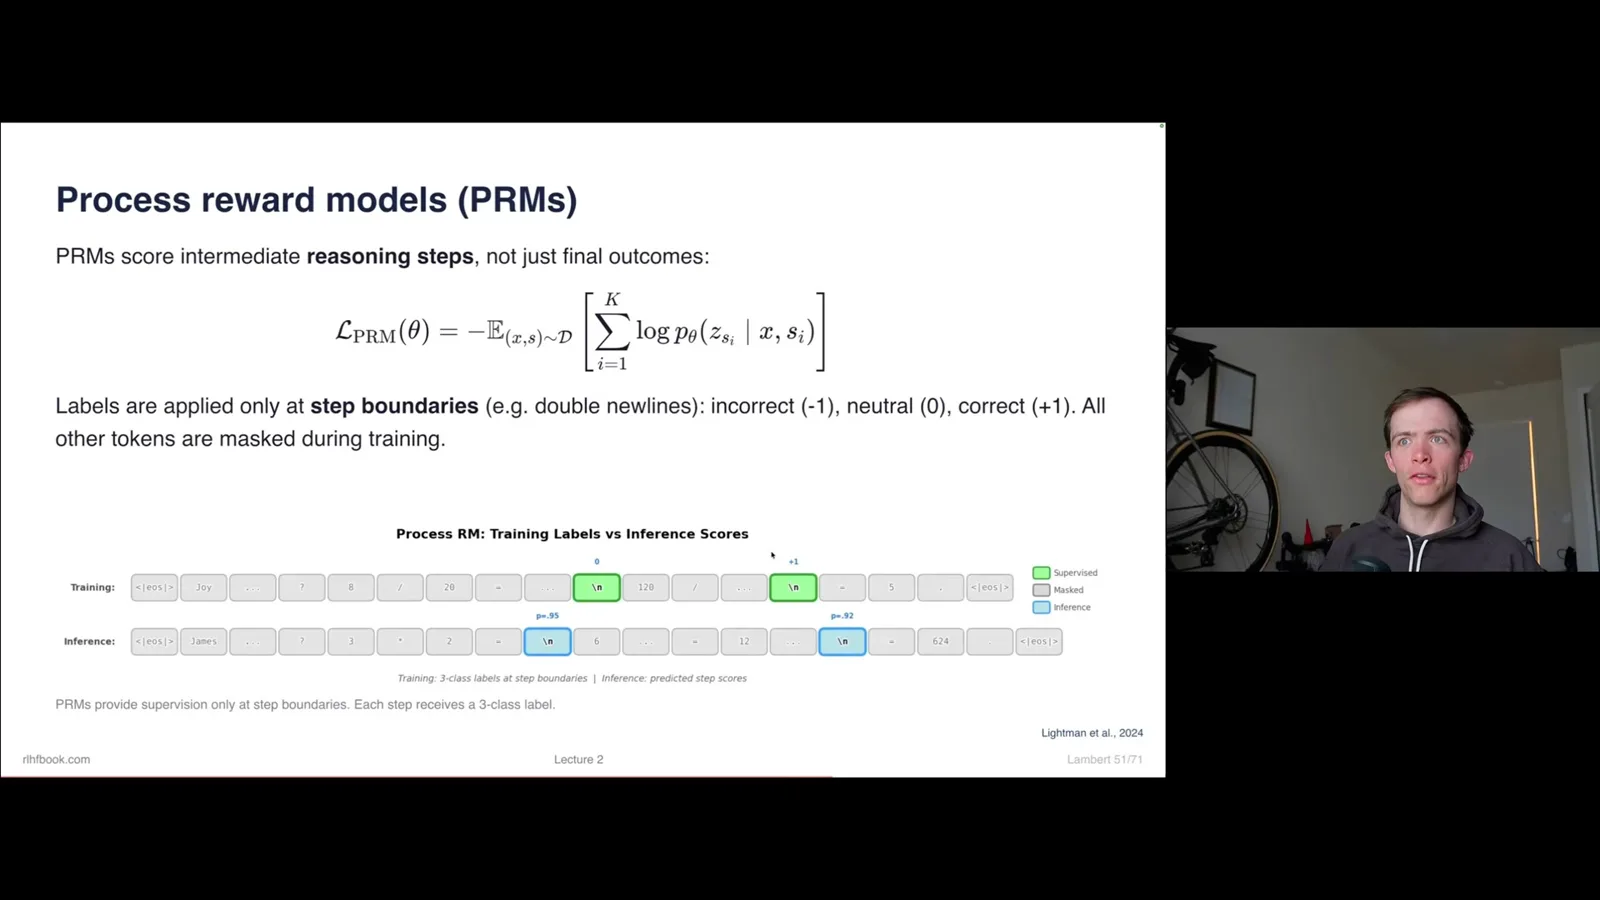
过程奖励模型为中间推理步骤评分。在讨论的例子中,标签区分好、中立和坏的步骤,损失应用于步骤边界。推理时模型估计中间过程的质量。
生成式语言模型评判器也可以用文本提供反馈。Lambert 认为这类评判器在筛选合成数据时非常有用,同时指出专用分类器在某些奖励模型基准上可能优于生成式评判器。
他参与构建了 RewardBench,但提醒说,奖励模型的基准表现与完整 RLHF 训练中的实用性之间,尚没有可靠对应关系。更好的评估仍是开放问题。
拒绝采样
高分生成回答成为监督训练数据。Best-of-n 则在推理时进行选择。
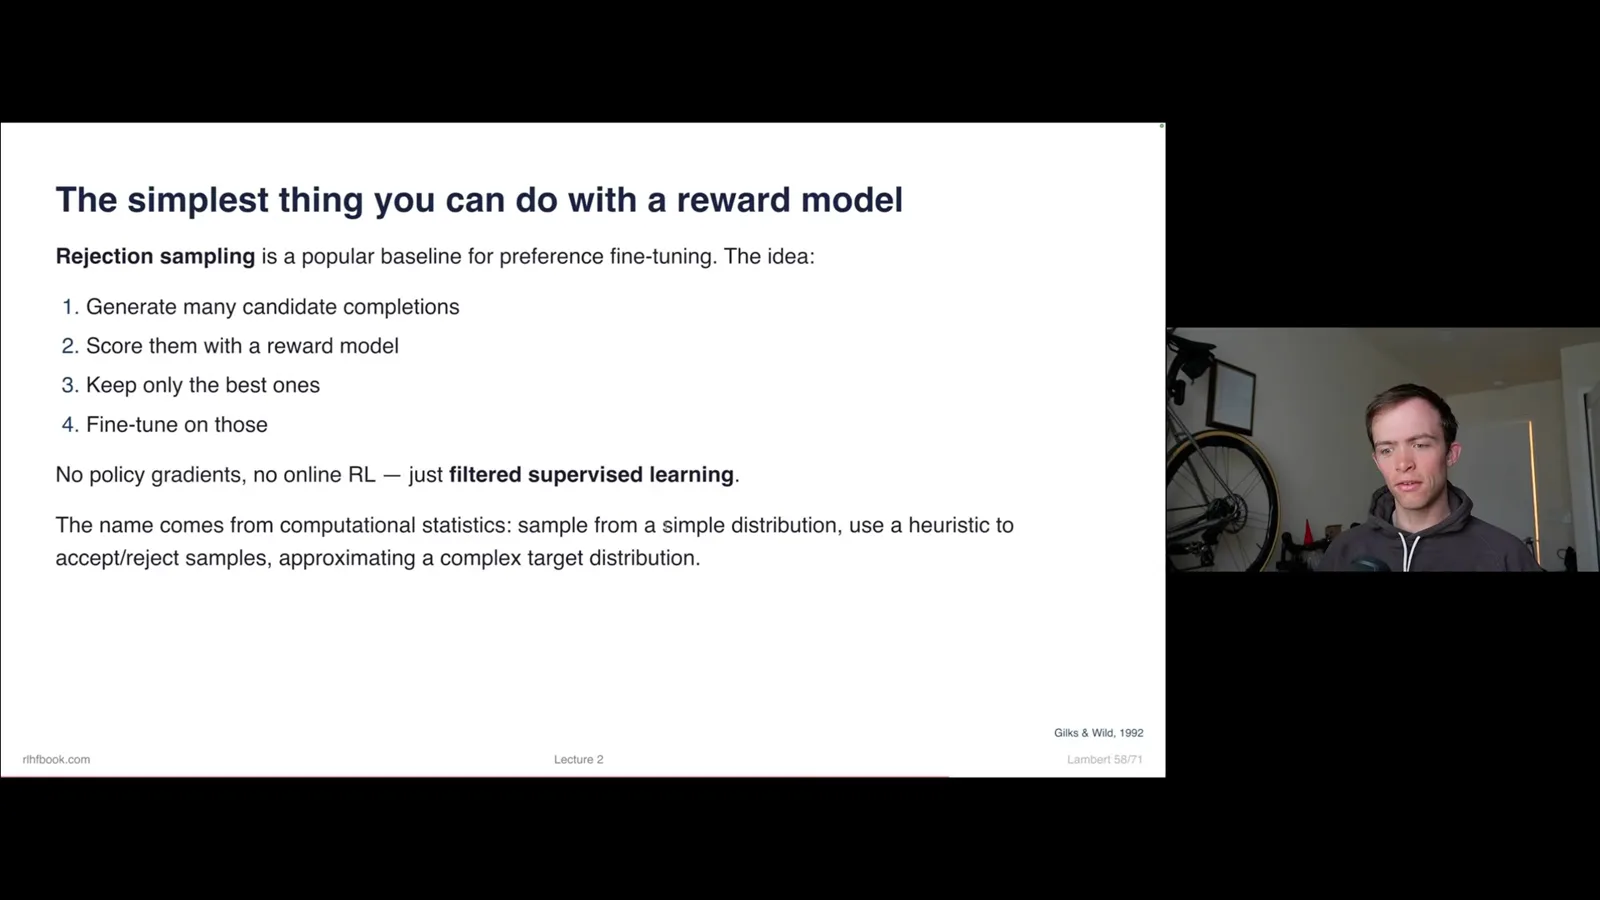
拒绝采样先生成多个回答,用奖励模型评分,保留高分回答,再用它们微调原模型。这是一种离线偏好训练基线,已用于多个知名模型方案。
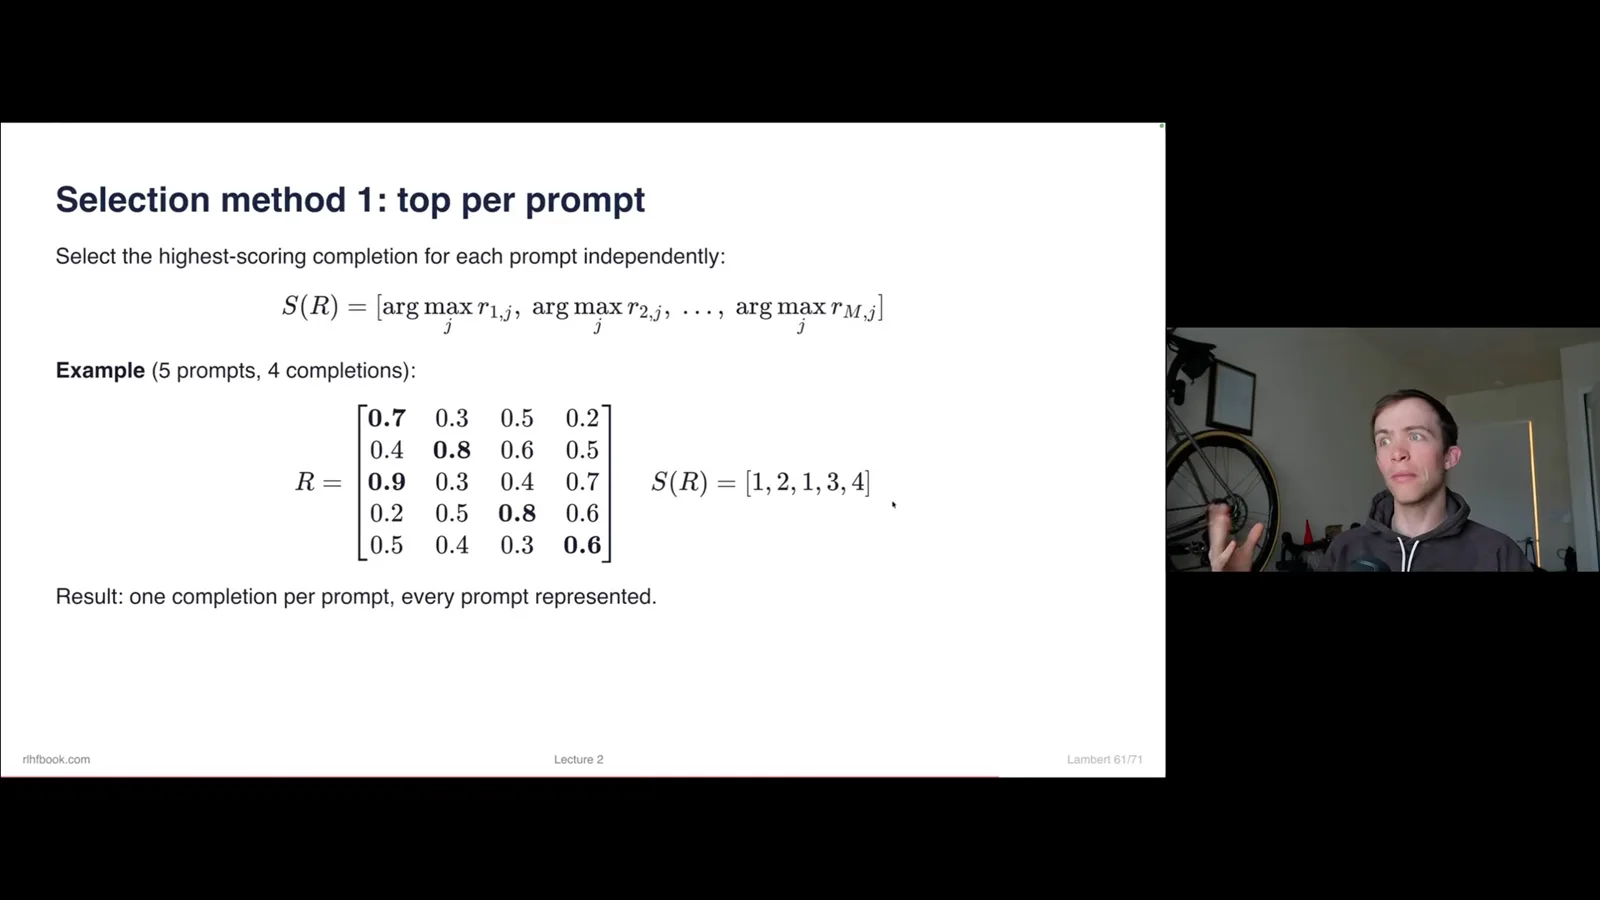
一种选择策略为每个提示保留最佳回答,从而保留提示词分布。另一种是在整个数据集中选择最高分的回答,这可能改变哪些提示得到保留。Lambert 认为其实际影响研究不足。
生成设置必须提供足够多样性,选择才有意义,这可能需要大量推理算力。批量奖励模型评分时,如果推理系统不能自动处理,可以按回答长度排序以减少填充。
Best-of-n 在推理时使用同样的生成与评分思路,但不使用选中回答进行微调。它为强化学习方法提供了简单的推理时比较基线。Lambert 最后呼吁对拒绝采样开展更多可复现研究。
同频道的其他文章
 16:48EN → 简体中文
 Nathan Lambert· 2026年11月2日Nathan Lambert:开放模型如何与前沿实验室竞争Nathan Lambert · Allen Institute for AI开放模型的用量正在增长,能力差距也在缩小,但开发者需要可持续的经济模式和价格之外的优势。
 48:04EN → 简体中文Nathan Lambert· 2026年10月26日Nathan Lambert:开放语言模型的历史、竞争与风险Nathan Lambert · Allen Institute for AI从开放权重、研究基础设施和蒸馏,到采用情况与模型开发者面临的选择。
 46:42EN → 简体中文Nathan Lambert· 2026年10月25日Nathan Lambert 与 Florian Brand 谈 Kimi K3.1、网络风险和 AI 智能体Nathan Lambert, Florian Brand · Allen Institute for AIInterconnects 主持人讨论模型评估的分歧、安全漏洞披露潮,以及个人智能体在日常生活中的作用。
 5:42EN → 简体中文Nathan Lambert· 2026年8月12日修格斯为何成了 AI 后训练的吉祥物Nathan Lambert · Allen Institute for AINathan Lambert 追溯了这种怪物从洛夫克拉夫特小说走向语言模型、微调与 RLHF 视觉隐喻的历程。
 32:56EN → 简体中文Nathan Lambert· 2026年8月6日Nathan Lambert:AI 角色训练入门Nathan Lambert · Allen Institute for AI从 constitution、model spec 到人格实验和激活引导,理解后训练如何塑造模型行为。
 32:11EN → 简体中文Nathan Lambert· 2026年8月5日Nathan Lambert:语言模型评估如何演变Nathan Lambert · Allen Institute for AI从少样本提示与 pass@k,到智能体沙箱、分数噪声和基准污染。