30 秒看懂
Dwarkesh Patel 介绍了他如何构建《血染钟楼》基准,让不同 AI 模型分别组成善恶阵营对抗。他展示了精彩对局,解释实验的局限,并讲述 AI 智能体如何协助开发游戏环境。
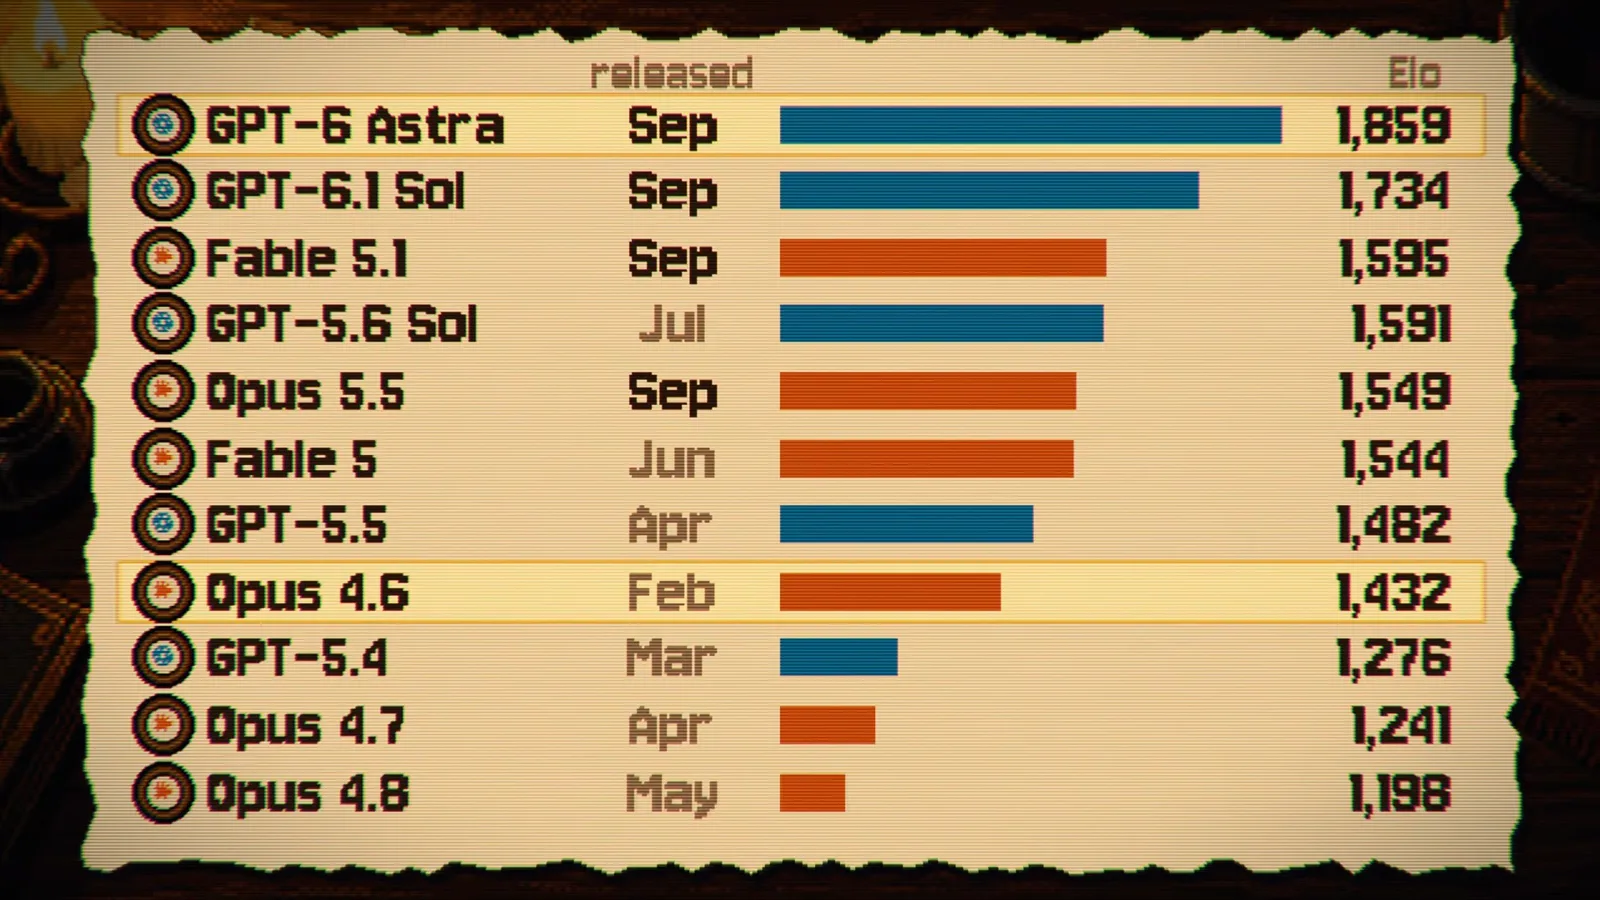
- 1特定游戏中的排名主要排名来自 368 局双方各由单一模型组成的对局;Elo 估计只描述这一设定。
- 2以牺牲换取信任邪恶爪牙主动被恶魔指认,让好人误以为恶魔是值得信任的调查员。
- 3误导性的射击失败能力遭禁用的杀手无法杀死恶魔;较强的队伍考虑到了中毒可能,而没有直接排除嫌疑。
- 4混合队伍的结果尚不确定约 130 局实验未能证明混合模型队伍有统计显著的优势。
- 5智能体协助构建测试Claude 修改环境并让智能体检查模拟对局,同时 Patel 提供人类判断。
要点建议
- 包含 368 局的排行榜衡量的是模型队伍在特定社交推理游戏中的表现,而非通用智能。
- 成功的欺骗可能需要牺牲队友,让恶魔获得好人信任。
- 更强的好人队伍会审视表面证据,而不是把单条线索视为定论。
- 规模较小的混合模型队伍实验未发现具有统计显著性的优势。
- AI 辅助迭代帮助构建了环境,但人为判断和预设概率仍会影响结果。
按章节阅读整理后的全文
游戏规则与策略挑战
Patel 解释规则以及善恶双方需要考虑的策略。基准考察协作、欺骗和对不确定证据的判断。
我很喜欢《血染钟楼》,这是一款类似狼人杀或黑手党的社交推理游戏。我让不同 AI 模型进行了数百场对抗,观察它们如何虚张声势、秘密协作、识破阴谋,以及开展长期推理。对局既展现了令人惊讶的计谋,也暴露了当前模型的局限。
玩家分为善恶两方,各自拥有特殊角色。邪恶玩家知道自己的队友和恶魔是谁,好人却不知道谁属于哪个阵营。白天大家投票处决一人,夜里恶魔秘密杀人。好人要在被消灭前处决恶魔,邪恶阵营则要抢先消灭村民。
邪恶方必须针对已公开的信息编造可信的故事,扭曲未来证据,并让恶魔避开怀疑。好人则要向信任的人分享信息,比较相互印证的线索,同时记住:他人的说法可能是假的,游戏机制也可能让诚实的观察产生误导。
因此,这款游戏可以测试智能体能否在反复盘问中维持一致的谎言,根据新证据调整故事,协调行动,甚至为了队伍牺牲自己。它也考察智能体能否在部分表面合作者暗中误导自己的情况下开展集体推理。
模型排名与两场精巧的骗局
368 局对抗构成 Elo 排行榜。Patel 讲述一名自我牺牲的爪牙,以及针对圣徒的陷阱。
我花了约 2 万美元的 API 额度构建基准并运行对局。主要排行榜包含 368 局,双方队员分别都是同一模型的副本。GPT-6 Astra 在这套特定设定中排名最高,比 Claude Opus 4.6 高约 430 个 Elo 分。我估算这一差距对应约 92% 的预期胜率;它并不是通用智能的衡量。
一场对局中,Astra 扮演邪恶方,对抗 Opus 5.5 的好人队伍。恶魔 Harper 假装自己是能发现邪恶玩家的好人角色调查员。一名死后仍能发挥作用的邪恶爪牙主动提议被指认:村民处决了他,真正的送葬者随后证实,他确实是男爵。
这个确认让 Harper 看起来像一名可信的调查员,尽管他本人就是恶魔。好人因此信任了他;他得以继续杀人,直到邪恶方获胜。爪牙用自己的性命换取了保护团队首领所需的可信度。
另一场对局中,Opus 5.5 扮演邪恶方,Opus 4.6 扮演好人。其中一名好人是圣徒:如果村民投票处决圣徒,邪恶方立即获胜。村民正确锁定了恶魔,但他们不知道一名邪恶爪牙有特殊能力:恶魔死后,她可以接替恶魔。
这名爪牙没有保护恶魔,而是支持处决他,并提出交易:如果处决后游戏没有结束,就把自称圣徒的人当骗子处决。圣徒相信游戏会结束,于是同意;恶魔临终前也配合设下陷阱。继任者让游戏继续,村民履行约定处决了真正的圣徒,邪恶方因此获胜。
为什么有些好人队伍更难被骗
杀手射击失败的例子说明,不能轻易把单条线索当成定论。玩家对恶魔身份的概率估计展现了推理过程。
在我的排行榜中,OpenAI 模型领先主要是因为它们扮演好人时表现更强。我发现它们更愿意质疑单条证据,并结合整场游戏的历史来判断。在这项评测中,GPT-5.4 到 GPT-6 Astra 的差距约为 580 个 Elo 分,对应两者对抗时约 97% 的预期胜率。
为了说明这一点,我让 Opus 5.5 和 GPT-6.1 用相同的角色分配对战两次,并交换阵营。两局中,杀手都射中了真正的恶魔,却没能杀死他,因为邪恶方前一晚禁用了杀手的能力。Claude 的好人队伍把射击失败当成无罪证明;GPT 队伍则考虑到中毒可能,最终处决了正确的恶魔。
每次投票前,我还私下要求好人玩家估计其他每位玩家是恶魔的概率。在这些对局中,随着证据积累,OpenAI 模型通常能更快、更准确地锁定真正的恶魔。这从另一个角度展示了进步,但结果仍只适用于所测试的基准和模型。
更强玩家与混合队伍
在所报告的实验中,邪恶胜率的小幅变化和混合模型队伍的结果都无法与随机波动区分。
如果所有玩家都变得更聪明,优势会偏向善良还是邪恶?双方变强时,邪恶方胜率似乎略有下降,但变化太小,无法与随机波动区分。我认为对手实力不断提高是这项评测的一个有用特征,尽管这不能证明游戏永远不会达到饱和。
我还试验了一支由一半 Opus 5.5、一半 GPT-5.6 Sol 组成的混合队伍,让它与强模型进行了约 130 局对抗。它的表现看起来略差于完全由其中任一模型组成的队伍,但差异没有统计显著性。实验规模有限,无法据此判定模型多样性是否有帮助。
借助 AI 构建基准
程序化概率表取代人类说书人的自由裁量。AI 智能体在人的判断指导下测试和修改环境。
人类说书人通常可以在模糊情况下自由裁量,有时会让结局更戏剧化。为了减少这种基准偏差,我用基于概率表的程序取代说书人。规则允许的结果仍可能发生,概率由人或 AI 设定,以近似有经验的说书人会作出的决定。这些设计选择仍可能影响结果。
大量 API 预算花在完善规则、私下交流和公开讨论的设计上。代码由 AI 编写,而我作为人类玩家提供判断,评估合理规则应该产生怎样的对局。Claude 还会修改环境、让多个模型进行游戏,再使用并行智能体检查记录,寻找不真实、不公平或不平衡的情况。
环境经历了 20 多轮修改;有时我在睡觉或处理本职工作时,几轮迭代已经完成。我认为,在参赛模型能力所限的范围内,结果能够稳定产生有趣而真实的对局。这一过程让我推测,AI 可能越来越擅长构建和改进强化学习环境,但这是我根据项目作出的推断。
后来我发现,另外一些人独立构建了《血染钟楼》基准,并在 LessWrong 上发表。他们用不同方式构建环境,也进行了不同实验,结果值得参考。我的代码还留下了许多开放问题。
还有哪些实验可以做
Patel 建议研究更多角色剧本、积累对局经验、混合模型队伍和人与 AI 对战。
一个扩展方向是加入其他角色组合,也就是不同剧本。我使用的是“暗流涌动”(Trouble Brewing),但游戏还有其他官方及玩家自制剧本。其中一个角色疯子是好人,却被告知自己是恶魔,因此玩家既要准备邪恶计划,也要考虑自己的身份可能受到误导。
另一个问题是智能体能否从经验中进步。除了训练数据和系统提示词提供的知识,它们基本上每局都从头开始。可以把过去十局的记录或总结放进上下文,比较有经验的模型与全新副本的 Elo;还可以研究一名更强的玩家能为队伍带来多少改善,以及善恶双方是否不同。
混合模型队伍也值得用更多模型和供应商开展系统研究。同模型队伍还可能出现一种风格识别捷径:玩家根据熟悉的写作风格推断谁是队友。我运行的对局中还没见过模型这样做,但未来的模型可能会。
最后,人们可以亲自与智能体对战,看看表现如何。在 clocktowerbench.com,你可以使用与 AI 玩家相同的界面和沟通渠道,也可以浏览它们的游戏记录。我计划在新模型发布后更新基准。这比我平时的视频随性一些,但制作过程很有趣。
同频道的其他文章
 1:01:10EN → 简体中文
 Dwarkesh Patel· 2026年10月30日播客 · 2 人对谈Robert Caro:权力、政治天才与一生的研究嘉宾 Robert Caro · 主持 Dwarkesh Patel这位传记作家谈 Robert Moses、Lyndon Johnson,以及研究权力如何运作的写作纪律。
 24:42EN → 简体中文Dwarkesh Patel· 2026年10月29日播客Dwarkesh Patel:Robert Caro 的政治权力课Robert Moses 和 Lyndon Johnson 的故事说明,机构、筹码与联盟如何让正式职权转化为持久的权力。
 1:09:00EN → 简体中文Dwarkesh Patel· 2026年10月22日播客 · 9 人对谈Dwarkesh Patel:2045 年的芯片会长什么样?嘉宾 Chris Auth, Kevin Fischer, Jack Kavalieros, Tyler Osborn, Pushkar Ranade, Gary Dickerson, Peter Wennink, Elon Musk · 主持 Dwarkesh Patel在 Intel 最先进的晶圆厂待了两天后,Dwarkesh Patel 讲清了 gate-all-around、背面供电、High-NA EUV、钌、CFET 和 hybrid bonding——并问 Intel 管理层:全球造芯设备跟不上的时候,行业怎么可能满足 AI 每年 3 倍的算力需求。
 1:37:23EN → 简体中文Dwarkesh Patel· 2026年10月1日播客 · 2 人对谈Si Sheppard 谈西班牙对阿兹特克与印加的征服嘉宾 Si Sheppard · 主持 Dwarkesh Patel讨论联盟、战争、疾病与殖民统治的长期后果。
 52:39EN → 简体中文Dwarkesh Patel· 2026年9月25日播客Sarah Paine:为什么战争难以结束一场讨论有限目标、升级、干预与常规战失败后抵抗的历史讲座。
 1:20:10EN → 简体中文Dwarkesh Patel· 2026年9月17日播客 · 2 人对谈Noam Brown 谈智能体群、研究加速与对齐嘉宾 Noam Brown · 主持 Dwarkesh Patel一场关于并行智能体、不确定的递归自我改进,以及如何评估更强系统的讨论。