30 秒看懂
Matthew Berman 介绍如何在较贵和较便宜的模型之间分配工作,并展示 token 成本示例与编程工作流。视频由 GenSpark 赞助;他还披露了对 Not Diamond 的投资。实际节省取决于价格、token 用量、质量以及额外审查或重试。
- 1规划与执行Berman 建议用较强模型研究和编写规格,用能力足够且更便宜的模型实现。
- 2审查循环他将生成的拉取请求交回较强模型审查,再把意见交给实现模型。
- 3成本假设示例假设规划使用 10 万输入和 2 万输出 token,编程使用 15 万输入和 12 万输出 token。
- 4示例节省按所述费率,规划加较便宜的编程共 3.02 美元,而全用较贵模型为 9.50 美元,约低 68%;未计审查和返工。
- 5手动与自动路由他展示在工具之间复制规格、命令行委派和第三方路由。
- 6超越编程他建议为知识工作选择模型和思考强度,并引用涉及默认设置、路由和缓存的公司示例。
要点建议
- 较强模型可以规划或审查,另一个模型则实现足够详细的规格。
- 在示例 API 假设下,路由将估算成本从 9.50 美元降至 3.02 美元,约节省 68%,尚未计入额外审查或重试。
- 订阅额度不一定能直接换算成 API token 价格。
- 应在自己的任务上比较质量和总成本,不要假定一定能达到某个节省比例。
- Berman 披露了 GenSpark 赞助及其对 Not Diamond 的投资。
按章节阅读整理后的全文
规划、编程与审查
Berman 介绍模型路由,并将编程任务分为研究、规格、实现和审查。
模型路由就是为每项任务选择合适的模型。我用它减少 AI 支出,尤其是在项目不同阶段需要不同能力时。标题所说的节省幅度因情况而异:应衡量包括重试、审查和质量差异在内的完整工作流。
我将规划与执行分开。规划涉及理解代码库、决定功能如何融入现有系统,以及编写架构或规格。我倾向于用较强模型完成这些工作;更便宜的模型可能足以实现清晰的计划,不过困难的实现仍可能需要更强模型。
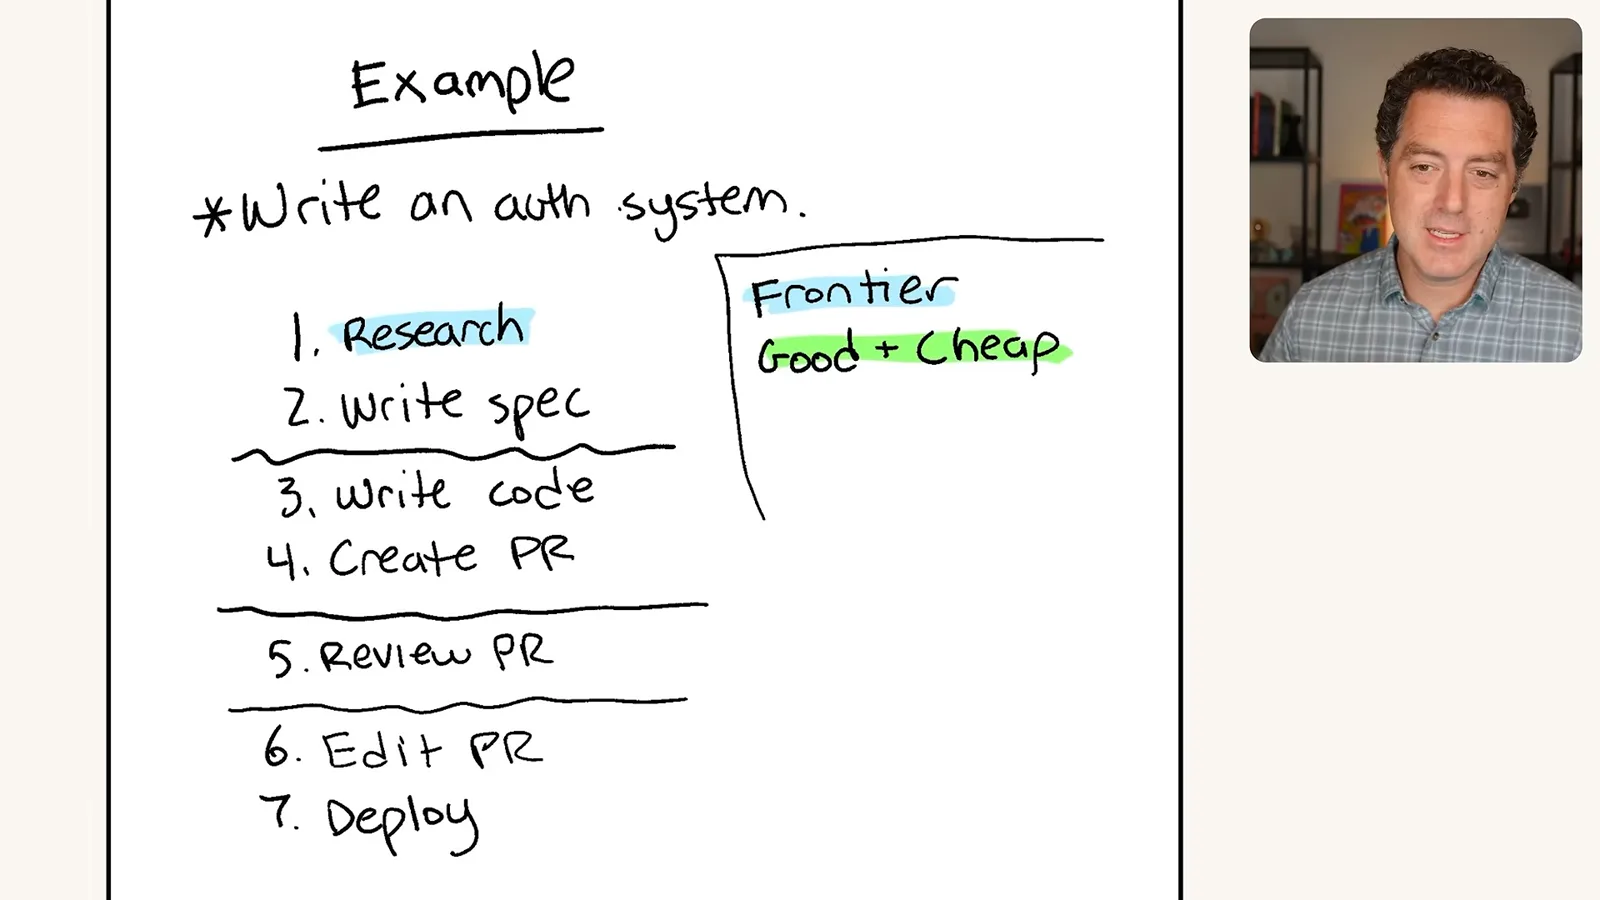
我的工作流从研究和提问开始,接着编写详细规格。我把规格交给编程模型,让它创建拉取请求。可选的一步是让较强模型审查请求,把反馈交给编程模型,并在工作准备就绪后部署。
视频由 GenSpark 赞助,Berman 将它介绍为整合写作、设计、代码和媒体工具的 AI 工作区。推广条款和产品可用情况以视频发布时的描述为准。
token 成本示例
他计算一种较贵模型的示例成本,并与将实现路由给较便宜模型的方案比较。
在一个 API 费用示例中,我假设较贵模型每百万输入 token 10 美元、每百万输出 token 50 美元;较便宜模型分别为 2 美元和 6 美元。这些只是示例假设,不保证代表当前价格或订阅额度消耗。
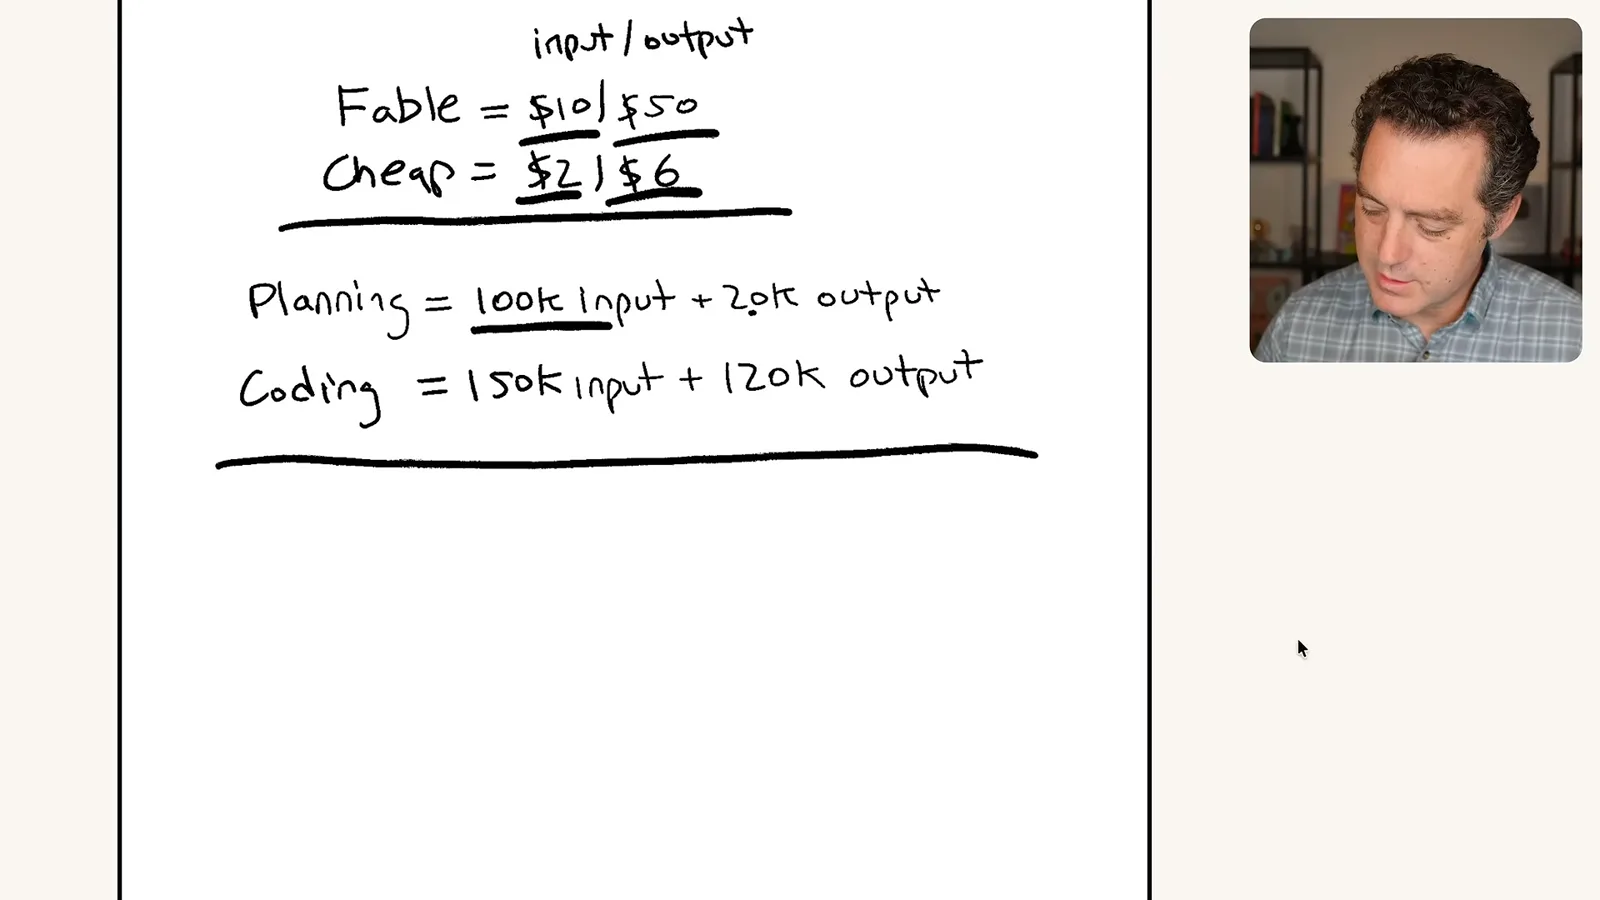
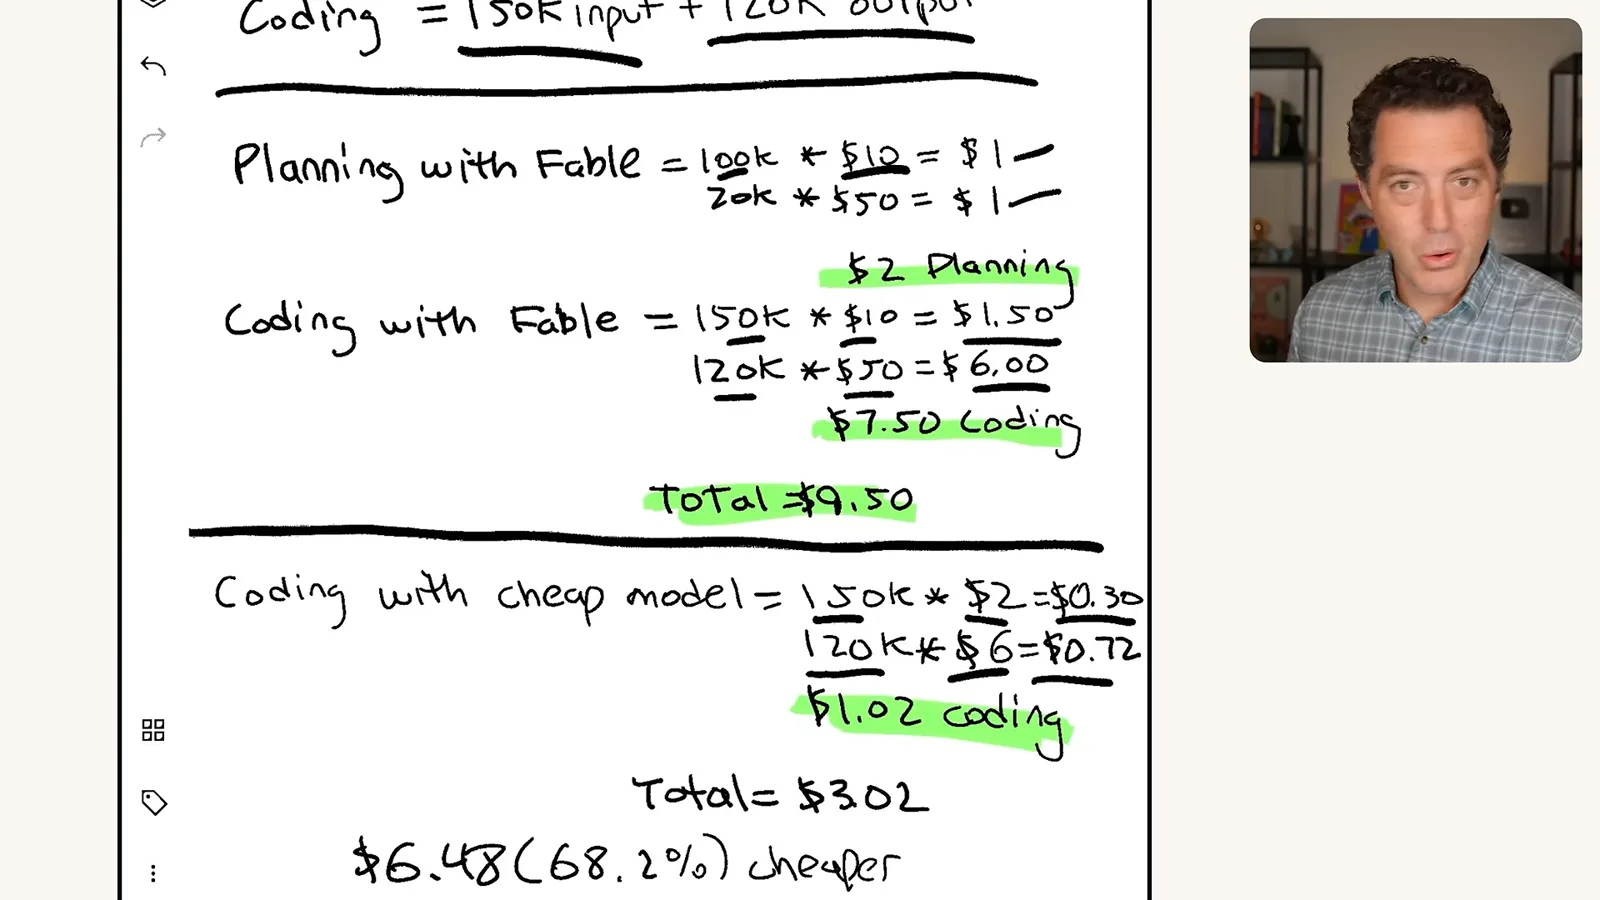
示例假设规划使用 10 万输入和 2 万输出 token。按较贵费率,输入和输出各花 1 美元,共 2 美元。编程使用 15 万输入和 12 万输出 token;按同样费率分别花 1.50 和 6 美元,总成本为 9.50 美元。
如果编程使用相同 token 数但改用较便宜费率,输入为 0.30 美元,输出为 0.72 美元。编程共 1.02 美元,规划加编程为 3.02 美元。差额是 6.48 美元,在此例中约节省 68%,并非开头提到的超过 90%。计算没有包含可选审查、失败尝试或返工。
实际路由工作流
他演示手动复制、命令行委派和第三方自动路由,并披露对一家路由公司的投资。
一种手动做法是在一个工具中制定规格,复制到另一个编程工具,之后再将审查意见复制回实现者。我展示了一个实现过程运行约一小时并生成拉取请求的例子。最终是否省钱取决于实际工作和计费模式。
我还演示了一个技能,让命令行智能体规划并委派另一个智能体编程。一些第三方编程环境提供自动模型选择;它们的路由逻辑和可用模型各不相同。应核实所使用工具和版本的行为与权限。
我提到专注路由的 Not Diamond,并披露自己是小额投资者。我也讨论文档和电子表格的路由:选择适合任务的模型和思考强度,然后评估输出,而不是总选最贵的模型。
知识工作与企业规模
Berman 讨论编程之外的模型和思考强度选择,以及默认设置、路由和缓存对企业支出的影响。
在企业规模上,我提到 Coinbase 通过更便宜的默认模型、路由、缓存和上下文管理控制 AI 成本的例子。我对不同阶段分别使用什么模型进行了推测,因此不能将这种分工视为已证实。核心是与现实基线比较质量和总支出。
同频道的其他文章
 25:50EN → 简体中文
 32:20EN → 简体中文
 45:08EN → 简体中文
 0:32EN → 简体中文
 12:14EN → 简体中文
 10:36EN → 简体中文