30 秒看懂
Matthew Berman 比较视频录制时使用 DeepSeek R1 或其蒸馏版本的方式。他演示托管聊天、Groq 和本地推理,解释模型规模与量化,并披露自己对 Groq 和 LM Studio 的投资。
- 1托管聊天演示在 DeepSeek 界面中选择 DeepThink(R1)。
- 2Groq 蒸馏版托管的 Llama 70B 蒸馏模型并非完整 R1。
- 3选择本地文件量化需要在内存使用和潜在模型质量之间权衡。
- 4本地推理Berman 加载 8B 蒸馏版,并展示特定硬件上的速度。
要点建议
- DeepSeek 托管聊天与托管的 R1 蒸馏版是不同选择。
- 蒸馏模型并非完整的 DeepSeek R1 模型。
- 本地模型规模和量化方式决定内存需求与性能。
- 托管服务和本地配置的数据处理方式有所不同。
- 展示的速度只是特定硬件和服务下的示例。
按章节阅读整理后的全文
托管选项
Berman 展示 DeepSeek 聊天和 Groq 上的蒸馏模型。他讨论隐私并披露投资关系。
我演示三种体验 DeepSeek R1 的方式:DeepSeek 托管聊天、由 Groq 托管的蒸馏模型,以及在 LM Studio 中运行的本地蒸馏模型。这里展示的界面和模型可用性反映视频录制时的情况。
在 DeepSeek 聊天界面中,我选择 DeepThink(R1);界面还提供网页搜索。托管服务会收到发送给它们的信息,因此我建议观众选择服务商前考虑隐私。视频没有证明任何政府或第三方如何处理某位用户的提示词。
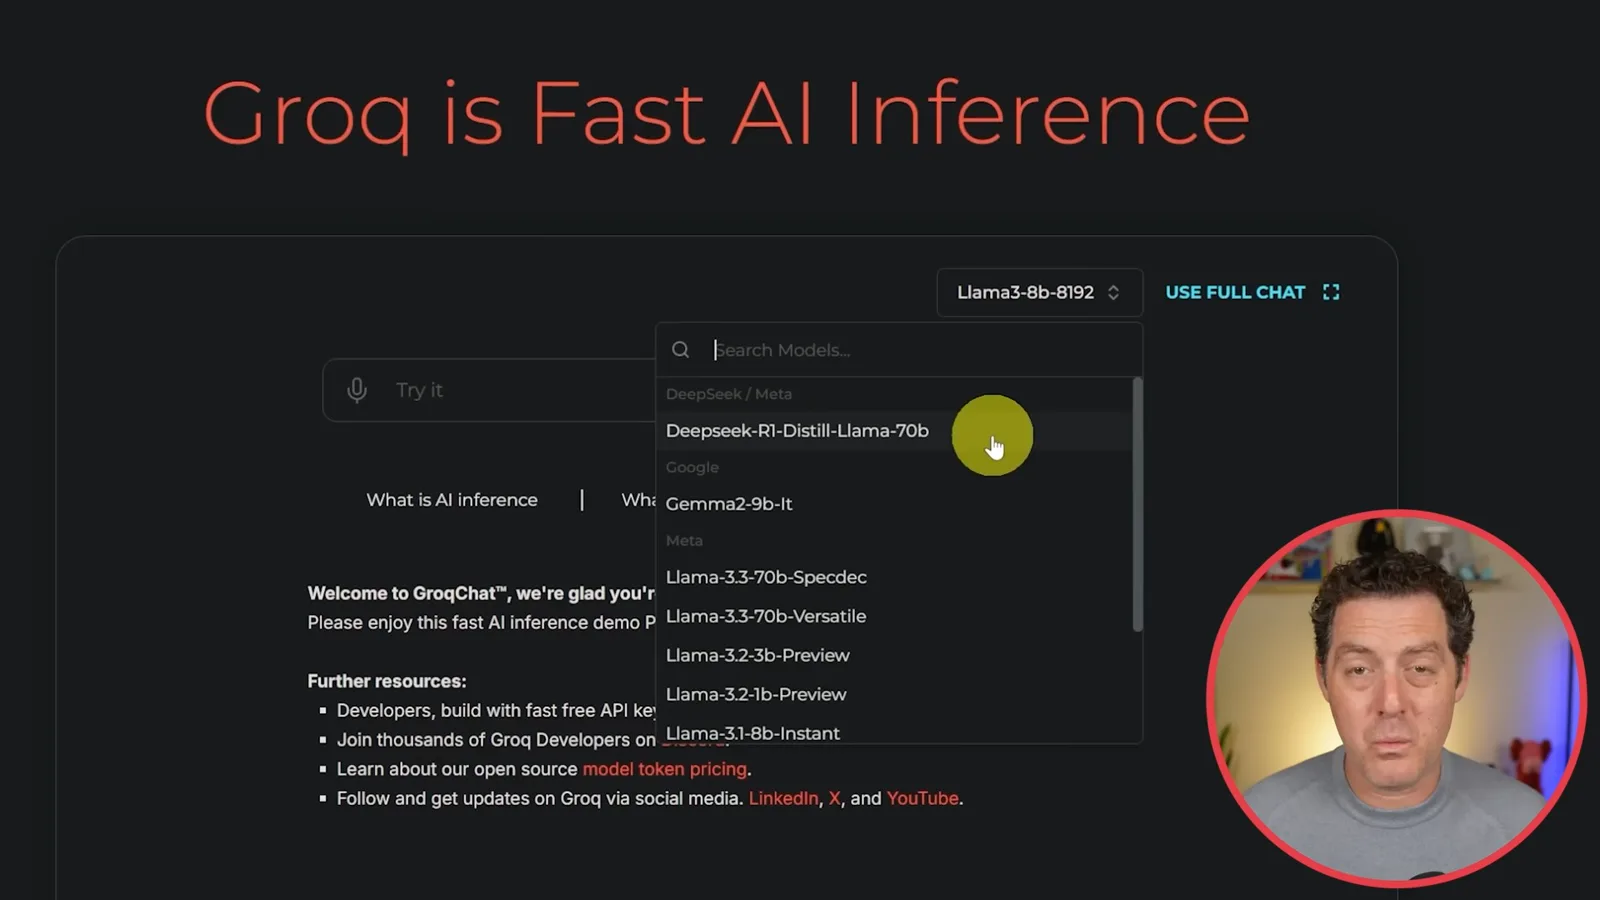
在 Groq 上,我选择 DeepSeek-R1-Distill-Llama-70B。这是蒸馏模型,并非完整的 R1。在我的俄罗斯方块编程示例中,显示速度达到约每秒 275 个 token。我披露自己是 Groq 的小额投资者。
本地运行蒸馏模型
他使用 LM Studio 查找、下载并加载量化模型,同时说明硬件需求及对该公司的投资。
本地推理方面,我使用 LM Studio,也披露自己对这家公司有小额投资。安装后,打开发现页面并搜索 DeepSeek。与需要大量硬件的完整 R1 相比,较小的蒸馏版本更适合个人设备。
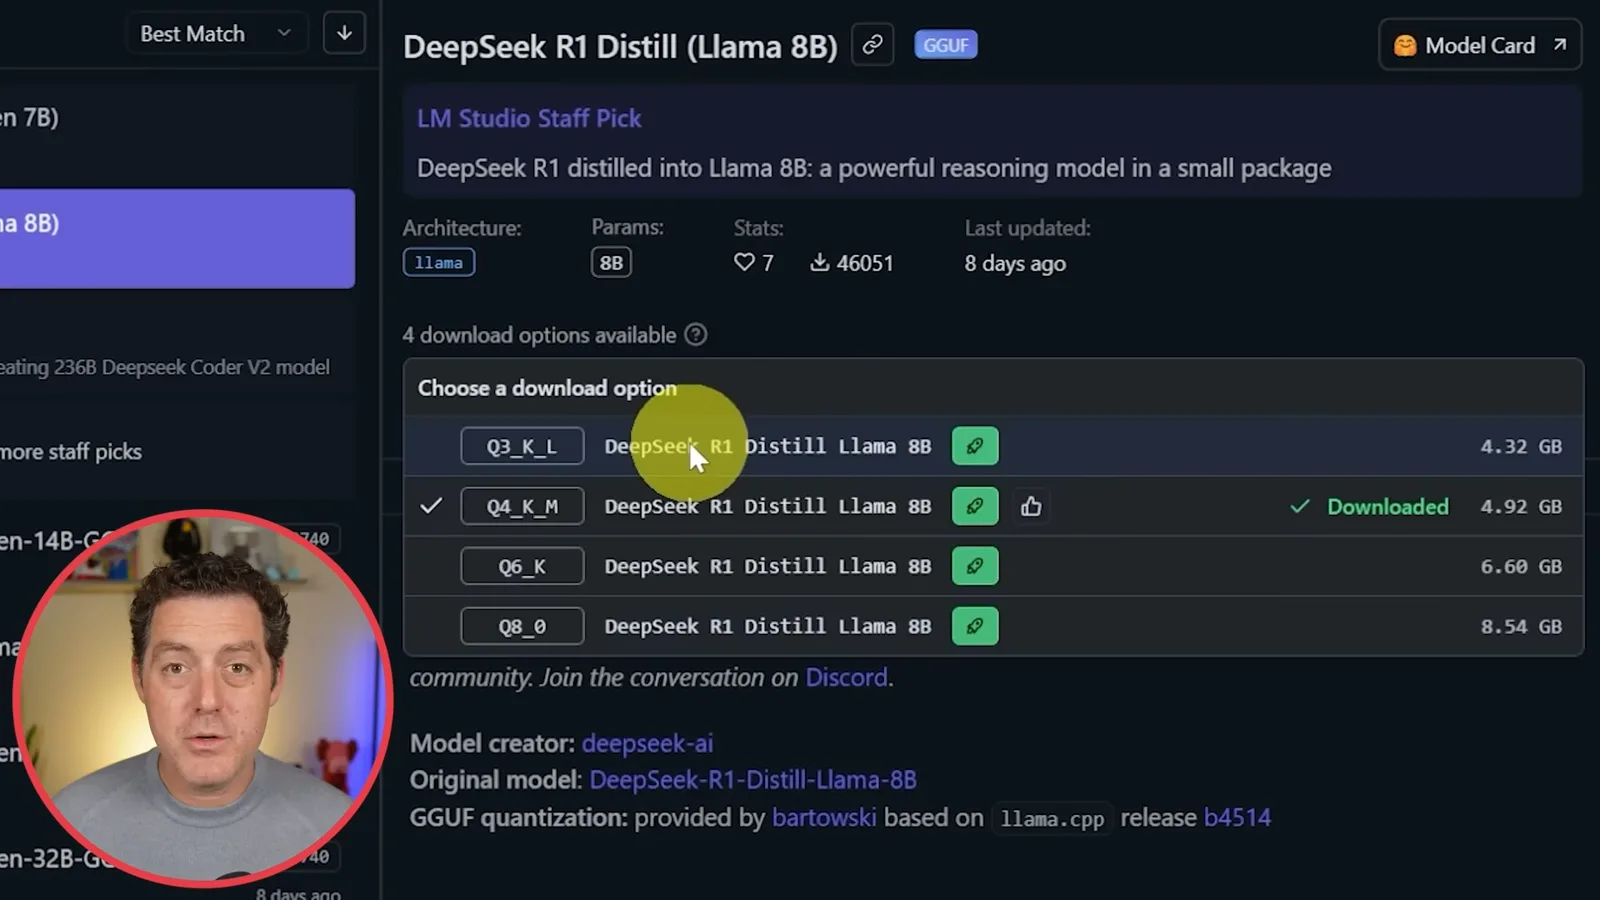
下载菜单提供不同的量化版本。较高位数的版本通常需要更多内存,也可能保留更多质量;我常选 Q4_K_M。LM Studio 会显示模型是否能够卸载到 GPU,帮助你选择适合自己硬件的文件。
下载后选择并加载模型。我在配有高端 GPU 的机器上演示 8B Llama 蒸馏版,并要求它用 Python 编写贪吃蛇;显示速度约为每秒 77 个 token。实际结果取决于模型、量化方式和硬件。
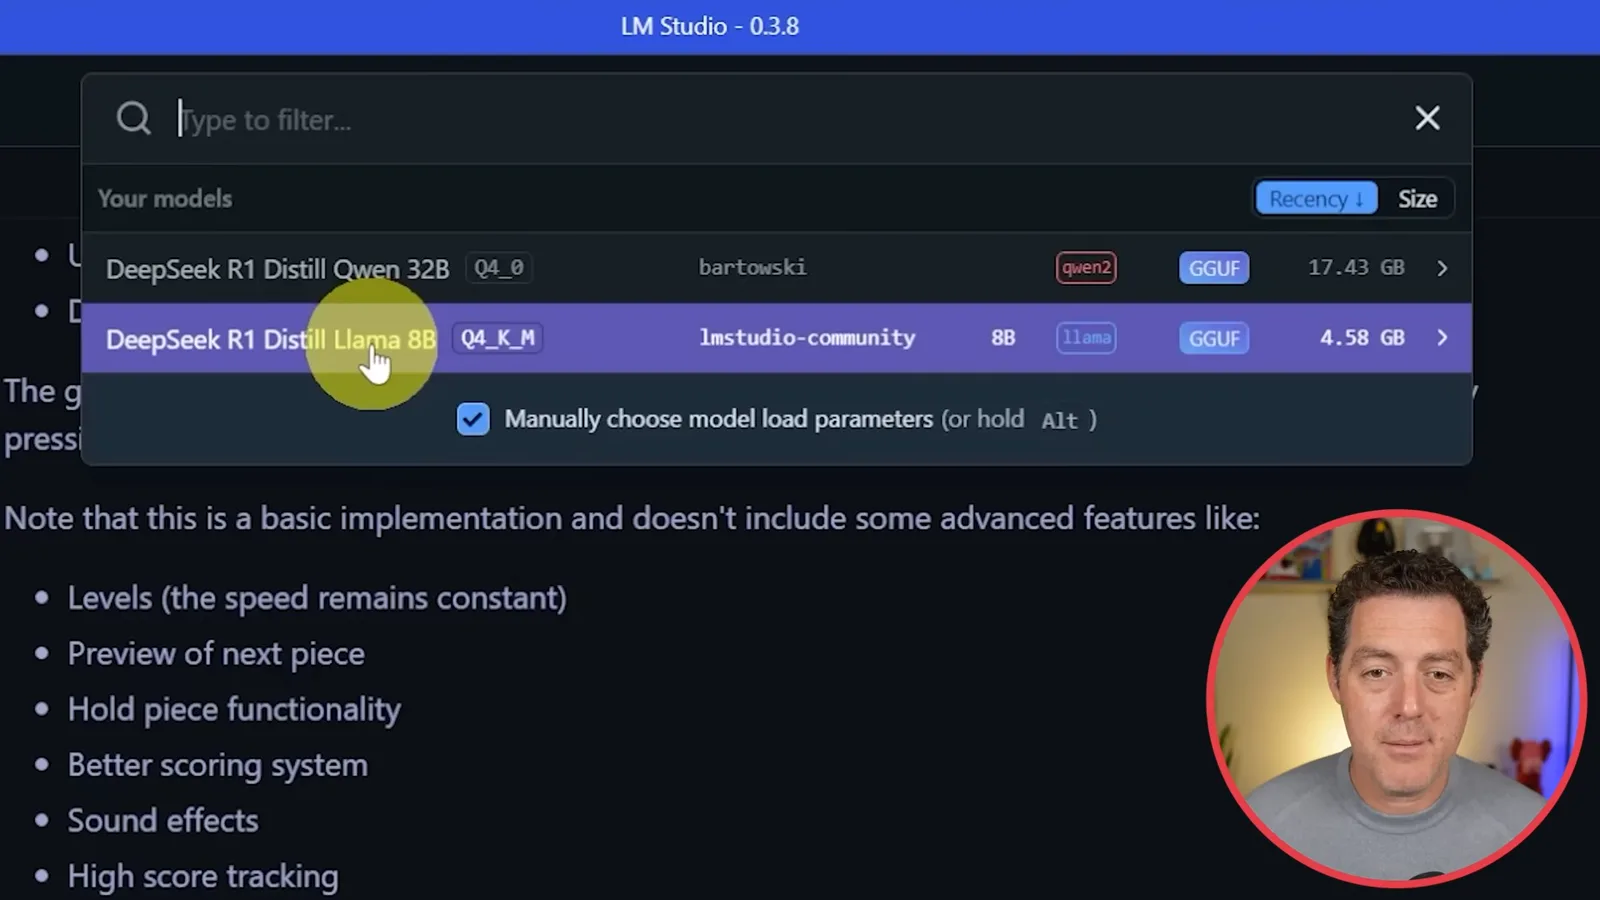
用户可以在托管服务与本地推理之间选择,两者在性能和数据处理上各有差异。配置为本地执行时,提示词可以保留在机器上,但应用程序和连接的功能仍会影响数据处理。我还提到 Ollama 是另一种本地选择。
同频道的其他文章
 25:50EN → 简体中文
 32:20EN → 简体中文
 45:08EN → 简体中文
 0:32EN → 简体中文
 12:14EN → 简体中文
 10:36EN → 简体中文