30 秒看懂
测序成本下降带来了更多患者和细胞数据,但从模型预测走到治疗仍面临实验与临床挑战。在 YC Paper Club,Alfredo Gonzalez 介绍如何利用患者个体分子证据支持临床医生;Yusuf Roohani 讨论虚拟细胞和数据缺口;Garyk Brixi 解释 DNA 模型能学到什么;Divya Nori 展示一种少样本设计方法,并介绍在小鼠脑部进行的实验。一些结果仍是计算预测,个体患者案例和动物实验也不能证明已找到普遍适用的癌症疗法。
- 1测序成本下降让每位患者的数据更加丰富Gonzalez 讨论如何结合肿瘤基因组、表达和患者信息,为个体研究提供依据。
- 2治疗决定仍由临床医生作出Gonzalez 说,研究人员必须以有用的形式传递证据;安排个体临床试验则是另一项挑战。
- 3虚拟细胞试图预测单个分子之外的影响Roohani 介绍细胞状态和可能干预的映射,同时强调细胞动态变化、难以建模。
- 4五亿条公开细胞记录仍存在重大缺口Roohani 说,收集的数据中过度集中于免疫细胞,尤其是 T 细胞;他提出用模型指导有针对性的实验。
- 5DNA 模型的训练数据组合会改变基准表现Brixi 介绍 Evo 2 经过筛选的九万亿碱基数据集,以及它对突变影响的预测。
- 6基因组模型可利用少量示例,无须针对任务单独微调Nori 展示多个设计任务中的候选序列,以及在小鼠脑部测试的后训练增强子。
要点建议
- 患者个体分子分析可以为临床决策提供证据,但负责治疗的临床医生仍需作出决定。
- 虚拟细胞需要模拟动态生物状态,并与有噪声的实际实验进行比较。
- 更多细胞数据不一定意味着更多样:公开数据可能集中于少数细胞类型。
- DNA 模型的表现高度依赖训练数据的组成和评估预测的方法。
- 少样本提示可以提出生物设计方案;计算预测和动物实验仍需进一步验证。
按章节阅读整理后的全文
为什么研究 AI 与生物学
主持人介绍测序成本下降以及迭代实验的可能性。四位讲者分别介绍研究和临床应用。
主持人先进行一场人类与 AI 聊天的现场实验。有些观众互相配对,另一些则与智能体聊天;约三分之一的人类参与者被误认为 AI。主持人将它作为非正式实验展示,并非受控的科学测试。
介绍 AI 生物学时,主持人提到测序成本下降、数据集扩大、蛋白质设计研究和实验反馈循环。四位讲者将从不同角度讨论癌症数据、细胞和基因组模型。
用患者个体数据支持癌症护理
Alfredo Gonzalez 介绍个体分子分析与临床医生合作。观众提问涉及类器官、治疗获取和安全性。
Alfredo Gonzalez 说,他的工作旨在围绕患者自身的癌症建立个体化研究流程。他曾从事癌症生物信息学、肿瘤基因组分析和癌细胞系筛选工作。
他认为,测序成本下降让人们能够生成更多分子数据。过去的癌症研究通常汇总规模相对较小的患者队列中的共同模式;他希望同时研究单个患者。
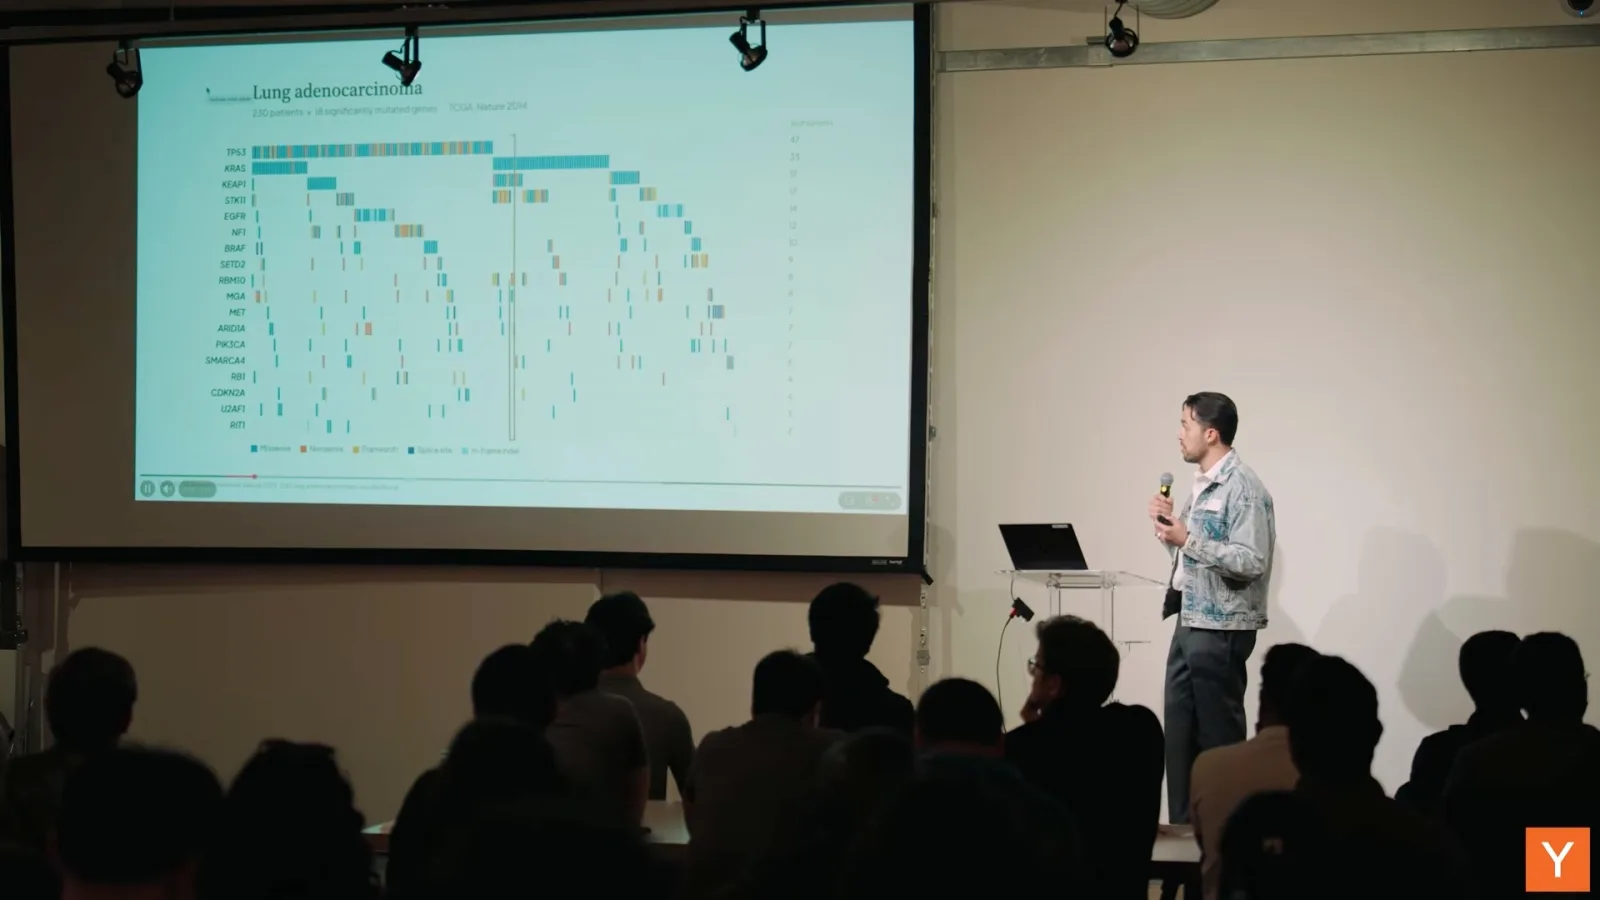
一位患者的数据可以包括数千个基因、拷贝数变化、RNA 表达、细胞状态和个人背景。Gonzalez 关心如何综合这些测量,而不是只依赖少数常见突变基因。
他提出由智能体辅助的研究流程,将计算分析、证据、临床试验信息和安全考量结合起来,目标是帮助小团队更快研究具体病例。
Gonzalez 介绍一个罕见脑肿瘤病例:分子比较显示它与其他分类中的肿瘤有相似之处。他说,在文献能提供的指导有限时,团队利用相关通路和表面标记研究可能的治疗方向。
在另一个病例中,他说团队通过分析不同时期的样本重新审视了既往治疗,并找到另一个方向。他展示的是个体患者经历,而非对治疗结果的受控比较。
展望未来,Gonzalez 预计蛋白质和递送系统的设计会加快,并讨论了 AI 辅助研究工具。他将这些描述为缩短发现周期的未来可能性,而不是已适用于每位患者的成熟方法。
一位观众问,患者个体类器官能否规模化。Gonzalez 说,培养组织和测试扰动在技术上可能可行,但医院常规组织处理方式可能导致材料不再适合培养类器官。
被问及研究发现如何真正帮助患者时,他说临床医生仍负责治疗,需要容易理解的证据材料。安排个体临床试验是另一项困难任务;已有疗法可能提供更直接的路径。
对于逆转恶性肿瘤的问题,Gonzalez 说他不了解提问中那家公司的具体主张,希望看到清晰的定义和更长期的患者结果数据。
谈到安全性时,他区分了涉及已知安全特征疗法的分析与从头设计新干预。他讨论了后者可借鉴剂量递增等临床试验方法,并表示患者安全是核心。
通过有针对性的实验构建虚拟细胞
Yusuf Roohani 解释细胞表示、数据不平衡和自主研究。他展示的分子设计结果是计算结果,仍需实验室验证。
Yusuf Roohani 将虚拟细胞与自主研究结合介绍。他把生物发现视作在大量假设中搜索,并说计算模型可以帮助研究人员在花费实验室时间和资金之前确定实验优先级。
蛋白质和 DNA 模型工作在分子层面。虚拟细胞则试图表示由许多分子组成、持续变化的系统,并最终模拟与疾病有关的细胞、组织或生物体行为。
在设想中的映射里,健康和患病细胞状态处于不同区域,干预可能使细胞在状态之间移动。Roohani 说,找到有效靶点和预测人体疗效仍然困难。
他介绍了一种通用细胞嵌入模型,输入是细胞与基因表达矩阵。模型遮盖部分测量值并学习预测它们,从而形成共享表示,而不需要训练时为每种细胞类型都提供标签。
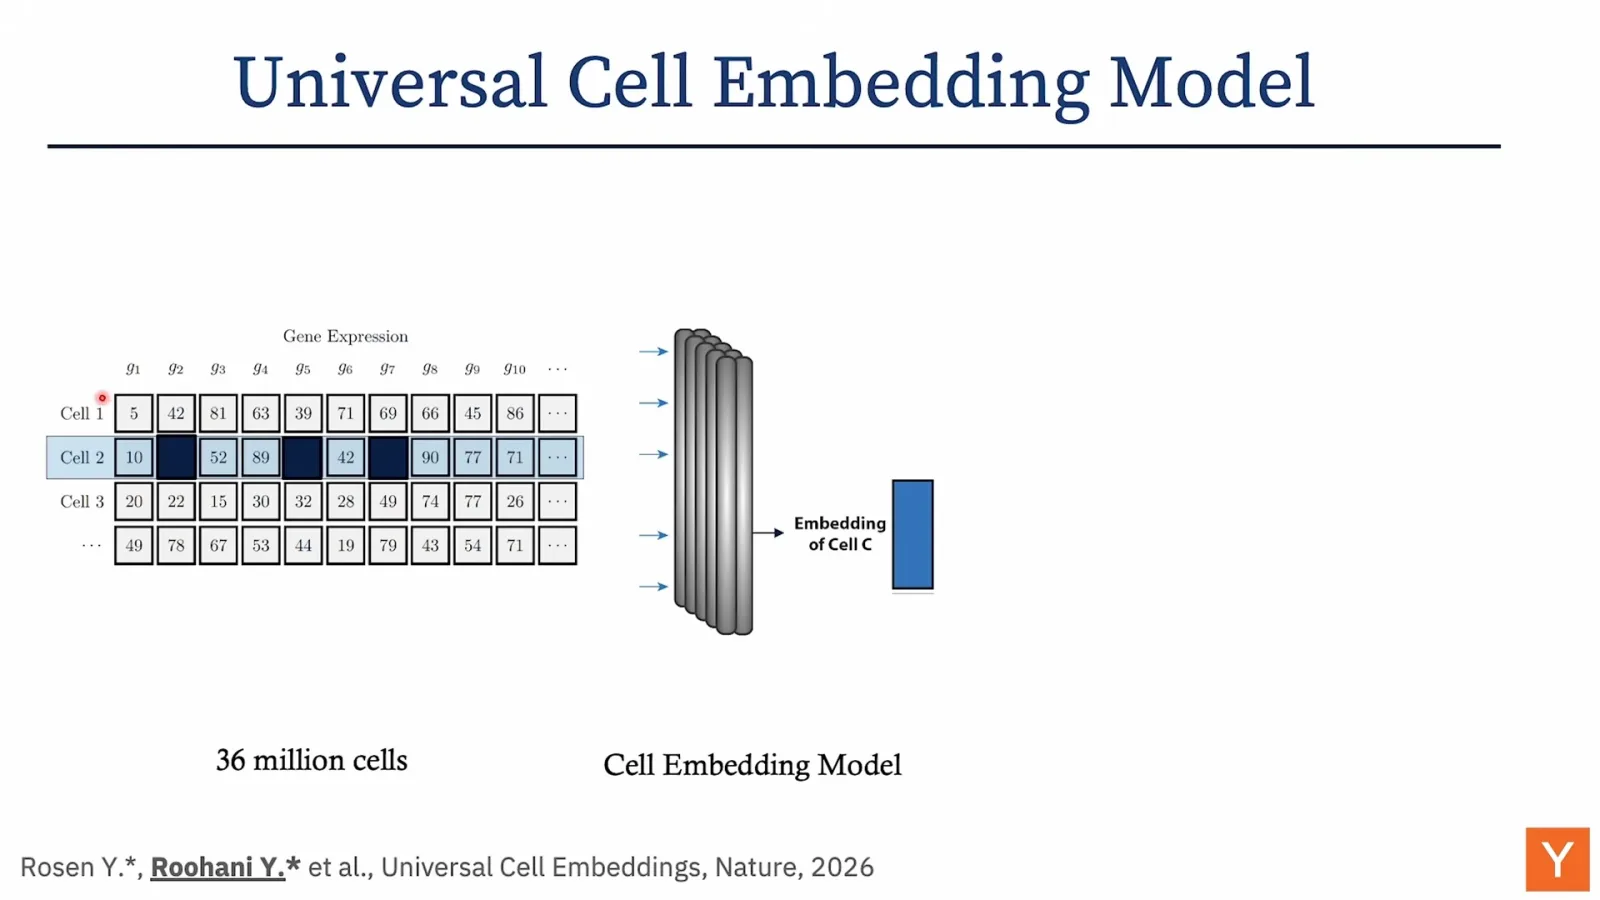
一个用约 3500 万个细胞训练的表示呈现出与已知生物学中宽泛及细分细胞类型相对应的聚类。Roohani 将其联系到细胞状态受到约束、并非任意状态都可能出现的观点。
团队使用智能体重新处理公开转录组记录,将规模从约 3600 万扩大到超过 5 亿个细胞。检查结果后发现明显不平衡:免疫细胞,尤其是 T 细胞,占比过高。
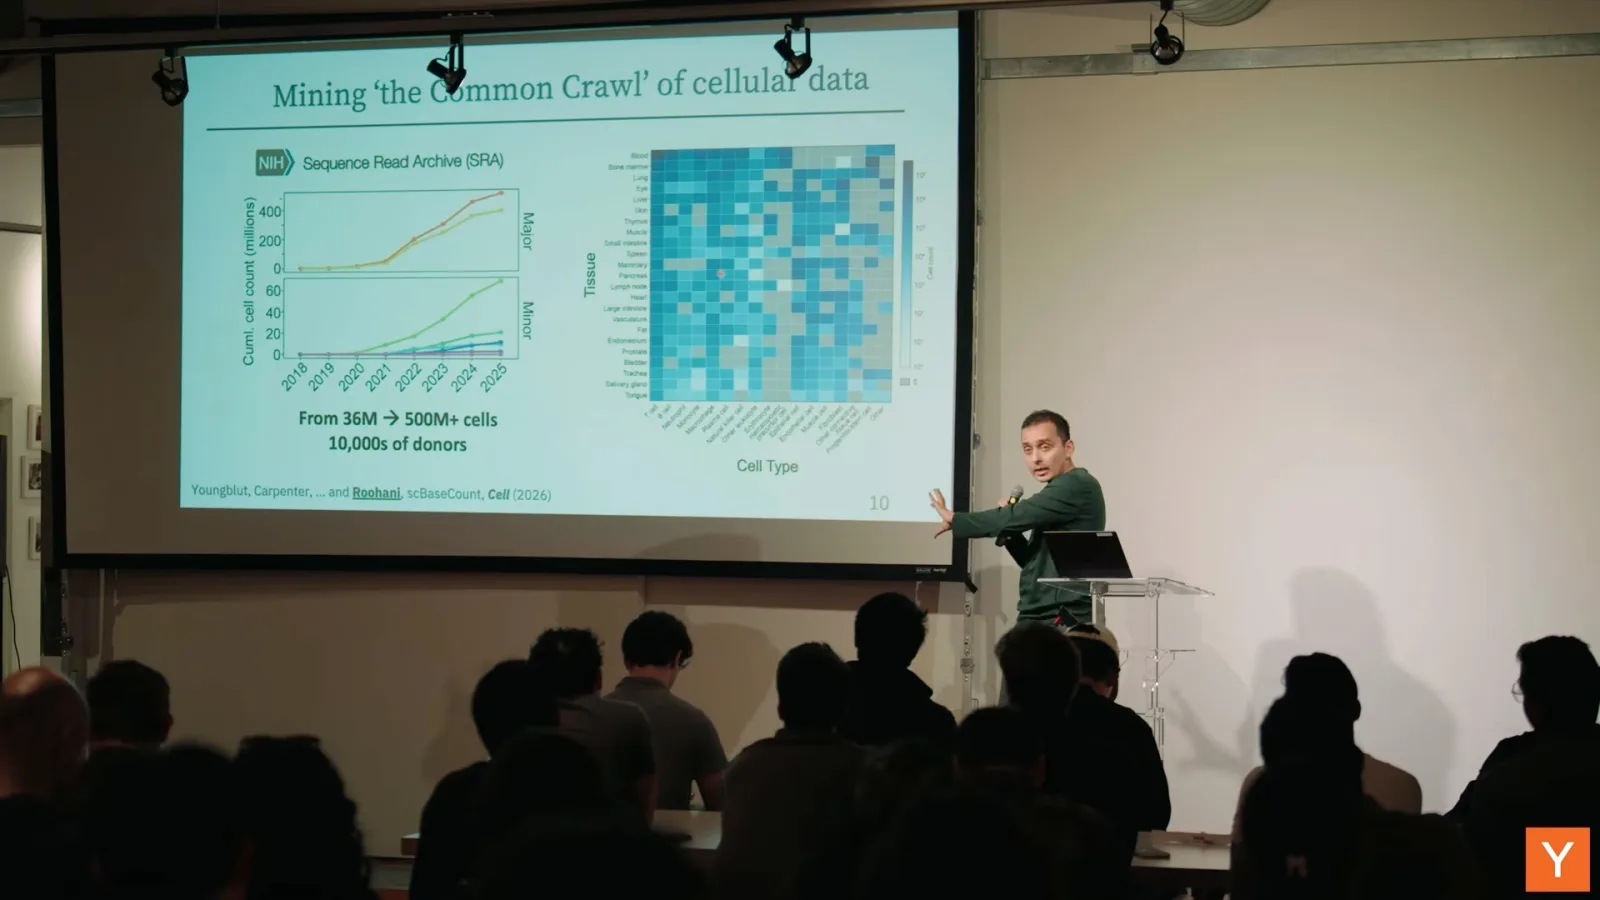
记录数量增加本身并不能保证覆盖足够多的生物类型。Roohani 提议建立循环,让模型帮助决定做哪些实验,使实际数据生成针对具体问题和数据缺口。
他将此与自动化机器学习研究相比较:两者都涉及昂贵实验、有噪声的评估和庞大搜索空间。实际区别是生物实验可能让每个反馈周期更慢、成本更高。
他说,在自己所在的研究初创公司,名为 Locus 的系统从自动化 AI 研究扩展到分子预测和设计。团队比较了可用研究算力增加时的表现。
Roohani 报告,在分子结合预测和生成搜索方面,该系统的计算结果优于所比较的智能体。他明确说,这些是计算机模拟结果,仍需实验室验证。
科学研究常常只有小规模、带噪声的验证集。团队还测试了系统在这一限制下能否获得有用结果,长期目标是将计算提出的方案连接到实体实验室。
在问答中,Roohani 说评估目标是复现实际测量,但即使条件相似,细胞也会波动。他强调,设计研究智能体时要考虑实验成本、长期研究过程和进度监控。
他澄清,比较测量的是实验使用的 GPU 算力,各系统在相同沙箱中工作,并不是对其他公司内部算力的判断。语言模型的词元成本也影响总成本。
被问及改进外围运行框架与改变模型权重的取舍时,他说在后训练之前,研究智能体框架本身就有不少改进空间。他的团队偏向通用方案,但认为两种方法都有作用。
训练基因组模型用于预测与发现
Garyk Brixi 介绍 Evo 2 的数据、架构、突变预测与内部特征,并讨论取舍和未解问题。
Garyk Brixi 提问:模型能从 DNA 中学到什么?与普通文本不同,基因组序列受进化塑造,包含重复片段、长距离相互作用和可能产生重大影响的单个突变。
Evo 2 对 DNA 使用下一词元预测,并采用注意力与卷积结合的架构来处理长序列。Brixi 说,团队整理公开序列、选择代表样本并去除高度相似的例子,构建了约九万亿碱基对的数据集。
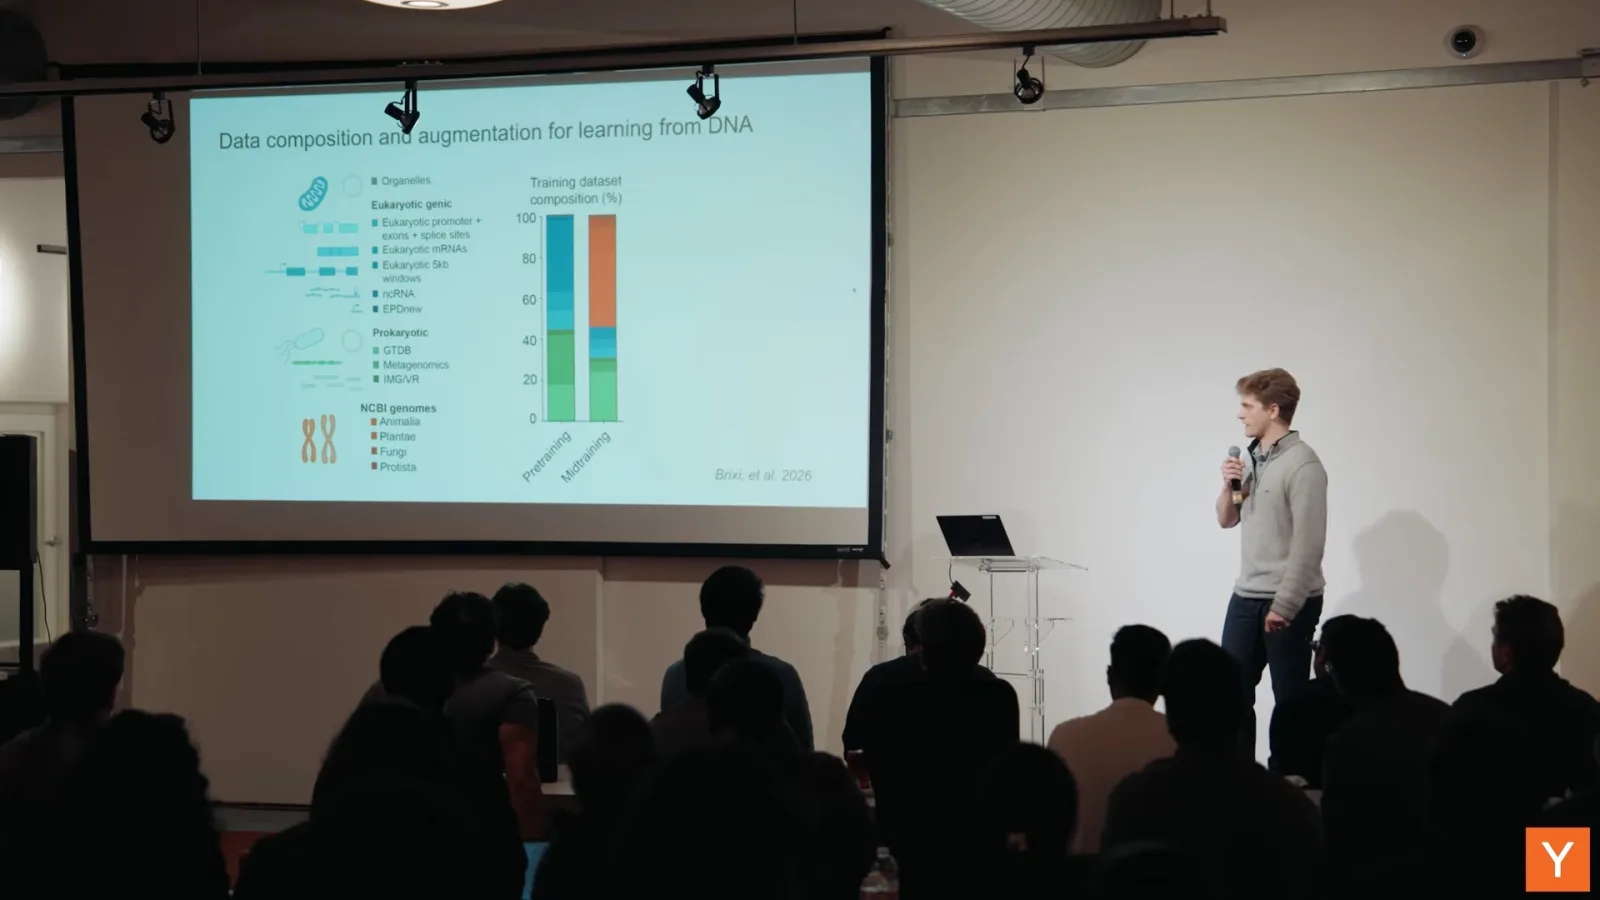
训练先侧重有注释的基因、RNA 和保守区域,随后将上下文延长到最多一百万碱基对。团队构建了 70 亿和 400 亿参数模型;Brixi 强调训练数据组合很重要。
使用模型时,研究人员可以比较序列概率、生成 DNA 或检查内部表示。某个突变概率较低,可能在基准中与功能丧失或疾病相关,但这是一项预测,并非诊断。
Brixi 介绍了一个癌症风险基因基准,其中 Evo 2 的表现与部分监督模型相当或更好。他说,改变数据组合显著影响了该基准上的相关性,并指出模型在远距离调控元件方面存在弱点。
团队还用稀疏自编码器检查内部特征。他展示的一个特征会响应与噬菌体有关的多种序列,其中包括某些此前未被注释的序列。
基因组模型也可以生成序列,并与其他预测工具结合。Brixi 介绍噬菌体设计,以及他称为 Manurva 的另一个双向模型,用于检测 DNA 不同部分之间的相互作用。
他说,新模型找到了候选非编码 RNA 结构,其中一个经实验室检查的系统功能仍然未知。这些预测可以引导科学家进行后续实验。
被问及核苷酸级切分和其他多模态架构时,Brixi 说,细粒度切分有助于部分突变预测基准。如何最好地结合 DNA 模型与人类语言模型仍是开放的研究问题。
一位观众问,每个物种只选择一个基因组是否会丢失物种内部差异。Brixi 同意会遗漏有用信息,但说在固定训练预算下,更多样的序列更有利于学习他们所研究的信号。
用示例引导生物设计
Divya Nori 介绍少样本提示,以及在小鼠脑部测试的细胞特异性增强子。观众还询问后训练和方法为何有效。
Divya Nori 介绍基因组模型的少样本提示。在语言模型中,提示词中的示例可以在不改变模型权重的情况下传达任务;她研究在标注示例稀缺时,这种方法能否帮助生物设计。
传统序列设计通常使用数千个示例进行任务专属微调。Nori 说,Evo 2 展现出从核苷酸预测中涌现的上下文学习能力,尽管它没有被明确训练来完成这些设计任务。
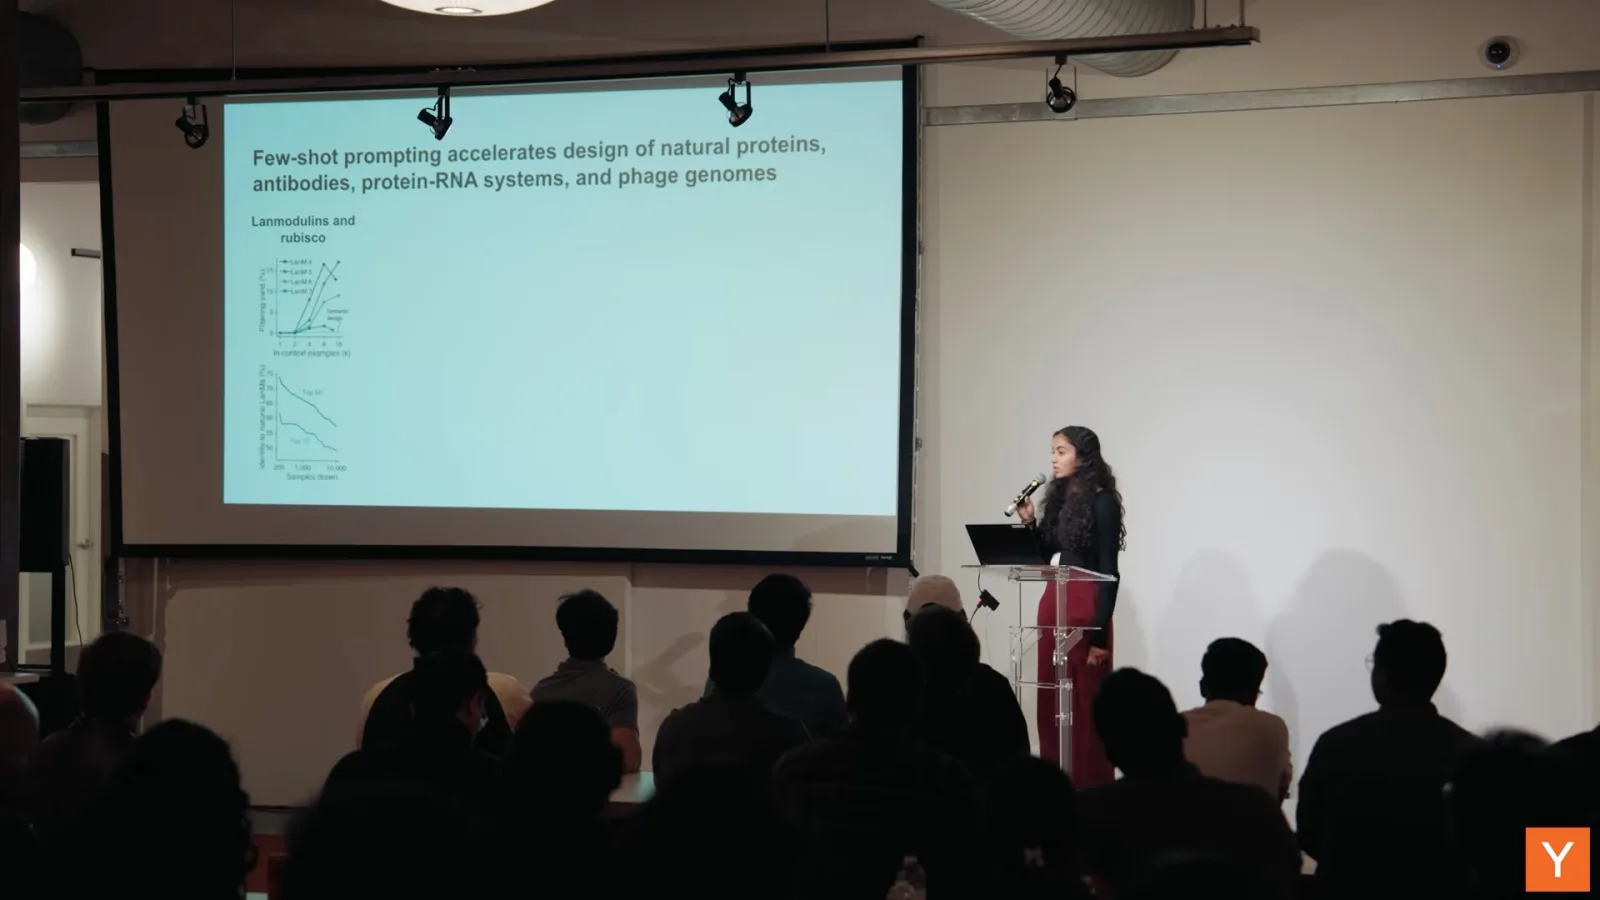
她介绍了结合稀土元素的蛋白质、抗体、CRISPR 系统和噬菌体基因组等例子。其中一些输出仍是预测候选结果,演讲将它们与实验验证区分开来。
团队选择细胞类型特异性增强子进行实验室验证。增强子是可影响基因在何处活跃的 DNA 元件;一个序列到功能的预测模型为 Evo 2 后训练提供奖励信号,帮助它更有效地利用示例。
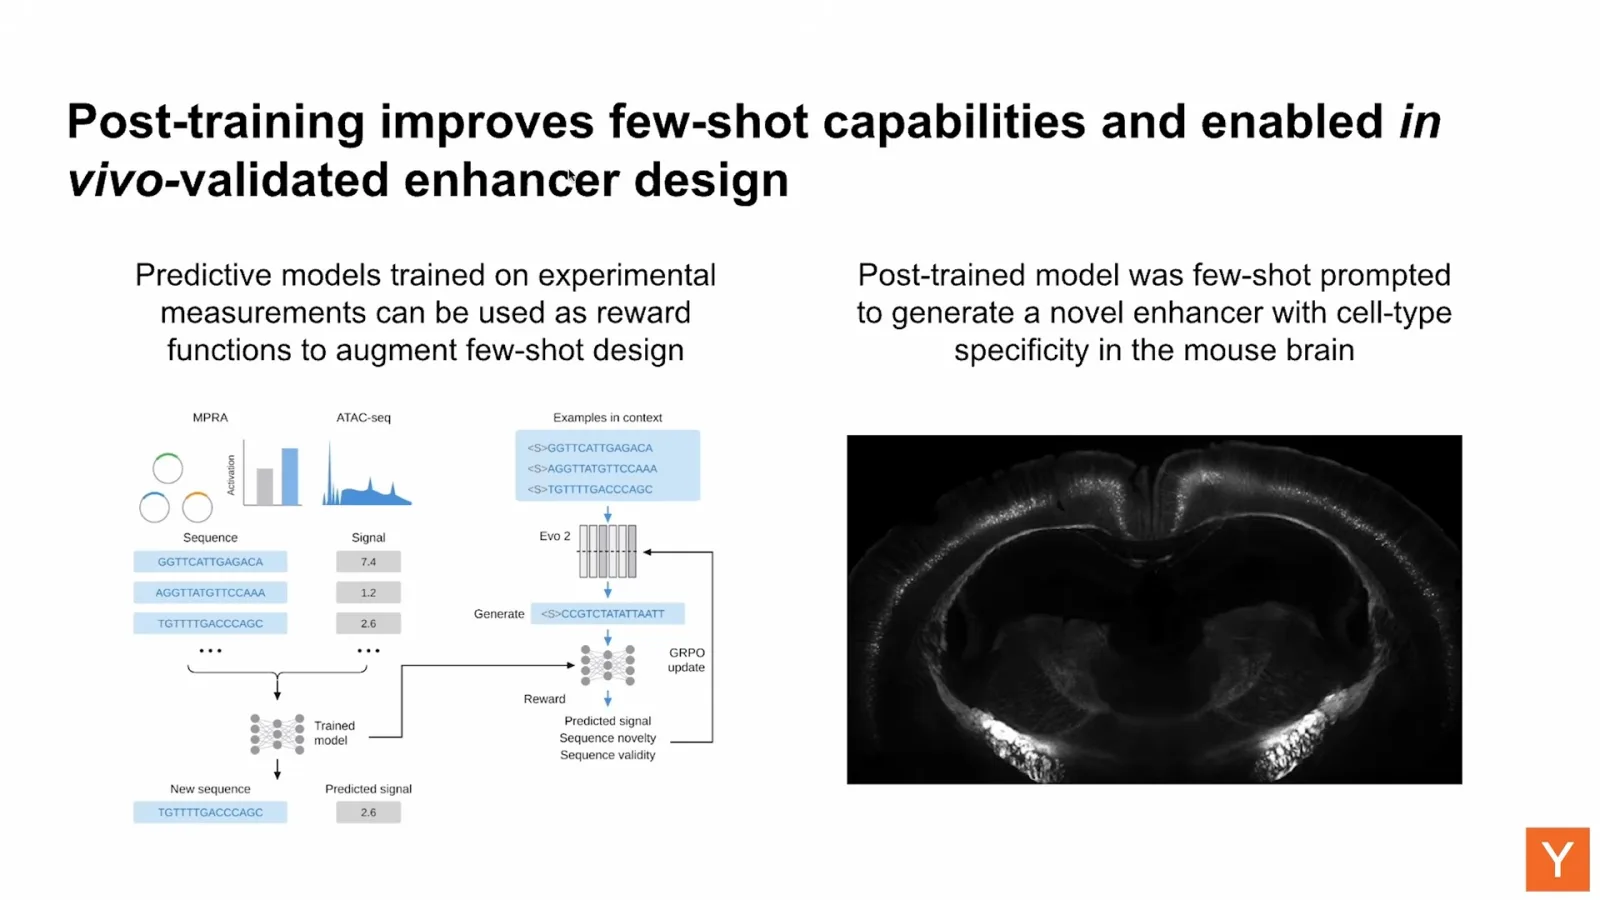
Nori 说,团队在小鼠脑部测试了一个生成的增强子,所展示的实验显示它具有活性和特异性。这是针对调控元件的动物实验,并非已证实的人类治疗方法。
她提出实验室反馈循环:从天然序列或模型生成的示例开始,产生新候选方案,测试有前景的结果,再用实验结果更新提示词。她还认为可以探索推理阶段方法和外围运行框架。
在问答中,Nori 解释强化学习设置:模型根据示例生成序列,预测器为预期活性评分,额外约束则鼓励合理的序列属性并减少对奖励机制的利用。
被问及 DNA 模型为何出现上下文学习时,她讨论了有关基因组数据分布和重复结构的假说。她说相关机制仍在研究中,并有一些证据显示它类似于语言模型中的归纳头机制。
一位观众问,增强子方法是在组合已知模式,还是能产生全新的特异性。Nori 说,它可能同时利用权重中的先验知识和示例中的模式,保留并重新组合相关片段。
同频道的其他文章
 44:15EN → 简体中文
 Y Combinator· 2026年11月7日Amjad Masad 与 Paul Graham 谈 Replit 如何走向 AI 编程Paul Graham, Amjad Masad · Y CombinatorReplit 联合创始人从用户观察与云基础设施谈起,介绍智能体编程的起步和他对企业工作的设想。
 47:14EN → 简体中文Y Combinator· 2026年11月6日Blake Scholl:超音速飞行与可能为其提供资金的燃气轮机Jessica Livingston, Carolynn Levy, Blake SchollBoom 创始人讲述发动机合作受挫、无地面音爆飞行的物理原理,以及拟议的发电业务。
 48:45EN → 简体中文Y Combinator· 2026年10月30日Paul Copplestone:为 AI 构建者和智能体提供数据库Paul Copplestone · SupabaseSupabase 联合创始人讨论公司增长、个人数据库、便于智能体使用的工具,以及如何适应新一类构建者。
 1:05:44EN → 简体中文Y Combinator· 2026年10月26日Marvin Schwaibold:用 AI 制作交互原型,设计更好用的网站Aaron Epstein, Marvin Schwaibold · Y CombinatorShopify 产品设计工作室负责人展示如何用 AI 构建和打磨交互,并与 Aaron Epstein 点评六个网站。
 1:50:48EN → 简体中文Y Combinator· 2026年10月24日为什么推理比训练重要 12 倍François Chaubard, Dan Fu, Jeff Morgan, Joe Fioti, Liangsheng Yin · Y CombinatorYC Paper Club 从一次 API 请求一路讲到 GPU kernel。Together AI、Ollama、Luminal 和 SGLang 的四场演讲认为:现在算力和钱大多压在推理服务质量上,而不只是训练 FLOPs。
 47:08EN → 简体中文Y Combinator· 2026年10月23日Farza Majeed 如何制作产品演示视频Aaron Epstein, Farza Majeed · Y Combinator一位创始人谈频繁发布、叙事和衡量真正转化的受众。