








筛选结果
344 篇排序
 1:32:22EN → 简体中文
 Cognitive Revolution "How AI Changes Everything"· 2023年6月29日播客一百万字节与 256 个符号:Meta 的 MEGABYTE 想扔掉分词器主持 Nathan LabenzMeta AI 的 Lili Yu 讲解一种多尺度 Transformer:它能预测百万字节的序列,不做分词,目标是把任何文件都当作原始字节来建模。
 1:52:46EN → 简体中文Cognitive Revolution "How AI Changes Everything"· 2023年6月27日播客给神经网络的连接按长度收费,黑箱就拆成了看得见的模块主持 Nathan LabenzMIT 物理学家 Ziming Liu 向 Nathan Labenz 讲解 BIMT,这是一种受大脑启发的训练技巧,能把网络稀疏到用眼睛就能读懂的程度。
 13:50EN → 简体中文
 Matthew Berman· 2023年6月23日MPT-30B:本地运行 MosaicML 模型并测试其 Chat 版本Matthew Berman · Forward FutureMatthew Berman 回顾 MosaicML 于 2023 年 6 月发布的模型,演示本地配置,并用一组非正式提示词测试托管的 Chat 模型。
 4:36EN → 简体中文Matthew Berman· 2023年6月20日测试 WizardCoder 15B:本地运行的编程助手Matthew Berman · Forward FutureMatthew Berman 在本地运行 2023 年发布的 WizardCoder 模型,测试小型 Python 练习和较长的 Snake 游戏程序。
 59:28EN → 简体中文Cognitive Revolution "How AI Changes Everything"· 2023年6月16日播客从 50 万美元到 5 万美元:MosaicML 让训练自有模型成了明码标价的产品主持 Nathan LabenzJonathan Frankle 和 Abhi Venigalla 解释:谁在训练定制的大语言模型(LLM),为什么抽取比聊天更有价值,以及 ALiBi 如何把 65k 上下文窗口(context window)拉得更长。
 2:00:19EN → 简体中文Cognitive Revolution "How AI Changes Everything"· 2023年6月6日播客150 万个 GPT-4 童话,让 3300 万参数的模型推理超过 GPT-2主持 Nathan Labenz来试试这道填空:Lily 喜欢猫和狗。她向妈妈要了一只狗。妈妈不同意,于是她又要了一个……
 11:49EN → 简体中文Matthew Berman· 2023年6月1日测试 Wizard-Vicuna 30B:回答、推理与代码Matthew Berman · Forward FutureMatthew Berman 考察一款宣传为不受审查的模型,演示 2023 年的云端配置,并进行一组非正式测试。
 1:25:35EN → 简体中文Cognitive Revolution "How AI Changes Everything"· 2023年5月21日播客两年半,从 33.3% 到 86.5%:谷歌把基础模型送进了医学院主持 Nathan LabenzVivek Natarajan 向 Nathan Labenz 讲述 Med-PaLM 和 Med-PaLM 2:少数据的技术、九个维度的临床医生评测,以及为什么美国医师执照考试(USMLE)式的高分是一个错误的奖杯。
 42:18EN → 简体中文
 No Priors: AI, Machine Learning, Tech, & Startups· 2023年5月18日播客 · 2 人对谈十分之一的搜索是健康问题,医生也在谷歌上查主持 Sarah Guo, Elad Gil谷歌研究员 Karan Singhal 谈 Med-PaLM 2、医疗语言模型真正的门槛,以及为什么医学是比聊天机器人更严苛的对齐实验场。
 11:07EN → 简体中文Matthew Berman· 2023年5月16日2023 年测试 MosaicML MPT-7B Chat 与 StoryWriterMatthew Berman · Forward FutureMatthew Berman 介绍 MPT-7B 的不同变体、许可及一组结果不一的本地测试。
 5:24EN → 简体中文Matthew Berman· 2023年5月12日Google I/O 2023:Bard、PaLM 2 与 Google 产品中的 AIMatthew Berman · Forward FutureMatthew Berman 回顾 Google 2023 年的 AI 发布,分析其重点改进现有产品的策略。
 4:14:33EN → 简体中文
 Lex Fridman· 2023年5月9日播客 · 2 人对谈下一个 Token 算不上证明:Stephen Wolfram 谈 ChatGPT 与计算性真理嘉宾 Stephen Wolfram · 主持 Lex Fridman这是 Stephen Wolfram 第四次与 Lex Fridman 对谈。他先把大语言模型与 Wolfram|Alpha 作对比,然后沿着计算不可约性的思路,从 ChatGPT 讲到观察者、热力学,以及二十世纪物理学的三大理论。
 9:58EN → 简体中文Matthew Berman· 2023年4月26日HuggingChat 的 2023 年初测:写作、推理与 Python 编程Matthew Berman · Forward FutureMatthew Berman 测试早期由 OpenAssistant 驱动的 HuggingChat,让它写作、算术、推理和编写贪吃蛇游戏,并将几个输出与 GPT-3.5 和 GPT-4 比较。这次小规模历史测试展示了潜力,也暴露出局限。
 5:47EN → 简体中文Matthew Berman· 2023年4月19日Sam Altman 谈 AI 模型规模:Matthew Berman 解读 OpenAI 的 2023 年方向Matthew Berman · Forward Future回顾 2023 年关于模型规模、改善 GPT-4 的可能途径以及 OpenAI 当时安全重点的讨论。
 40:25EN → 简体中文No Priors: AI, Machine Learning, Tech, & Startups· 2023年4月6日播客 · 2 人对谈60 亿参数的模型,复刻了 ChatGPT 的核心技巧主持 Sarah Guo, Elad GilDatabricks 首席技术官(CTO)Matei Zaharia 向 Sarah Guo 和 Elad Gil 讲述,Dolly 如何用比 GPT-3 少五十倍的数据学会遵循指令,以及他为什么宁愿去查资料,也不把事实记进一个万亿参数的网络里。
 6:24EN → 简体中文Matthew Berman· 2023年4月6日BloombergGPT:结合金融与通用数据训练语言模型Matthew Berman · Forward FutureMatthew Berman 考察这款 2023 年面向金融的研究模型,包括训练语料、评估以及不发布权重的决定。
 7:53EN → 简体中文Matthew Berman· 2023年4月4日HuggingGPT:用语言模型协调 AI 工具Matthew Berman · Forward FutureMatthew Berman 介绍一个研究系统:它以语言模型为控制器,将多模态任务分配给专门的模型。
 8:05EN → 简体中文Matthew Berman· 2023年3月29日2023 年指南:在本地运行初代 GPT4All 模型Matthew Berman · Forward FutureMatthew Berman 演示早期 CPU 版 GPT4All、终端安装步骤和可用于微调的资源。
 6:50EN → 简体中文Matthew Berman· 2023年3月19日本地运行 LLaMA 和 Alpaca:2023 年 Dalai 教程Matthew Berman · Forward FutureMatthew Berman 在 MacBook Air 上演示早期本地模型的安装方法,并解释控制生成结果的设置。
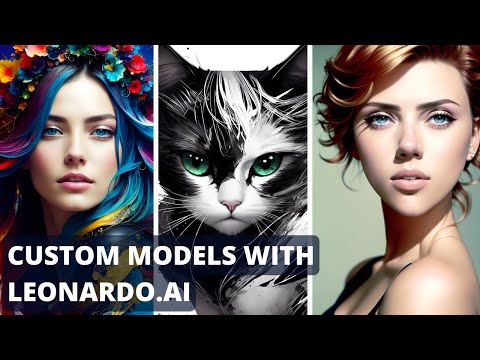 7:55EN → 简体中文Matthew Berman· 2023年2月20日如何在 Leonardo.ai 中训练自定义图像模型Matthew Berman · Forward FutureMatthew Berman 介绍 Leonardo.ai 在 2023 年的模型库、训练集建议和自定义模型流程,并分享几次实验的结果。
 1:03:29ZH
 跟李沐学AI· 2023年1月12日多模态论文串讲:BLIP、CoCa 与 BEiT-3从图文数据清理到统一预训练,梳理三种视觉语言模型的结构、目标函数与相互联系。
 1:07:10ZH跟李沐学AI· 2022年12月29日InstructGPT 论文精读:从人工反馈到语言模型对齐从监督微调、奖励模型到 PPO,梳理 InstructGPT 的训练流程、实验结果与局限。
 3:28:47EN → 简体中文Lex Fridman· 2022年10月29日播客 · 2 人对谈Karpathy 称训练好的神经网络是复杂的外星造物嘉宾 Andrej Karpathy · 主持 Lex Fridman在 Lex Fridman 的播客上,Andrej Karpathy 拒绝用大脑来做类比,借助 Nick Lane 的化学研究梳理费米悖论(Fermi paradox),并把 Transformer 视为一台通用的可微分计算机。
 2:10:08EN → 简体中文Lex Fridman· 2022年7月26日播客 · 2 人对谈Gato 只是开始嘉宾 Oriol Vinyals · 主持 Lex FridmanDeepMind 的 Oriol Vinyals 与 Lex Fridman 聊通用智能体、被丢掉的权重,以及人类水平的通用人工智能(AGI)能否在他有生之年到来。
加载更多已显示 24 篇,共 344 篇