30 秒看懂
一个 skill 既可能包含模型已经知道的信息,也可能包含模型需要的精确细节。Intel 的 Nikolay Petrov 建议将指令拆成可检查的条目,对比加载与不加载 skill 时的回答,标出能力提升、原有知识、退化和缺口。在一次报告的比较中,Opus 按一般理解标准答对 70% 的条目,但要求精确细节时只答对 22%。Petrov 将这张图作为起点:删除可能冗余的内容后,还要重新运行任务评估,才能判断精简后的 skill 是否有效。
- 1从加载和不加载 skill 的相同任务开始Petrov 在两组测试中比较任务成功率、词元使用量和耗时。他以五题答对三题与五题全对的例子说明如何衡量指令是否有帮助。
- 2将指令拆成可检查的条目每个命题或行为约定都配一个问题和预期答案,在两种条件下评估。问题本身不应向评审泄露答案。
- 3四种结果区分能力提升、退化和缺口模型可能在两种条件下都答对、只在没有 skill 时答对、只在有 skill 时答对,或者两次都答错。每种情况提示了不同的后续调查方向。
- 4知道大致概念可能掩盖操作细节的缺失Petrov 报告了一项 Opus 对比:一般标准下为 70%,严格标准下为 22%。这些数字描述的是他的评估,并不适用于所有任务或模型。
- 5利用结果图提出删减,再重新运行任务评估单独看似冗余的条目,在实际工作流中仍可能重要。Petrov 建议确认编辑后的端到端结果仍然成立。
要点建议
- 用加载和不加载 skill 的相同可检查问题,定位提升、不变的回答、退化和缺口。
- 将一般知识与精确参数、数值和步骤区分开;模型可能知道前者却不知道后者。
- 避免在问题中泄露答案,并考虑使用独立模型家族或评审组进行判断。
- 明确测试的是模型内部知识,还是使用工具时的实际表现;两者不同。
- 用条目级结果指导编辑,再通过端到端任务评估验证精简后的 skill。
按章节阅读整理后的全文
skill 提供什么,以及如何测试
skill 可以传授新信息,也可以引导流程。Petrov 从配对任务评估入手,衡量 skill 是否有帮助。
Nikolay Petrov 将 skill 描述为可重复使用的指令包,它把反复使用的提示词转化为可移植的智能体能力。有些 skill 提供新知识,另一些主要引导可重复的流程。两者都可能有用,但这次演讲关注的是旨在教会模型原本不知道的内容的 skill。
一种基本评估方法是对比加载和不加载 skill 时的相同任务。Petrov 建议尽可能选择可以确定性检查的任务。他举例说,模型没有 skill 时五题答对三题,有 skill 时五题全对;对比还可以包括词元使用量和耗时。
将 skill 映射为可单独测试的条目
问题和预期答案可以用于比较加载与不加载 skill 的情况。能否使用工具和评审的选择会影响评估所测量的内容。
即使 skill 提高了端到端评估成绩,随着模型演进或词元成本成为关注点,其内容仍可能需要重新审视。尝试每一种逐行组合成本很高,而凭直觉删除文本可能删掉模型真正需要的细节。
Petrov 建议借鉴 FActScore 中原子事实的思路,将 skill 拆成可以独立检查的小条目。每个条目配一个问题和预期答案。条目可以描述一般命题,也可以描述更具体的行为约定。
一个 skill 可能拆出 25 或 30 个条目。对于每个问题,团队分别运行加载和不加载 skill 的两组测试,再用模型评审或评审组判断答案。Petrov 建议在可行时使用来自不同模型家族的评审,并避免问题自身泄露答案。
测试可以不使用工具,以探测模型已经知道什么;也可以提供网页访问等工具,更贴近实际环境。这是两种不同的测量:外部信息可能改变模型在没有 skill 时能回答的内容。
解读四种可能的结果
模型可能已经知道某个条目、因 skill 得到提升、表现退化,或在两种条件下都失败。Petrov 将这些结果映射到原文上。
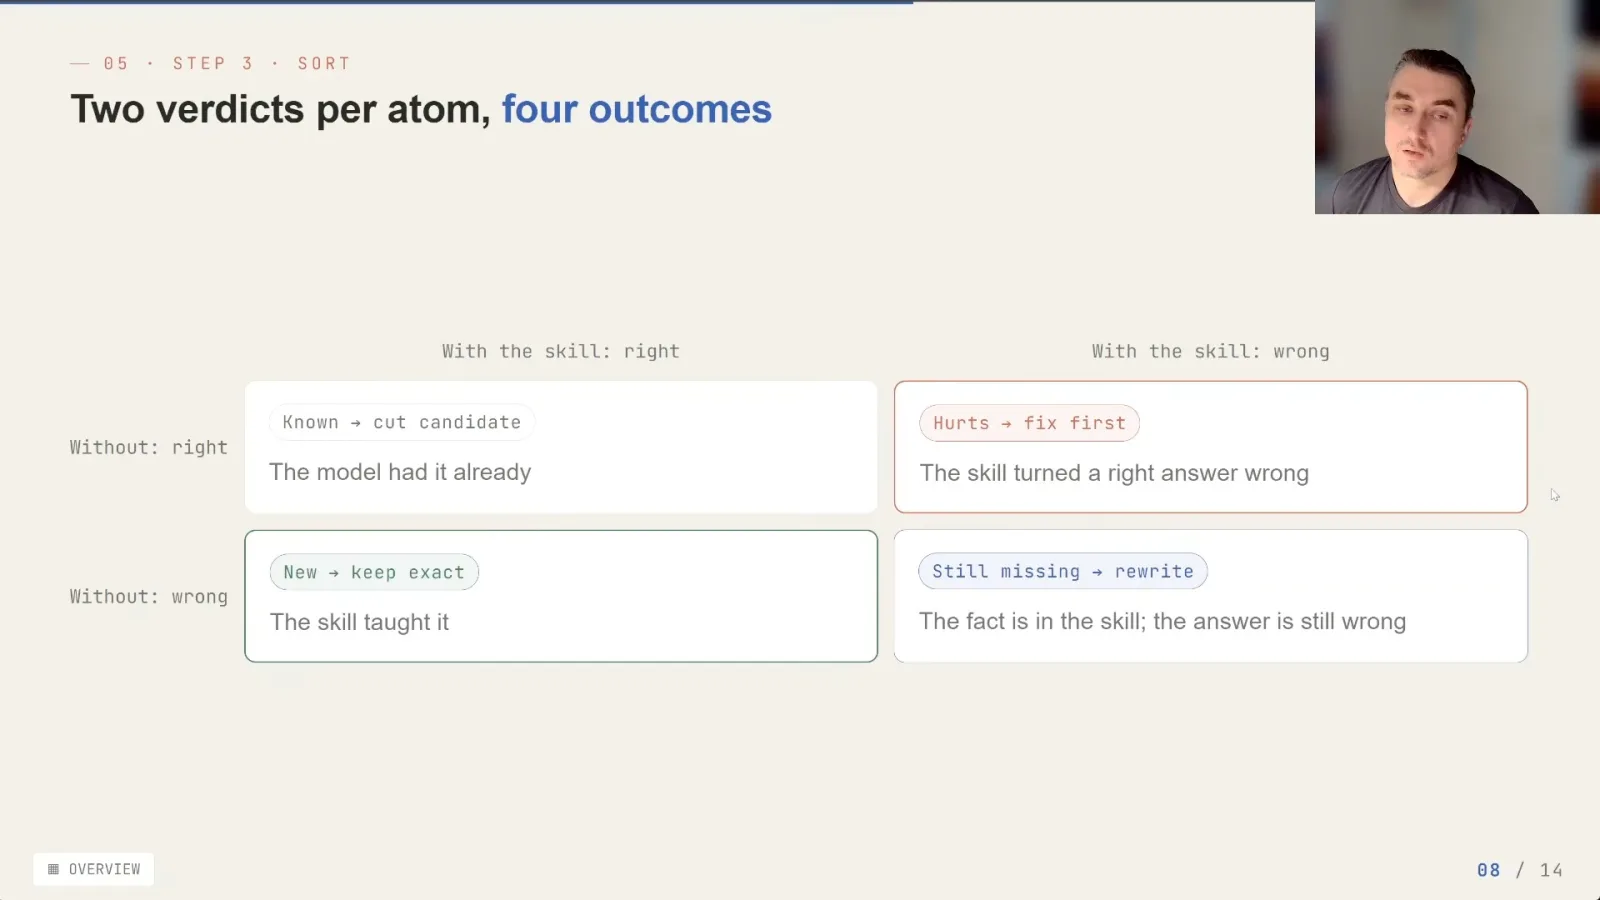
两组结果构成四类情况。如果模型在有无 skill 时都能正确回答某个条目,说明在该测试环境下它已有足够知识回答这个问题。如果只有没有 skill 时才能答对,加入 skill 似乎损害了该条目的表现。
如果模型没有 skill 时答错、有 skill 时答对,这个条目就代表该测试中期望获得的增益。如果两种条件下都答错,相关主题仍可能重要,但当前 skill 的写法没有让受测模型成功回答。
Petrov 说,在团队考察的热门 skill 中,导致表现退化的条目很少:他指出展示的 Anthropic skill 中近 400 个条目只有一个这样的案例。他报告称,在一些规模更小、较不流行的 skill 中看到了更多此类情况;这一发现只针对受测 skill、模型和问题。
这些结果可以可视化映射到 skill 文本,展示哪些内容有帮助、已经知道、有害或仍然缺失。Petrov 提醒,评估单位是条目,不一定是一行:同一行或一句话可能包含结果不同的多个条目。
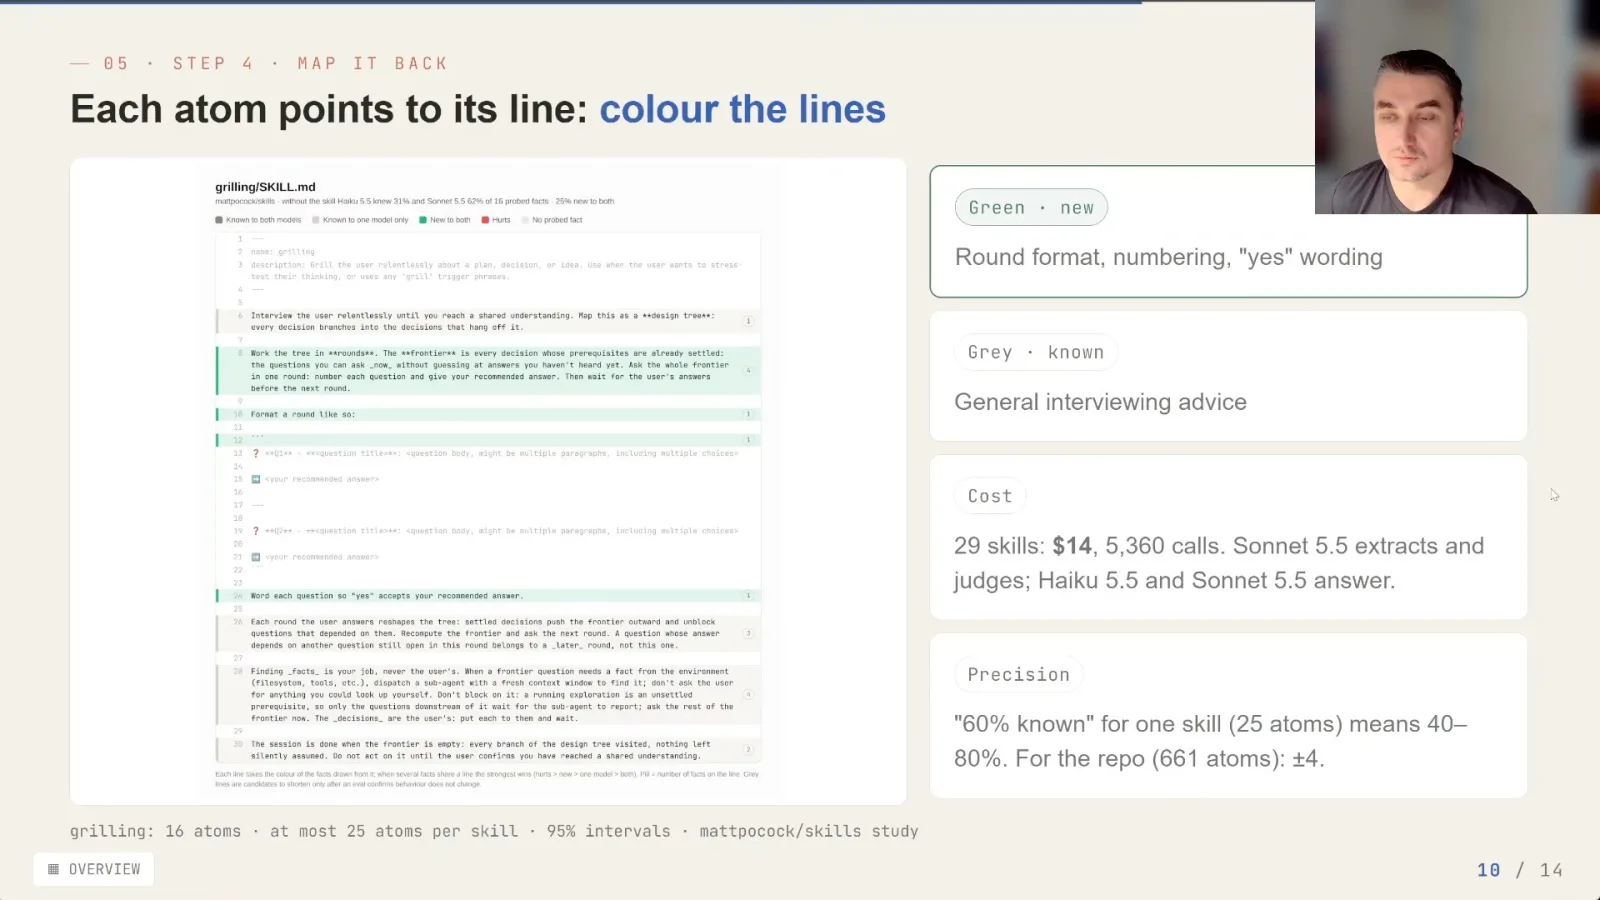
Petrov 说,在报告的实验中,测试 29 个 skill 的 Sonnet 和 Haiku 调用费用约为 14 美元,其中使用 Sonnet 作为评审。这是该次运行的费用,不是评估每个 skill 的通用价格。
区分大致理解和精确细节
严格与宽松评分可能产生截然不同的结果。条目级新颖度有助于指导编辑,但最终仍需要任务评估。
评估还可以调整答案评分的严格程度。宽松检查关注是否表达了大致意思;严格检查则要求特定键名、参数值或准确步骤。知道一个概念不等于知道智能体必须使用的具体细节。
Petrov 报告的一次比较中,Opus 按一般理解标准答对约 70% 的 skill 条目,但按具体细节标准只答对 22%。他认为,这一差异说明即使前沿模型知道大致概念,也有理由保留精确数据和操作细节。
在展示的模型和 skill 集合中,小模型通常比大模型知道的内容更少,但不同 skill 的结果差异也很大。有些 skill 旨在引导行为,而不是提供新事实,因此新颖度低并不自动意味着有缺陷。
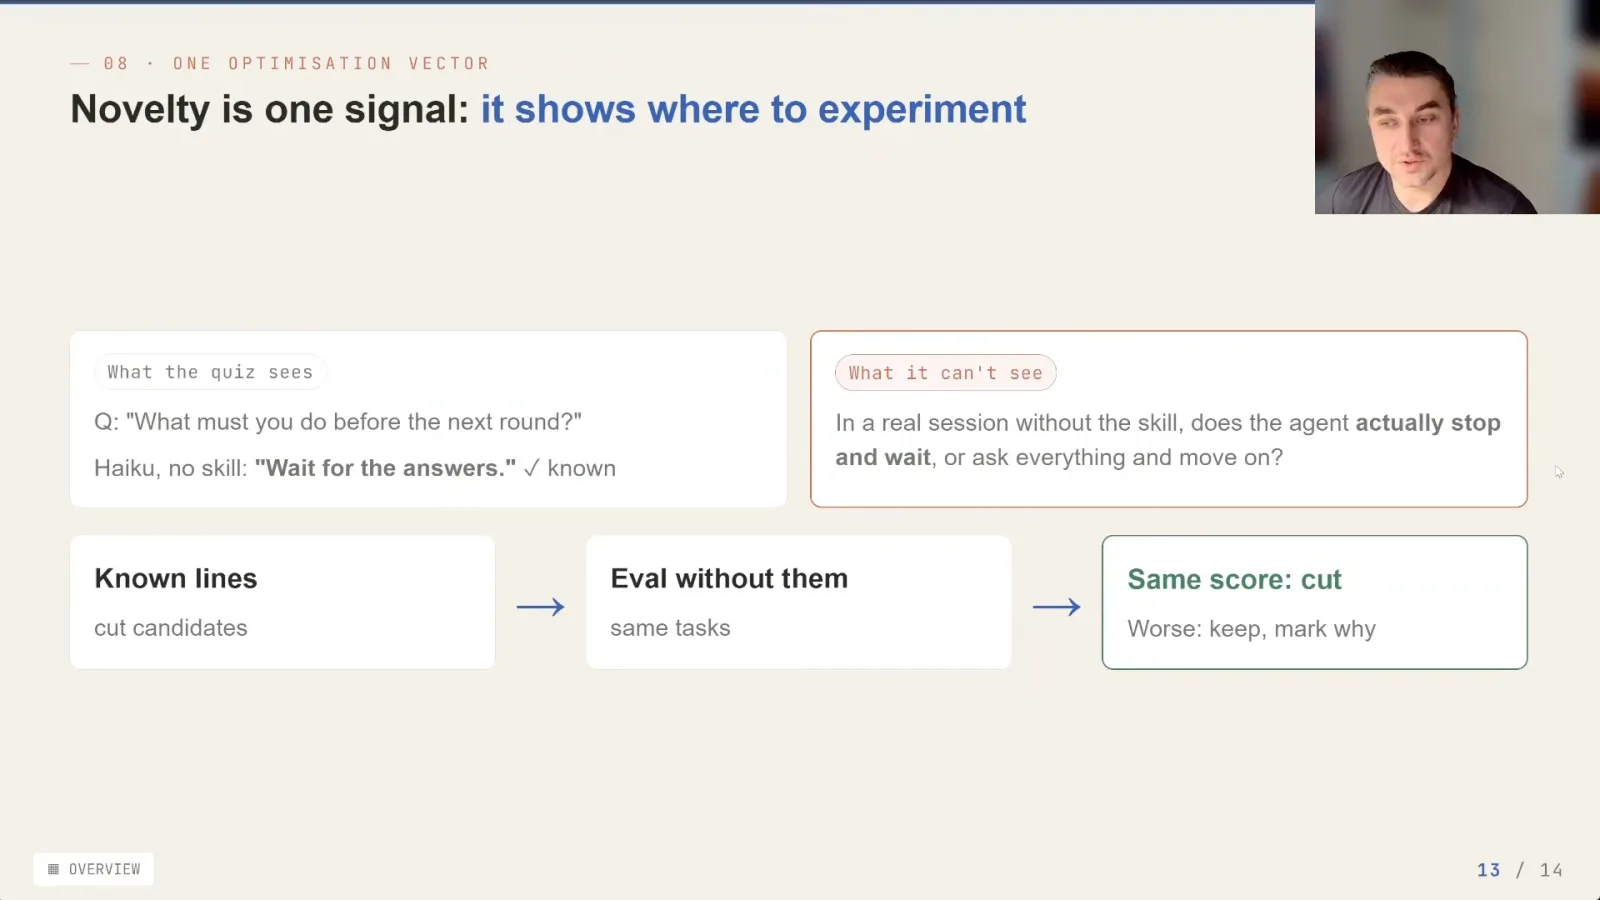
新颖度只是优化的初始方向,不能代替任务评估。Petrov 建议删除一些看似已知的信息,然后重新运行端到端评估。如果任务结果保持不变,精简后的 skill 可能节省词元和上下文;否则,看似冗余的材料可能仍有用。
实验使用了 Documate。Petrov 将其描述为比较智能体上下文的框架,可用于 skill、AGENTS.md 和 MCP 工具等内容。他说,该框架还支持评估上下文影响、路由、描述和命名,目标是根据测量结果而不是猜测来修改 skill。
同频道的其他文章
 17:31EN → 简体中文
 AI Engineer· 2026年11月12日Claude Code 需要的引导更少,无人值守工作却需要更强的检查Lydia Hallie · AnthropicLydia Hallie 介绍权限、隔离环境和验证如何接手人们过去在每次会话中执行的任务。
 18:03EN → 简体中文AI Engineer· 2026年11月11日Dmitry Buykin:当编码智能体快过审查,如何维护代码Dmitry Buykin · Maersk在马士基,每周清理、真实任务回放和业务专家反馈帮助团队理解智能体构建的系统。
 26:49EN → 简体中文AI Engineer· 2026年11月11日Ara Khan:选择能随 AI 进步而受益、又不会被取代的工作Ara Khan · ClineCline 的 Ara Khan 解释自动评估循环,并建议工程师选择能从模型进步中受益的问题。
 12:38EN → 简体中文AI Engineer· 2026年11月11日Duolingo 如何用智能体补充测试,同时保留人工审查Kush Agrawal · Duolingo定时流程通过生成测试、修复 CI 并将拉取请求交给工程师批准,提高了 iOS 测试覆盖率。
 38:50EN → 简体中文AI Engineer· 2026年11月10日LinkedIn 的自我改进代理,先要修好评估裁判Ziwei Guo, Saloni Gandhi · LinkedIn一个提示词优化循环改进了职业代理,但团队首先需要通过人工校准提高评估器的可靠性。
 12:48EN → 简体中文AI Engineer· 2026年11月10日Brian Douglas:把智能体纠正记录变成可复用的审查知识Brian Douglas · Paper Compute这位 Paper Compute 开发者记录编程会话中的专家纠正,并测试如何在代码审查中复用。