30 秒看懂
Jon Gjengset 通过一个小型只读基准测试解释缓存一致性、读写锁争用和伪共享。他演示 left-right 数据结构,讨论其内存、一致性和写入侧的权衡,并回答有关硬件和同步实现的问题。
- 1出人意料的读取基准测试增加第二个核心后,互斥锁保护的读取吞吐量大幅下降;在这个短临界区中,读写锁的扩展性也很差。
- 2读取者会写入锁状态读写锁会更新共享的读取者计数,使缓存行所有权在核心之间转移。
- 3两个副本和一个指针left-right 让读取者使用一个副本,写入者更新另一个副本,再通过交换指针发布。
- 4实践中的伪共享读取者计数器共用缓存行导致性能严重下降;将它们分别对齐解决了基准测试中观察到的问题。
- 5权衡很重要left-right 消耗更多内存,允许读到旧数据,并采用单写入者设计,因此只适合部分工作负载。
要点建议
- 获取读锁可能需要写入共享协调状态,从而在读取者之间产生争用。
- 缓存一致性以缓存行为单位运作,因此所有权转移可能主导短临界区的开销。
- left-right 为读取者提供独立状态,将更多工作转移给较少出现的写入者。
- 独立变量共用缓存行时,即使是无锁代码也可能因为伪共享而发生争用。
- left-right 用内存和更强的一致性保证换取读取可扩展性,并非锁的通用替代品。
- 应根据工作负载及其所需的一致性保证选择并测量同步设计。
按章节阅读整理后的全文
互斥锁慢吗?
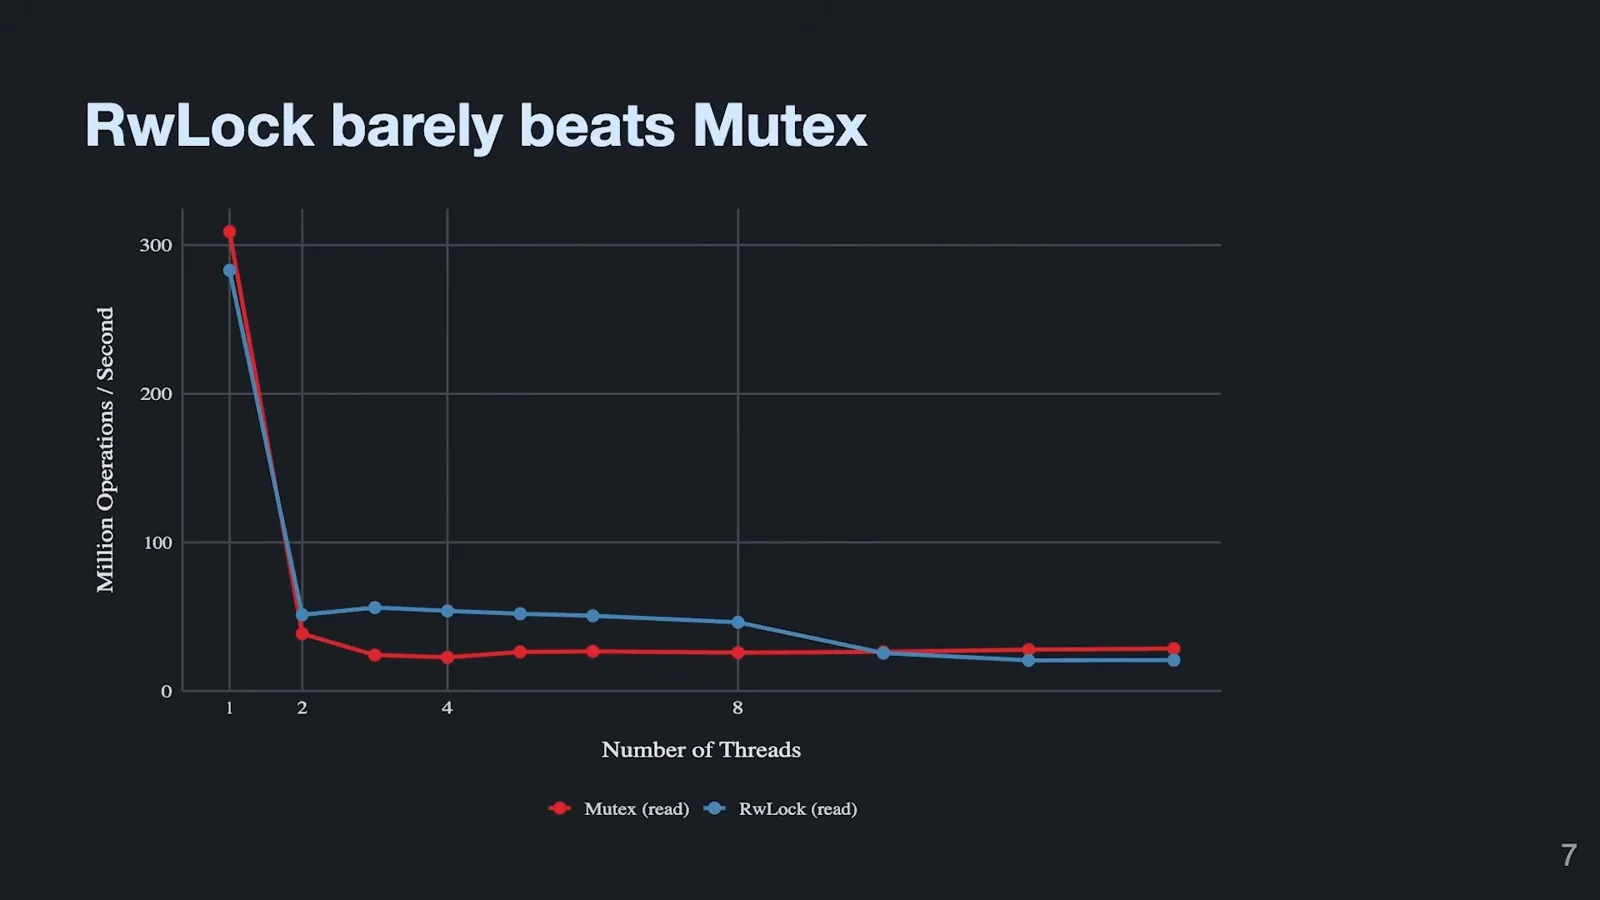
只读基准测试显示,线程增加时吞吐量下降。读写锁不会自动解决这个问题。
我想超越“互斥锁很慢”这种说法,追问线程协调时 CPU 实际在做什么。例子会用到少量 Rust,但这些思路更广泛地适用于并发算法和性能问题。
考虑一个共享计数器,许多线程只读取它。每个线程获取互斥锁、读取计数器,然后释放锁。一个 black-box 操作防止编译器将读取优化掉;没有线程写入计数器本身。
在我的基准测试中,一个线程每秒大约读取 2.5 亿次;增加第二个核心后,吞吐量降到约 2500 万次。继续增加线程,吞吐量仍然很低。互斥锁会串行化访问,但这个结果比线程增加后仅仅保持原有吞吐量还要差。
读写锁似乎可以解决读密集型工作负载的问题。但在这个例子中,它的吞吐量也急剧下降,而且随着读取者增加,最终比互斥锁更差。要理解这个结果,我们需要看看缓存。
缓存与一致性
Gjengset 解释缓存层级、MESI 状态和缓存行所有权。共享写入需要核心之间协调。
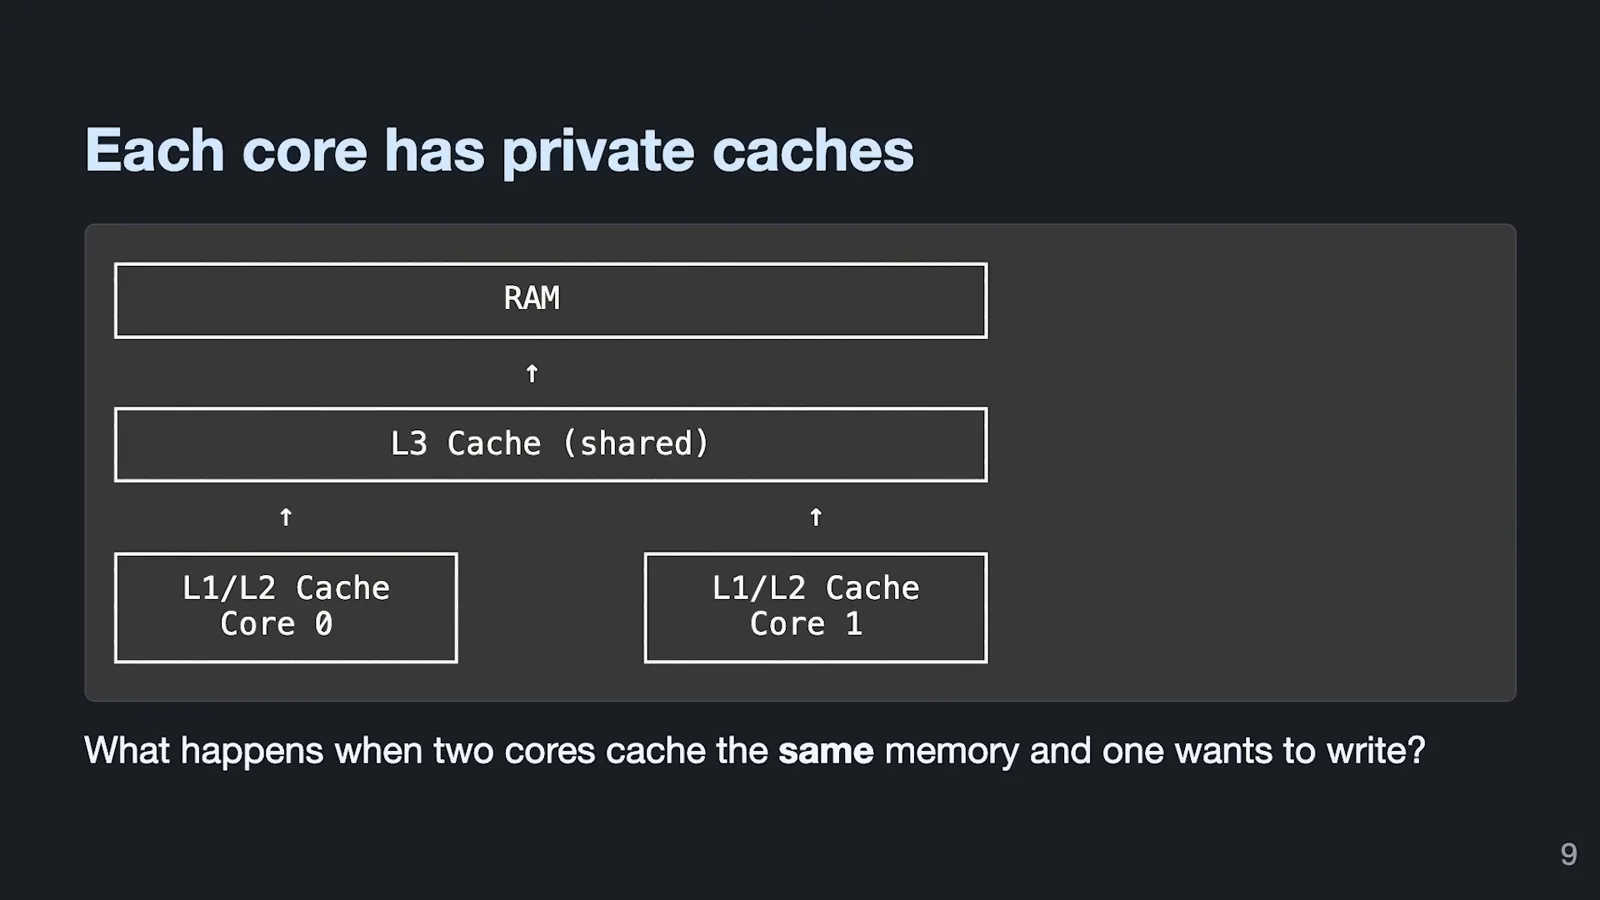
访问主内存比访问 CPU 本地缓存慢得多。常见处理器有缓存层级:每个核心一个较小的 L1 缓存、中间层 L2,以及通常由多个核心共享的较大 L3。具体安排因处理器而异。
当不同核心缓存同一块内存时,一致性协议负责协调访问。MESI 是一个有用的模型:Modified 表示核心拥有已修改的独占副本;Exclusive 表示唯一副本未修改;Shared 表示多个有效副本一致;Invalid 表示缓存条目不能使用。
一致性协议以缓存行为单位运作,而非以单个变量为单位;例子中常见的缓存行大小是 64 字节。核心写入共享数据之前,必须获得独占所有权并使其他副本失效。这需要跨核心通信。
读锁为何发生争用
读取者获取和释放锁时会更新共享计数器。缓存行转移可能成为极短临界区的主要开销。
读写锁通常维护一个共享的读取者计数。获取读锁时加一,释放时减一,所以即使读取者也会写入同一缓存行。核心数量增加时,所有权会反复在它们之间转移,带来串行协调开销。
以两个读取者为例,假设核心 0 拥有缓存行并增加计数。核心 1 随后需要取得更新后的缓存行才能增加计数;核心 0 释放时,缓存行可能还要移回来才能减去计数。一次获取和释放可能涉及两次缓存行转移。
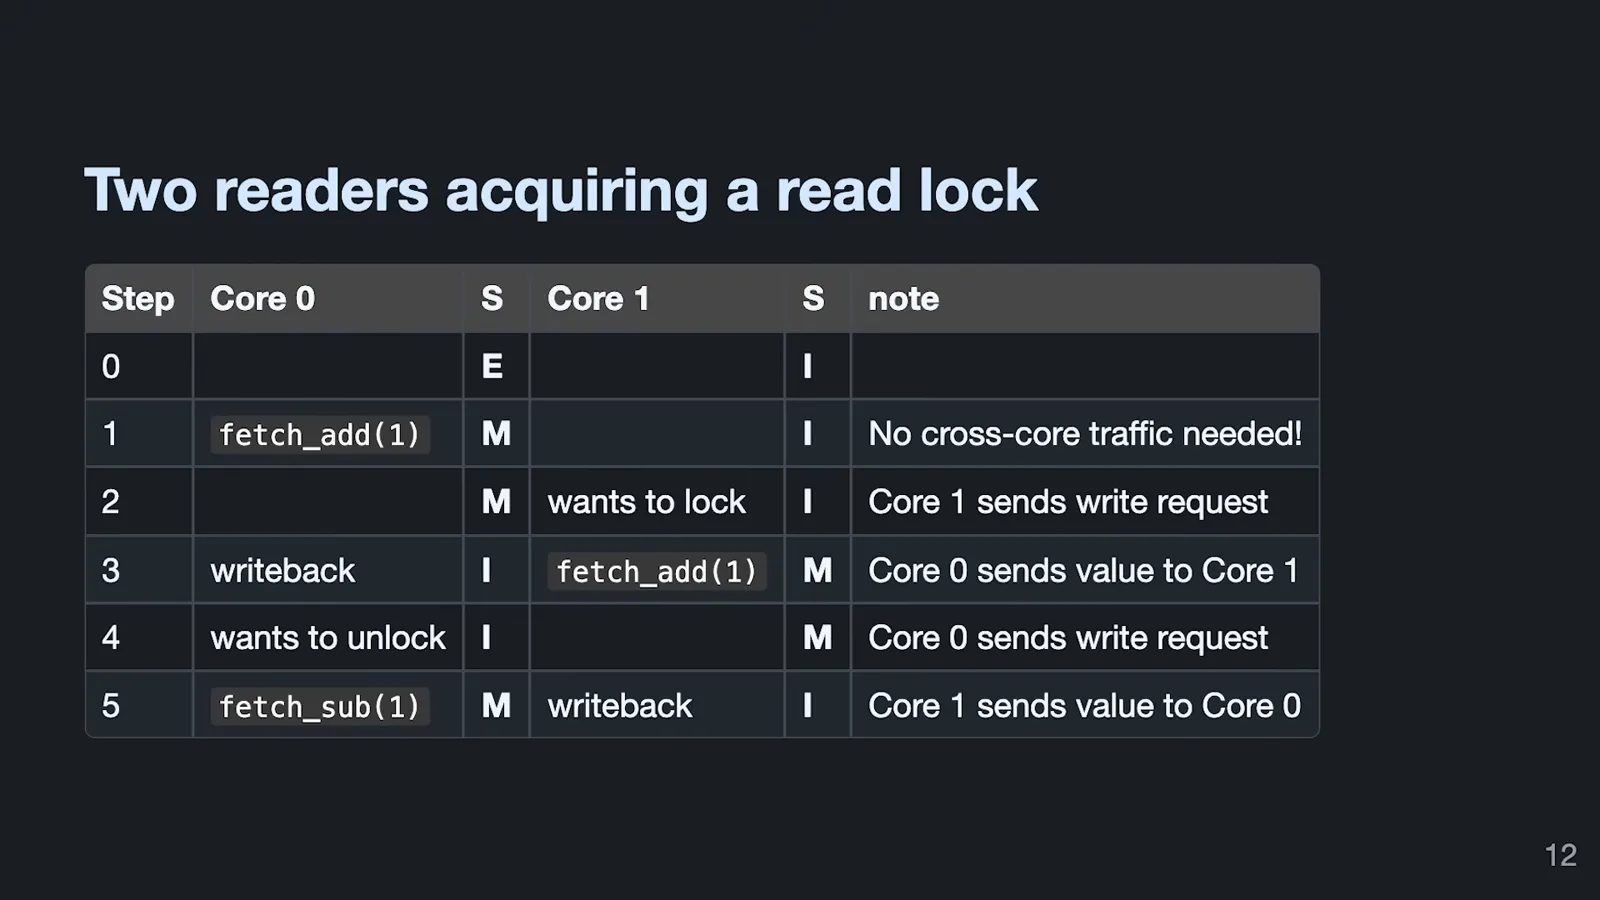
在这个例子中,本地 L1 访问约需 1 纳秒,跨核心转移约需 30 纳秒;两次转移已经占约 100 纳秒的主内存访问时间的很大一部分。这些时间仅用于说明,并非通用常数。
使用互斥锁时,持有者在释放前具有独占访问权,因此不会以同样的方式出现读取者计数的来回争用。所以,在这个特定的短小只读基准测试中,读写锁的扩展性可能更差,尽管它允许多个读取者进入受保护区域。
临界区较长时,锁内工作可能远远超过获取锁的开销,互斥锁完全可能是合适的选择。问题主要出现在争用激烈、临界区极短的热点循环中。真实工作负载需要实际测量。
left-right 替代方案
两个副本和每个读取者各自的计数器减少了读密集型工作负载的争用。写入者复用旧副本前需要等待旧读取者。
作为具有不同权衡的替代方案,我在博士研究中使用了 left-right:当时读取远多于写入,每次读取只是一次短小的哈希映射查找。目标是避免读取者反复写入共享缓存行,将更多工作转移给不常出现的写入者。
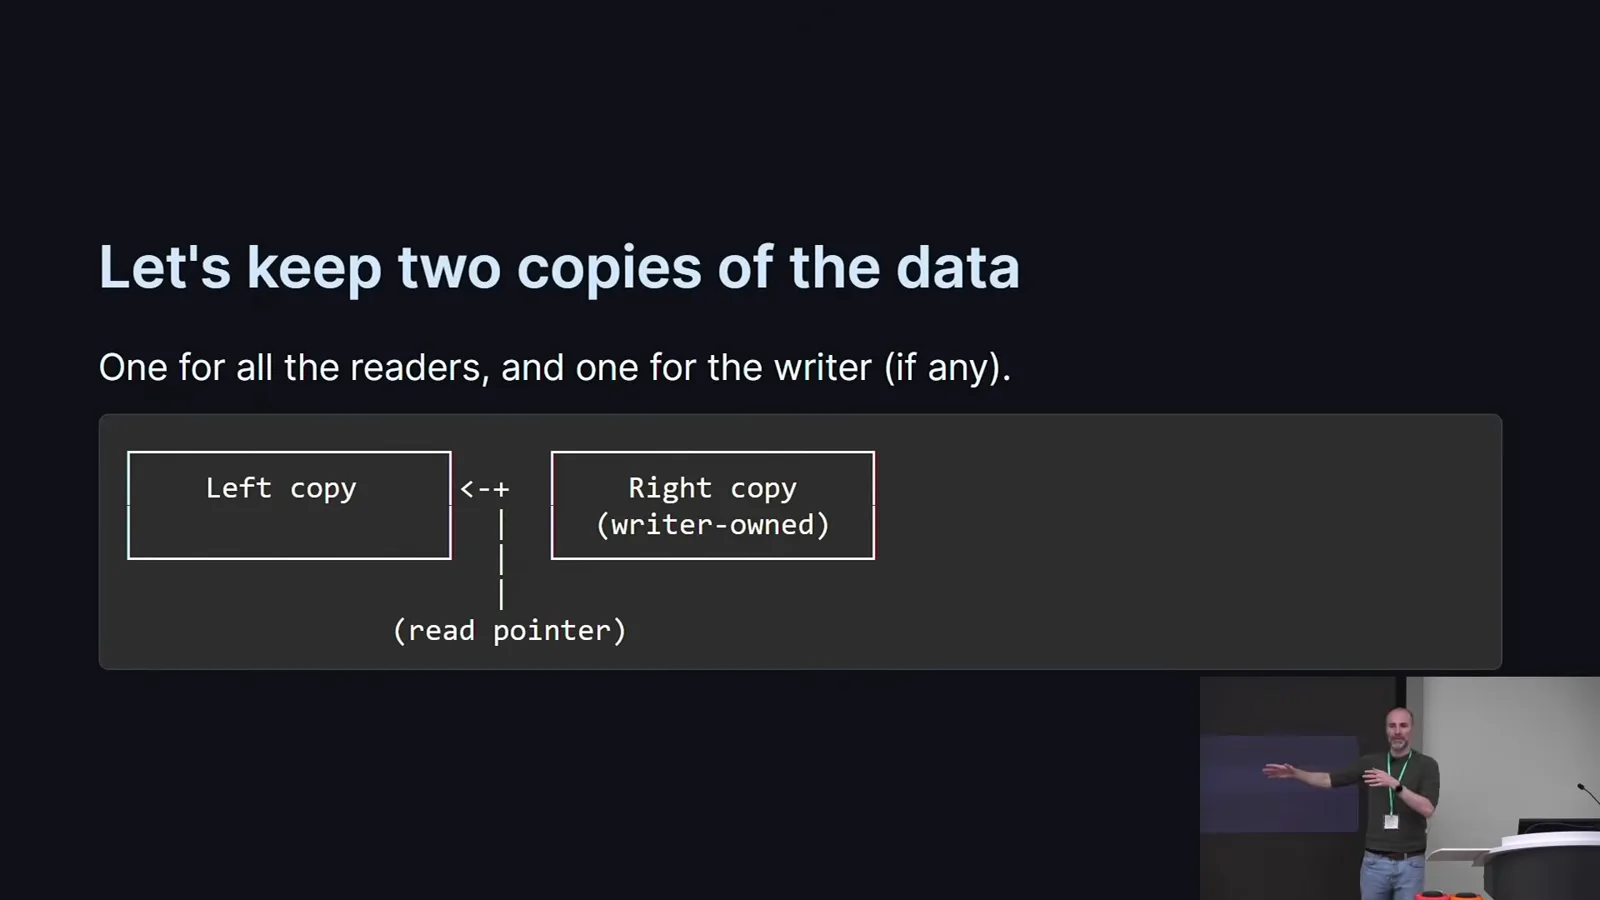
left-right 保存两份数据,并使用一个原子指针指向读取者应使用的副本。写入者修改另一个副本,然后交换指针。之后开始的读取者使用新发布的副本;已有读取者可能还在使用旧副本。
修改旧副本之前,写入者必须知道先前的读取者已经使用完它。每个读取者都有自己的计数器,理想情况下位于独立缓存行。写入者交换指针后扫描这些计数器,判断何时可以安全继续。
读取者不更新共享的读取者计数,也不需要彼此协调。除了写入者检查时,本地计数器可以一直由对应核心拥有。读取无须等待并发写入者;在这种设计中,读取路径是无等待的。
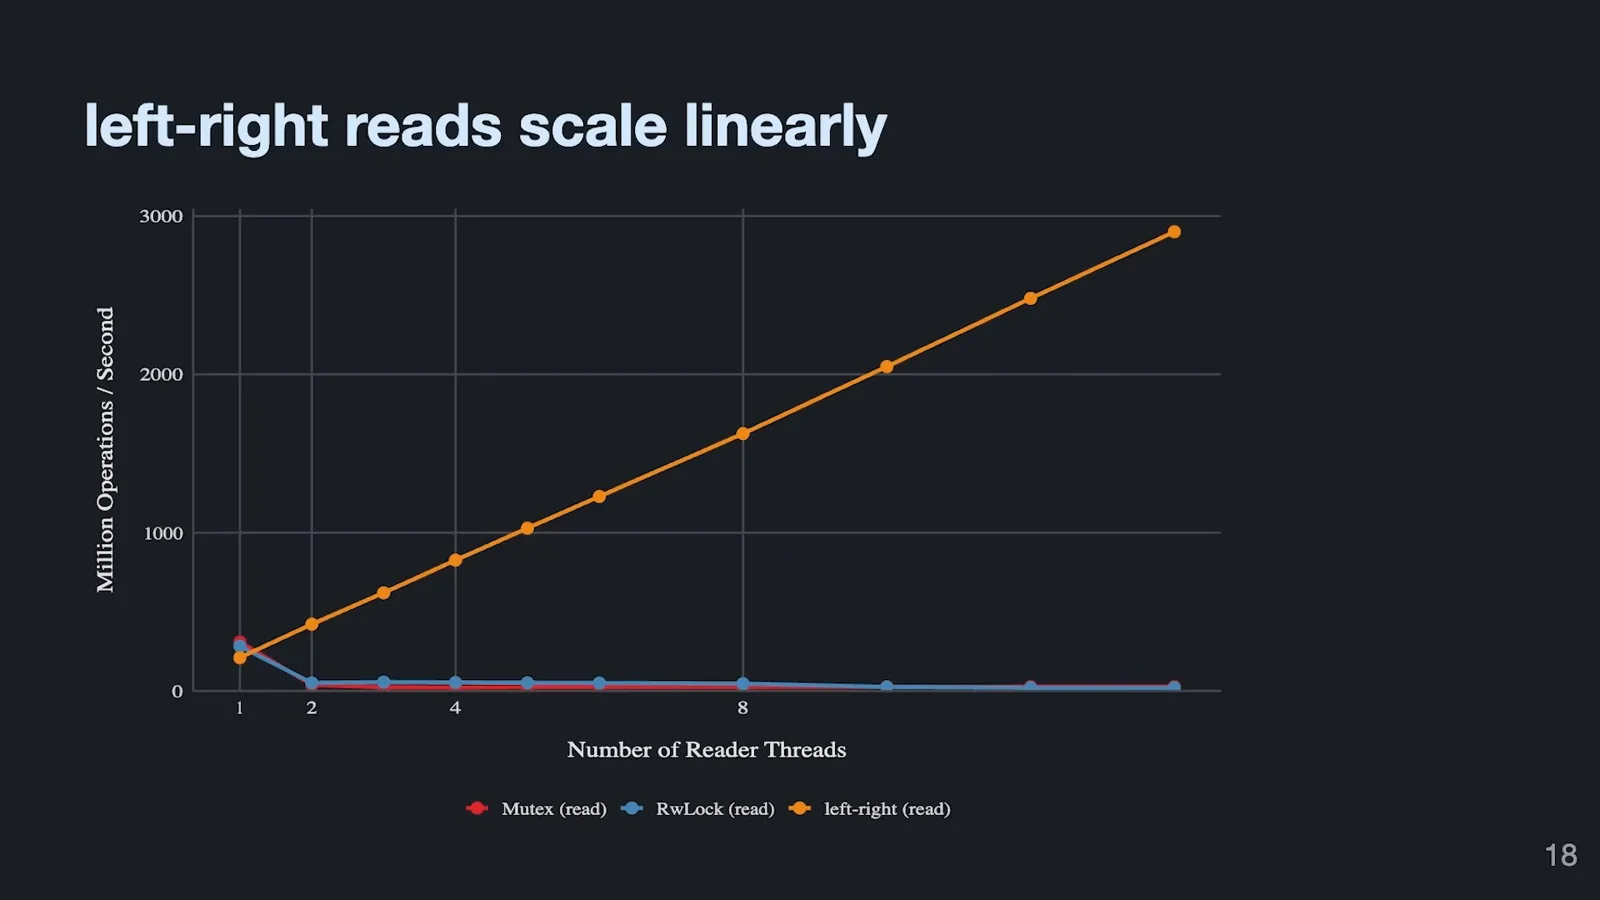
只读基准测试的吞吐量随读取线程数大致线性增长,例子中达到每秒约 30 亿次操作。这得益于读取者相互独立,但收益取决于写入很少发生。
一位观众问休眠的读取者怎么办。我澄清说,每个读取者在操作开始和结束时各增加一次计数;写入者可以通过偶数计数或计数变化识别不活跃的读取者。一直停留在操作中的读取者会拖延写入者,但不会阻止其他读取者。
伪共享与权衡
一次基准性能退化揭示计数器共用了缓存行。Gjengset 讨论 left-right 在内存、写入和一致性方面的代价。
频繁写入会带来更多争用和写入者工作。当写入多于读取时,left-right 可能比读写锁更慢。它是为利用特定工作负载的特点而设计的,并非要赢得所有基准测试。
做基准测试时,我发现四个核心时性能出乎意料地下降了约十倍。原因是伪共享:各自独立的读取者计数器落在同一个 64 字节缓存行中,因此对不同计数器的写入仍会让整条缓存行的所有权在核心之间转移。
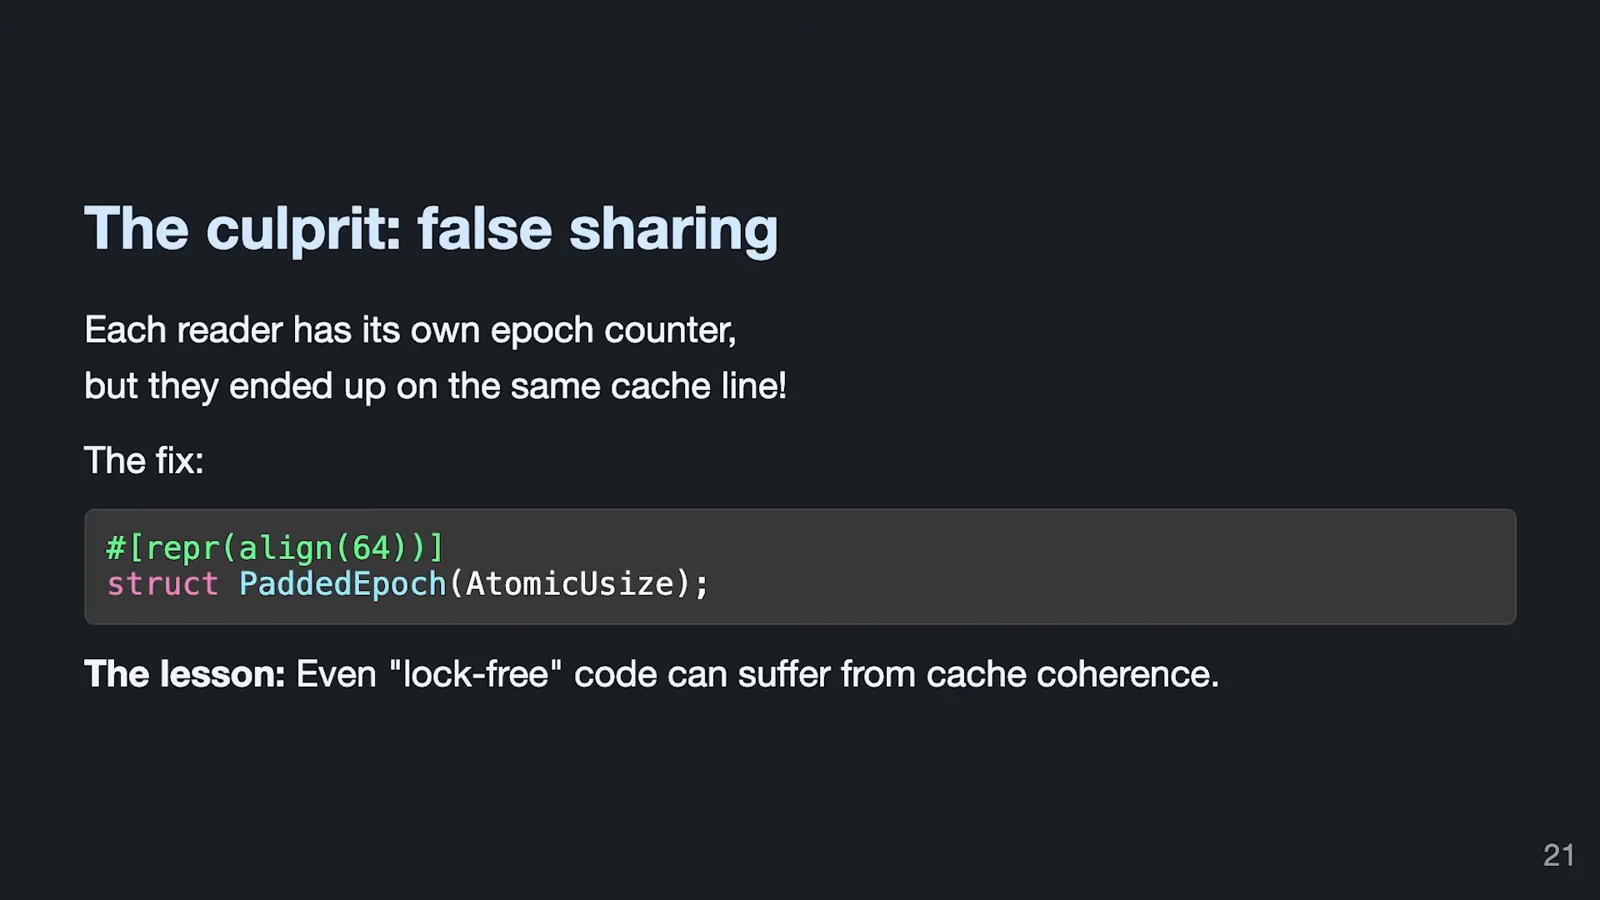
给计数器类型增加 64 字节对齐,让计数器位于不同缓存行,解决了观察到的问题。教训是,无锁不等于无争用:即使程序没有锁,硬件仍可能迫使核心之间协调。
应根据实际数据传递模式选择并发算法,而不是从基准测试中挑一个看似最快的原语。left-right 不能直接替代其他方案:两份数据需要额外内存;读取者可能看到旧值;除非增加额外同步,否则它只支持单写入者。
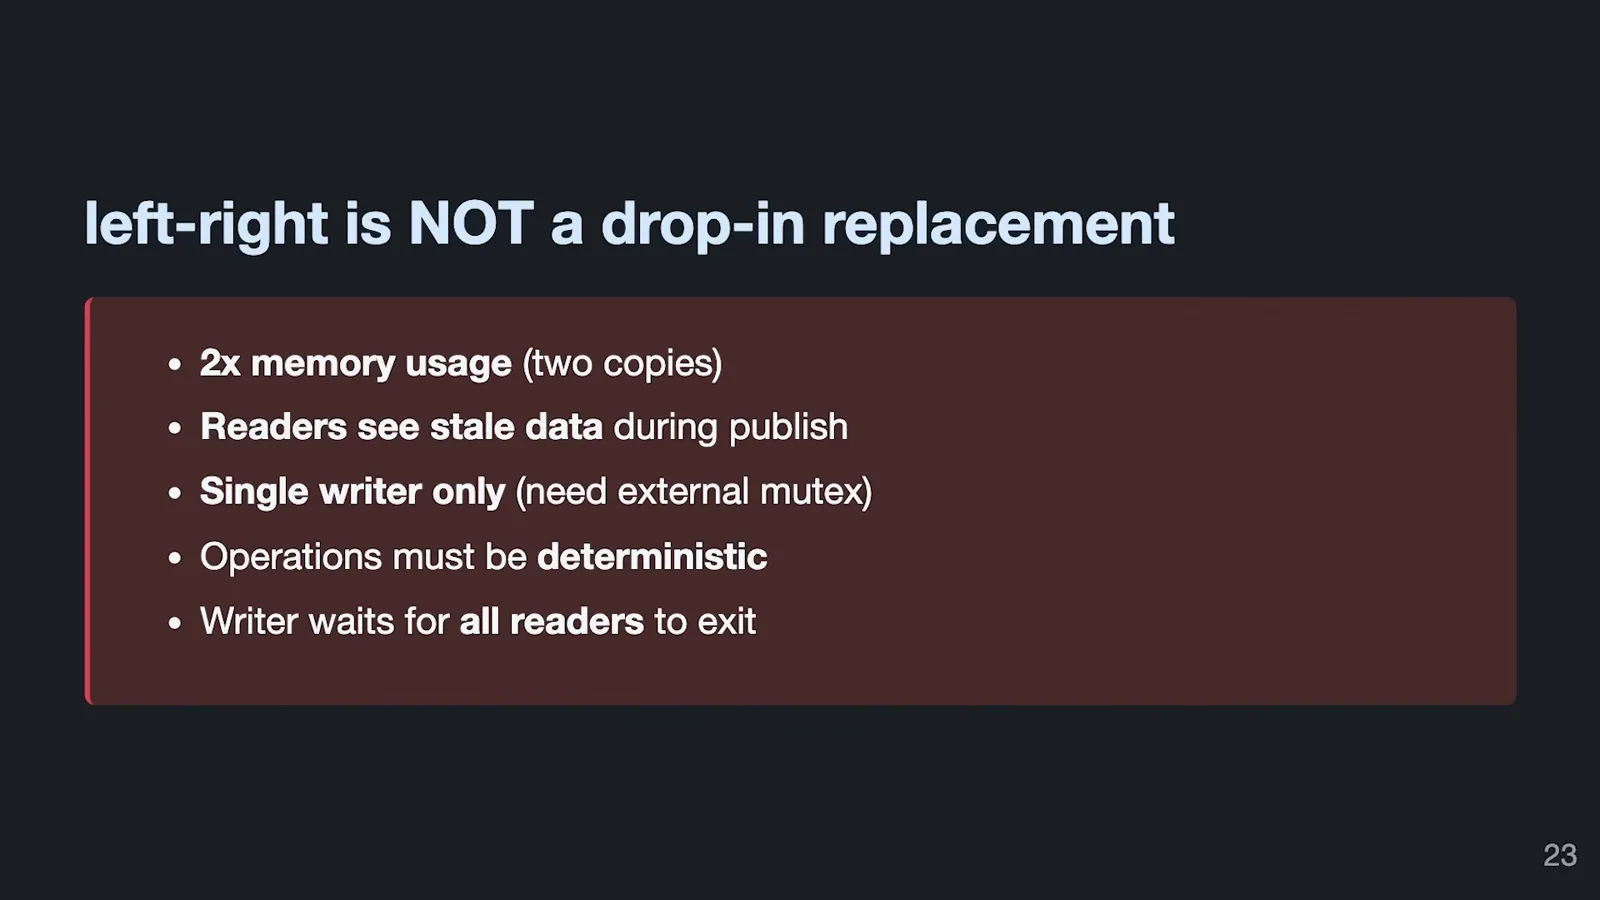
写入者可以等待所有读取者转到新副本,但这会增加开销。更新还需要确定性的操作和可将变更重放到另一个副本的日志,否则两个副本会发生分歧。写入者必须等待仍在使用旧副本的读取者。
left-right 提供最终一致性,而非线性一致性,因此我会考虑把它用于缓存或查找,而不是金融交易。它可能不保证立即读到自己刚写入的数据。互斥锁、读写锁和 left-right 分别适用于不同需求。
选择与测量
读写比例、临界区长度和一致性要求都会影响选择。开销来自协调,而不只是锁接口。
需要考虑读写比例、临界区长度、线程数和一致性要求。读取者能否容忍旧数据?是否必须读到自己的写入,或满足线性一致性?优化之前先测量,再根据答案选择设计。
主要开销来自缓存一致性导致的协调,而锁只是这种开销表现出来的一种接口。其他设计,包括使用每核心计数器的可扩展读写锁,可以将协调成本转移给写入者。正确选择取决于工作负载。
观众问答
问题涉及硬件进步、读取者注册、互斥锁实现和编译器排序屏障。Gjengset 区分已知行为与不确定的硬件细节。
被问到硬件进步时,我提到了类 MESI 协议的改进和三维缓存封装,后者可以增加附近缓存的容量。我还介绍了合并 fetch-add 操作的研究,同时指出专有实现使当前硬件细节难以核实。
一位观众询问读取者加入和离开 left-right 的情况。目前注册时,读取者列表受互斥锁保护;已有读取者不必在每次读取时获取该锁。如果注册争用成为瓶颈,无锁链表可以减轻它,但必须谨慎处理写入者交换指针后的扫描。
谈到互斥锁实现,我介绍了 Linux 的 futex 支持和减小锁尺寸的优化。将小锁紧密排列本身可能引发伪共享。读写锁的实现变化更多,包括采用每核心读取者状态的方案。
被问及编译器优化时,我解释说,同步实现使用排序屏障,防止读取或写入以不安全的方式跨越锁操作。有些约束针对编译器,有些针对 CPU,有些同时针对两者;实现必须提供适当的顺序保证。
同频道的其他文章
 1:48:29EN → 简体中文
 1:36:37EN → 简体中文
 1:05:45EN → 简体中文
 1:25:00EN → 简体中文
 1:16:29EN → 简体中文
 27:39EN → 简体中文