30 秒看懂
Nathan Lambert 从早期研究讲到 2025 年以来快速涌现的推理模型。他比较 RLHF 与可验证奖励,回顾有影响力的模型,并解释大规模强化学习中的常见选择。
- 1两种奖励RLHF 常对主观偏好建模;RLVR 使用可检验的结果。
- 2两个扩展维度增加强化学习训练和增加推理计算影响不同阶段。
- 3R1 的催化作用DeepSeek R1 帮助推理模型训练成为受到广泛研究的开放问题。
- 4难度筛选训练可以集中在结果有差异、能够产生有用信号的提示上。
- 5开放问题强化学习的长期作用以及它对新能力的贡献仍在研究中。
要点建议
- 可验证奖励为数学和代码提供了清晰的训练信号。
- 训练时强化学习和推理时计算扩展相互关联,但属于不同阶段。
- 更好的模型、数据和基础设施促成了快速实验。
- 难度筛选和数值稳定性是反复出现的实际问题。
- 使用工具的智能体将推理训练扩展到更复杂的环境。
按章节阅读整理后的全文
推理模型基础
Lambert 比较 RLHF 和可验证奖励,并区分训练时和推理时扩展。他介绍推理轨迹与 pass@k。
本讲梳理推理模型、可验证奖励强化学习和推理时扩展的历史。它建立在前几讲的强化学习内容之上,讨论后训练方法和模型是如何发展到今天的。
Yann LeCun 的蛋糕比喻把自监督学习放在蛋糕主体,监督学习放在糖霜,强化学习则是顶端的樱桃。Lambert 认为,预训练、监督微调和建立在其上的强化学习阶段,与这个比喻有值得注意的历史对应关系。
RLHF 通常使用学习得到的模型为主观偏好打分,而 RLVR 使用可以检验的奖励,例如标准答案或代码测试。更精确的信号支持了大规模数学和代码训练,但实际流水线会混合多种方法。
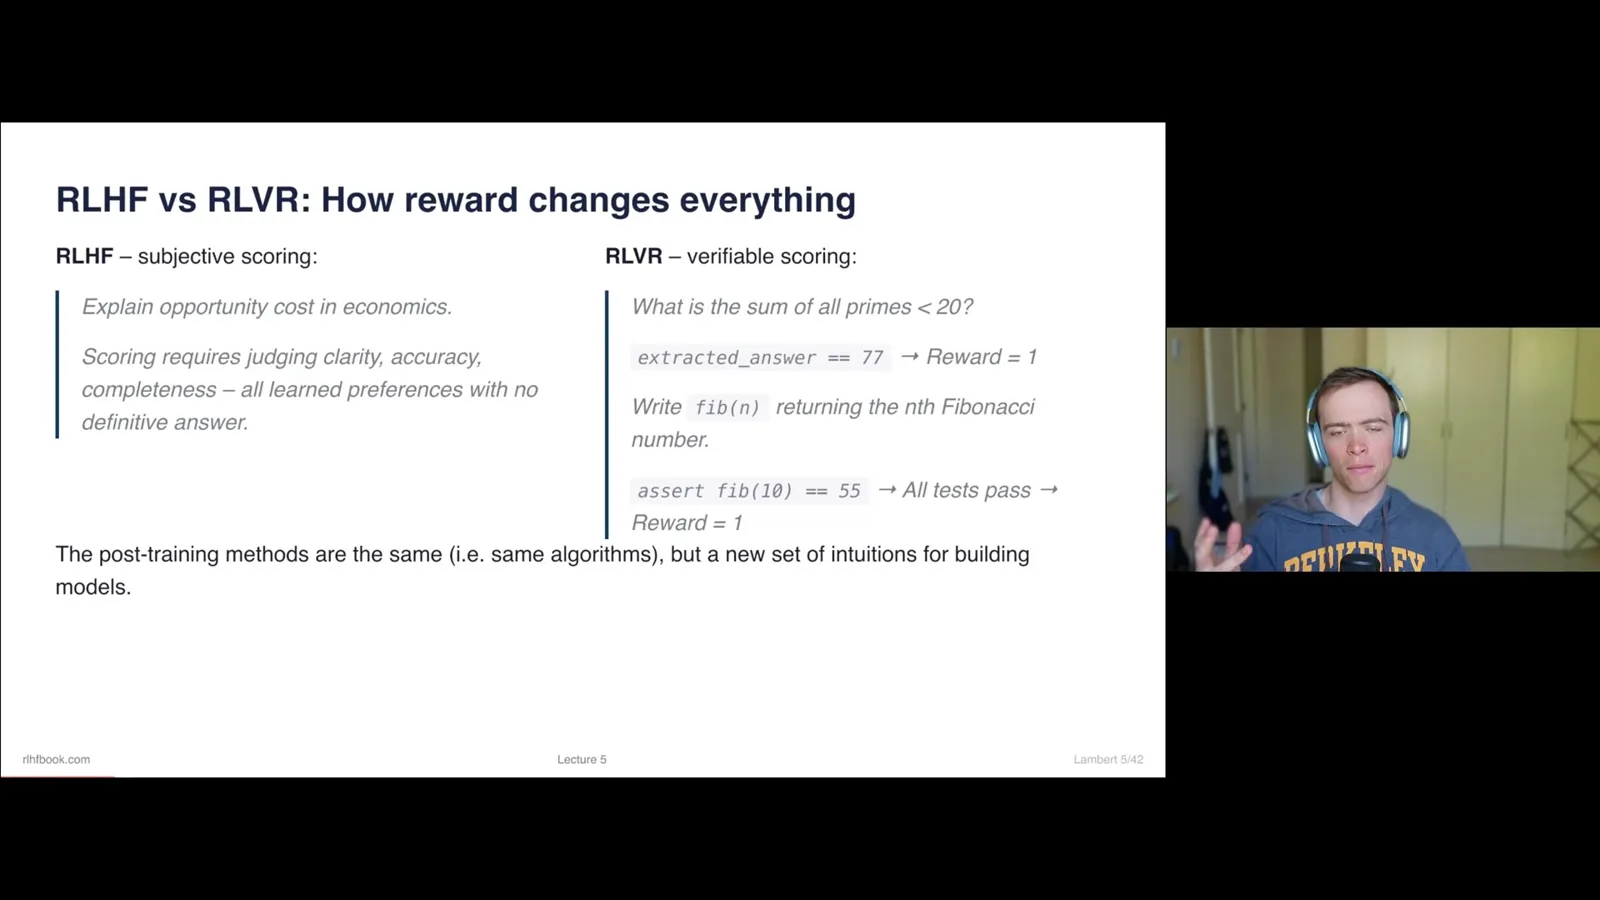
在 RLVR 循环中,模型尝试解决问题,再从验证器获得反馈。对于使用工具的智能体,验证器越来越像一个更丰富的环境。Lambert 预计,这些更复杂的互动既带来机会,也带来实现挑战。
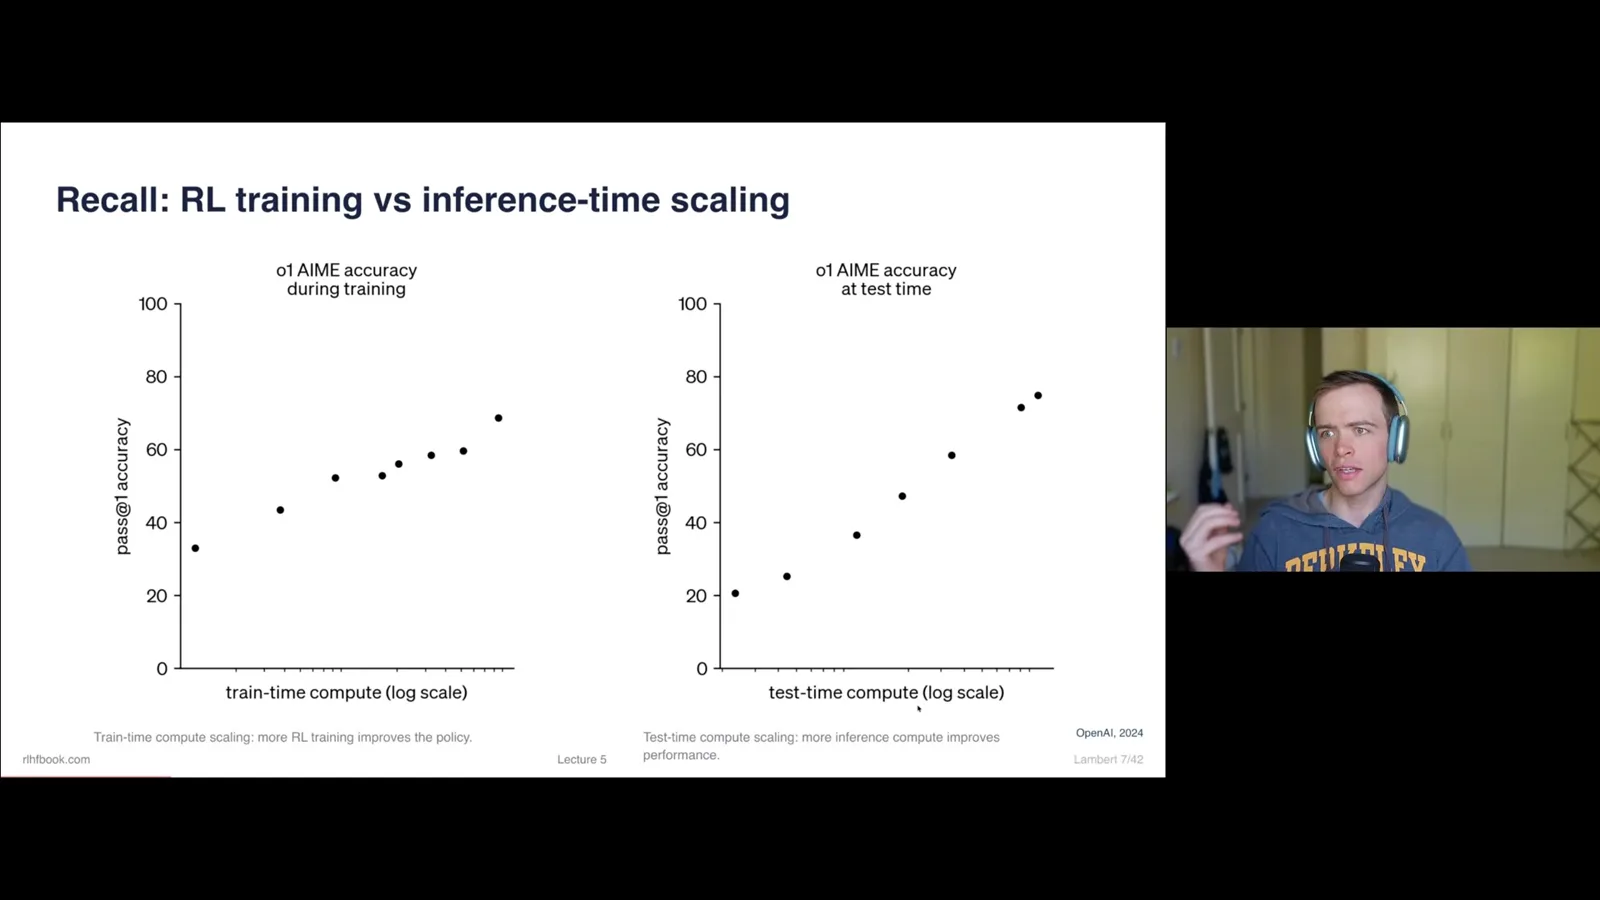
训练时和推理时计算是不同的。更长的强化学习训练可以改善策略;推理时生成更长的推理轨迹,也可能提高某些任务上的表现。Lambert 强调,这两种效应相互关联,也可以分别研究。
推理模型可能在最终回答前生成中间思维链。开放权重模型可以展示这些轨迹,其中可能有重复、检查和修订。这样的轨迹提供了一种观察额外推理计算如何使用的方式。
pass@1 衡量采样一次时的表现;pass@k 关注 k 次尝试中是否至少有一次成功。估计时可以采样更多次,再使用组合计算。给予模型更多尝试,通常会提高至少成功一次的概率。
Lambert 提到 DAPO 对 GRPO 类训练的修改,以及 MiniMax 的 CISPO,认为它们是影响后续工作的算法改进例子。随后他转向 2025 年快速接连发布的推理模型。
推理模型浪潮
早期研究、基础设施和更强的基础模型为 R1 和一系列开放发布铺平道路。Lambert 从多个模型报告中总结经验。
OpenAI 的 o1 在 2024 年出现,之后 2025 年迎来了 DeepSeek R1 和许多其他模型,包括 Kimi、Qwen 及研究复现。Lambert 将其视为领域的快速扩张,后续模型则更加重视工具使用和智能体。
o1 之前已有相关研究。STaR 和 Quiet-STaR 采样推理轨迹并保留成功示例;树搜索工作探索推理步骤;VinePPO 使用多次展开估计训练信号。这些方法各不相同,却与后来的 RLVR 有值得注意的联系。
Tülu 3 在通用模型上应用 PPO 和数学正确性奖励,同时保留更广泛的能力。Lambert 说,团队为这一方法创造了 RLVR 术语。该模型本身并非推理模型,说明多条研究路线最终汇合。
更好的基础设施让这一转变得以实现。到 2025 年,开放训练框架、更强的基础模型以及更高质量的数学和代码数据,支持了在 2023 年困难得多的实验。客观评估也比一些容易被刷分的聊天基准提供了更清晰的信号。
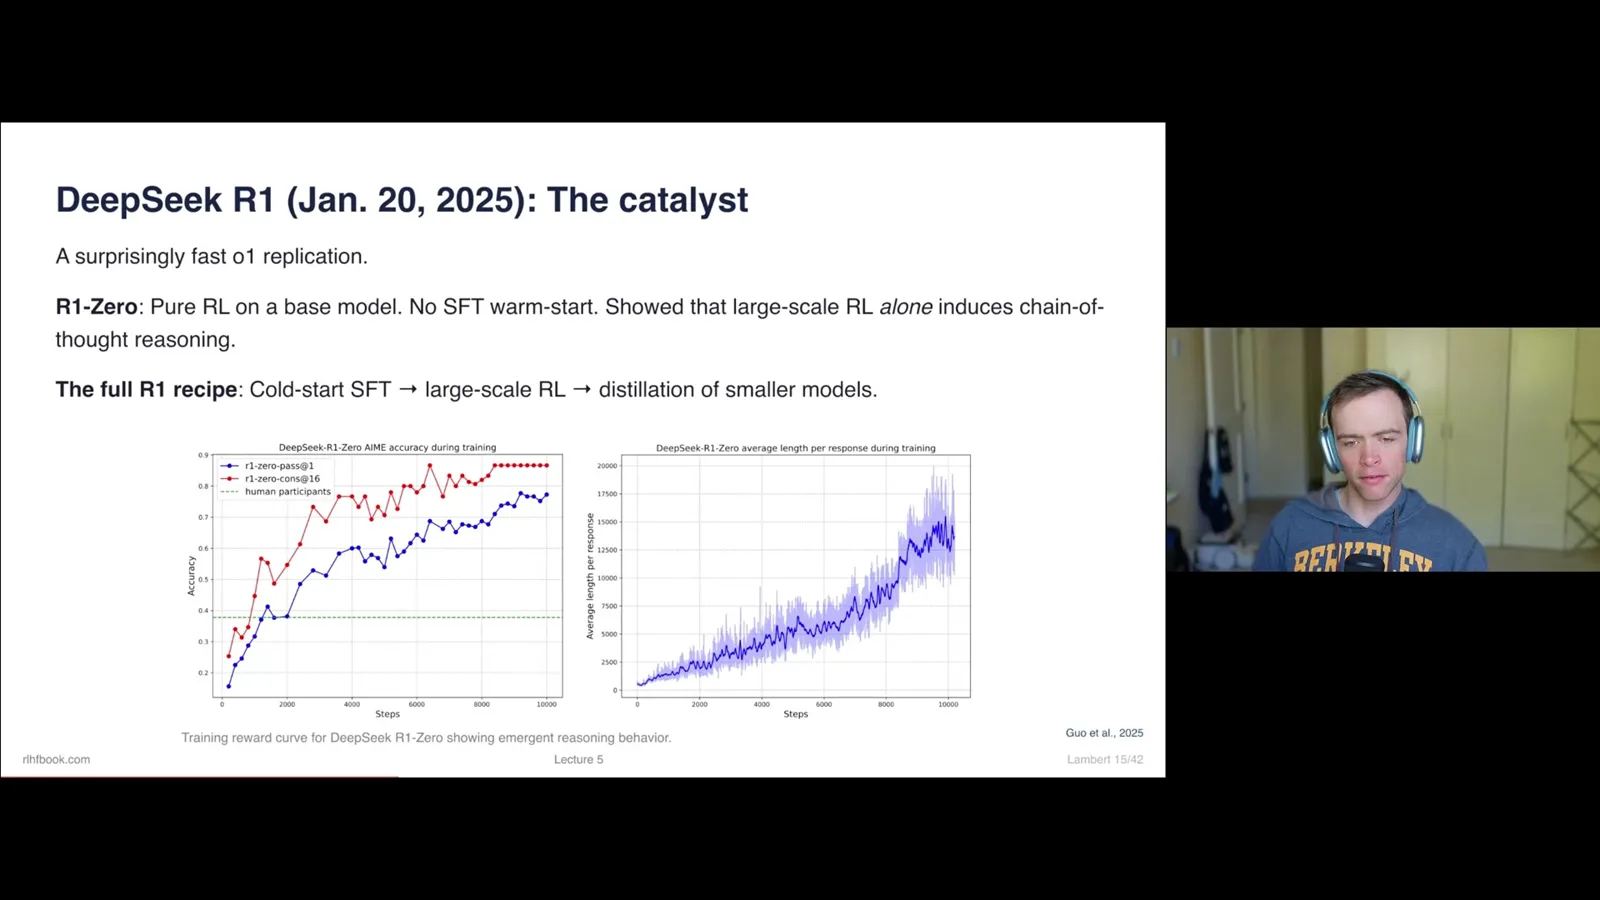
DeepSeek R1 描述了长时间强化学习训练方案,展示了训练期间推理表现和回答长度的增长。Lambert 认为其发布推动了开放研究,并表示这套方案一直具有影响力,直到后来的蒸馏方法逐渐受到重视。
Kimi 1.5 与 R1 同一天出现,但在他的叙述中受到的关注较少。其报告讨论了难度筛选、调度和逐步延长推理长度,这些技术后来仍然有用。
Open-Reasoner-Zero 提供了早期公开复现和训练数据。它使用 PPO,这让 Lambert 想起 GRPO 并非唯一可选算法。他认为价值模型方法在复杂、多轮工具使用中仍值得关注。
Qwen 3 让更强的基础模型广泛可用,并提供可切换的思考模式。Lambert 描述了业界对分离 thinking 和 instruct 模型的尝试,以及后来覆盖不同推理强度的模型。小模型的发布也让蒸馏技术更容易研究。
Xiaomi 早期的 MiMo 发布了基础、监督和强化学习检查点,方便研究者比较各阶段。OpenThoughts 3 是有影响力的推理数据发布;Lambert 说 OLMo 3 广泛建立在它之上,并呼吁重新投入基础开放数据集的建设。
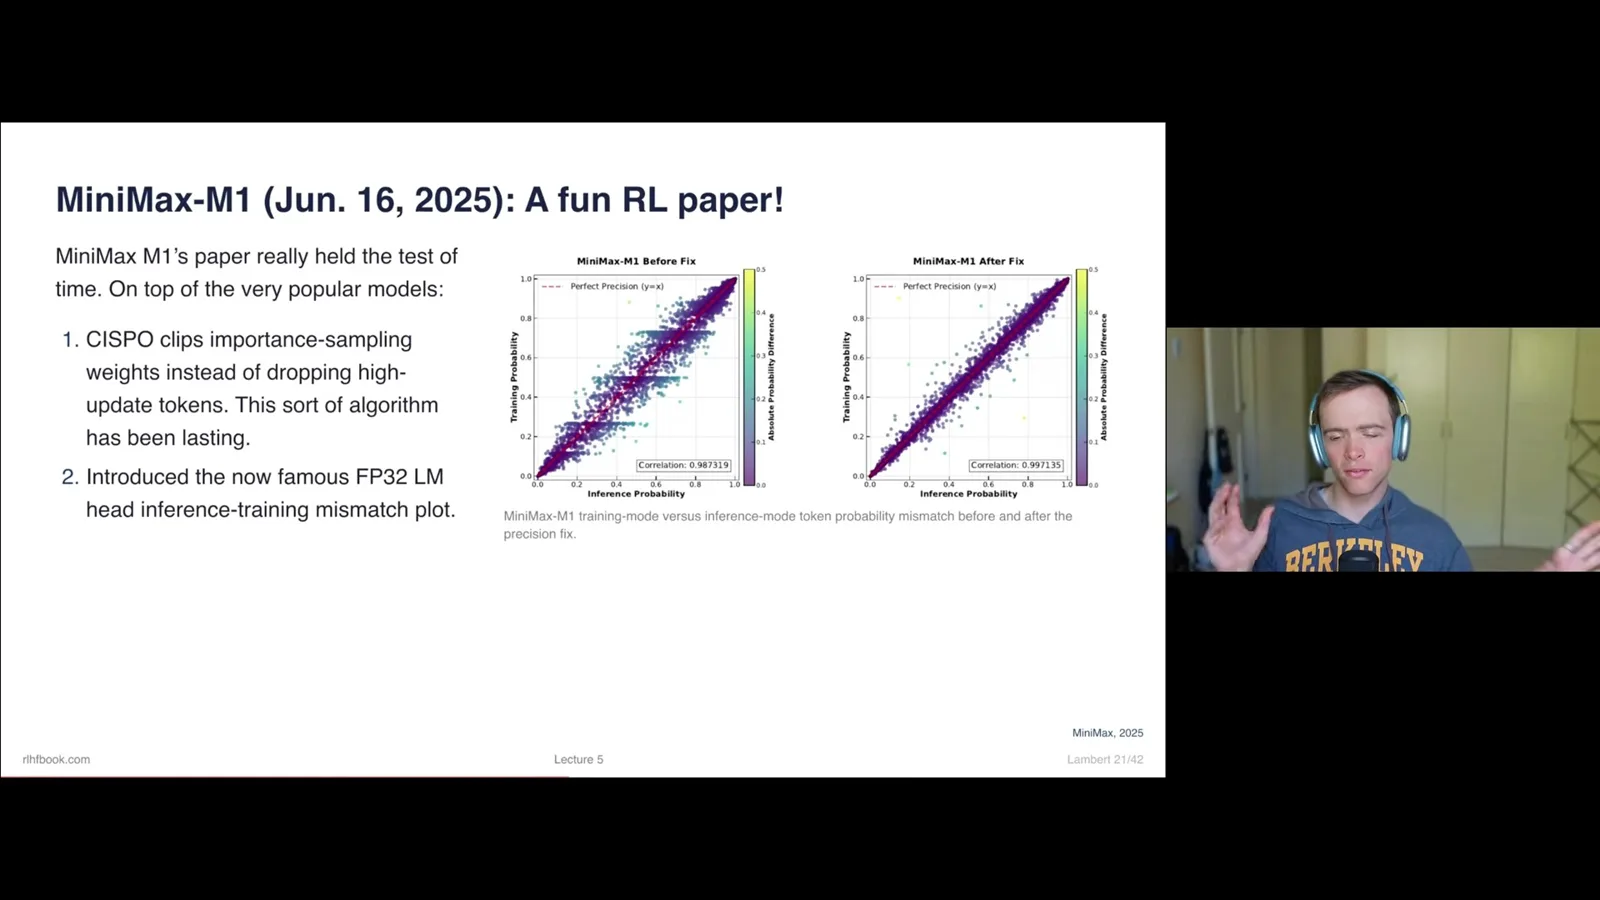
MiniMax-M1 突出了异步强化学习中的实际问题:推理和训练系统计算的 token 概率可能略有不同。语言模型头使用 FP32 可以缩小差异。其 CISPO 算法也成为后续工作中有影响力的参考。
Lambert 认为 GLM 4.5 较早展示了重心从数学与编程基准转向智能体和工具使用。他将这一转变与按有竞争力的时间表发布完整开放模型方案的困难作了对比。
他介绍,OLMo 3.1 Think 的多领域强化学习训练使用约 200 块 GPU 持续约一个月,并发布了检查点和数据供研究。他希望类似的完全开放工作也能覆盖工具使用推理。
后续发布包括 DeepSeek V3.2 和 NVIDIA 的 Nemotron 3 Nano,后者共享了数据、环境和检查点。Lambert 强调高效的长上下文架构和持续开放发布是这一发展过程的重要部分。
Lambert 将 Xiaomi MiMo-V2-Flash 描述为把多个专业教师蒸馏成一个通用模型的例子。不同团队可以开发各领域专家,再由共享方案整合。他指出,其他大型模型报告也描述了多教师方法。
他简要提到 2026 年的更多发布,并认为长时程工具使用是核心方向。纵观技术报告,反复出现的技术值得关注,但模型开发依赖此前路径:几个团队使用的技巧,并不保证适合每个模型。
常见训练选择
难度筛选、主动采样、KL、裁剪和长度控制反复出现在强化学习方案中。它们是否有用取决于模型和任务。
离线难度筛选先从初始模型采样回答,移除过于简单或困难的提示。对于组相对训练,如果一组结果完全相同,可能没有有用的相对梯度,因此筛选可以节省昂贵的训练算力。
在线筛选和课程学习会随着模型变化重新评估难度。OLMo 3 的主动采样保留具有非零梯度的组,替换所有采样回答奖励相同的组。目标是把训练资源用于能产生学习信号的样本。
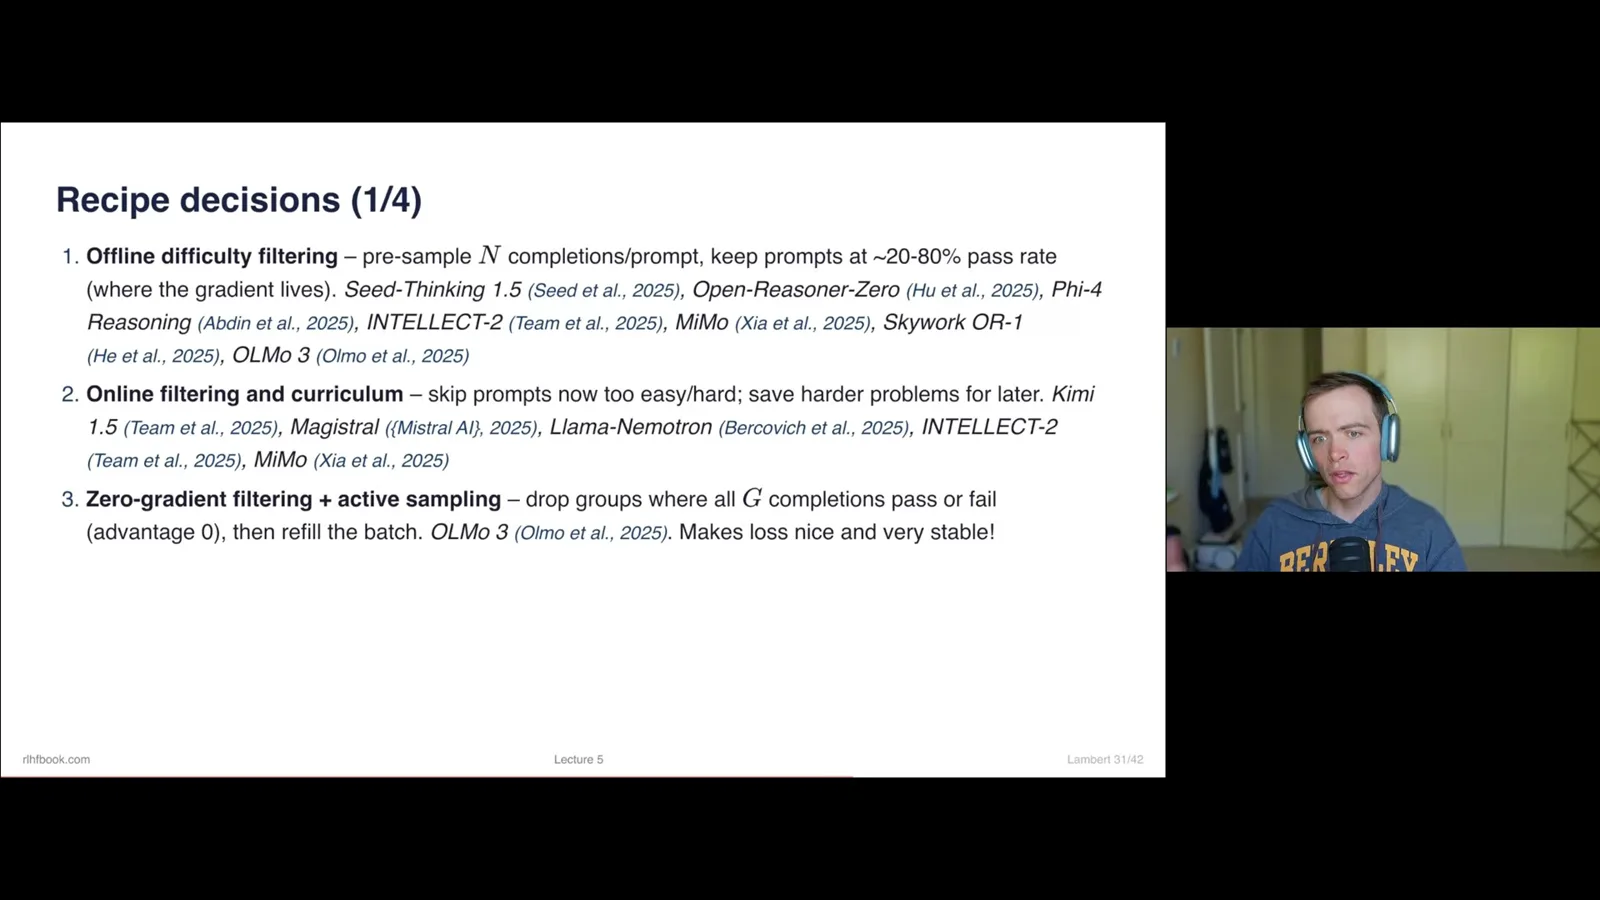
早期 RLVR 工作常去掉 RLHF 中使用的 KL 惩罚,因为可验证奖励似乎不容易出现同样的过度优化。Lambert 说,训练运行非常长时,约束模型的惩罚可能再次有用;合适选择取决于训练环境。
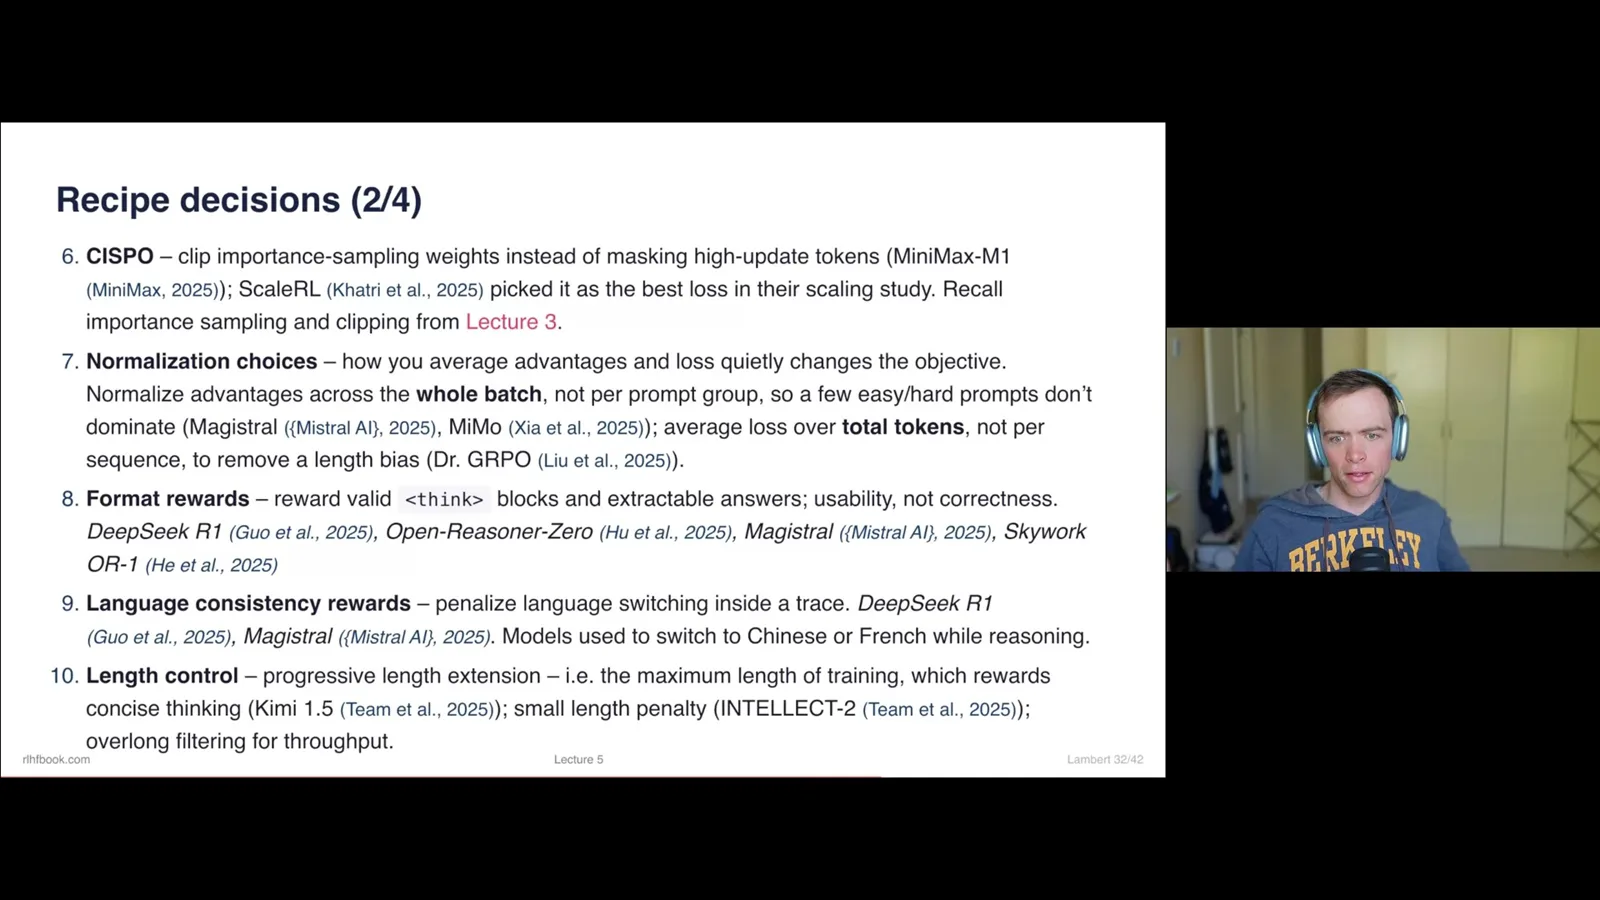
其他实现选择包括非对称裁剪、CISPO,以及优势和损失的归一化方式。按 token 或按序列聚合可能改变长度偏差与探索行为,因此代码细节会影响模型表现。
辅助奖励可以确保答案格式便于提取,或鼓励语言一致性。渐进式长度扩展先使用较短的思考预算,再逐步增加,让模型先学会简洁解决较容易的问题,然后探索更长轨迹。
技术报告还研究纯文本强化学习是否能迁移到多模态任务,以及中间训练如何影响后续强化学习。Lambert 希望看到更多公开证据,因为模型方案的不同阶段相互影响。
开放问题
智能体能力、算力扩展和未来后训练方案仍未定论。Lambert 介绍了开源训练工具。
开放问题包括:智能体强化学习是在教授新能力,还是主要激发已有能力;强化学习算力相对预训练将如何增长;哪些方案适合复杂环境。Lambert 认为强化学习可以教会模型新技能,但长期发展仍未确定。
构建模型需要把阅读研究与实践实验结合起来。Lambert 提到当时的开放强化学习框架,并指出工具使用和异步训练改变了研究者偏好的软件库。他最后邀请观众为后续课程视频提问。
同频道的其他文章
 16:48EN → 简体中文
 Nathan Lambert· 2026年11月2日Nathan Lambert:开放模型如何与前沿实验室竞争Nathan Lambert · Allen Institute for AI开放模型的用量正在增长,能力差距也在缩小,但开发者需要可持续的经济模式和价格之外的优势。
 48:04EN → 简体中文Nathan Lambert· 2026年10月26日Nathan Lambert:开放语言模型的历史、竞争与风险Nathan Lambert · Allen Institute for AI从开放权重、研究基础设施和蒸馏,到采用情况与模型开发者面临的选择。
 46:42EN → 简体中文Nathan Lambert· 2026年10月25日Nathan Lambert 与 Florian Brand 谈 Kimi K3.1、网络风险和 AI 智能体Nathan Lambert, Florian Brand · Allen Institute for AIInterconnects 主持人讨论模型评估的分歧、安全漏洞披露潮,以及个人智能体在日常生活中的作用。
 5:42EN → 简体中文Nathan Lambert· 2026年8月12日修格斯为何成了 AI 后训练的吉祥物Nathan Lambert · Allen Institute for AINathan Lambert 追溯了这种怪物从洛夫克拉夫特小说走向语言模型、微调与 RLHF 视觉隐喻的历程。
 32:56EN → 简体中文Nathan Lambert· 2026年8月6日Nathan Lambert:AI 角色训练入门Nathan Lambert · Allen Institute for AI从 constitution、model spec 到人格实验和激活引导,理解后训练如何塑造模型行为。
 32:11EN → 简体中文Nathan Lambert· 2026年8月5日Nathan Lambert:语言模型评估如何演变Nathan Lambert · Allen Institute for AI从少样本提示与 pass@k,到智能体沙箱、分数噪声和基准污染。