30 秒看懂
Robinhood 报告,截至 2026 年 8 月,约 60% 的数据流水线拉取请求无需人工审查即可合并。Chetas Joshi 将成果归因于混合关卡:确定性检查核验注册表与血缘事实,AI 审查者搜索代码中检查遗漏的风险,敏感或不确定的情况交给人。团队报告漏报率约 2%,并根据人工反馈手动更新规则;拟议的统一架构尚未构建。
- 1脚本、代理和人分别负责不同审查工作合并需要确定性检查通过和审查批准;敏感或不确定的决定交给人。
- 2通过检查的模式变更隐藏了未登记的下游故障代理发现一个任务把扩展后的列写入更窄类型的目标列。人工确认该任务在线运行后,先修复下游表。
- 3人每周更新规则;审查者不会自动重训团队每天收集审查回复,由值班工程师手动调整规则。
- 4报告的漏报率为 2%,但没有统一的误升级数字Joshi 说,过度谨慎的审查也会浪费人工时间,因此两类错误都值得关注。
- 560% 的流水线 PR 无需人工审查即可合并截至 2026 年 8 月 31 日,Joshi 还报告人工审查工作量减少 75%,每月节省约 132 个工程工时。
- 6当前并行系统缺少共享的运行状态代理无法看到脚本的实际运行结果,也无法调用实时检查。拟议的统一入口尚未构建。
要点建议
- 用确定性检查核验权威系统中可查的事实,让代理判断需要上下文的风险。
- 敏感授权、数据含义变化及低置信度决定必须由人处理。
- “搜索范围内没有找到使用方”不等于证明任何地方都不存在使用方。
- 同时衡量漏掉的问题和不必要的升级,两者都能帮助改进规则。
- 明确保留人工反馈与规则更新流程,不要假设审查者会自动学习。
按章节阅读整理后的全文
为什么 CI 通过不能证明流水线变更安全
AI 创建拉取请求的速度超过了小型数据平台团队的审查能力。团队在脚本、代理和人之间分工。
一个拉取请求修改了数据流水线的模式,并通过所有自动检查,但这仍不足以证明它安全:下游使用方可能出错,数据更新可能超过时限,变更还可能暴露本应受限的数据。
Chetas Joshi 在 Robinhood 数据平台团队构建数据摄取和处理系统。他介绍了一套生产数据流水线变更审查系统,覆盖模式、代码、配置和访问授权。编程助手创建请求的速度超过了少数具备审查背景知识的人能够阅读的速度。
现有的持续集成检查和人工审查能够发现代码错误、低效查询、下游故障和敏感数据风险。限制在于审查者的时间和知识:谁读取一张表、表有多大、内容有多敏感,都需要相关背景。
团队把责任分为三部分:确定性脚本根据权威系统核验事实,AI 代理判断需要上下文的风险,明确受保护的决策则由人负责。合并前既需要检查通过,也需要获得批准审查。
脚本检查失败会让 CI 标红并阻止请求。代理的指令说明了脚本覆盖的内容,让它专注其他风险。Joshi 说,这样也能节省成本,避免调用模型重新寻找脚本就能查询的事实。
模式变更通过检查,却可能藏着未知使用方
脚本检查数据契约、标签、已登记血缘和性能,其视野受所查询系统的记录范围限制。
贯穿演讲的示例在数据湖表中新增一列,并把现有列从 integer 扩展到 big integer。类型扩展看似无害,但团队还要追问下游谁会读取这一列,以及数据血缘系统是否记录了所有使用方。
第一层脚本将模式和键与模式注册表比较,检查每张表是否有负责人、个人信息是否已标注;事实不符合要求时阻止请求。示例中的上游新列和标签都通过了检查。
另一个脚本遍历已登记的血缘,检查下游任务是否受影响。预发布环境的性能测试使用生产规模的模拟数据,检查集群配置和数据更新时限。示例中两项检查都通过,但血缘只能覆盖实际记录到的关系。
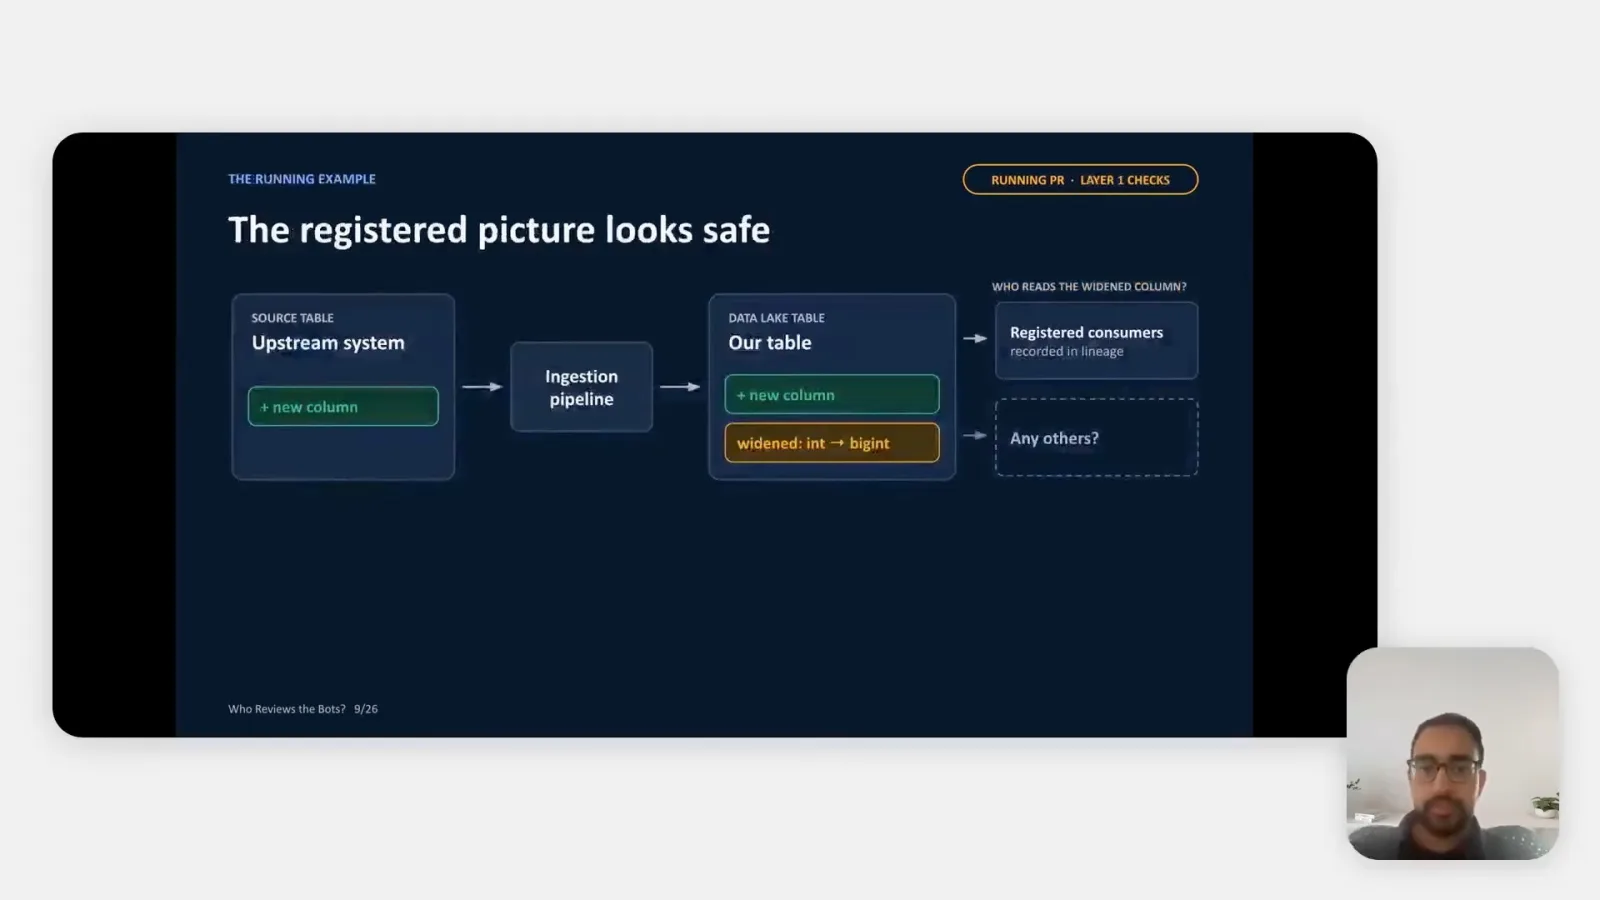
代理发现未登记的下游任务
代码库搜索发现了血缘遗漏的较窄目标列。人工确认任务运行后,先修复下游表。
代理读取差异、请求描述和提交信息,再搜索代码库中的文件。作者意图能够提供背景,但不能推翻与之矛盾的代码。它的工具只能读取、搜索和列出代码库文件,不能查询实时目录、血缘系统或生产状态。
规则按变更类型区分,重点关注高成本查询模式、敏感数据访问和未登记在血缘中的使用方。代理沿着流水线定义和访问授权查找关系,替代部分原本需要人工追踪的工作。
在示例中,代理发现一个未登记任务:它读取扩展后的列,再写入另一张表,而目标列仍是 integer。一旦数值超出旧类型的容量,写入就会失败,尽管所有已登记检查都显示通过。
不同查询引擎各自发布数据血缘,某个引擎未发布就会留下缺口。代码库搜索也有另一种盲区:代码库之外的临时查询和仪表板不会出现。代理可以说在已搜索范围内没有找到使用方,却不能声称任何地方都不存在使用方。
审查结果包含针对具体代码行的评论、推理和风险分数。低风险请求可以由代理批准;严重风险会携带证据升级给人工调查。合并同时需要脚本通过,以及代理或有权限的人给出批准。
对于扩展列的案例,人工审查者确认未登记的使用任务在生产环境中实际运行。团队先扩展下游目标列,再合并原变更。Joshi 说,这通过调整顺序避免了事故,并不是否决该变更。
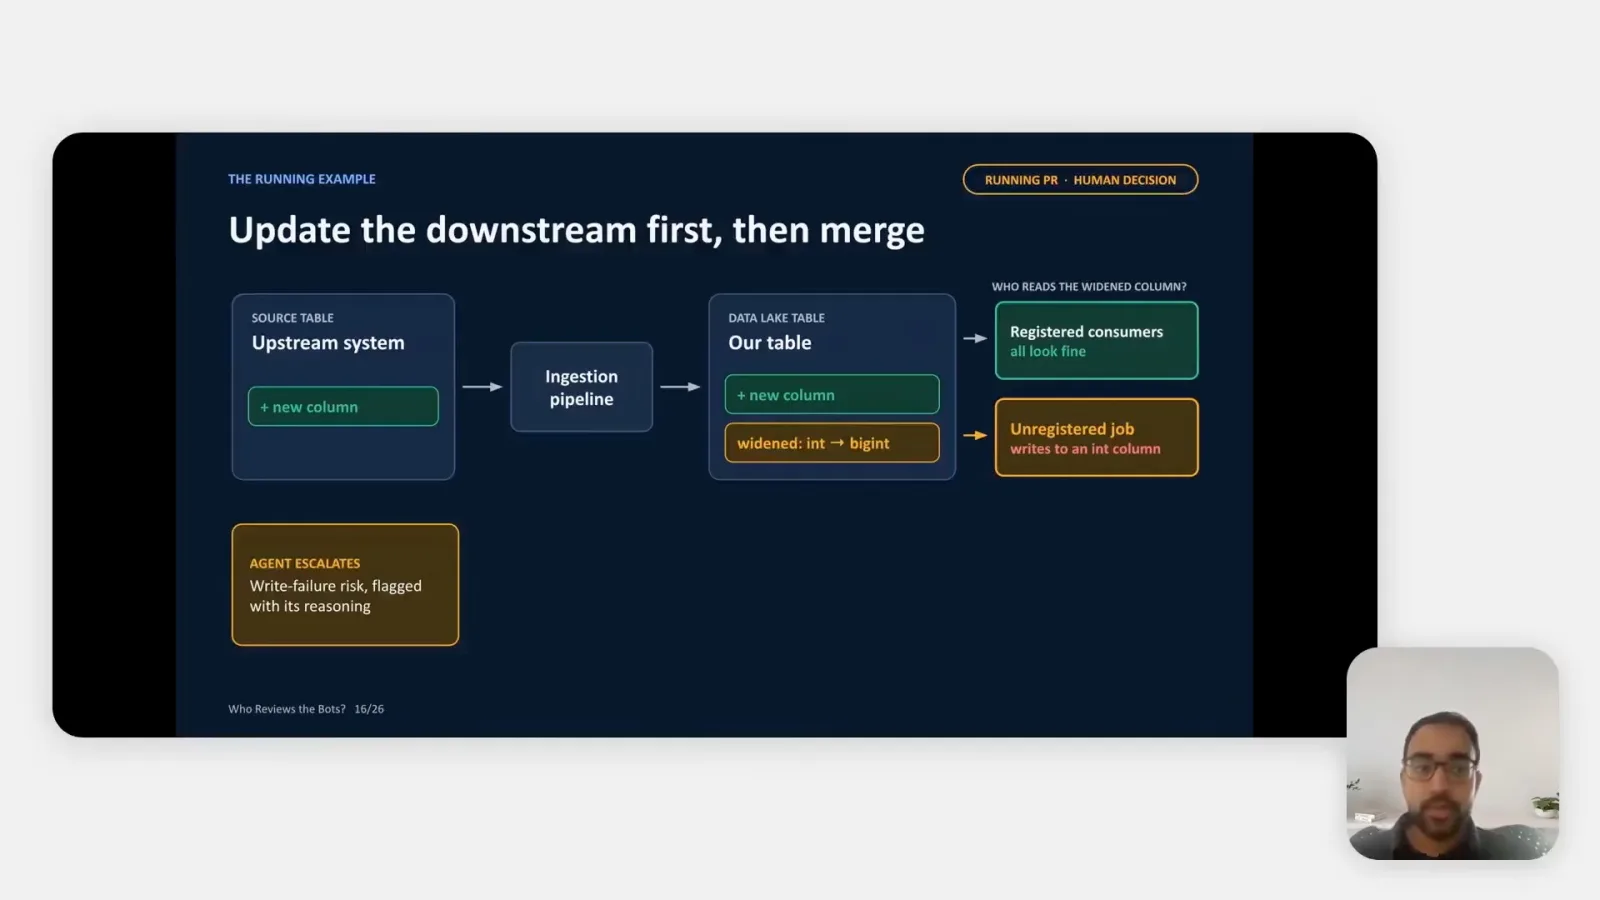
受保护的决策与人工反馈
敏感授权、语义迁移和不确定判断必须由人处理。值班工程师根据审查回复手动修改规则。
有些决策始终交给人:涉及敏感数据的授权、改变数据含义或意图的迁移,以及代理自己缺乏信心的审查。代理可以解释风险,但不能仅因为没有发现具体问题,就批准这些受保护的情况。
人工审查者回复代理评论,说明同意或不同意及其原因。回复每天收集,值班工程师每周阅读并手动更新规则。目前系统不会自动重训或修改规则;团队考虑引入调查代理协助,但尚未构建。
另一个案例中,源列标为个人信息,但流水线写入数据湖前已对其加密。代理反对把数据湖中的列标为非敏感;作者和人工审查者认为,在这条具体流水线中该分类合适。这种纠正可减少相似的无谓升级。
Joshi 提醒,这并不意味着加密总能让数据变成非敏感信息。结论取决于具体流水线及其写入前如何处理该值。
统计漏掉的风险和无谓升级
团队报告漏报率为 2%,但没有统一清晰的误升级数字。一次隐私重标漏报促成了一条新规则。
团队跟踪两类错误:代理批准了有问题的请求,以及把安全请求不必要地升级给人工。如果所有请求都升级,可能减少漏报,却无法减轻审查工作。截至 2026 年 8 月 31 日,报告的漏报率约为 2%;Joshi 说,团队没有一个清晰统一的误升级数字。
一个漏报案例涉及重新标为敏感数据的列:它们从开放数据副本移到受限副本。下游读取任务仍依赖旧副本,因此列消失后发生故障。团队新增规则,搜索仍在读取即将离开开放副本的列的使用方。
结果与尚未构建的架构提案
Joshi 报告截至 2026 年 8 月审查工作量和事故减少。现有并行系统缺少共享的运行状态。
Joshi 报告,截至 8 月 31 日,约 60% 的数据流水线 PR 无需人工审查就合并,人工审查工作量下降约 75%,每月节省约 132 个工程工时,与这些 PR 相关的事故下降约 30%。受保护的决策仍需人工处理。
现有设计有一个弱点:脚本和代理相互独立、并行运行。代理知道脚本配置检查什么,却不知道实际是通过、失败还是发生故障。双方都缺少完整运行状态,一方无法完成时需要人工介入。
平台团队正在探索统一入口:整体查看 PR,决定哪些变更一起审查,并把第一层检查提供给代理作为可调用工具。Joshi 明确表示,这只是提案,并非已经投入生产的系统。
他的结论是:用成本较低的确定性检查证明权威事实,把敏感或不确定的决定留给人,同时统计误升级和漏报。目标是减少审查工作,同时保留责任机制。
同频道的其他文章
 38:50EN → 简体中文
 AI Engineer· 2026年11月10日LinkedIn 的自我改进代理,先要修好评估裁判Ziwei Guo, Saloni Gandhi · LinkedIn一个提示词优化循环改进了职业代理,但团队首先需要通过人工校准提高评估器的可靠性。
 12:57EN → 简体中文AI Engineer· 2026年11月10日Harvey 的代理扩张后,平台和合并队列接连遇阻Joey Wang · Harvey告警启动 900 个代理、一名工程师发出 950 个任务后,Harvey 增加了去重和公平调度。
 19:41EN → 简体中文AI Engineer· 2026年11月9日高可靠自动化的第一步:把难处理的案例分流出去Matthew Jewkes · Standard CyberneticsMatthew Jewkes 介绍如何在生物医药文档索引流程中区分关键错误、模糊判断和异常情况。
 52:08EN → 简体中文AI Engineer· 2026年11月9日编码智能体压垮自托管模型时,应尽早拒绝请求Harshul Jain, Parv Khatri · Audible准入控制可以保护 GPU 容量,但评测时必须计算所有到达的请求,包括被拒绝的请求。
 22:01EN → 简体中文AI Engineer· 2026年11月9日Zach Lloyd:让软件工厂可以衡量和修改Zach Lloyd · WarpWarp CEO 建议记录智能体运行、评估失败原因,并用真实任务测试工作流的改动。
 27:35EN → 简体中文AI Engineer· 2026年11月9日Uber 为加快 AI 时代的代码合并,放弃主干始终通过测试Preetam Dwivedi, Manjari Akella · Uber合并队列放宽部分冲突限制,合并后再验证组合状态,并保留已验证的可用版本。