30 秒看懂
OpenAI 的 Alex 和 Erika 说,GPT Live 可以在后端智能体执行较长任务时继续语音对话。他们的画图游戏演示将语音、界面和后端分开,再将更新作为静默上下文、可说出的评论或指令发送回来。两人还对比了客户端管理的委派和 Responses 委派,并演示在背景音中继续对话。
- 1语音模型自行处理打断和发言时机讲者介绍同时输入和输出音频,无须由独立检测器判断用户何时说完。
- 2后端可以绘图,同时语音对话继续演示将用户界面、语音模型和后台任务分开。
- 3将更新作为上下文、评论或指令发送不同信息流分别影响语音模型知道什么、说什么或如何行动。
- 4委派可以使用已有后端或 Responses API客户端委派由应用执行后端工作,Responses 委派则由 OpenAI 管理。
要点建议
- 用户可能询问进度但不需要持续播报时,可在后台静默更新语音模型。
- 根据需要选择让后端更新改变上下文、提供发言内容或改变指令。
- 已有框架可使用客户端委派,需要托管后端调用时可使用 Responses 委派。
- 用不同模拟用户和背景条件测试语音行为。
按章节阅读整理后的全文
能够同时听和说的语音模型
讲者用两个语音会话演示打断、个性和评估。
GPT Live 工程师 Alex 和与语音初创公司合作的 Erika 与名为 Marin 的语音智能体一起介绍 GPT Live 1。他们演示同时听说、任务委派以及背景噪声下的表现。
讲者说,模型持续流式接收和输出音频,而不是依赖明确分开的用户与助手轮次。它可以边说边听,并决定何时回应。
他们引入第二个声音 Colin,进行合作讲故事的游戏。Colin 是独立的 GPT Live 会话,拥有自己的声音和指令。
对话中出现了打断和简短反应。Alex 说,模型自行处理发言时机,无须依赖独立的语音活动检测器判断对方是否说完。
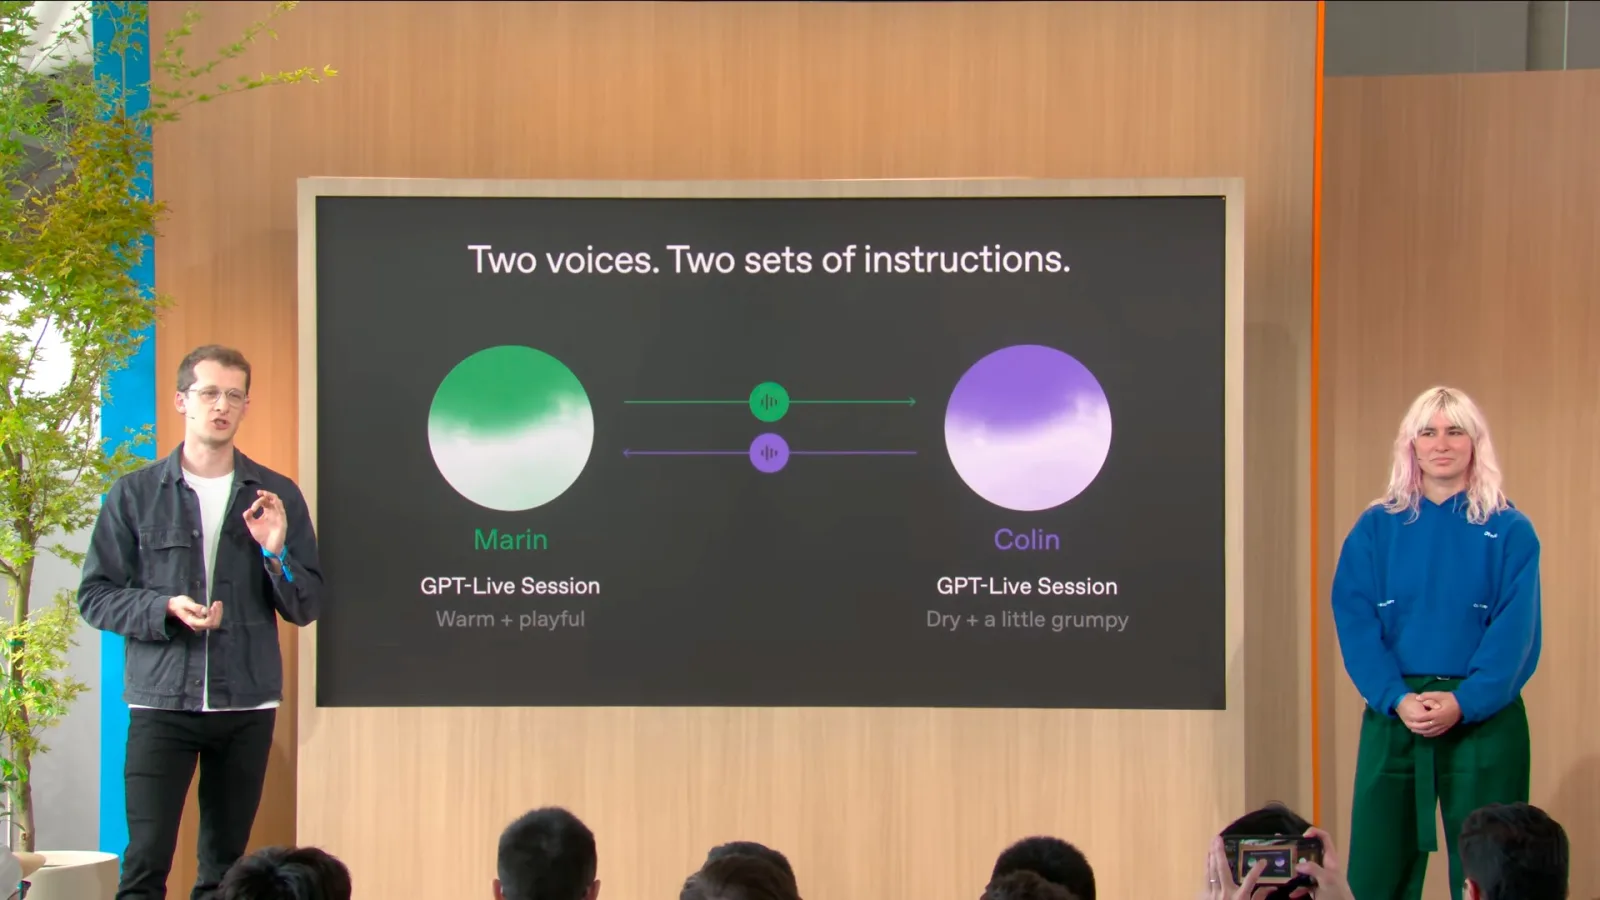
第二个语音会话也可以在评估中扮演模拟用户,使用指定的声音、性格和目标。团队用这种方式排练了演示。
Erika 说,提示词可以调整语气、口音、笑声、简短回应以及语音打断或等待的倾向。合适的行为取决于产品需要积极的伙伴还是耐心的倾听者。
委派绘图,同时继续对话
游戏将语音界面与后端及视觉界面分开。
下一个演示是画图猜谜游戏。后端负责画图,Marin 同时与观众交谈并回应猜测。
委派让语音模型在更强的模型或智能体处理复杂请求时继续流式对话。后台任务完成后,结果可以返回给语音模型。
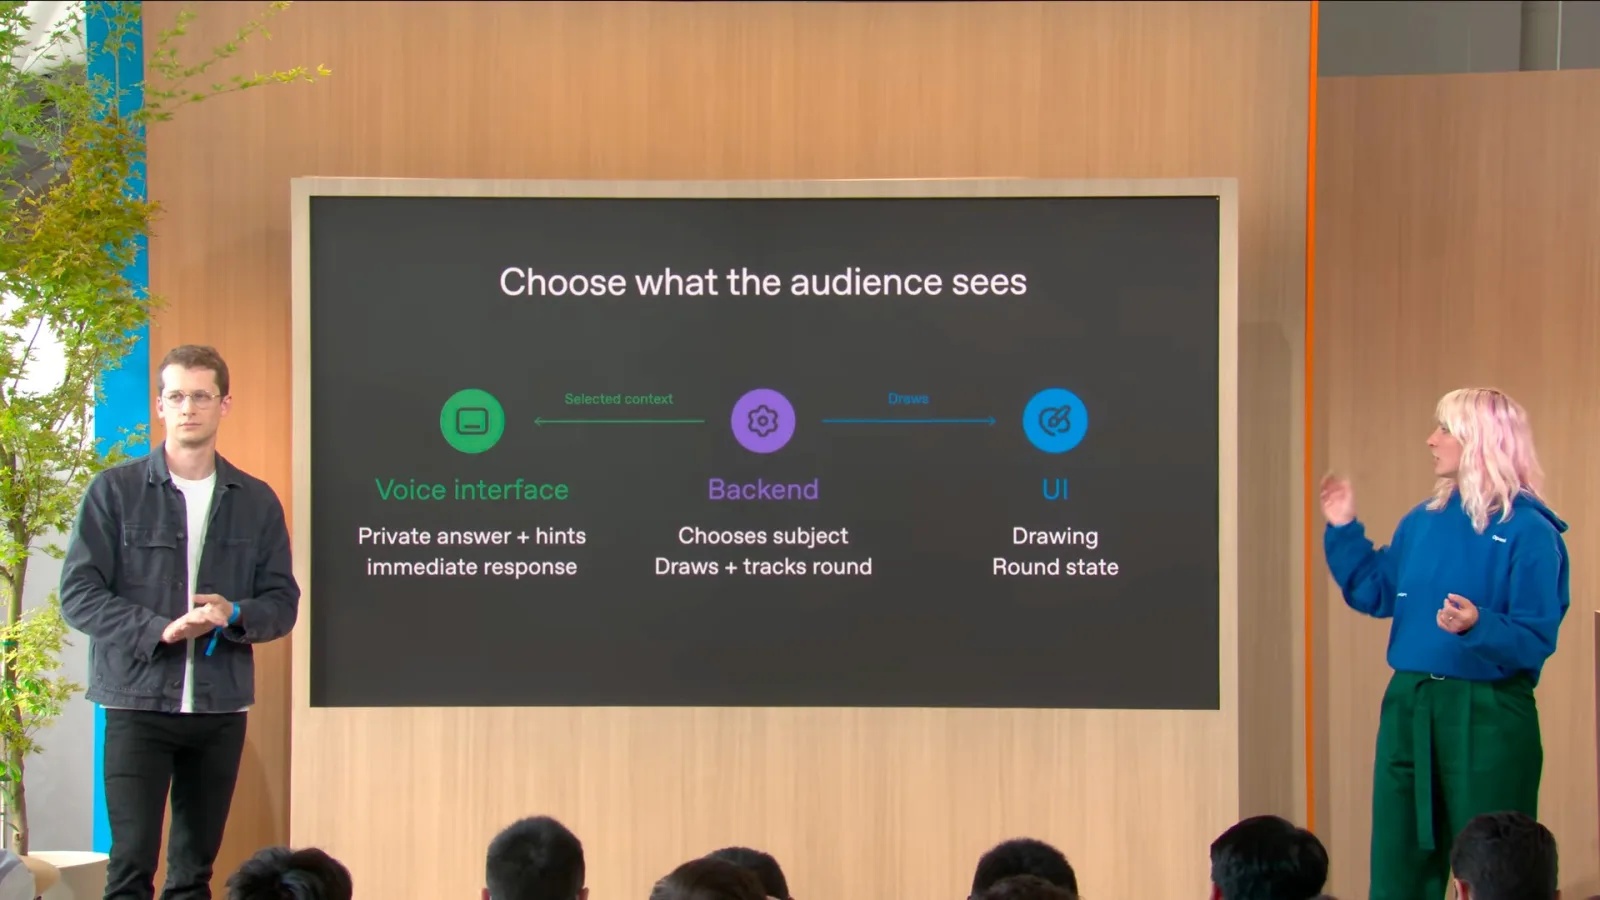
游戏将视觉界面、语音界面和后端分开。语音模型收到答案和提示,因此可以立即回应猜测,而后端同时绘图并记录本轮状态。
选择后台更新如何影响语音
静默上下文、评论和指令分别服务于不同目的。
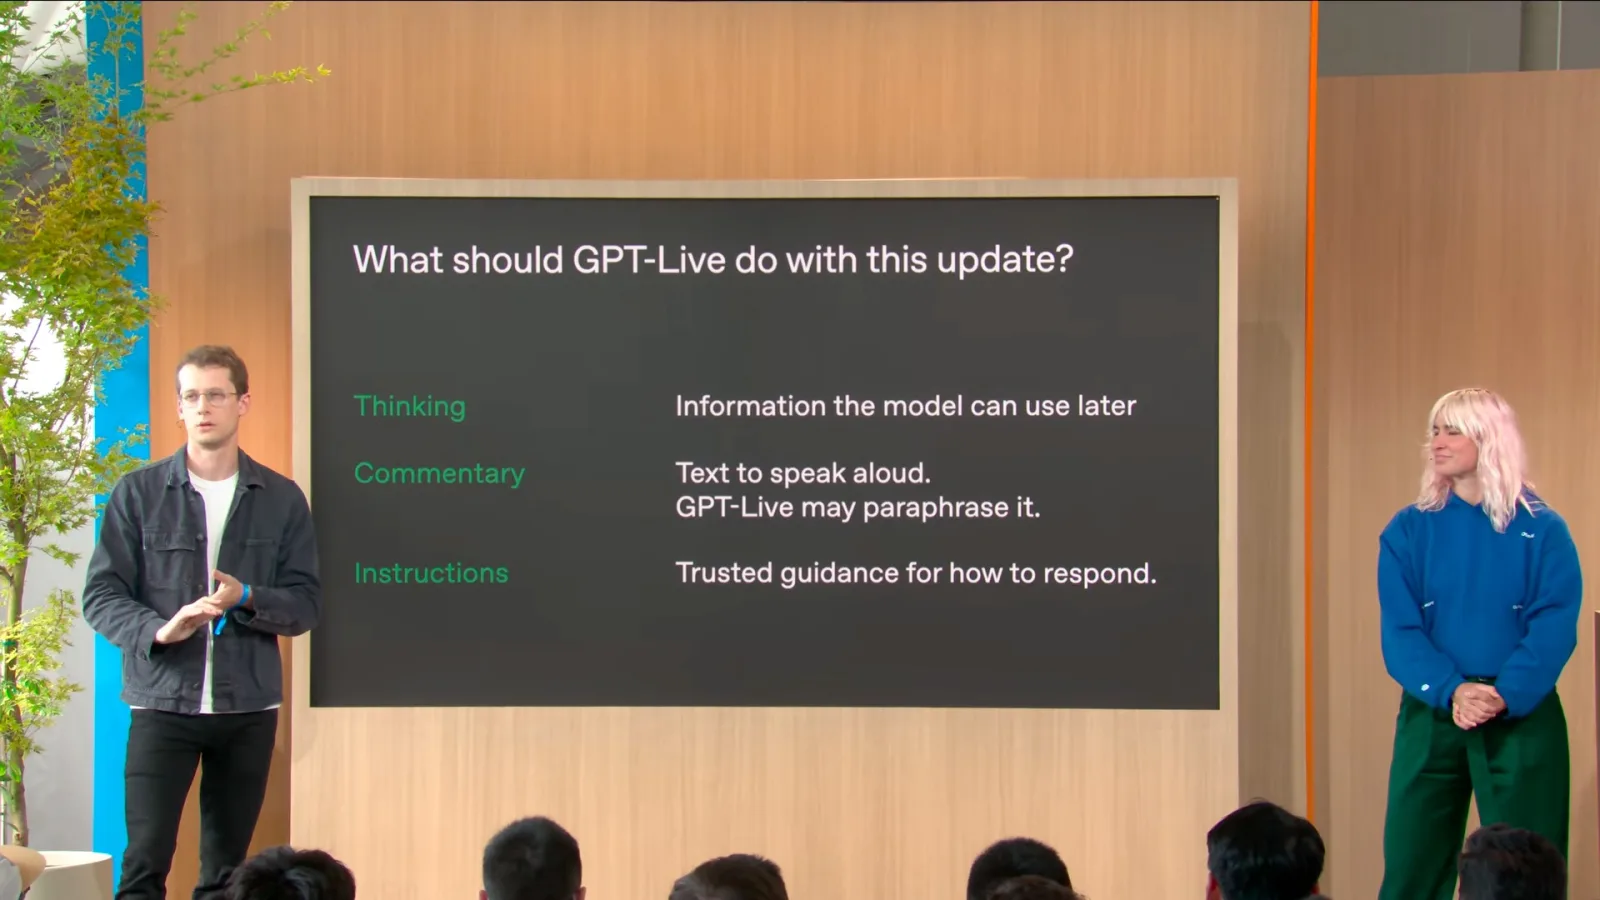
后端可以向模型的思考流发送静默上下文更新,让语音模型了解进展,从而在用户提问时无须每次重新委派任务。
评论流可以提供要说出的内容,指令流可以改变行为或设置约束。应用决定哪些信息应保持静默、被说出来或作为指令。
团队发现,在长期 Codex 任务中频繁播报进展可能令人分心。讲者建议在后台保持语音模型的信息更新,并考虑用户已经能够在界面上看到什么。
选择委派模式
客户端委派和 Responses 委派提供不同的后台执行方式。
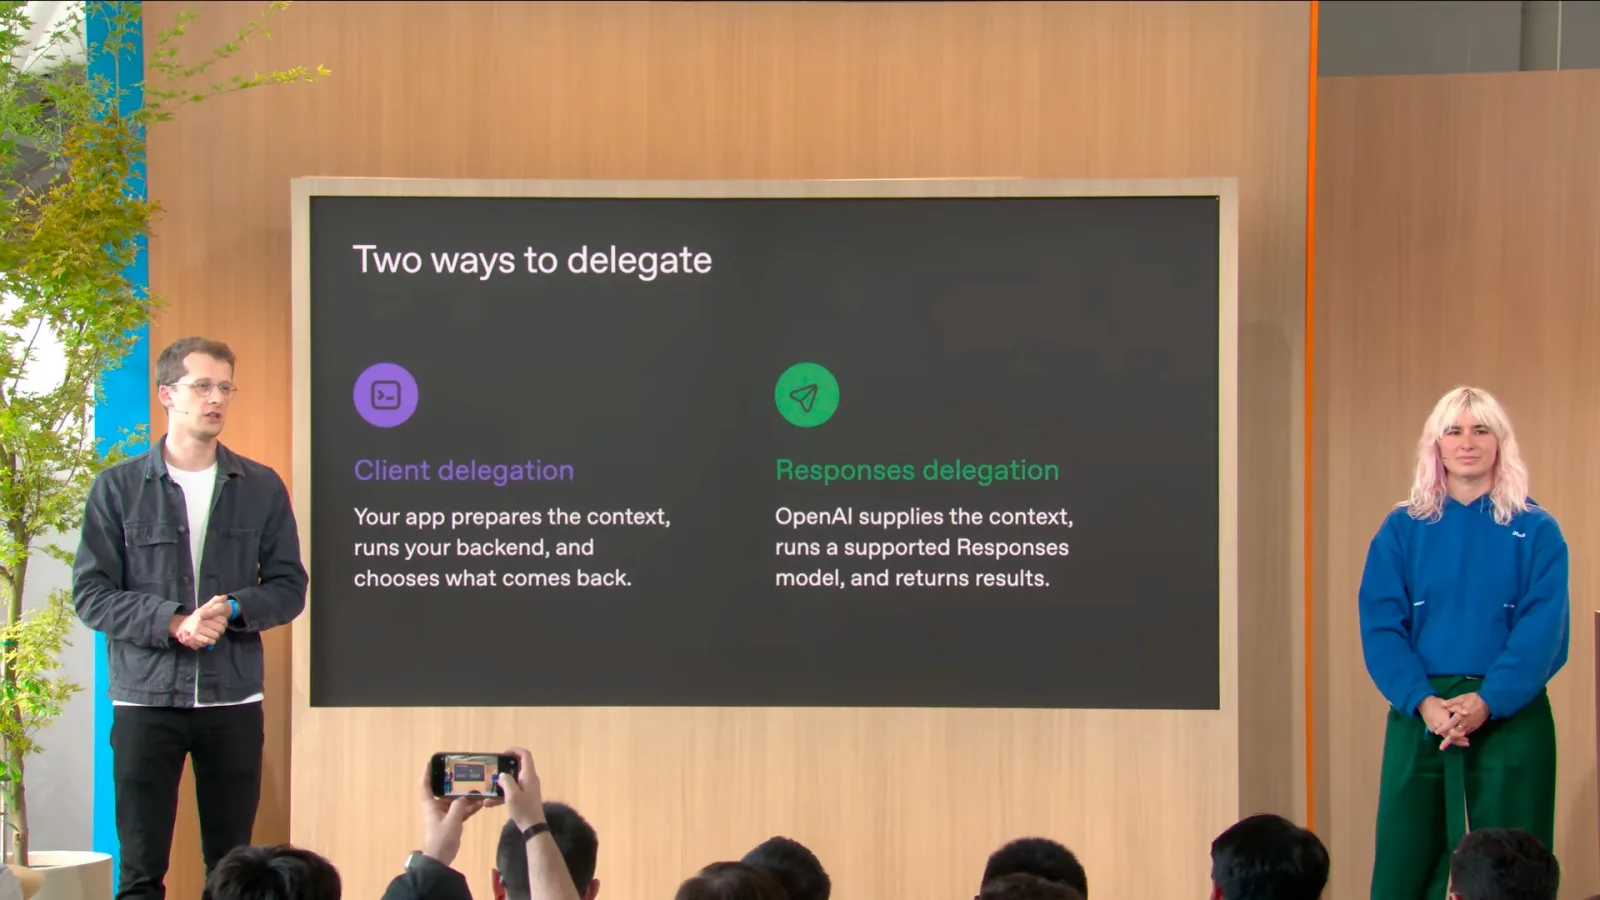
使用客户端委派时,应用接收事件并运行自己的后端、模型或智能体框架。它可以利用文稿和应用状态准备请求,再通过选定的流返回结果。
使用 Responses 委派时,开发者选择 Responses API 模型并配置指令和工具;OpenAI 管理委派并提供对话上下文。还可以启用网页搜索和图像生成等托管工具。
在背景音中交互
团队演示持续对话,并以图像生成结束。
最后,团队播放较大的背景音,同时继续交谈、改变声音并发出请求。他们用此说明无须等待安静即可持续交互。
讲者认为语音可以让控件更容易使用:用户无须知道设置在哪里,只需描述想要什么。他们说,模型持续判断是说话、倾听还是调用工具。
最后,Marin 委派生成一组图片。团队说,应用设计者需要决定哪些工作交给后端、界面展示什么,以及语音模型需要知道或说出什么。
同频道的其他文章
 27:44EN → 简体中文
 OpenAI· 2026年11月11日插件扩展将交互式工具带入 ChatGPTCorey, Max Neuber · OpenAIOpenAI 介绍插件发现、侧边栏和文件入口、事件驱动自动化及修订后的提交方式。
 24:01EN → 简体中文OpenAI· 2026年11月11日智能体工作何时需要循环、子智能体和共享日志Raj, Eric · OpenAIOpenAI 的 Raj 和 Eric 解释持续工作、何时委派以及如何协调长期任务。
 21:10EN → 简体中文OpenAI· 2026年11月11日OpenAI 如何将安全发现转化为经过验证的修复Ian, Kyle · OpenAIOpenAI 工程师介绍 Codex Security 背后的扫描、去重和补丁验证循环。
 19:44EN → 简体中文OpenAI· 2026年11月11日托管智能体框架如何持续完成长期任务Charlie, Steve · OpenAIOpenAI 工程师解释远程沙箱、长期运行状态和需要人工批准的航班改签演示。
 27:09EN → 简体中文OpenAI· 2026年11月11日一次运行六周的编程智能体实践及其监督方式OpenAI 工程师介绍维护 CI 的智能体、长期上下文以及持续运行的成本。
 20:48EN → 简体中文OpenAI· 2026年11月11日Sites 增加个人连接器和面向智能体的网页应用功能Katia, John · OpenAIOpenAI 通过两个 Sites 应用演示定时更新、按用户使用的插件和 WebMCP。