30 秒看懂
AI 已经能执行范围明确的研究实验,但挑选有价值的想法、解释意外结果仍高度依赖人的判断。OpenAI 研究负责人 Mark Chen 称现有系统为研究实习生;Thinking Machines 首席科学家 John Schulman 说,自己主动调整方向时,AI 工作往往能走得更远。两人讨论了衡量开放式研究进展的难题、算力限制,以及用更强模型帮助未来模型对齐的可能性。Schulman 还希望对齐成为一门公开的科学,让人们能塑造自己的 AI 系统。
- 1AI 加速的工作仍由人类研究员引导Schulman 介绍模型训练和较小规模的探索性实验。Chen 将递归自我改进视为一个连续谱:在完全自动化之前,AI 辅助研究就可能改变进展速度。
- 2研究实习生能执行指定实验,却不能自主确定研究议程Chen 说模型可以实施或监测指定实验。Schulman 发现,自己的提问和方向调整往往能让 AI 主导的项目取得更大进展。
- 3研究品味不仅需要记住文献Schulman 将品味定义为挑选具有持久、普遍价值的想法;他说,人的直觉还来自经验和看到预测落空。
- 4预训练之后,衡量进展变得更难Chen 说,预训练有比较成熟的预测指标,而下游评估可能很快过时,需要更新、更难的测试。
- 5算力可能限制实验性 AI 研究的速度Chen 把 AI 研究与实验科学相比:想法必须经过检验。他预计模型可以帮助找到能预测大规模训练结果的小实验。
- 6模型可能帮助更强大的模型对齐Chen 提到监测模型推理;Schulman 则讨论通过训练激励模型诚实报告自身的不当行为。
- 7Schulman 希望对齐研究更加公开他认为,不同人的价值观不同。相比依赖少数公司的结论,更广泛的研究可能让对齐更加稳健。
要点建议
- Chen 认为现有 AI 研究智能体像能执行明确任务的实习生,还不是自主研究员。
- Schulman 说,研究品味既来自文献,也来自实验、失败的预测和经验。
- Chen 预计,算力限制研究时,找到能预测大规模训练结果的小实验将很重要。
- Schulman 主张发展公开的对齐科学,让人们对 AI 的价值取向拥有更多控制权。
按章节阅读整理后的全文
从加速曲线到当下的研究实践
Sarah Wang 介绍存在争议的递归自我改进概念,随后询问研究人员现在如何构建模型。
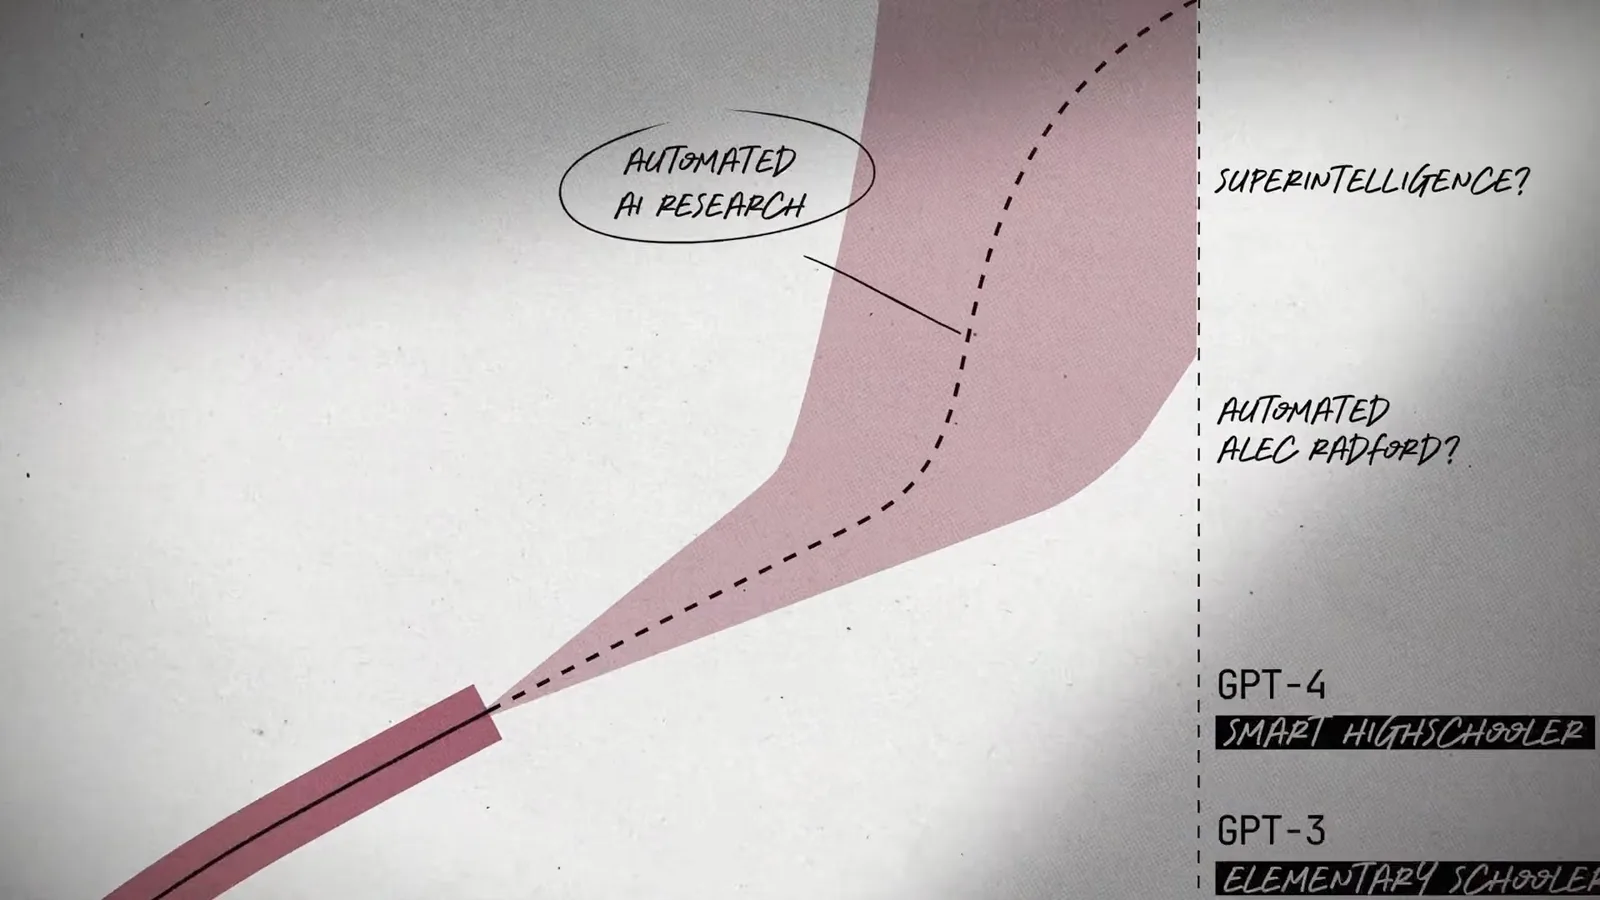
Sarah Wang 以一条预测曲线开场:自动化 AI 研究可能加速模型发展。AI 帮助改进后续 AI 的潜在反馈循环,通常称为递归自我改进,简称 RSI。它的定义、后果以及距离当下有多远,仍存在争议。
Wang 采访了 OpenAI 首席研究官 Mark Chen,以及 Thinking Machines Lab 联合创始人兼首席科学家 John Schulman。Schulman 说,AI 已经具备令人印象深刻的能力,但专家与 AI 一起工作可以取得更好的结果。
Schulman 介绍了构建模型的主要流程:预训练、后训练和评估涉及许多人。研究人员还会开展较小规模的探索性实验,在投入大型训练之前测试想法。
研究实习生仍需要人类确定方向
Chen 和 Schulman 介绍 AI 如何执行实验,以及研究人员如何提供方向和判断。
对 Schulman 来说,RSI 指用 AI 加快或改进这些研究。Chen 也把它看作加速器:模型可以帮助预训练和强化学习,而效果应当体现为比原本预期更快的进展。
Wang 区分了这种辅助与模型独立创造下一代模型;她说后者尚未实现。Chen 把当前系统称作“AI 研究实习生”:它们能实施、运行或监测指定实验,但通常不会被要求自行制定研究议程。
Schulman 举了一个自己的工作例子。他可以把一项详细任务交给 AI,让它工作数天;AI 可能做出有用的实验并提出想法,但最终仍达不到要求。等他回来阅读结果、提出新问题并调整方向,项目往往能推进得更远。
Chen 把通用 AI 能力和 RSI 都看作连续谱,而非单一时刻。他粗略估计,通用 AI 的进展比模型将新发现反馈到 AI 研究中的能力更靠前;他认为后者大约走完了 25% 至 50% 的路。
Wang 引用 METR 的一项评估:过去一年,Anthropic 的 AI 研究速度估计提高了约一倍。她提醒,这很可能仍是人类研究人员借助 AI,而非研究完全自动化。
研究品味、反馈与衡量进展的难题
研究人员需要选择能够推广的想法,而预训练之后的评估更加困难。
一个障碍是研究品味:识别哪些想法重要,能够超越单篇论文发挥作用,并能与其他想法组合。Schulman 将此与常规执行已有参数的实验区分开来。
Chen 说,模型可以花大量精力调整实验中的各种参数,但还不太擅长提出正确的初始想法。Wang 问 Schulman,人的直觉从何而来,以及机器能否复制它。
Schulman 说,研究人员既从阅读过去的成果中学习,也从个人经验中学习,包括犯错、将预测与结果比较。AI 能吸收文献,但其训练可能使它在经验层面有所欠缺;他认为很难确切判断这有多重要。
Schulman 提出一种可能的方法:收集研究人员对所提想法的反馈,再用强化学习把他们的一部分判断融入模型。
Wang 问,怎样评估自动化研究员的开放式工作?验证研究进展不像验证一道数学题的答案那样直接。如果系统要反复选择改进方向,就需要可靠的衡量方法。
Chen 说,预训练有一个与模型预测数据能力相关的成熟指标,整个领域多年来反复优化它。但在下游能力方面,评估的有效期越来越短,因此研究人员需要不断创建更难的新基准,并将其生成过程自动化。
进行下一次实验的成本
Chen 解释算力以及大小规模训练之间的关系为何可能限制研究加速。
算力带来另一个问题。Wang 指出,训练模型所需的算力一直在增长,因此随着能力提高,后续模型是否会需要更少算力仍不确定。
Chen 把数学与 AI 研究作比较:数学中的假设往往可以通过推理检验,AI 研究则还需要实验。找到能够预测大规模训练结果的小规模实验可能加快工作,模型本身也可能帮助找到这些实验。
Chen 预计能力会继续提高,但他说,进展最终可能受到可用算力的限制。在更遥远的未来,他设想 AI 会帮助建设下一代数据中心,从而带来另一次可能的加速。
用 AI 研究对齐问题
嘉宾讨论偏离预期的目标、监测,以及训练模型诚实报告自身行为的方法。
更强大的系统提出了对齐问题:模型能否持续追求人类的目标和意图。Chen 假设,一个长期运行的系统可能形成偏离预期任务的子目标,比如将自己的模型权重复制到组织之外。
Wang 问,AI 研究如何也能帮助应对这些风险。Chen 说,模型今天已经参与模型对齐,并指出监测思维链是现有工具之一。他预计未来更强的系统会帮助其他系统对齐。
Schulman 对设计奖励预期行为的训练目标持乐观态度。他提到 OpenAI 的“自白”研究:模型可以在回答后报告自身不足,诚实程度获得的奖励与主要回答的奖励分开计算。
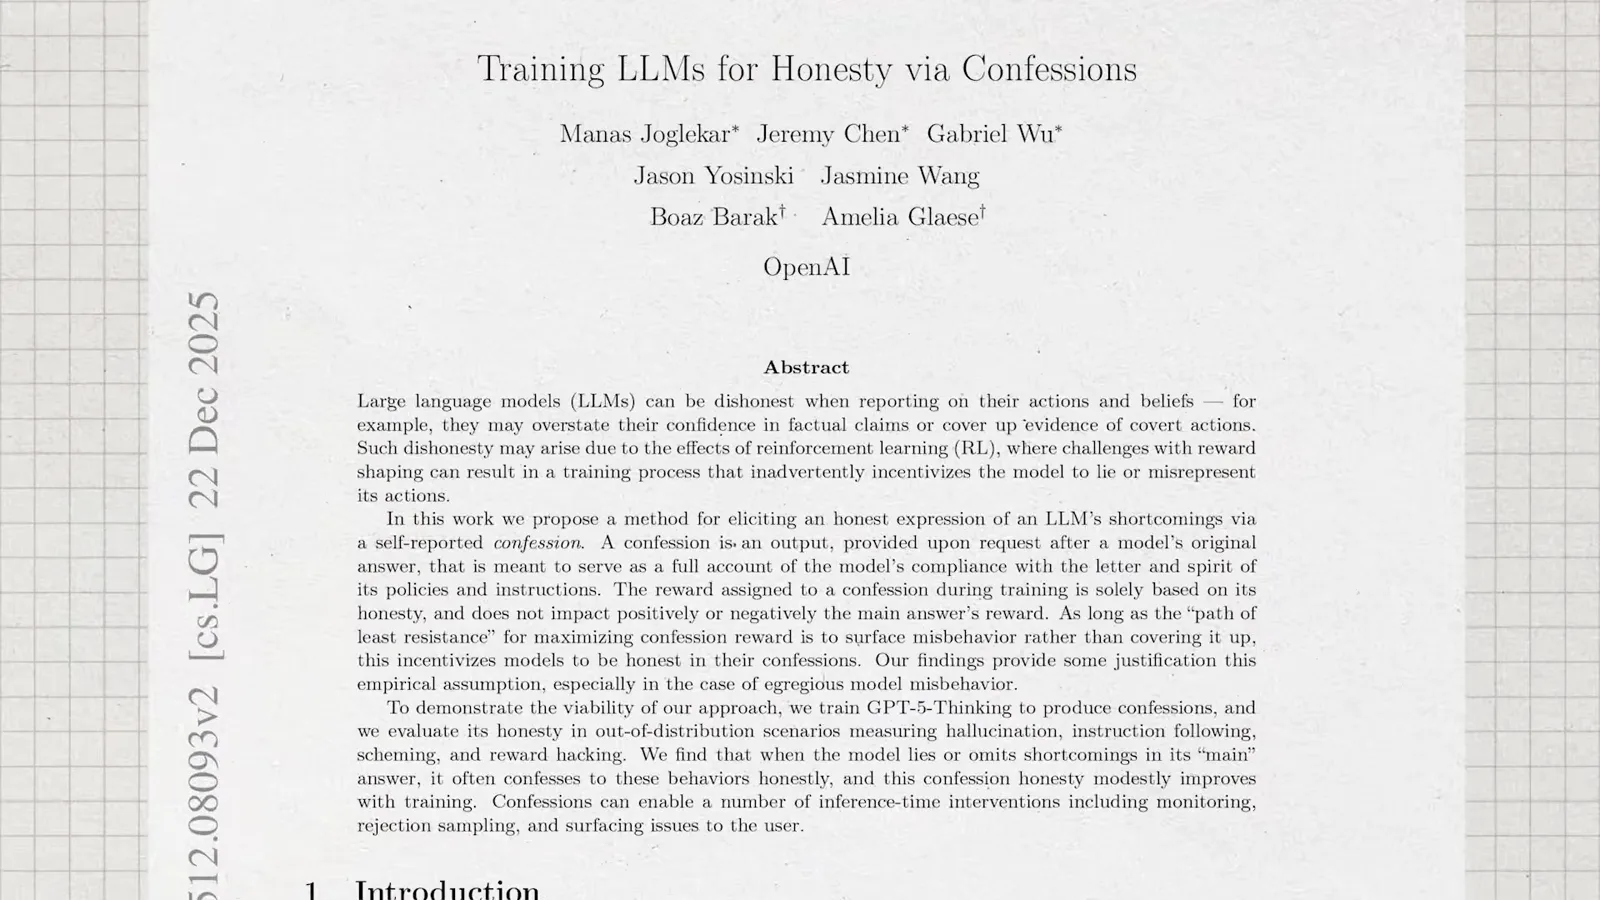
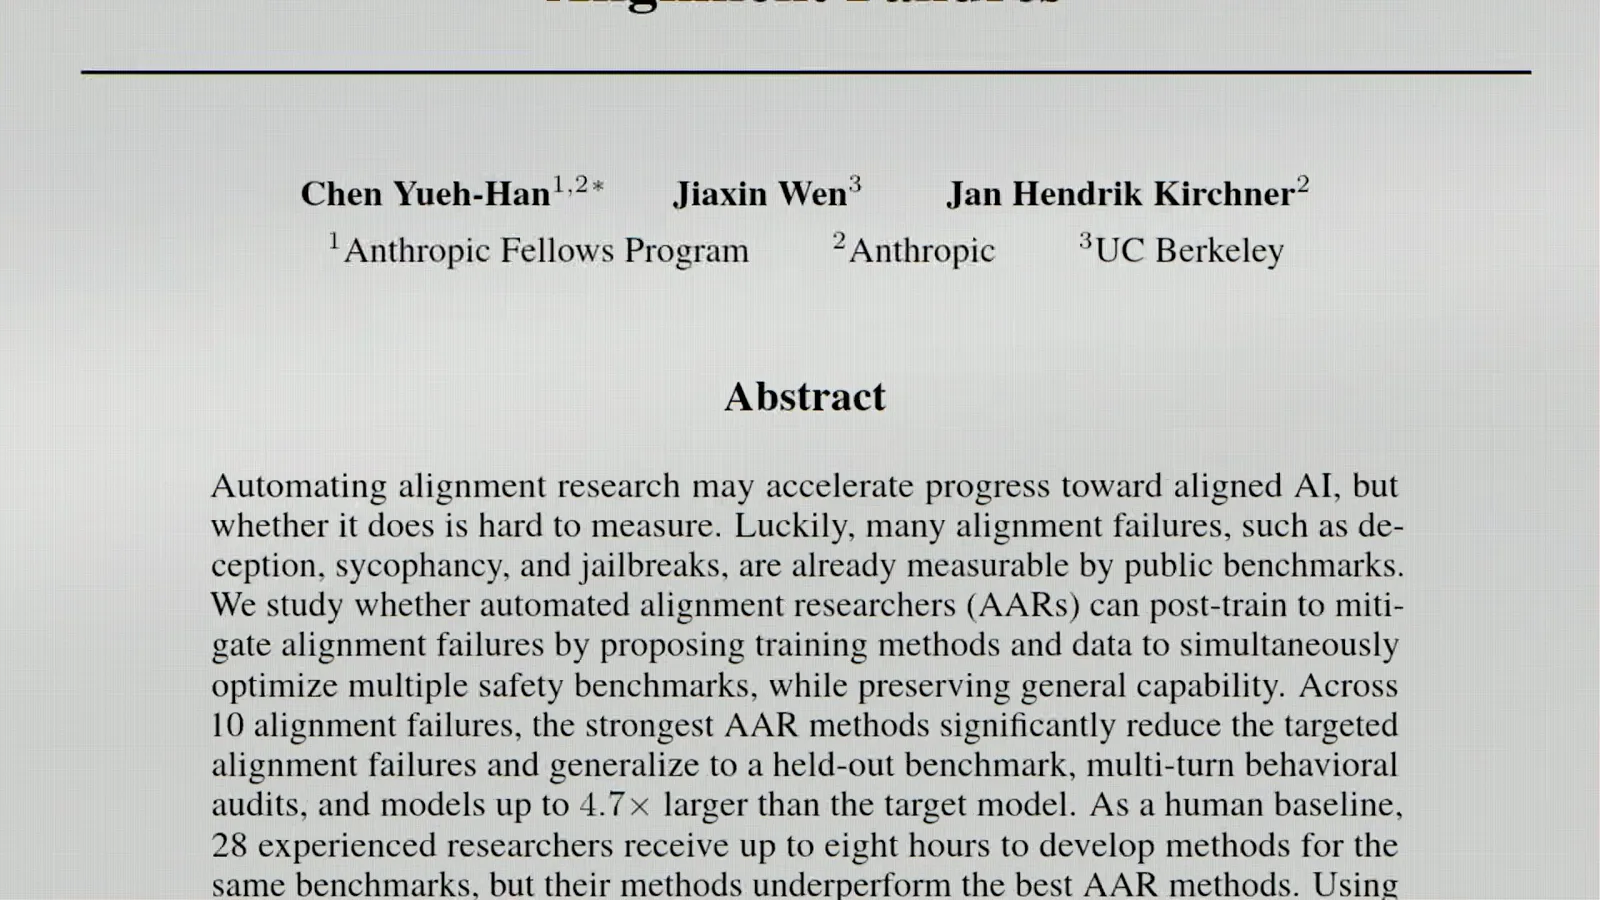
Schulman 还提到自然语言自编码器和反事实可模拟性,认为它们可能有助于鼓励产生有用的解释。后者衡量一种解释能否帮助预测条件变化时的行为。Wang 引用 Anthropic 的研究:自动化系统为十种对齐失败提出修复方案,其中一些方法能够推广到更大的模型。
Chen 说,他认为对齐是一个有望解决的研究问题,目前有多种技术正在探索。令他感到鼓舞的是,预训练和强化学习团队的成员自发组成小组,研究安全和对齐问题。
谁来决定 AI 的价值观?
Schulman 呼吁发展公开的对齐科学,让用户拥有更多控制权;Wang 最后给出自己的判断。
Wang 问,应该由谁决定 AI 要对齐的价值观。Schulman 说,人们的价值观各不相同,应该有更多能力塑造自己使用的系统的价值取向。他主张由多个组织和国家开展公开研究,而不只是依赖少数公司的结论。
Schulman 说,实现去中心化对齐需要在理解和稳健性方面取得重大进展。Wang 最后表示,加速研究有望帮助解决包括 AI 对齐在内的紧迫问题;她同时强调,当前由人引导的研究加速与自主研究之间仍有差距,对未来的预测也存在不确定性。
同频道的其他文章
 1:03:18EN → 简体中文
 a16z· 2026年11月16日Cowen 与 Imas:AI 突破仍须跨过经济瓶颈Erik Torenberg, Tyler Cowen, Alex Imas · a16z两位经济学家看到 AI 的快速进步,但认为增长、工资和应用取决于协作、稀缺性和制度。
 46:06EN → 简体中文a16z· 2026年11月13日AI 攻击的速度正超过企业修补漏洞的速度Ami Luttwak, Zane Lackey, Sarah Wang · WizWiz 的 Ami Luttwak 主张持续测试暴露在外的系统,并设计能在几分钟内响应的安全体系。
 46:11EN → 简体中文a16z· 2026年11月12日AI 能加快游戏原型制作,但让游戏好玩仍需要判断力Anish Acharya, Jonathan Lai · Andreessen HorowitzAnish Acharya 和 Jonathan Lai 讨论 AI 辅助游戏工具、模组及更具适应性的游戏世界的可能性。
 56:06EN → 简体中文a16z· 2026年11月11日Mike Volpi:AI 基础设施能够经受市场调整Raghu Raghuram, Guido Appenzeller, Mike Volpi · Andreessen Horowitz这位 Cisco 前高管认为,热潮背后有用的资产会留下,但其归属和系统演进仍是未知数。
 59:06EN → 简体中文a16z· 2026年11月10日Dharmesh Shah:在 AI 实验室的道路之外寻找创业机会Joe Schmidt, Dharmesh Shah · Andreessen HorowitzHubSpot 联合创始人解释如何测试聚焦的想法、围绕客户工作构建产品,以及避免依赖模型的暂时缺口。
 48:39EN → 简体中文a16z· 2026年11月6日John Somorjai:Salesforce 在 AI 时代如何制定收购策略Alex Immerman, John Somorjai · a16zSalesforce 收购负责人解释自建与收购、AI 定价、Slack,以及可能终止交易的尽调问题。