30 秒看懂
Matthew Berman 回顾 2026 年的安全事件,认为 AI 可以同时加速攻击者和防御者的工作。他讨论了 Google 威胁情报、恶意软件包行动、Vercel 遭入侵事件,以及 Anthropic 和 OpenAI 的安全模型,并预测攻击的经济模式将如何变化。本视频由 GenSpark 赞助。
- 1疑似 AI 辅助的零日漏洞Google 研究人员描述了一项计划中的大规模漏洞利用行动,并高度确信 AI 辅助了漏洞发现和武器化。
- 2软件包生态遭到攻击Mini Shai-Hulud 行动污染了软件包版本、窃取凭据,并包含一个破坏性开关。
- 3Vercel 的第三方服务遭入侵Vercel 将事件源头追溯到员工使用的一款第三方工具;尚无证据证实攻击使用了 AI。
- 4限制预览的安全模型Anthropic 和 OpenAI 介绍了限制访问条件下的安全用途,基准和部署均有其局限。
- 5较小目标的经济账Berman 认为,自动化可能让攻击低价值目标变得有利可图。
要点建议
- Google 研究人员高度确信 AI 辅助了一次零日漏洞利用行动,但具体使用了什么模型,以及计划中的大规模行动是否得到阻止,仍不确定。
- 即使开发者信任自己安装的软件,恶意依赖项和第三方服务仍可能导致凭据泄露。
- Anthropic 和 OpenAI 在限制访问的安排下介绍了网络安全能力;基准分数不能保证真实世界中的安全。
- 更快地发现漏洞可能有助于防御,但强大模型不能保证绝对安全。
- 更便宜的自动化将使攻击较小目标有利可图,这是一项经济预测。
按章节阅读整理后的全文
AI 与近期安全事件
Berman 介绍自己的担忧,讨论一起疑似 AI 辅助的零日漏洞事件和 Mini Shai-Hulud 软件包攻击。他披露了视频由 GenSpark 赞助。
我关注人工智能已经多年,但一连串网络安全事件让我产生了新的担忧。AI 可以降低发现弱点和发起攻击所需的时间与专业门槛,而防御者也在用同样的技术发现并修复弱点。我讨论的是这些力量可能如何相互作用,并不是说近期每起攻击都有 AI 参与。
Google 的威胁研究人员报告了一种零日漏洞利用工具,他们认为它由 AI 辅助开发。零日漏洞是指防御者可能还没有机会修复的漏洞。过去,攻击者可能会把有价值的漏洞留在手里,因为一旦使用,就可能暴露漏洞并促使对方修补。
[Google 的报告](https://cloud.google.com/blog/topics/threat-intelligence/ai-vulnerability-exploitation-initial-access)称,犯罪分子计划开展大规模漏洞利用行动,Google 的抢先发现可能阻止了这次行动。研究团队根据利用工具的特征,高度确信 AI 辅助了漏洞发现和武器化,同时表示认为使用的不是 Gemini。该漏洞可以绕过一款管理工具的双因素认证,但仍需要有效凭据。
在我看来,这初步表明发现漏洞可能变得更快、更便宜。不过,报告没有确定具体用了哪个模型,也没有证明所有计划中的漏洞利用都被阻止;这就是现有证据的边界。
另一起事件冲击了 JavaScript 软件包生态。攻击者在受信任的软件包中植入恶意版本,其中包括 TanStack 软件包,使软件依赖项成为进入开发者电脑和构建系统的潜在通道。
这次攻击还有破坏性功能:研究人员描述了一个监控程序,一旦被盗的 GitHub 令牌遭撤销,就可能删除文件。因此,修复需要按安全事件响应来处理,不能简单理解为关闭一个开关。受影响的团队应遵循维护者和安全响应人员的最新指导。
一个软件包看起来合法,仍可能携带恶意更新。我担心开发者安装依赖项和让自动化工具拉取依赖时过于随意,我自己也不例外。我们信任的软件包和服务越来越多,供应方遭入侵时可能造成的影响也随之扩大。
研究人员追踪了横跨 npm 和 PyPI 的更广泛 Mini Shai-Hulud 行动,数字也随着事件发展而变化。[JFrog 当时的分析](https://research.jfrog.com/post/shai-hulud-here-we-go-again/)描述了凭据窃取、传播和破坏性开关;其发现并未证实这次攻击由 AI 引起。
本视频由 GenSpark 赞助。Berman 介绍说,GenSpark Claw 是一种托管方式,让用户无须自行搭建服务器,就能通过消息应用使用 OpenClaw 风格的智能体。这些属于赞助商的产品说法;托管智能体本身不能免除对访问权限、配置和安全性的评估。
这些例子让我想到一个更大的问题:当能力更强的模型同时被用于攻击和防御,会发生什么?我想先看看已经报道的事件,再解释为什么我认为模型的相对能力和经济因素很重要。
Vercel 事件与 Google 威胁情报
第三方服务遭入侵影响了 Vercel;Google 则记录了数类与 AI 有关的威胁活动。Berman 讨论模型防护措施的局限,以及冒充他人带来的风险。
Vercel 披露了一起发生于 2026 年 4 月的安全事件,涉及部分客户的环境变量遭访问。公司表示已联系受影响客户,并建议轮换暴露的凭据。环境变量往往包含敏感信息,因此泄露的影响可能超出单个应用。
Vercel 的[事件公告](https://vercel.com/kb/bulletin/vercel-april-2026-security-incident)将最初的入侵追溯到一名员工使用的第三方 AI 工具 Context.ai,随后攻击者进入该员工的账户。公司又发现了一些受影响账户,并区分出另外一些似乎并非源自 Vercel 系统的独立入侵事件。
Vercel 管理层在讨论可能有 AI 辅助时,提到了攻击的速度和复杂程度。这是一种怀疑,并不能证明 AI 参与了攻击。可以确认的教训是,授予第三方服务的访问权限可能成为进入公司系统的间接通道。
Google 的威胁报告描述了更广泛的趋势:攻击者尝试利用 AI 开展漏洞研究、开发恶意软件,并辅助行动的其他环节。其中部分活动仍处于实验阶段;报告也区分了实际观察与研究人员对意图和模型使用的推断。
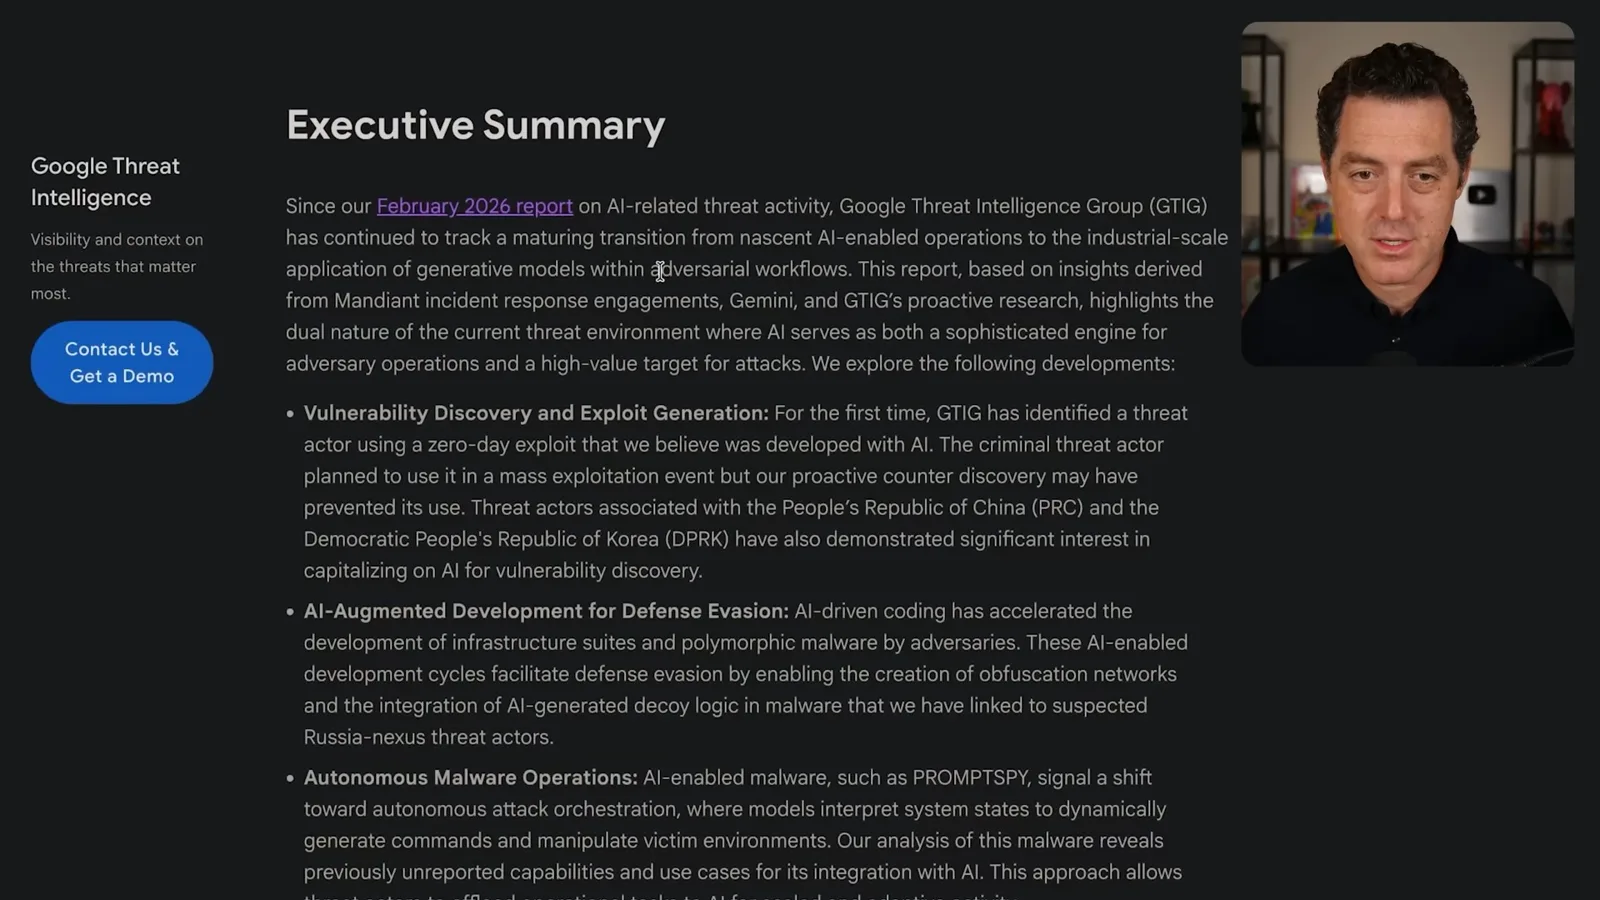
发现的漏洞与利用工具有关,却并不相同:一个是弱点,另一个是利用弱点的方法。防御者需要在攻击者能够可靠利用漏洞之前识别、验证并修补它。AI 可能加快这场竞赛双方的速度。
考虑到商业供应商对前沿模型的限制,我想知道攻击者究竟依赖这类模型,还是使用控制较少的模型。我怀疑持续滥用有防护的模型并不容易,但防护并不完美,Google 的报告也记录了观察到的滥用和绕过限制的尝试。
我的核心框架是“我的 AI 对你的 AI”:帮助防御者的模型发现并修复弱点,帮助攻击者的模型则寻找另一条路径。这种框架有助于理解速度问题,但结果还取决于访问权限、配置、操作人员和部署方式。
AI 并不是安全审查需求的根源。漏洞早已存在几十年;模型能够加快发现过程,包括找出普通扫描工具可能遗漏的逻辑缺陷。它们也可能给出错误结论或引入新漏洞,因此输出仍需验证。
Google 还描述了 AI 辅助开发代码混淆等旨在规避防御的工具。与其把每个例子都看作完全自主的攻击行动,不如将其理解为支持不同阶段的一系列用途,其中一些仍在实验中。
报告讨论了一种恶意软件,它可以利用模型输出来辅助决定如何与设备交互。这正是我担忧规模化的原因:帮助智能体应对陌生环境的同一机制,既能为合法操作者所用,也可能被攻击者利用。
AI 服务本身也可能成为目标。攻击者可能尝试窃取凭据、滥用付费推理服务,或将对 AI 应用的访问作为通往其他系统的跳板。智能体本身、其连接的工具以及它获得的权限是否安全,都很重要。
我从模型防护措施和阻止滥用的难度来思考这些威胁。供应商可以限制托管模型的使用,但攻击者也可能寻找被盗账户或其他模型。如何平衡有用的访问与防止滥用,并不简单。
问题也涉及人:合成语音可以让诈骗电话听起来像熟人打来的。遇到制造紧迫感的消息时,家人可以事先约定私密验证口令,也可以独立拨打已知号码回电确认。任何单一措施都无法防范所有骗局。
更强的 AI 能保护软件吗?
Berman 预测漏洞发现和修复将加快。他认为更强的防御模型是一种优势,同时承认软件不太可能完全安全。
一种乐观的可能性是,AI 帮助揭示大量积压的软件漏洞,让维护者得以修复。我推测两三年后安全领域可能会大不相同。这个时间表只是预测,而非已证实的结果;新软件和配置错误仍会不断带来风险。
我一开始描述了一个最终几乎没有漏洞的世界,随后又限定了这一观点:我不认为软件会达到完美安全。即使自动审计成功,也依赖于能否访问正确的系统、报告是否准确、是否负责任地披露,以及修复是否真正部署。
经济因素很重要。最大的模型供应商在训练和推理上投入大量资源,而攻击者可能寻找更便宜的开放权重模型,或滥用他人的访问权限。本地模型也需要硬件和能源;权重可用并不意味着使用没有成本。
我的假设是,资源充足的防御者往往能够使用比许多攻击者更强的模型。这可能帮助他们更早审查重要代码。但模型规模本身不能决定安全性,更强的模型也不能保证找出较小模型发现的每一个问题。
公司可以使用先进的安全模型检查重要应用,在对手到来之前解决发现的问题。只要结果经过核验并得到修复,我认为这就是有意义的优势。不过,工具无法消除社会工程攻击、凭据失窃,也无法消除它从未检查过的系统中的错误。
Mythos 与 GPT-5.5-Cyber
视频介绍 Anthropic 的安全研究发现,并将其限制预览与 OpenAI 的网络安全访问计划作比较。理解基准结果和发布方式需要各自的背景。
Anthropic 的 Claude Mythos Preview 是模型应用于安全研究的一个例子。Anthropic 推出 Project Glasswing,用该模型应对关键软件中的漏洞。其[技术报告](https://www.anthropic.com/research/mythos-preview)介绍了研究发现,以及与维护者合作披露问题的流程。
Anthropic 称,该模型帮助发现了 OpenBSD 和 FFmpeg 等广泛使用的项目中长期存在的缺陷。漏洞存在的时间说明它逃过检测多久,并不意味着所有报告的问题严重程度相同或都容易被利用。
以 FFmpeg 为例,Anthropic 称底层缺陷始于 2003 年,并在 2010 年一次代码重构后成为漏洞。公司还表示,将这个具体问题变成可用的漏洞利用工具很有挑战。其他报告的发现当时仍在披露和验证中。
Anthropic 选择限制预览,而没有向公众普遍开放 Mythos。我对强大安全工具的访问权过度集中持怀疑态度,也质疑最谨慎的发布策略是否会让防御者缺少所需能力。这是我对政策的判断,并不能证明 Anthropic 的动机。
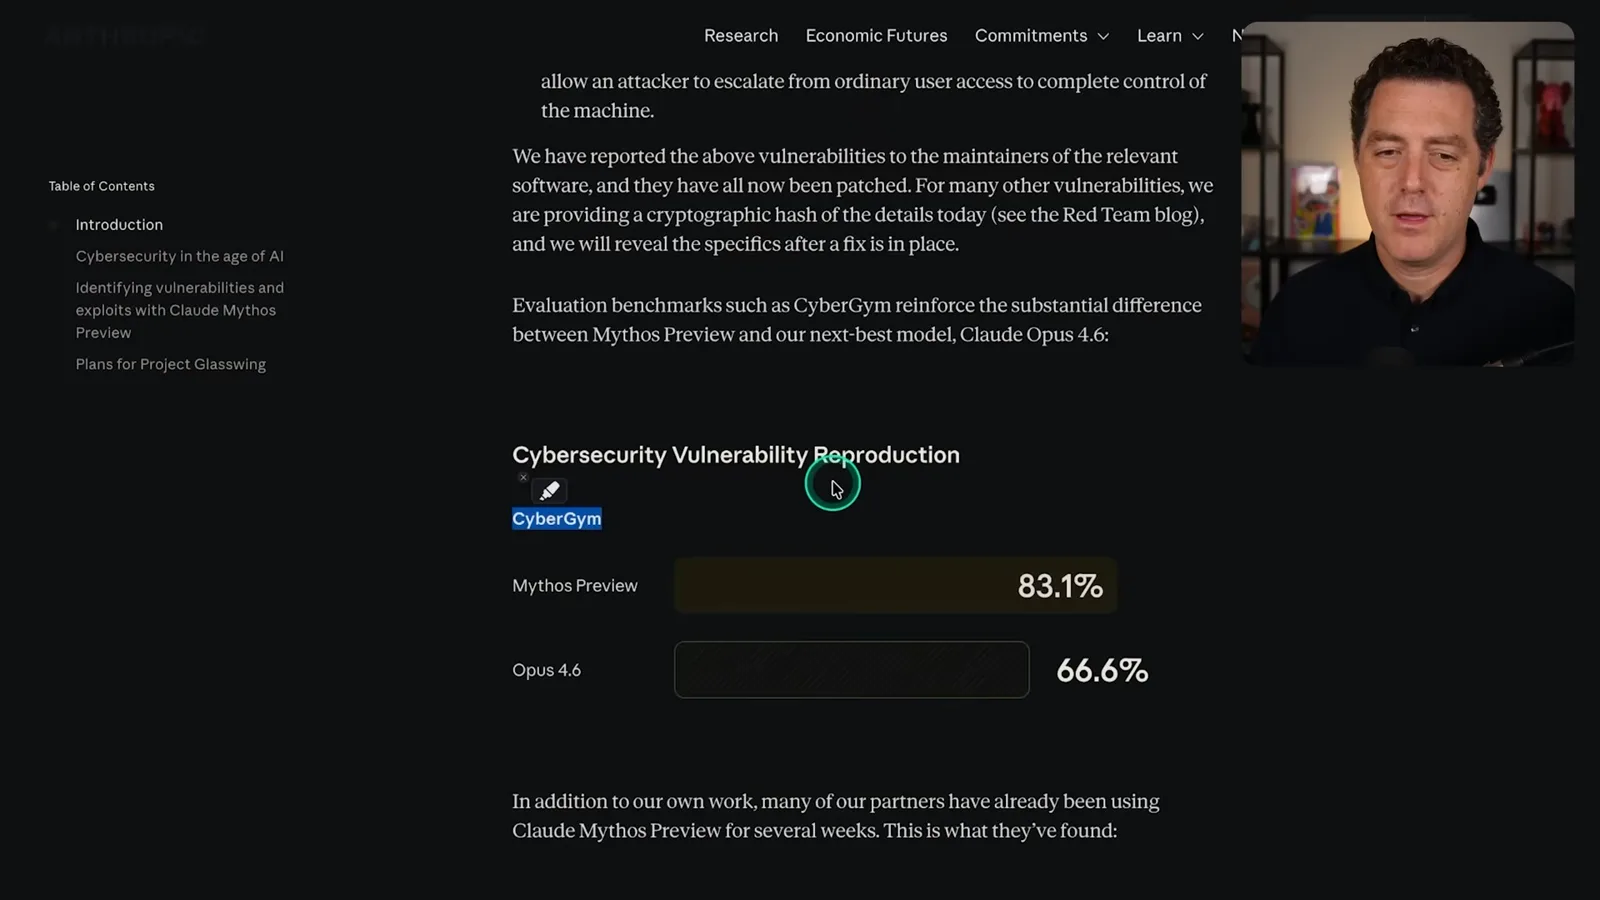
画面中的 CyberGym 图表显示,Mythos Preview 在漏洞复现基准上得到 83.1%,Claude Opus 4.6 得到 66.6%。这是特定评估的结果,不能衡量整体安全性,也不能保证对真实攻击者的表现。
我将 Anthropic 的做法与 OpenAI 发布 GPT-5.5-Cyber 的方式作比较。[OpenAI 表示](https://openai.com/index/gpt-5-5-with-trusted-access-for-cyber/),网络安全版本是面向特定防御人员的有限预览,并附带额外验证与控制。它并非向所有人不受限制地开放。
OpenAI 表示,最初的网络安全预览旨在对经授权的安全任务更宽容,而不是在每项网络安全评估中都超过标准 GPT-5.5。比较不同实验室公布的数字需要注意测试条件,不能据此断定哪个系统在所有方面都更强。
攻击经济学与长尾
Berman 勾勒自动化如何可能降低攻击较小目标的成本。最后,他评价了开放模型、防御能力和相对风险。
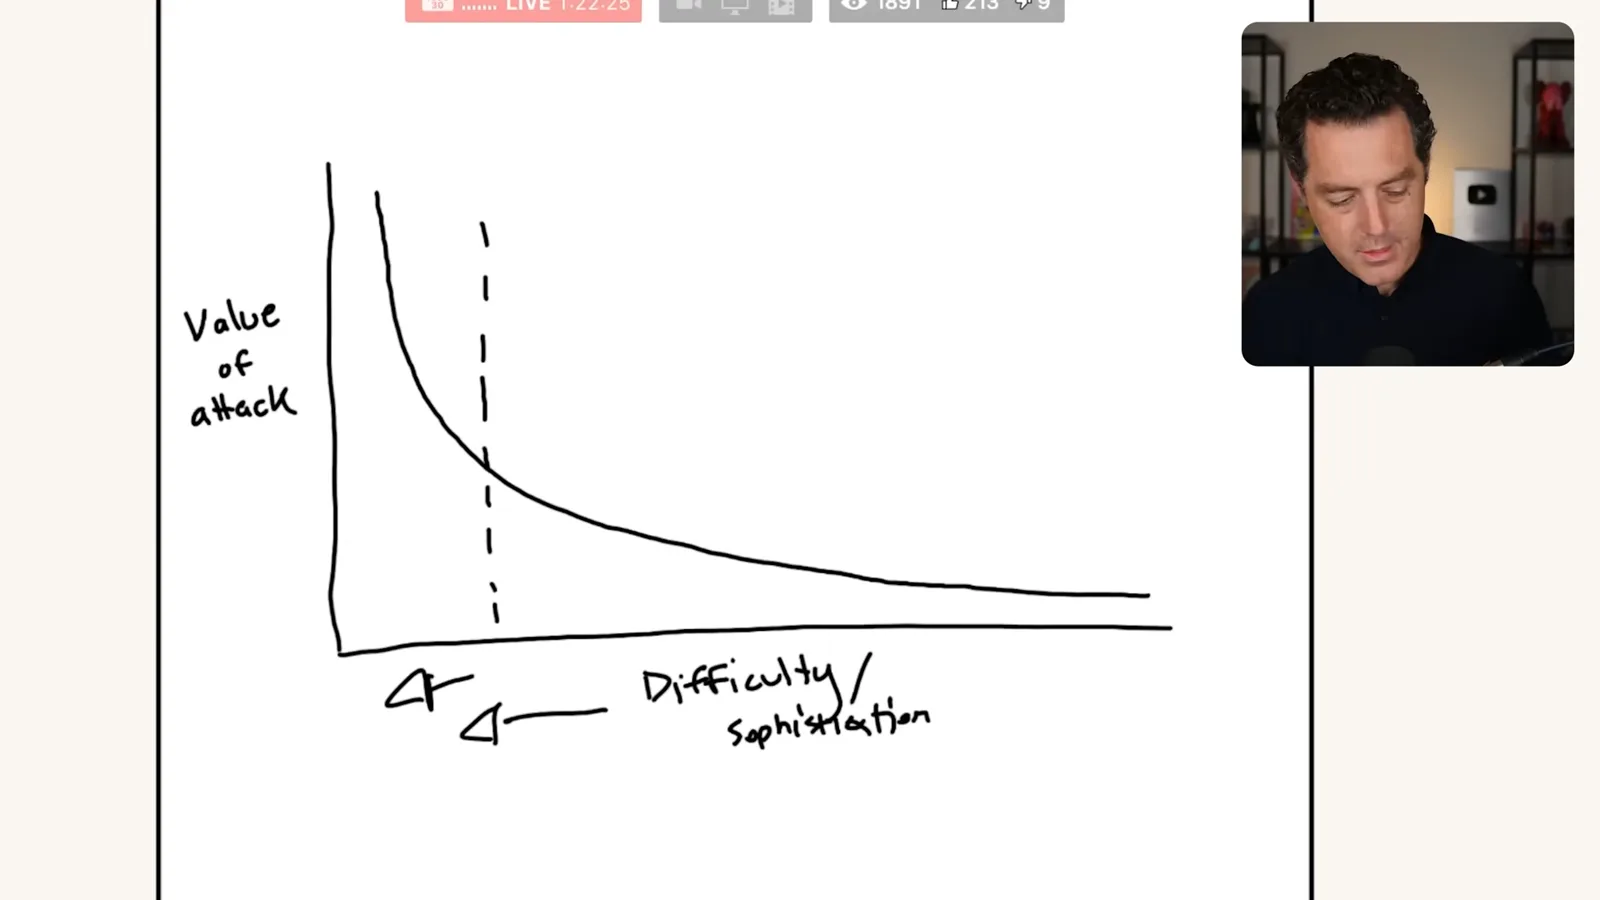
我用一张关于攻击价值和难度的草图解释自己的经济学观点。高价值目标足以让攻防双方投入大量资源;过去,如果寻找并利用每个目标都需要大量人力,低价值目标的吸引力就会较小。
自动化可能改变这笔账。如果发现弱点或定制攻击的成本降得足够低,大量较小目标合在一起也可能值得攻击。这是一种提出的经济机制,并不是对已经发生的攻击数量的测量。
同样的成本下降,也能让人们为以前服务不足的较小问题开发有用的软件。我支持开放模型和开发成本下降带来的更广泛益处,同时也承认,同样的工具扩散可能让安全和防滥用工作更加困难。
我再次强调,规模更大、资金更充足的模型可以帮助防御者加固重要系统。使用能力强的模型可能提高团队成功的机会,但模型能力、部署方式和人员响应都很重要。攻击者的目标可能比防御者保护整个系统的任务更窄。
对个人或小型组织来说,实际担忧并不只有精心策划的国家支持行动。随着瞄准目标的成本下降,规模化网络钓鱼、凭据窃取、有漏洞的依赖项和配置不当的服务都可能造成损害。常规防护和及时响应仍然有用。
相比一个孤立团伙使用较弱模型突破大国的每一道防线,我更担心的是许多小规模攻击变得有利可图。这是我对相对风险的评估,并不能保证某个具体攻击者能做到或做不到什么。
更广泛的结论是,AI 同时改变了攻击速度和防御的可能性。我们应逐案审视证据,把安全当作持续的过程,避免把强大模型或单次补丁当成安全保证。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。