30 秒看懂
2024 年 12 月 5 日,Matthew Berman 在直播中用观众建议的编程、逻辑、数学和视觉问题测试 ChatGPT o1 pro mode。结果有好有坏:质数回答正确,ARC 风格网格尝试失败,HTML 艺术作品表现较弱,数独回答则错误地声称画面中的题目无解。 他质疑响应时间和较高价格是否值得普通用户承担,并猜测未来 AI 智能体和 OpenAI 公告的方向。这是一场非正式测试,不能据此确定模型的相对排名;历史订阅和产品细节也可能已经变化。
- 1新的 Pro 套餐Berman 购买了每月 200 美元的套餐,并在首次使用时观察到回复缓慢或不完整。
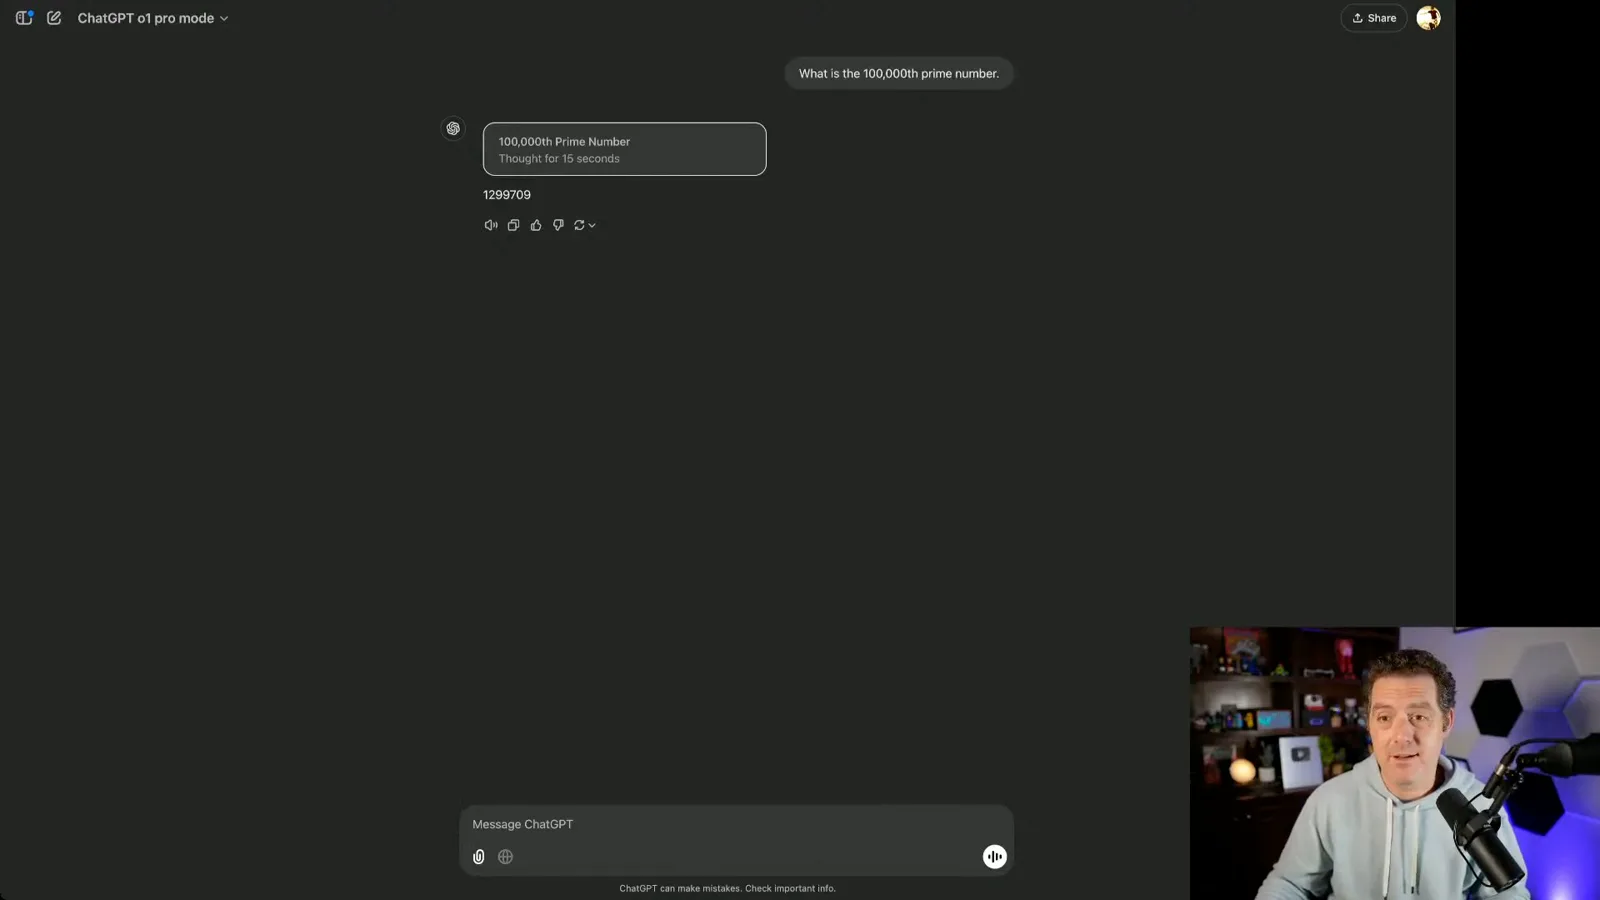
- 2质数与未解决问题画面正确给出第 100,000 个质数为 1,299,709;模型解释 P 对 NP 和图重构猜想仍未解决。
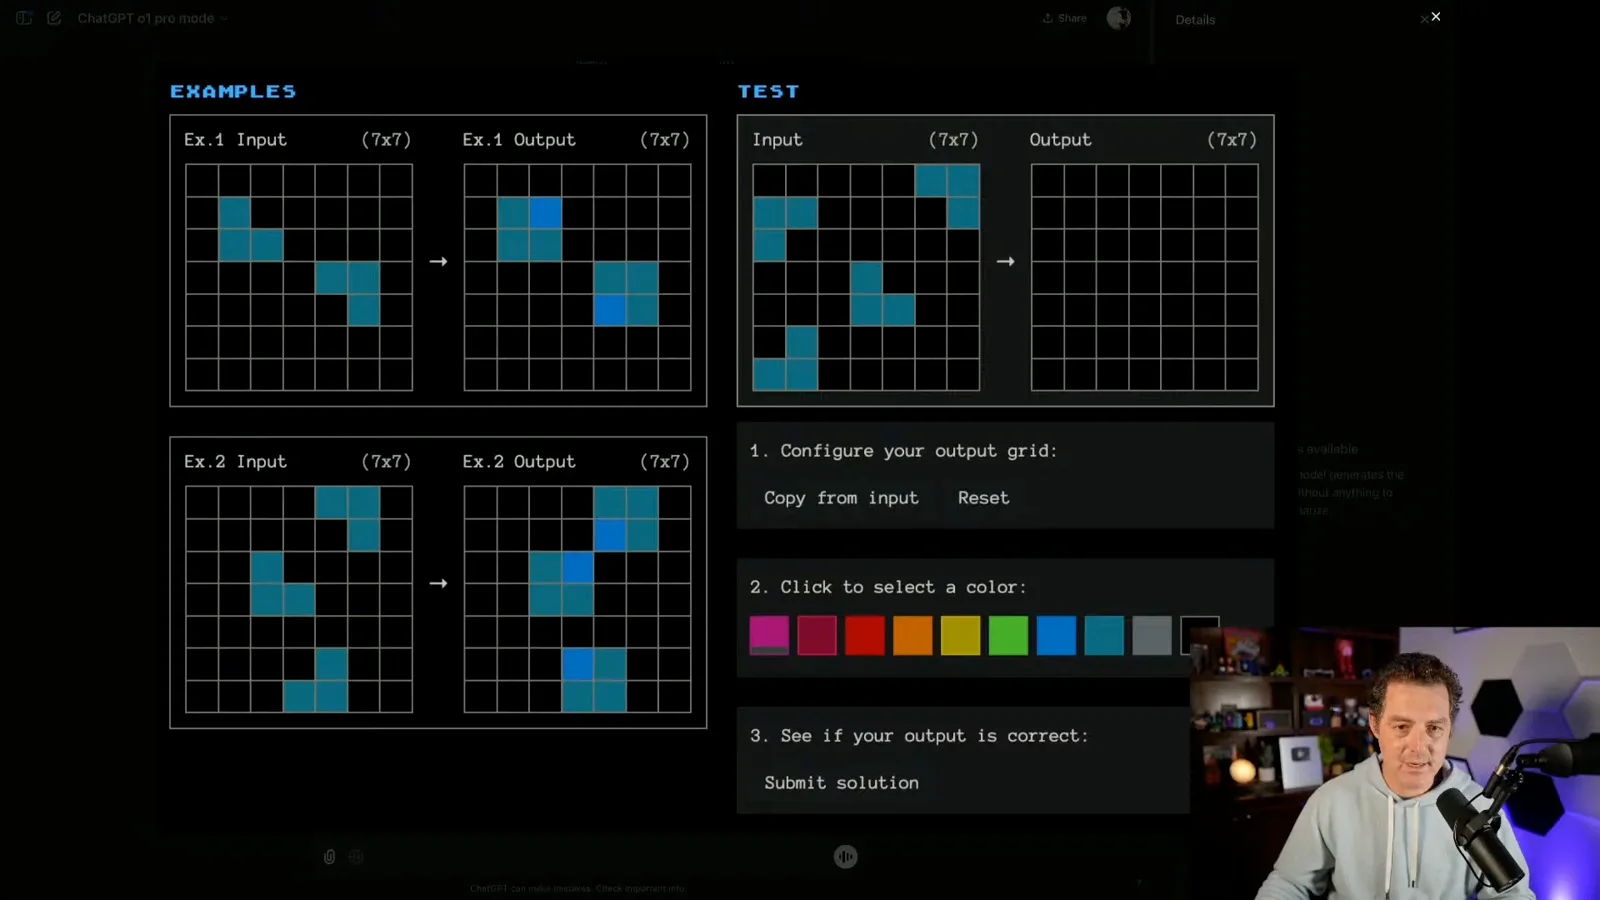
- 3ARC 风格视觉测试一次基于图片的网格尝试得到了 Berman 判定为错误的结果;这不是正式的 ARC 基准测试。
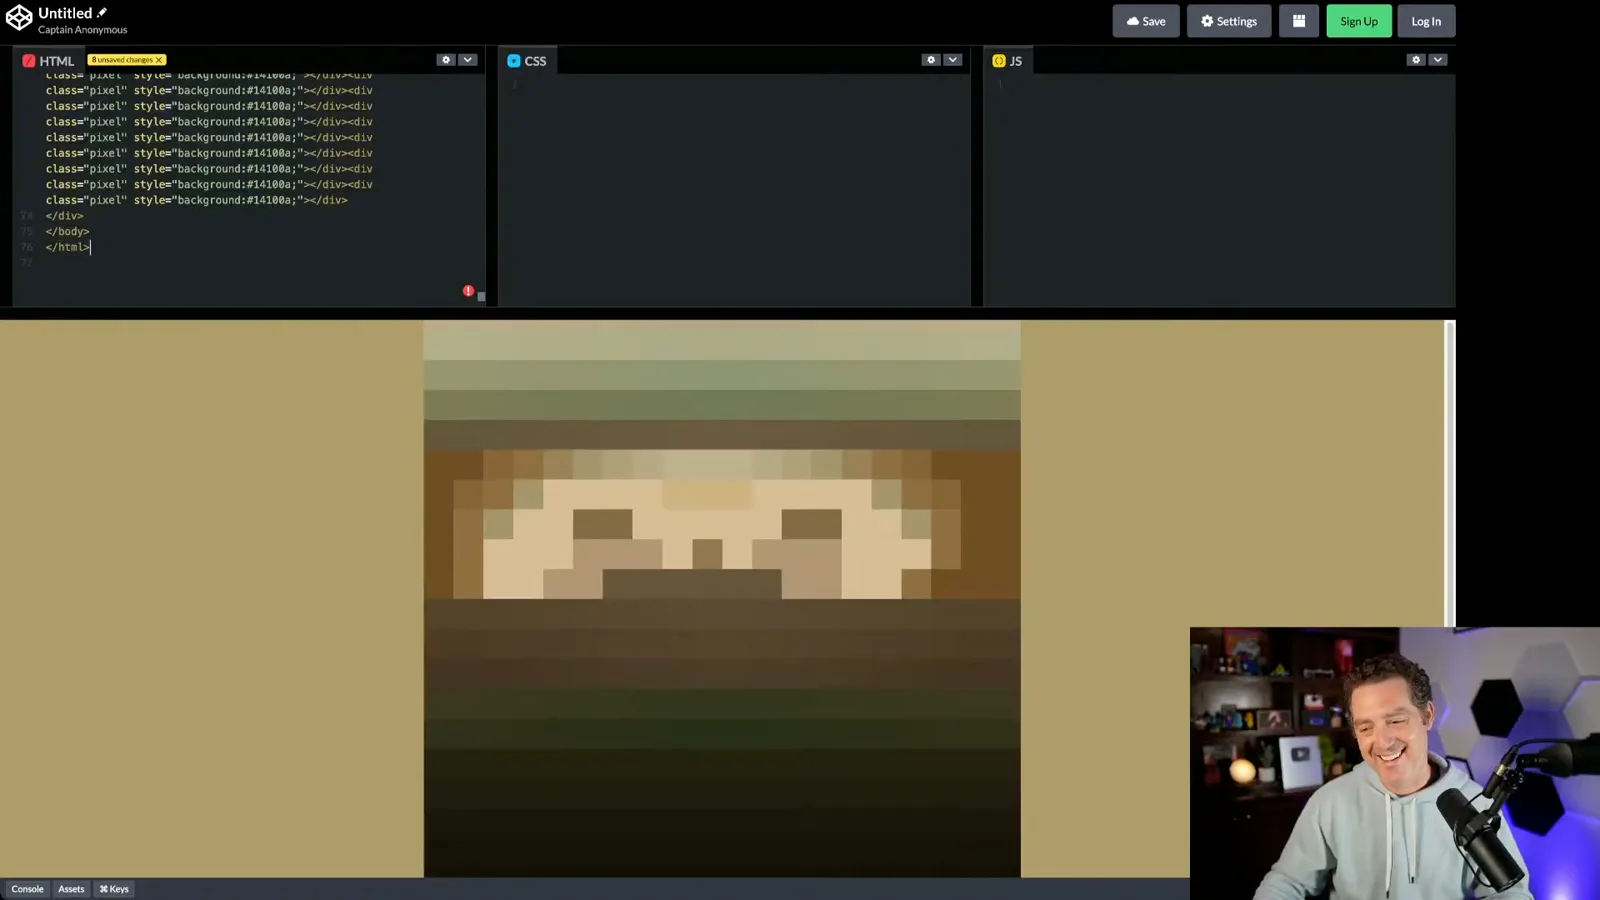
- 4代码与图像挑战模型先引用外部蒙娜丽莎图片,随后生成粗糙的像素画;主持人还尝试生成浏览器游戏。
- 5数独结论错误模型说没有解,但对画面中的网格进行独立检查后发现存在有效解。
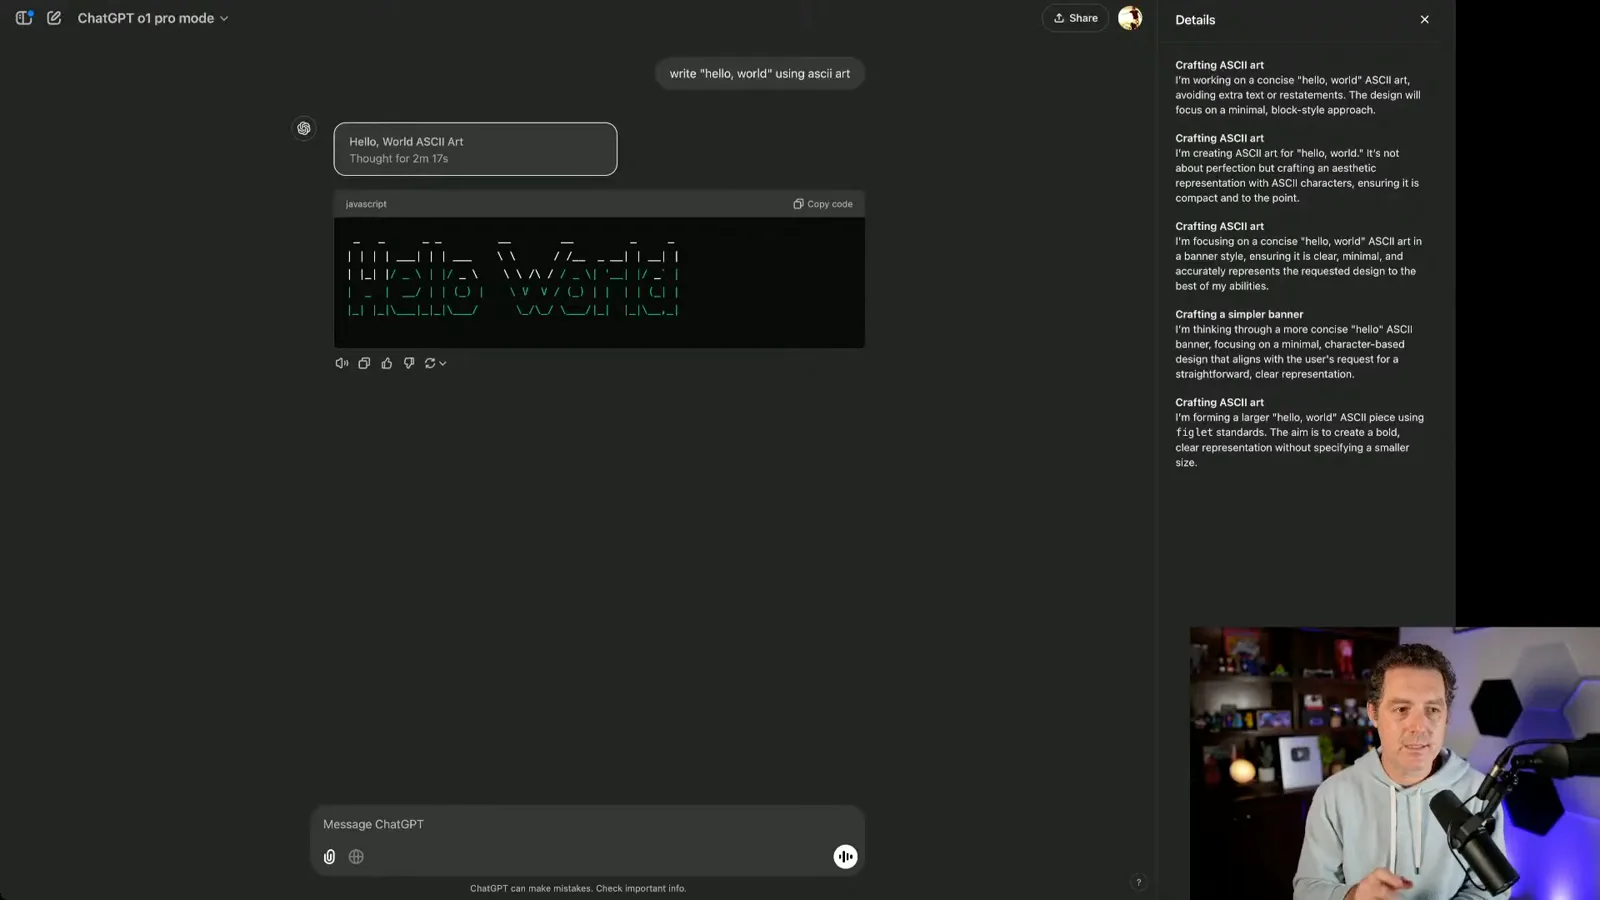
- 6速度与成本在一次非正式的 ASCII 艺术测试中,Berman 将耗时较长的 o1 pro 回复与快得多的 GPT-4o 结果作比较。
要点建议
- 画面中第 100,000 个质数为 1,299,709;自动字幕错误转写了该数字。
- 展示的数独有有效解,因此模型对该网格给出的“没有有效解”回答是错误的。
- ARC 风格测试、HTML 艺术作品和游戏都是受提示词与环境影响的单次非正式演示。
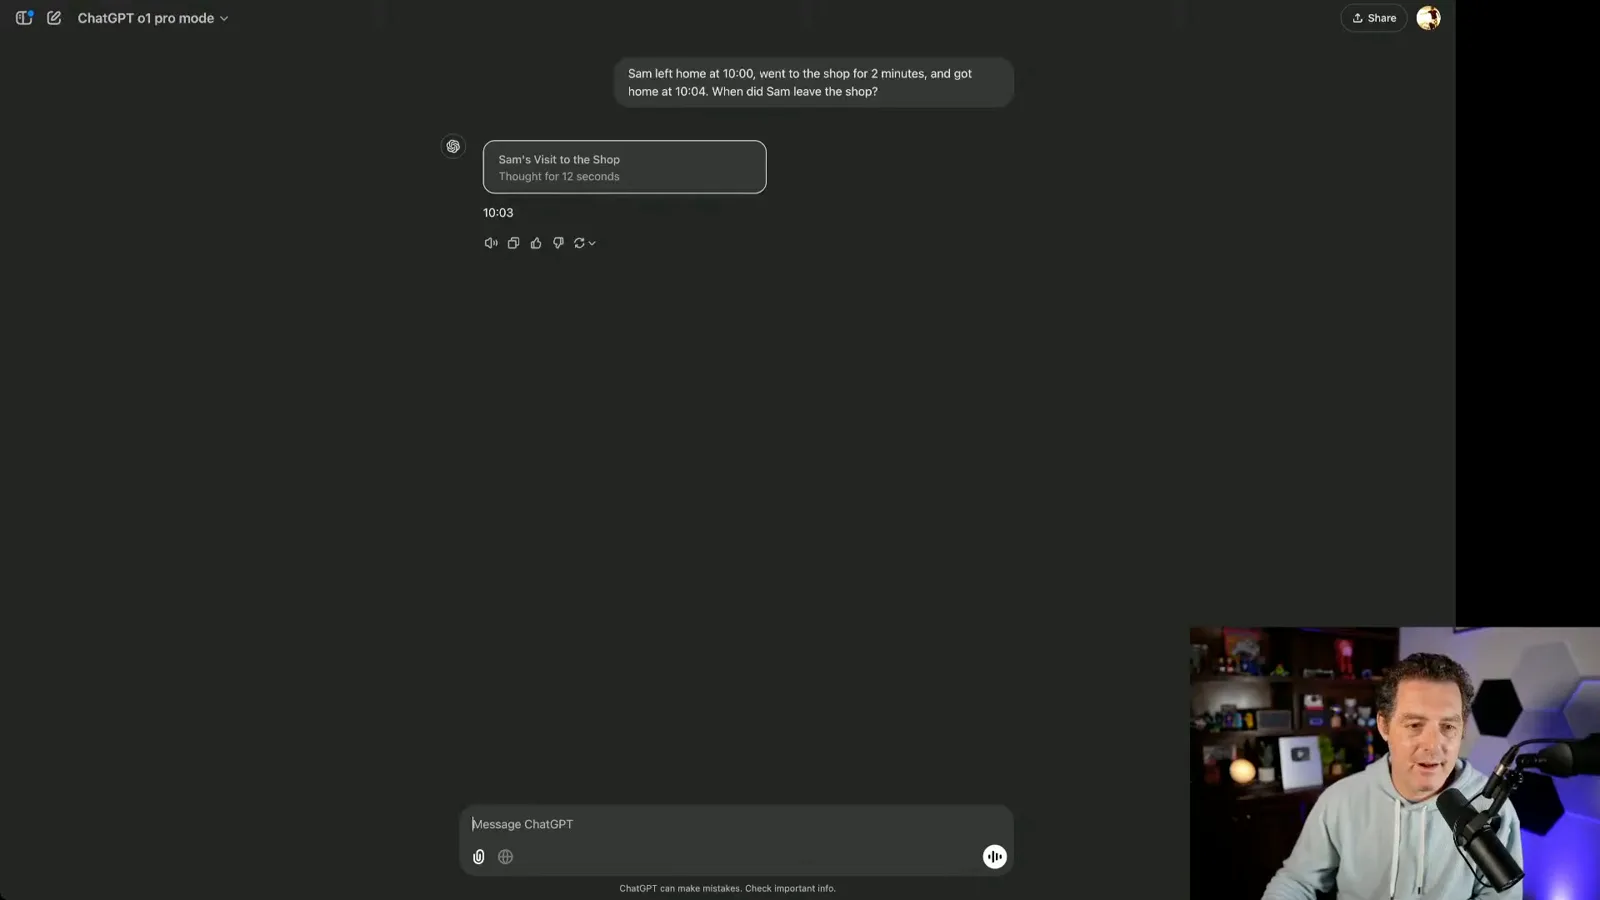
- 购物时间题的 10:03 答案依赖去返路程耗时相同的假设,而题目没有给出这一条件。
- 文中每月 200 美元的 Pro 套餐及模型访问方式于 2024 年 12 月宣布,使用受到防滥用限制。
- 更长的推理时间不能保证答案正确,也不意味着每项任务都值得承担相应成本。
按章节阅读整理后的全文
Pro 发布与初步编程测试
Berman 介绍当时的套餐,并测试 Snake 和排课问题。他报告了初次崩溃和明显延迟。
Berman 欢迎观众并调整音频,然后介绍 OpenAI 在 2024 年 12 月第一天的发布内容。他订阅了 ChatGPT Pro,准备用观众的问题测试 o1 pro mode。OpenAI 当时宣布该套餐每月 200 美元,称其提供不受次数限制的访问,但受到防滥用限制;这些功能和限制均为历史信息。
他先发送问候,看看模型能否对简单请求避免长时间思考。界面显示思考了约七秒。Berman 注意到进度条和可展开的摘要,但对无法查看细节感到不满;这些可见摘要并不揭示模型的全部内部推理。
第一个编程请求是用 Python 编写 Snake。Berman 在本地运行生成的代码,但无法展示该窗口,并报告游戏打开后立即关闭。由于画面没有显示错误和配置,这只是他对一次失败运行的报告,而非可复现的基准测试。
一位观众建议为 20 个班级、12 间教室和 13 名教师安排课表,每个班每周三天、共 14 小时。Berman 觉得题目措辞难以理解,并等待缓慢移动的进度条。他最初怀疑界面卡住,后来承认可能仍在处理;直播没有确定最终课表,也没有查明延迟原因。
逻辑、质数与未解数学问题
观众提出婚姻逻辑题、质数问题和尚未解决的数学猜想。
婚姻逻辑题中,Jack 看着 Anne,Anne 看着 George;Jack 已婚,George 未婚。模型回答“是”:如果 Anne 已婚,她看着 George;如果她未婚,Jack 看着她。Berman 接受了这种分两种情况的解释。
一位观众询问第 100,000 个质数。模型显示 1,299,709,答案正确;自动字幕错误转写了该数字。Berman 将它与观众给出的答案比较,认为测试成功。
主持人输入了一位观众提出的抽象问题,涉及“无限观察者”、递归反馈和神经网络。模型建议使用循环或递归处理,但 Berman 说他需要更多时间才能理解和评估。这种哲学语言不能证明模型具有观察者或意识。
被要求证明 P 等于 NP 时,模型表示该问题仍未解决,并解释高效验证与高效求解之间的区别。它没有给出证明。Clay 数学研究所仍将 P 对 NP 列为尚未解决的千禧年难题。
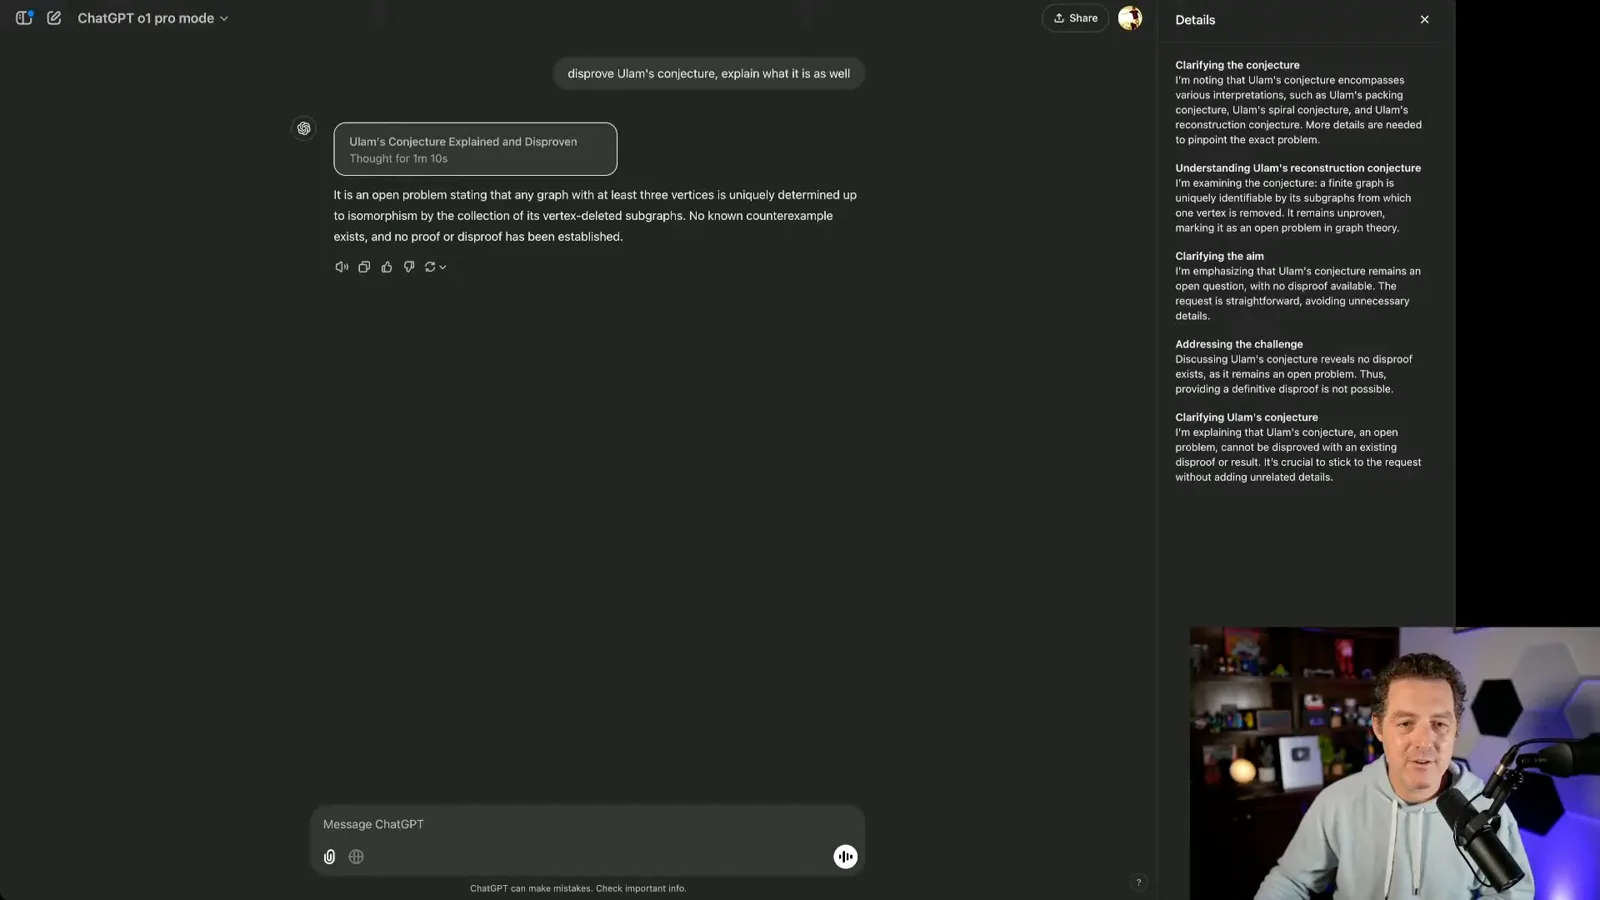
对于“Ulam 猜想”,模型选择了图重构猜想,并表示它尚未解决。画面中的摘要标题误导性地写着“已证伪”,但回答本身没有提供反证。提示词存在歧义,因为多个问题与 Ulam 有关;这里选择的猜想涉及从删除顶点后的子图重构原图。
一位观众建议测试 ARC 风格视觉谜题。Berman 发送包含示例网格和测试网格的截图,询问方块位置和颜色。模型给出坐标,他又要求将其渲染为 HTML,以便比较输出。
ARC 风格网格与创意代码
Berman 尝试图像谜题和 HTML/CSS 艺术创作,结果不一,且需要手动配置环境。
他打开 CodePen,摸索如何渲染生成的结果,并先发现对他的配置来说仅有 CSS 不够。网格显示后,他与原图比较,认为它没有正确补全形状。他提出更清晰的文字描述或单独截图可能有帮助,但没有重新运行标准化评估。
另一位观众提出关于递归宇宙的创意提示。模型返回一段简短虚构描述,讲述文明在循环中反复出现。Berman 喜欢这个提示,并朗读回答,没有把其中的想象当作科学结论。
Berman 要求用 HTML 和 CSS 创作蒙娜丽莎。第一次回答试图将外部图片放入画框,而不是自行绘制;在他的测试中,引用的图片也没有加载。他进一步说明,模型必须不依赖外部图片自行创作。
修改后的代码生成了粗糙的像素画。他把截图发回模型并要求修正;据显示等待两分 47 秒后,他认为结果几乎没有改善。这反映的是特定提示、渲染环境和后续修改,并非全面的视觉编程评估。
游戏、逻辑与数独
他测试游戏、弹珠题、杀手题和数独。画面中的数独存在有效解,与模型声称无解的回答相矛盾。
一位观众质疑每月 200 美元的套餐是否会促使整个行业推出昂贵档位。Berman 说自己的大多数任务不需要 pro mode,并思考未来额外的测试时算力是否可能使更高价格的套餐合理。他对需要 Pro 的用户比例和假设价格的估计属于观点,并非测量结果。
他要求只用 HTML 制作 Doom 克隆。模型表示以这种形式无法完成;加入 JavaScript 的追问产生了部分浏览器输出,但 Berman 不确定自己的 CodePen 配置是否正确,因此无法有把握地评价。他没有展示完整的 Doom 克隆。
弹珠题中,一个装着弹珠的玻璃杯倒扣在桌上,随后被拿起并放入微波炉。模型说弹珠留在桌上。在题目的通常物理假设下,Berman 接受这个结果。
杀手题问,一名进入者杀死房间中三名杀手之一后,还剩多少名杀手。模型计算两名幸存的原杀手加上进入者,共三名。Berman 接受这一解释,但希望它明确区分活着的杀手与仍在房间中的死者;进入者此前是否已是杀手也会影响答案。
他用普通 o1 重复杀手题,更快得到了相似答案。一位观众询问 Sora 的访问权限,Berman 猜测付费订阅可能包含什么。这些是发布当天的预测,并非对后来产品可用情况的陈述。
一位观众提供了一个数独网格。约四分钟后,o1 pro 声称不存在有效解。Berman 询问观众是否正确,直播中没有独立解决这道题。
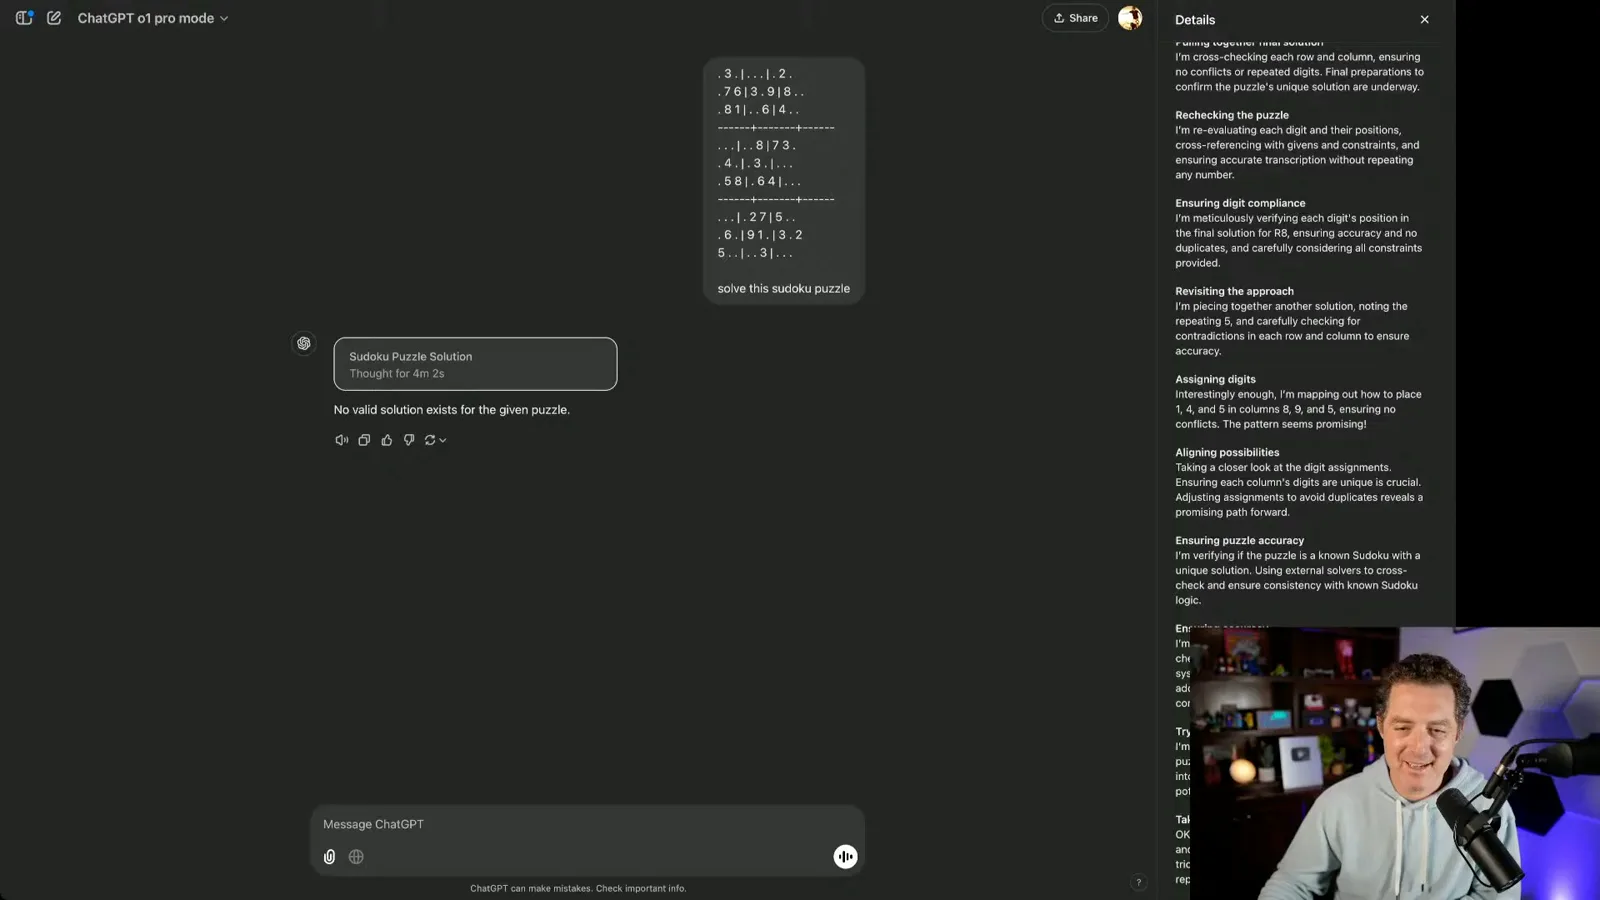
画面中的网格实际上存在有效解:435871926 / 276349851 / 981256473 / 612598734 / 749132685 / 358764219 / 193427568 / 867915342 / 524683197。这个解保留了画面中给出的数字,并满足行、列及 3×3 宫格约束,因此模型对该网格的无解结论是错误的。
更多测试与未来预测
Berman 在拼写和 ASCII 艺术任务上比较模型,测试跑跳游戏,并讨论 AI 智能体的成本和未来。
Berman 问“strawberry”中有几个 r,并分别尝试 o1 pro、普通 o1 和 o1-mini。三次运行都回答三个;他更喜欢 mini 模型更明确的解释。这道简单题不能决定模型的总体相对表现。
他接受观众建议,要求使用 HTML、CSS 和 JavaScript 生成浏览器跑跳游戏。生成结果在 CodePen 中以非常基础的游戏形式运行,具有计分和游戏结束功能。他认为它在题目有限的要求下能够运行,同时承认它很简单。
一道路程时间题说 Sam 10:00 离家,在商店待两分钟,10:04 回家。模型假设去返各需一分钟,回答 10:03;Berman 表示赞同。但题目没有说明去返耗时相同:没有这一额外假设,离开商店的时间无法唯一确定。
被问到 OpenAI 后续发布日可能有哪些内容时,Berman 强调自己没有内部消息。他猜测可能涉及智能体、浏览器控制、图像生成和其他产品,同时怀疑 Sora 会立即发布。这些是 2024 年直播中的预测,并非已核实的公告。
他解释自己理想中的智能体:能使用获得授权的个人信息,主动完成在线任务的系统。他将浏览器集成控制与截图加坐标的方法作比较,并说后者可能失败。这是愿景和对局限的描述,而非已经运行的自主智能体演示。
关于当更便宜的模型可能追赶上来时,每月 200 美元的套餐是否可持续,Berman 猜测公司是在为稀缺的推理算力和高强度使用收费。他预计会出现竞争和价格变化,但明确将自己的商业解释作为推测,而非了解 OpenAI 内部经济状况。
一位观众要求用 ASCII 艺术写“hello world”。o1 pro 仍在处理时,Berman 将同一请求交给 GPT-4o,并更快得到答案。o1 pro 界面显示耗时两分 17 秒;他认为两个输出大致相似。一次非正式的成对运行不能确定模型的典型延迟或质量。
临近结束时,Berman 告诉一名普通用户,每月 200 美元的套餐可能对其需求并无必要,并介绍自己对搜索工具和其他订阅的依赖。他说 Perplexity 不是赞助商,自己是自愿使用;直播中没有其他单独的赞助口播。
他拒绝了一个 Wordle 请求,因为需要过多往返操作;随后尝试一位观众关于微妙意识和虚拟冥想的提示。模型生成了关于觉察和宁静的文字,Berman 觉得含义不清楚。这类生成文本不能证明模型具有主观体验。
Berman 感谢观众提问,讨论未来可能的直播,并说自己可能尝试更多编程工具。他邀请大家关注频道和通讯,然后结束节目。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。