30 秒看懂
在这期 2025 年 3 月的教程中,Matthew Berman 介绍如何使用 Cursor、Windsurf 和 Claude 3.7 Sonnet 根据规格文档构建应用。他的建议侧重明确项目规则、隔离环境、缩小请求范围、测试和频繁提交;视频包含 Mammouth 赞助。 此后编辑器界面和模型可用性已有变化,Claude 3.7 Sonnet 也已从 Claude API 退役。他的规则和耗时数据来自个人经验,并非普遍适用的规定。
- 1编写规格文档Berman 起草应用规格,并建议在交给编程智能体之前先审阅。
- 2明确项目规则清晰的技术栈和工作流约束有助于避免意外替换技术或重复实现。
- 3避免生产环境中的虚假回退模拟响应可能掩盖真实操作失败;Berman 将此类数据留给测试使用。
- 4检查测试和行为小范围任务和频繁测试有帮助,但如果智能体改变了测试意图,通过测试并不能证明正确。
- 5控制执行权限自动执行命令可能影响线上系统;Berman 警告不要在生产环境中使用他的实验模式。
- 6提交与恢复频繁提交和编辑器检查点提供了返回先前状态的方法。
要点建议
- 先准备并审阅规格文档,告诉智能体哪些技术和约束很重要。
- 项目规则可以减少重复指令,但是否生效取决于编辑器配置。
- 保持开发、测试和生产环境分离,防止虚假回退数据掩盖故障。
- 测试重要行为,检查代码和测试的改动,并亲自验证关键流程。
- 不受限制的智能体命令可能影响外部服务和生产环境,应谨慎选择执行权限。
- 频繁提交和了解检查点的作用,有助于从失败的迭代中恢复。
- 视频中的模型选择、产品菜单和 Mammouth 价格均为历史信息。
按章节阅读整理后的全文
环境与规格
Berman 介绍他在 2025 年使用的编辑器和模型,并在实现前起草详细规格文档。
在这期 2025 年 3 月的教程中,Matthew Berman 分享约 100 至 150 小时“vibe coding”的经验:给编程智能体较宽泛的指令,让它们实现应用。他使用 Cursor 和 Windsurf,强调这种工作流有局限,并介绍更清晰的规格、项目规则、测试和版本控制如何帮助他应对问题。
他当时主要使用 Claude 3.7 Sonnet,通常开启扩展思考模式,有时使用 Grok 3 起草规格文档。Anthropic 于 2025 年 2 月发布 Claude 3.7,并于[2026 年 2 月将其从 Claude API 退役](https://docs.anthropic.com/en/docs/about-claude/model-deprecations)。视频中的模型可用性、编辑器菜单和服务商设置均为历史信息,应查看当前产品文档。
Berman 展示了 2025 年的模型选择界面,以及一个兼容 OpenAI 接口的自定义服务商端点。他建议选择支持智能体所需工具和函数调用能力的模型。API 凭据应保密,如今支持的服务商和配置方式可能与画面不同。
在让智能体实现项目之前,Berman 建议先编写详细规格。他的例子是让另一个模型起草使用 Python 后端的类 Twitter 应用,再审阅其提出的行为、数据库结构和端点。他建议修改规格,使其反映用户真正想要的内容,然后再交给编程智能体。
项目规则与编程偏好
他定义技术栈和工作流规则,以避免重复、意外更改和环境混淆。视频包含 Mammouth 赞助。
项目规则用于表达反复出现的约束,例如偏好的技术、惯例和工作流。Berman 发现规则很有用:有一次智能体为修复 SQL 问题而悄悄改用 JSON 文件,应用表面上可以运行,却绕过了原本指定的数据库。明确约束有助于智能体区分修复与不希望发生的架构变更。
示例中的 Cursor 项目规则以 `.mdc` 文件形式保存在 `.cursor/rules` 中,与用户全局设置分开。Berman 不确定哪些规则会自动加载,因此手动附加其中一些。[当前 Cursor 文档](https://docs.cursor.com/context/rules-for-ai)区分始终应用、自动附加、由智能体请求和手动调用的规则;是否生效取决于配置。
视频包含 Mammouth 的赞助片段。Berman 将其描述为提供多个 AI 模型访问权限的服务。他提到的每月 10 美元价格和模型列表属于 2025 年的宣传信息,不能保证当前价格、模型可用性或套餐限制相同。
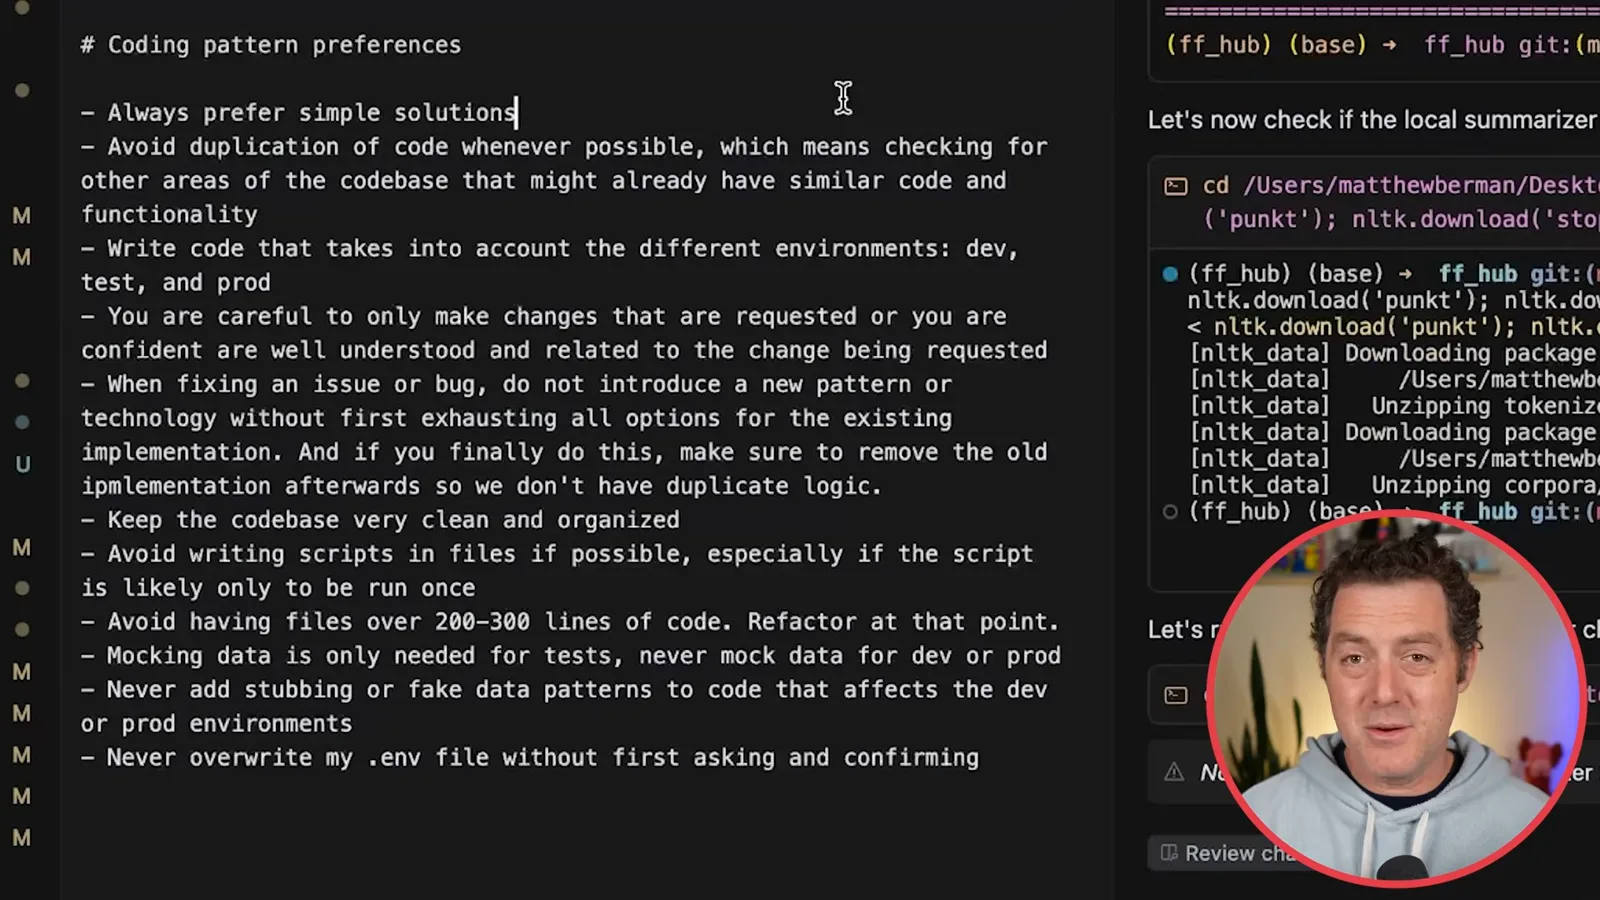
他的编程模式规则要求智能体优先选择简单方案,在新增功能前查找已有实现以避免重复,并保持代码整洁。他解释说,智能体有时会另外写一套实现,而不是修复已有代码。他还要求改动保持在请求范围内,并在尝试现有方法之前避免引入新技术。
另一条规则要求开发、测试和生产环境保持分离。Berman 曾遇到测试影响开发数据,以及生产代码指向本地资源的问题。明确环境边界有助于智能体理解每个配置和数据库的归属,但仅靠指令并不能强制实现隔离。
Berman 要求智能体不要留下不必要的一次性脚本,并建议文件达到 200 至 300 行时考虑重构。他承认这不是普遍适用的软件规则;有用的目标是可维护性,而不是为了满足行数机械拆分代码或冒着破坏功能的风险。
他还要求智能体不要在开发和生产行为中使用模拟或桩数据。他遇到过的一种故障是,抓取器在真实请求失败后悄悄回退到假数据,掩盖了问题。他将模拟数据留给测试,并在不得不替换丢失的密钥后,增加了不覆盖 `.env` 文件的规则。
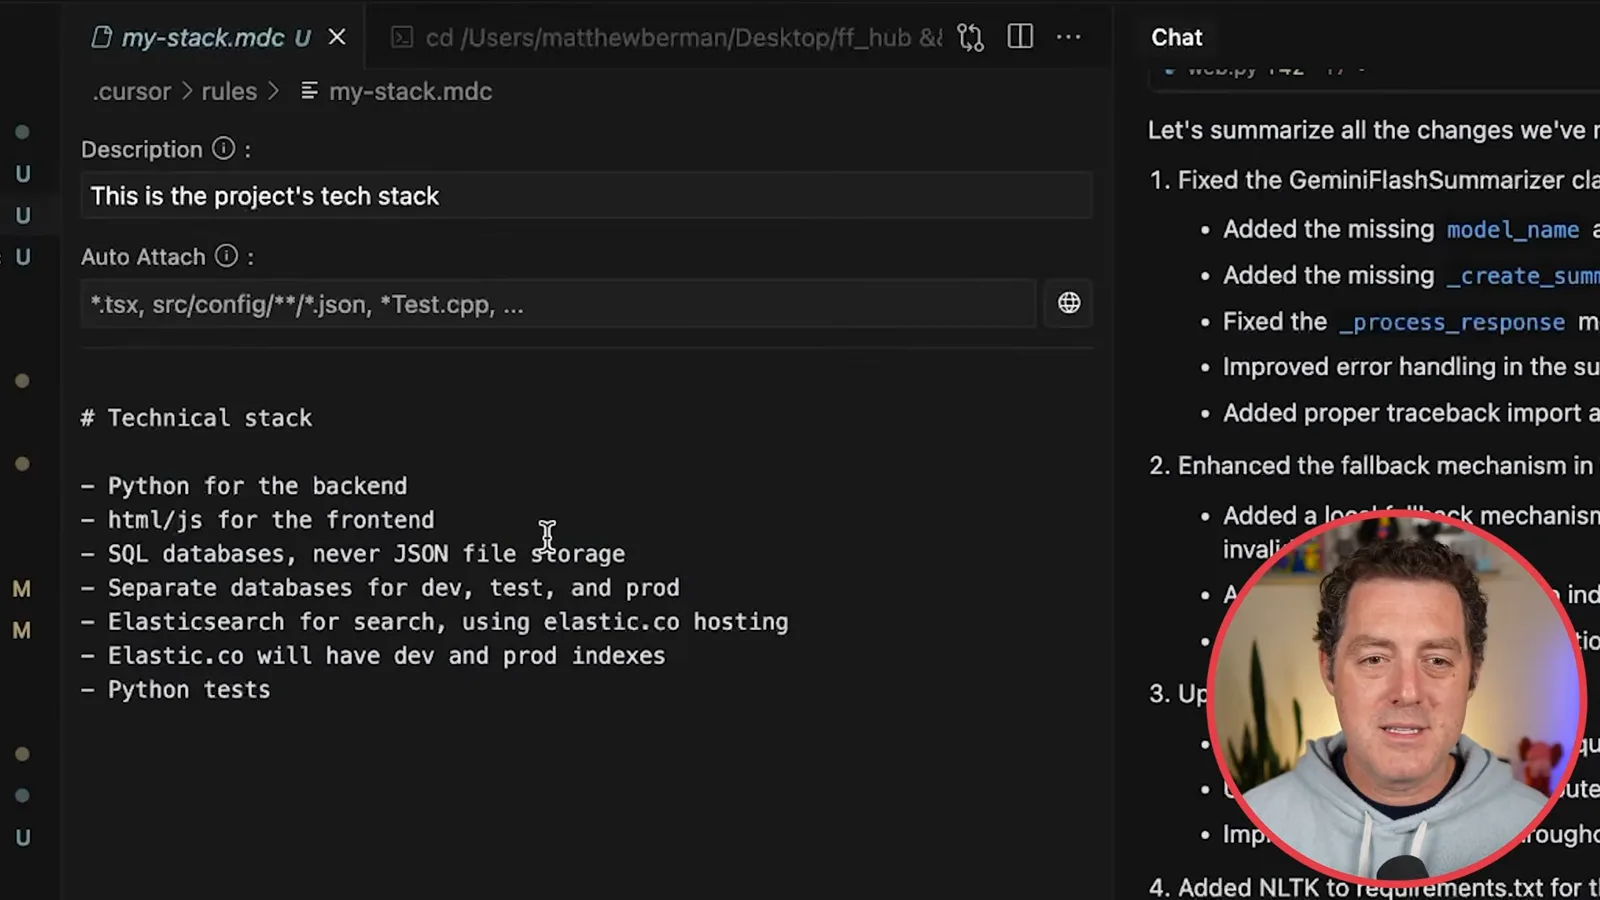
技术栈规则记录了他的偏好:Python 后端、HTML 和 JavaScript 前端、SQL 而非 JSON 文件存储、各环境独立数据库、托管 Elasticsearch 和 Python 测试。这些是他的项目选择,不是所有应用的要求。写下来可以让意外的技术变更更容易被发现。
他的工作流规则再次强调聚焦任务、测试主要行为,以及未经指示不要改变已经运行良好的架构。他要求智能体考虑改动会影响代码的哪些其他部分。接着,Berman 将审阅过的应用规格粘贴到新的智能体对话中作为起点。
上下文、小范围任务与测试
Berman 重启过长的对话、附加相关规则,并强调聚焦的请求。他讨论测试、常见技术栈和标签长度示例。
长对话会积累上下文,Berman 发现对话增长后表现可能下降。开启新对话可能有帮助,但如果不带上相关细节,就会丢失信息。他重新附加工作流、技术栈和编程规则,并建议通过实践判断何时适合开启新对话。
他建议缩小请求范围并频繁测试。他偏爱像用户一样操作应用的端到端测试,但单元测试和集成测试也可以针对不同故障发挥作用。如果智能体错误地修改了测试或生产行为,仅仅通过测试还不够;应检查具体改动,并亲自试用应用。
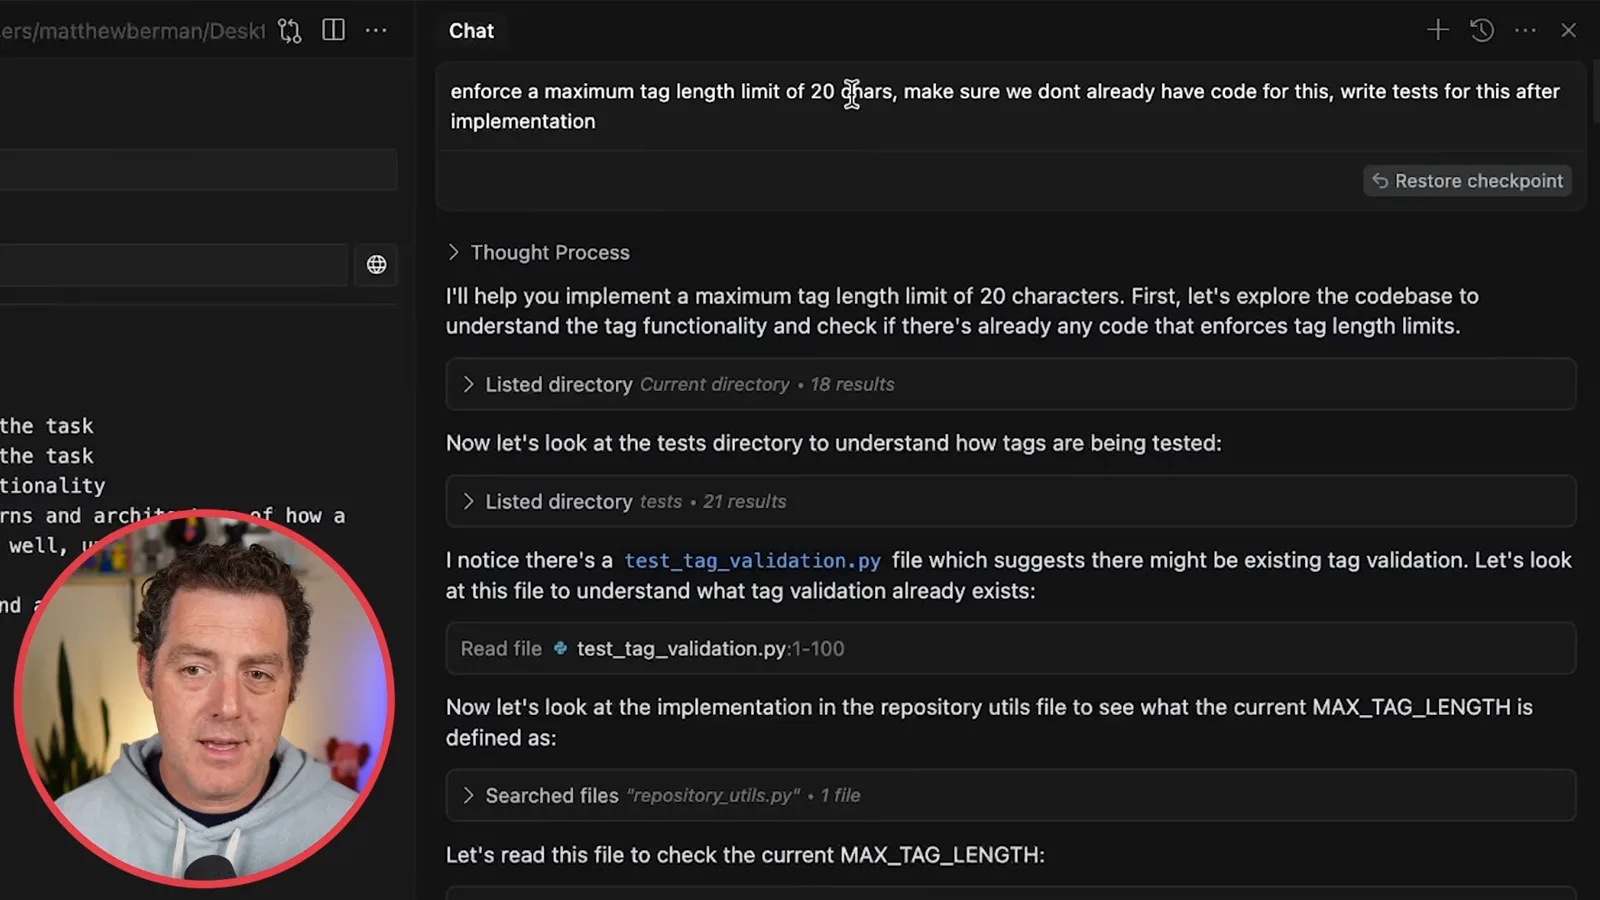
Berman 偏爱文档完善、使用广泛的技术,因为他预计智能体有更多可用材料。他的示例提示要求将标签长度限制为 20 个字符,先检查现有代码,再编写测试。智能体列出目录、读取文件并搜索,然后说明计划并修改代码。
执行、迭代与恢复
他比较命令审批模式,介绍并行分支和异步工作。频繁提交和检查点有助于恢复改动。
2025 年的编辑器提供了不同级别的命令审批。Berman 说,他在实验中使用自动“YOLO”模式,但警告不受限制的执行可能推送代码或部署到生产环境。即使是新项目,审批设置、隔离环境和审查也很重要,因为智能体仍可能影响已连接的服务或凭据。
智能体运行测试、调查一个失败并返回摘要;Berman 注意到模拟仓库的修改,这也说明了他为何反复强调环境规则。他审阅结果,而不是把智能体的摘要当作证明。积累的上下文变得难以管理时,他也会开启新对话。
Berman 表示,他有时会要求智能体提交改动并部署到 Heroku。根据他的经验,一次迭代可能需要 2 至 15 分钟,包括运行和修复测试。他建议使用独立分支或编辑器窗口并行工作,再谨慎合并;这个耗时只是他 2025 年环境下的个人经历。
他偶尔会要求对较长文件进行低风险重构,并在思考和非思考模式之间切换。不过,随着项目扩大,有时即使是小改动也需要多次迭代。他认为,如果更早建立这些规则和做法,自己可能会走得更远。
Berman 描述了一种异步节奏:给智能体一个任务,去做别的事,然后回来审阅结果并继续迭代。他希望有完全托管的手机界面,让自己离开电脑时也能更方便地操作。这是他在 2025 年的产品愿望,并非对当前可用产品的描述。
他最后的实用建议是频繁提交,以便改动出错时有可恢复的检查点。他还展示了编辑器的对话检查点功能。Git 历史和编辑器检查点的作用范围不同,因此使用恢复功能前应了解它会改变什么。
经过 100 至 150 小时的实验,Berman 认为智能体降低了构建软件的门槛,并鼓励观众尝试。他预计工具会不断改善,而他自己的例子也显示,明确目标、检查改动、测试行为和控制部署仍然必要。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。