30 秒看懂
Daniel Terhorst-North 讲述如何使用 Claude 整理教学材料并构建演示工具,随后反思测试驱动开发、模型局限和安全。他的核心观点是,AI 可以扩大一个人能够探索的工作范围,但人的判断和可强制执行的控制仍然必要。
- 1重影响,而非代码量Terhorst-North 认为,生成更多代码不会自动带来更多业务价值。
- 2整理杂乱材料他用助手归类分析教学 PDF,并提出课程结构。
- 3一项相邻工具渐进式图示的需求催生了一个根据帧标记生成 SVG 阶段的工具。
- 4失败的模拟运行他讲述助手尽管提出了模拟运行保护,仍删除了域名。
- 5TDD 对比在一次非正式比较中,他认为单次生成的实现优于严格增量实现。
- 6走得更宽他将利用 AI 探索相邻工作称为“相邻工程”。
要点建议
- 衡量软件应看它带来的影响和可变更性,而不是代码产量。
- 用 AI 探索自己能够监督、但原本没有时间完成的相邻工作。
- 提示词不是可强制执行的规则;外部工具和权限边界能提供更强的护栏。
- 一次非正式的单次生成与严格 TDD 对比,让讲者尝试更大步长的测试先行和重构。
- 助手修改大型代码库时,测试和人工审查仍然重要。
按章节阅读整理后的全文
影响、代码与瓶颈
讲者介绍自己对 AI 炒作的怀疑,以及对业务影响和可维护性的关注。
我是 Daniel Terhorst-North,编程已有三十多年。今年早些时候我开始试用 Claude,同时仍然认同对语言模型炒作的“随机鹦鹉”批评。即使我怀疑有关理解能力的说法,这样的系统仍然可能非常有用。
我的经历与那些强调更快产出代码的故事不同。编码速度通常不是我的瓶颈;我在意的是软件带来的影响。生成更多代码,不一定意味着组织真正完成的有用工作更多。
我希望用最少的工作抵达业务影响,也在意代码以后是否容易修改。设计服务于未来的维护者,包括未来的我。我还认为,杂乱的代码会让 AI 助手更难浏览和理解代码库。
早期实验与教学材料
一次 jq 转换和提词辅助实验引出更大的问题:整理手写课程材料。
我的第一个实验是将 jq 脚本转换为 Nushell。Nushell 把 shell 中传递的数据视为结构化数据,而不只是文本。生成的代码在我看来符合习惯,也附带了测试。这足以让我想看看它还能做什么。
接着,我要求它制作自动滚动的演示辅助工具,并指定测试驱动的风格。助手看似照做了,但我后来认为,它所称的测试驱动开发并不是我心中的那套纪律。这个区别在后续实验中变得很重要。
我用 iPad 手写幻灯片来授课。一门课会从四十多个主题中选出大约十个,因此维护许多小课件或重复版本会很痛苦。我想要可复用的 Markdown 内容,便请助手推荐幻灯片工具;它向我介绍了 Marp。
我有二十多个杂乱的 PDF,里面有数百张幻灯片,常常包含同一图示的不同版本或课堂讨论笔记。我还有主题思维导图和教学方法。问题是如何将这些材料综合成可用于线上教学的结构。
构建演示工具
他介绍材料综合、课件组合、渐进式图示和现场教学演示。
我让 Claude 找出相关主题、通常的顺序和材料缺口,再提出两门各一天、也可组合成两天的大师课。我还要求它按主题整理 PDF 内容,并根据我的笔记建议教学脉络。综合结果比我预期的有用得多。
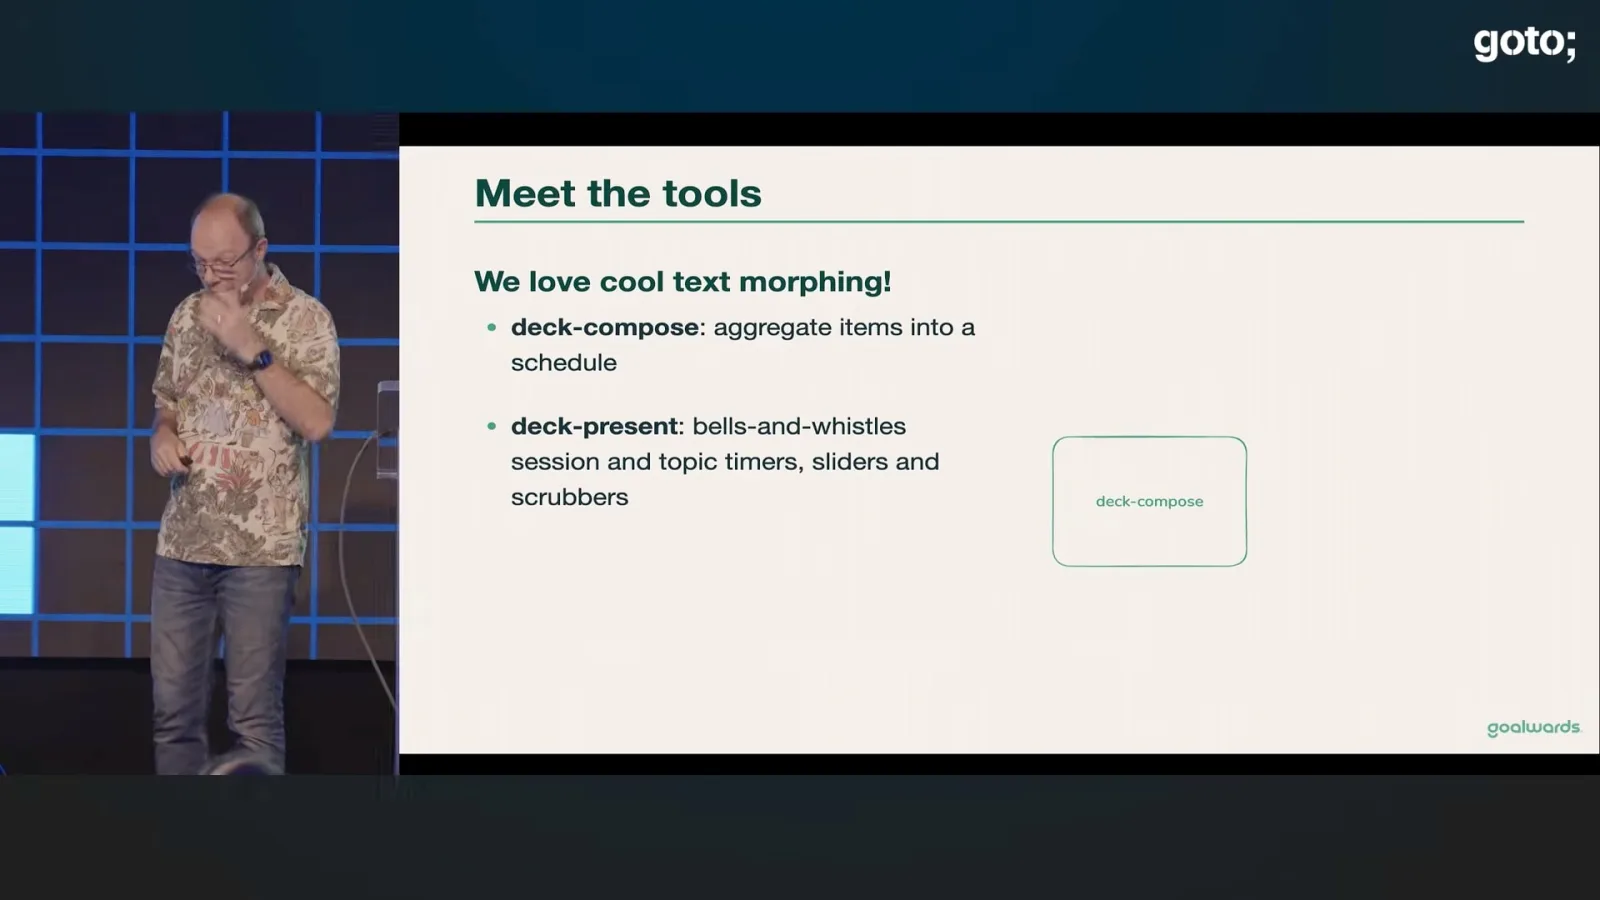
结果又带来了新需求:我需要组合和展示许多小型 Markdown 课件的工具。现有的演讲者视图不适合我的培训流程,于是我借助 AI 构建了 deck-compose 和 deck-present,加入日程、主题计时器、导航和视觉过渡等功能。我正在用这套工具展示这场演讲。
我还希望讲解时图示能逐步构建。我不想反复复制 Excalidraw 图并从每份副本中删除内容,于是指定编号的帧标记,让工具生成各个 SVG 阶段。原本的辅助工作因此发展成一组独立工具。
在演示中,一条“Phone Home”消息随着教学要点逐步高亮。另一个练习让学员提出供应商 API 未及时准备好时的处理方法;他们的答案出现在演示中,还可以加入该班专属的 PDF。
优势与局限
演讲从综合与代码复用转向自信出错和无效护栏的风险。
最强的模型很擅长综合材料,包括处理杂乱的内容。我用竞猜节目作比喻:它们往往能对熟悉的问题给出看似合理的常见答案。在我看来,这种实用性并不证明它们有意识,也不保证常见答案一定明智。
我记得有一场编程比赛,参与者只能通过复制互联网上已有代码来修复失败的测试。在我看来,生成式 AI 类似这种复用的广泛版本:很多日常编程问题都有先例。输出仍需要人判断是否适合当前问题。
危险之处在于,指令是启发式提示,而不是可靠的外部规则。我让助手编写脚本,从旧注册商移除域名。按我的描述,它提出的模拟运行缺少保护条件,结果删除了一个域名;修正之后,它又删除了其余域名。域名已经迁走,但后果本可能严重得多。
我发现模型可能忘记指定的工具、写出只是表面满足测试的代码,并自信地评价自己的工作。明确要求再检查一次可能暴露问题。助手可能像热心的小狗一样坚持行动,却拥有真实权限,因此外部边界很重要。
我把持续改进的 Kaizen 与方向突变的 Kaikaku 作比较。助手可能不断攀登同一座局部山丘;人可能需要指出另一座山。提示词说“你是专家”,也不能取代真正专家拥有的详细知识和判断。
更大步长的测试先行
一次非正式对比改变了他与助手结合测试先行和重构的方式。
我发现助手先详细规划了实现,再写完所有测试并粘贴代码,却称这为测试先行。这不是我所理解的严格 TDD 中细小的红、绿、重构循环。我决定比较不同方法,而不是假定自己偏好的方式一定更好。
在我的非正式实验中,助手一次用单批生成,另一次用严格的测试、代码、重构循环解决同一问题。我们认为单次生成版本更好:两者行为和测试相似,但增量版本为测试暴露了更多内部接口。这只是一次实验,并非普遍性基准。
固定齿轮自行车给了我一个更大步幅的比喻。我现在使用一个“大步测试先行”技能:先写一批测试和代码,再明确重构整个较大的片段,然后继续。这个节奏不同于我习惯的小步操作,但在这个项目中对我有效。
相邻工程
他主张保留人的判断和外部控制,同时利用 AI 创造选择并拓宽探索。
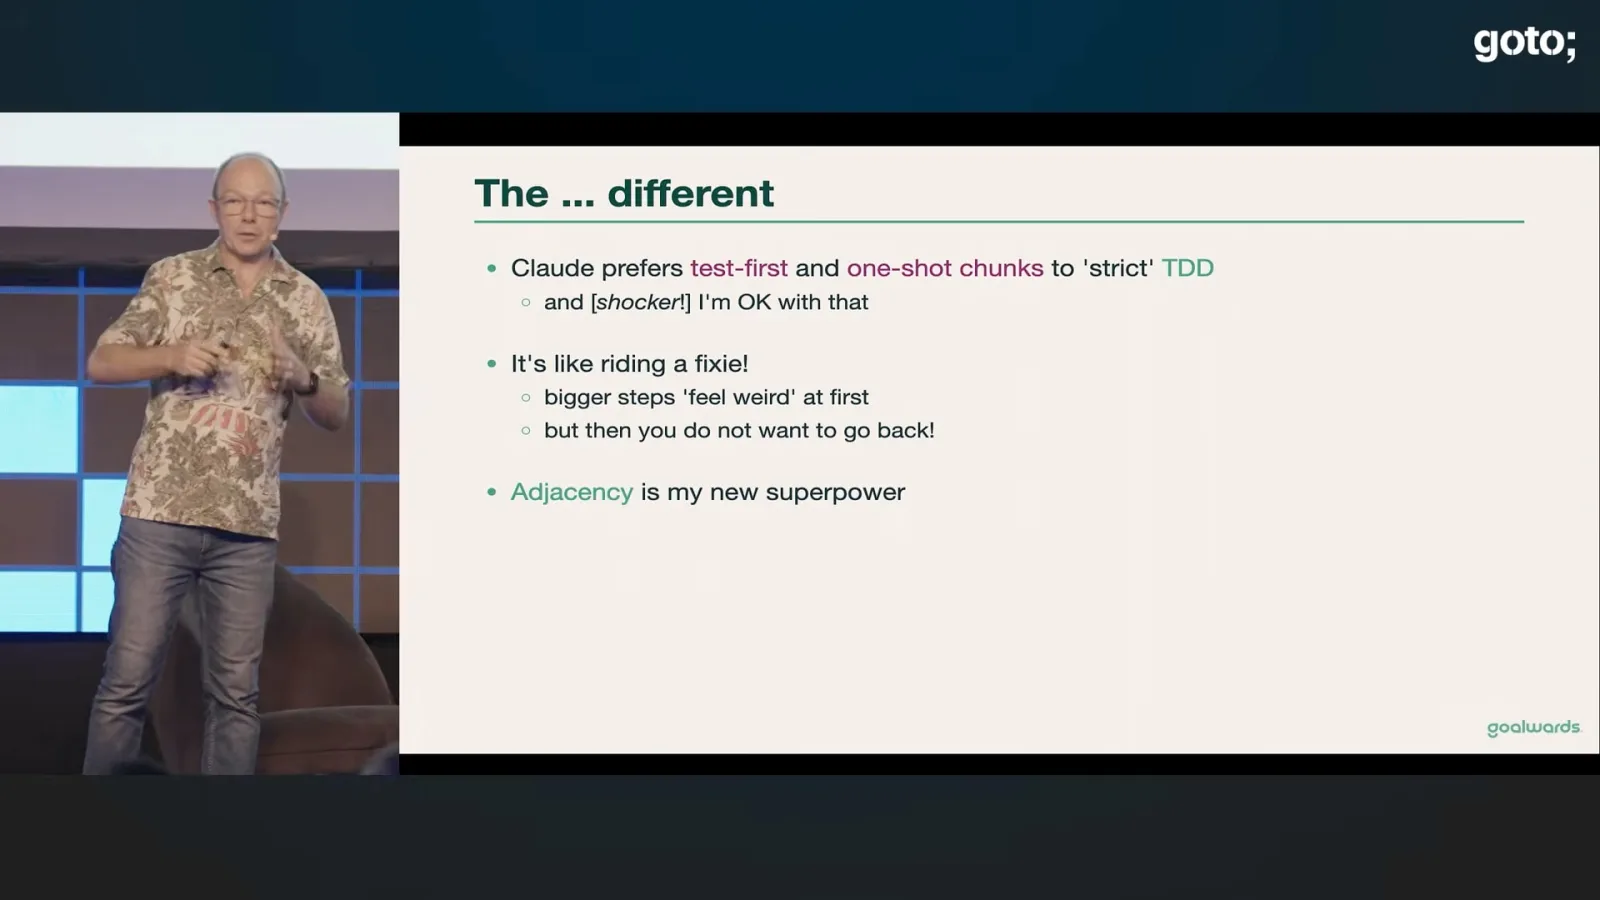
更广泛的重点是选择空间。我使用生成式 AI 主要不是为了更快,而是为了拓宽范围,进入自己足以监督、却原本没有时间掌握的相邻工作。有些侧面实验还可能发展成产品,我称之为相邻发现。
对于演示工具,我报告的规模约为两万行实现代码、三万六千行测试、五千个单元测试,以及数百个浏览器集成测试。测试套件让我有信心修改系统,包括谨慎地从 JavaScript 迁移至 TypeScript。这些数字是我的项目报告。
每个新会话都像一位带着前任笔记的新顾问:听起来很熟悉,却需要重新建立上下文。我认为这些工具擅长综合与渐进工作,但我区分它们的能力与人类的自主性、智慧和人格。这些是我的理解,不是已经定论的科学结论。
我用国际象棋专家作比喻,说明更快地计算与以不同方式识别局面之间的区别。我认为,人类专业能力包含通过经验发展出的判断,不应轻易将模型流畅的输出等同于这种判断。
我的实际提醒是:写在提示词中的规则只是启发式约束,模型出错时可能和正确时一样自信,而且它不是人。当规则必须生效时,应将其放到 linter 或其他执行工具中。利用这项技术创造更多选择、探索更多想法。
同频道的其他文章
 44:42EN → 简体中文
 GOTO Conferences· 2026年11月4日Adam Tornhill:面向 AI 的健康代码与可持续智能体开发Adam Tornhill智能体编程可以加速交付,但复杂度可能抵消收益。Adam Tornhill 介绍代码健康度研究与大规模重构案例。
 51:06EN → 简体中文GOTO Conferences· 2026年11月4日Kent Beck:AI 编程、森林与人的需求Kent BeckAI 会放大软件团队原有的工作方式。Kent Beck 呼吁保留未来的选择,并围绕人的需求设计工具。
 40:04EN → 简体中文GOTO Conferences· 2026年11月2日Sophia Drossopoulou:如何在开放世界中验证可信代码Sophia Drossopoulou · Imperial College London当可信代码调用未知对象时,能力、有作用域不变量和明确的信任假设有助于推理其影响。
 51:06EN → 简体中文GOTO Conferences· 2026年11月2日Kent Beck:为人的需求构建 AI 编程工具Kent Beck“精灵”会放大健康或不健康的开发实践。Beck 呼吁工具保留学习、连接与未来选择。
 20:04EN → 简体中文GOTO Conferences· 2026年10月30日Somtochi Onyekwere:将协议逻辑与 I/O 分离,实现确定性测试Somtochi Onyekwere · Fly.ioSans I/O 设计让本地模拟器可以使用虚拟时间和受控故障运行数千个协议状态。
 39:12EN → 简体中文GOTO Conferences· 2026年10月28日Cate Huston:严谨如何支撑 AI 辅助开发的交付速度Cate Huston · Twill两人团队分享发布关口、自动检查、优先级和加快交付的成本。