30 秒看懂
在 GOTO Copenhagen,Adam Tornhill 认为代码质量对智能体和人类同样重要。他介绍了自动代码健康反馈、《街头霸王 III》重构案例,以及识别架构协调瓶颈的方法。
- 1代码健康度与智能体Tornhill 介绍其团队关于代码健康度与智能体测试失败的研究。
- 2反馈循环MCP 服务器提供代码健康问题,供智能体在审核前处理。
- 3大规模遗留代码案例结合质量反馈、重放检查和可复用的重构手册。
- 4协调热点反复出现的合并冲突可能暴露工作与架构之间的不匹配。
要点建议
- 清晰、模块化的代码可以帮助智能体找到并安全修改正确的行为。
- 如果复杂度不断累积,最初的速度收益可能消失。
- 自动质量反馈可以引导智能体进行迭代式重构。
- 行为分析可以揭示导致协调冲突的架构热点。
按章节阅读整理后的全文
速度与质量
Tornhill 介绍自己的智能体开发经验,以及有关质量与复杂度的研究。
软件开发的某些方面每周都在变化,但基本原则保持得出奇稳定。我想借助行为代码分析,理解这些原则如何适用于智能体编程。
我在 2025 年 9 月手写了最后一行代码,此后一直以智能体方式工作。在我的经验中,与智能体协作比手写代码更难,但几个月后,我们团队的任务完成速度提高了两到三倍。
更有趣的好处是速度带来的新可能,包括过去不会尝试的任务。智能体也能帮我自行解决障碍:对于简单的 GitHub Actions 修改,我不再需要打断同事并让他们切换上下文。
质量是明显的顾虑。我展示了一项 2025 年研究:采用 AI 后缺陷增加 41%。另一项覆盖一千多个开源项目的研究发现,最初的速度提升在两个月后消失,原因与代码复杂度增加有关。
我的理解是,智能体可能写出自己以后也无法安全修改的代码。因此,管理偶然产生的复杂度是智能体开发成功的关键。我用一个名为“代码健康度”的特定指标来讨论这一问题。
代码健康度与编程智能体
可读的结构有助于定位代码;演讲者介绍健康度与智能体破坏率的研究。
看一个充满嵌套条件的密集函数,我们甚至很难判断它属于什么领域。重构后,它作为智能体循环的意图变得清晰,也有明显的位置可供修改反馈评估逻辑。这有助于人和智能体定位代码,并限制变更影响范围。
我们早期的 Code Red 研究发现,健康代码与更快的任务完成速度和更少的缺陷相关。这些结果早于生成式 AI,因此我们的研究团队进一步询问:代码健康度对编程智能体是否也重要?
在 Code for Machines 研究中,我们使用了一个具有强自动化测试的公开竞赛编程数据集。智能体接收任务,测试失败则计作一次破坏。公开数据集也让其他人能够用不同模型或指标重复实验。
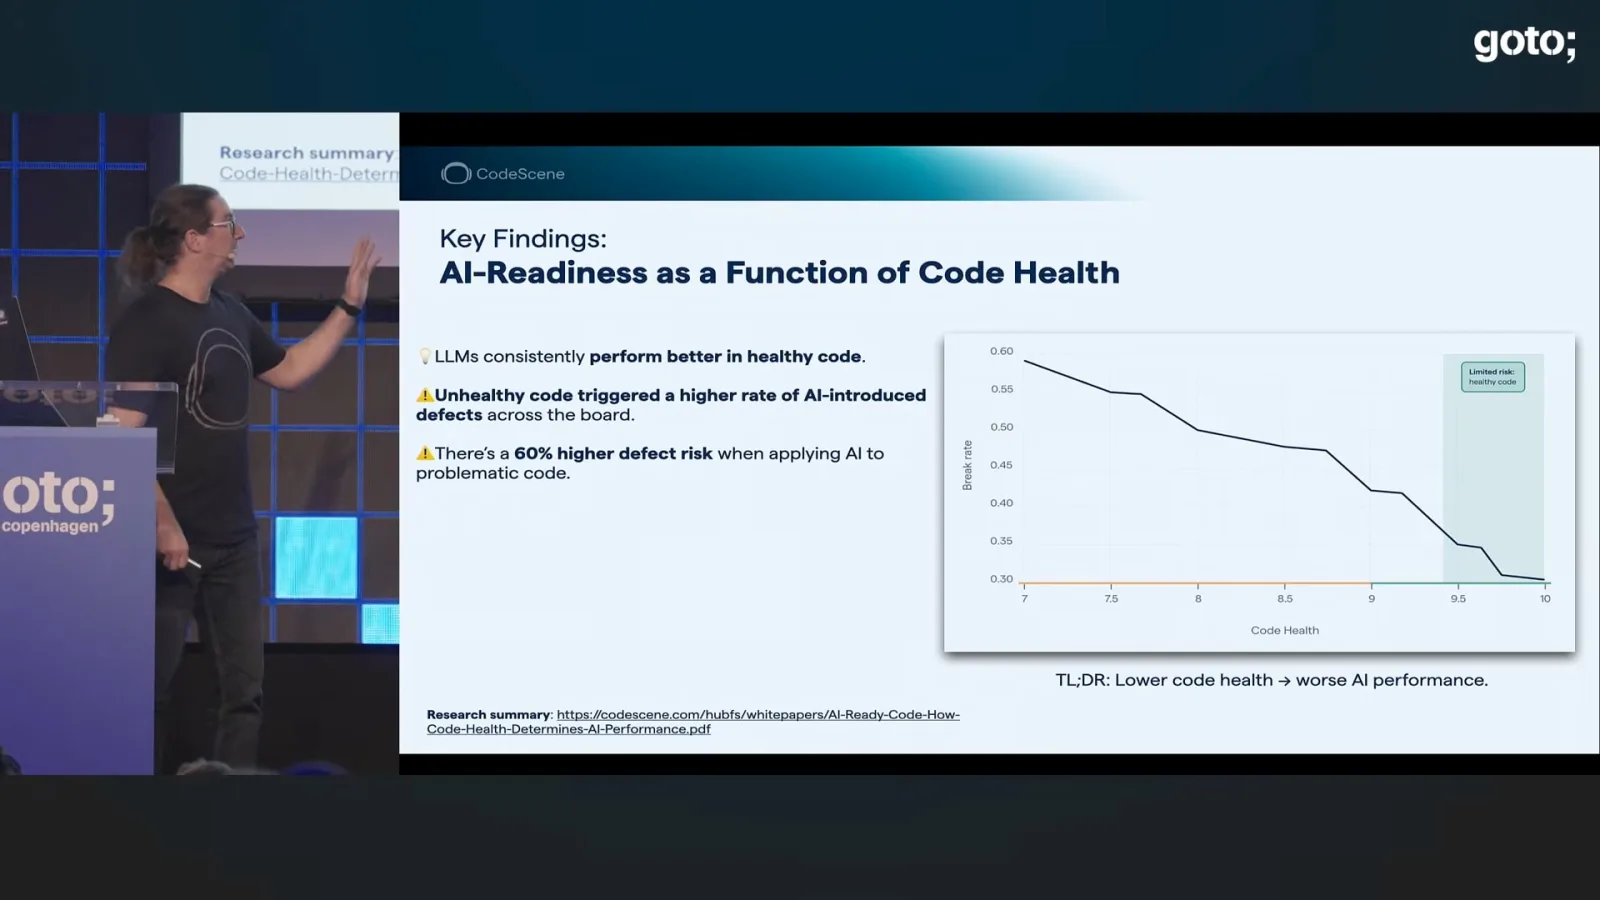
这种关系比我预想的更强。在我们的代码健康度量表上,9 分原本被设定为人类可读的水平,但研究发现,与最健康的代码相比,智能体的缺陷风险已明显上升。我认为智能体需要更高的质量标准,在这一特定量表上达到 9.5 或更高。
即时软件的错觉
一个生成的 C++ 示例展示了首次发布之后会累积的风险。
能否直接让智能体重写遗留代码?我让它扩展一段 C++ 代码,向分析服务报告按键。结果最初看起来能运行,但一个函数承担了太多职责,而且逻辑嵌套很深。
生成的代码也缺少稳健的错误处理:异常可能造成资源泄漏,而捕获所有异常的语句可能静默吞掉错误。我担心的不只是第一版不整洁,还包括智能体以后难以安全地迭代自己写出的代码。
这就是“即时软件”的错觉。第一个原型只是开始;大量维护工作发生在发布之后,那时架构和可维护性才会体现价值。我引用了一项模拟六个月维护的研究,其中表现随着先前决策的累积而下降。
我还引用了一份工程报告,报告发现 AI 采用与错误和事故增加相关。这些数字是所引报告的发现,不能保证适用于每一个团队。我的结论是,生成和修改的代码需要质量保障。
质量保障与重构
自动反馈循环检查生成的代码,并引导智能体修复问题。
我们把代码健康度指标封装在 MCP 服务器中。智能体写入或修改代码后进行检查,接收深层嵌套或模块化不足等具体问题,再重构并重新检查。
在支付验证示例中,第一版得分很低。反馈促使智能体进行第二次、第三次尝试。目标是让人工审核从已经过自动健康检查的代码开始,而不是用检查取代人工验证。
保障新改动只是第一步,现有的关键业务代码也必须便于智能体处理。在我们的数据集中,我报告的平均代码健康度为 5.15,远低于我建议的智能体开发水平。
这一差距表明遗留代码可能制约采用。我们研究了智能体能否自行改善代码。一项实验中,智能体在质量较差的代码中修复了更多明显问题,但随着健康度提升就变得保守,常做一些对底层设计改善不大的重命名。
当我们通过 MCP 服务器提供具体的代码健康问题后,智能体获得了目标和障碍说明,能够制订计划、处理问题并衡量进度。接着我们询问,这种方法能否大规模应用。
街头霸王案例
团队将重构循环与手册应用于大型遗留 C 代码库。
我们选择了《街头霸王 III》一个约有 25 年历史、包含约 30 万行 C 代码的代码库作为案例。目标是在保持功能正确性的同时提高代码健康度,使智能体能更安全地添加功能。
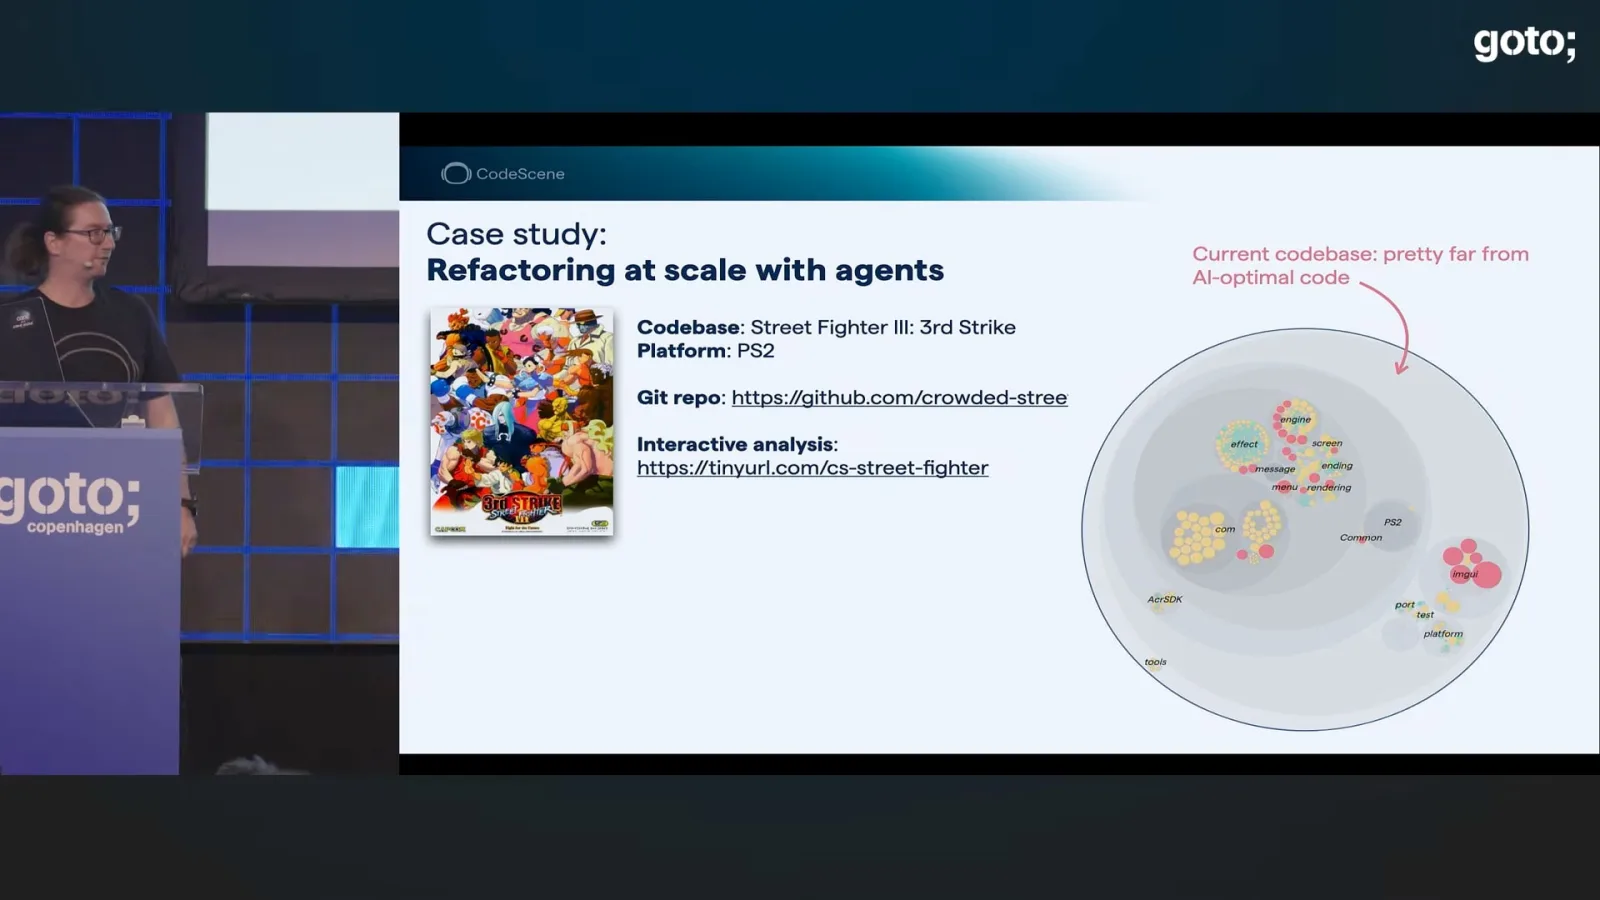
团队使用重放轨迹,并比较修改前后截图帧的哈希,同时实际试玩。代码健康度提供质量信号。智能体还构建了一份重构手册,记录成功的转换、适用条件和约束。
两位同事在处理其他工作之余参与该项目。建立流程和测试花了约两周,随后自动化改善耗时不到一周。我们尝试了多个模型,最终选择了一个更善于记录重构过程以充实手册的模型。
最终,各文件在我们的指标上达到 10 分。我过去会预计这样规模的人工工作需要专家团队和数月时间,因此结果令我惊讶。这个分数只是我们框架中的度量,并不证明所有可能的缺陷都已消除。
手册包括提取函数等常见转换,也包括专门针对该代码库、定义非常具体的规则。每条规则都记录其适用场景和限制。
例如,有两个函数分别对 X 和 Y 坐标执行相同变换。智能体提取共同过程,并用函数指针传入变化的操作。其底层机制类似策略模式。
这个做法有价值之处在于规则的具体性。笼统地要求到处应用策略模式可能造成麻烦;而狭窄的规则能把局部问题映射到通用知识,并在条件满足时机械地复用。
分数不应只是虚荣指标。我们的研究发现健康代码与更低的 token 用量相关,跨语言的可比工作平均少用 40% 至 45%。对于本案例,我估计未来缺陷风险和 token 成本会下降;整个改善过程的 API token 成本约为 4000 美元。
架构与协调
贡献者热点可以揭示迫使独立工作相互碰撞的代码结构。
除了单个文件,智能体编程加速还会带来协调问题。团队常用更好的拉取请求队列或冲突解决工具应对反复出现的合并冲突,但这可能只是在处理症状,而不是架构原因。
行为代码分析可以显示哪些文件被许多贡献者或智能体反复修改。在 Meta 的 Folly 项目可视化中,一个异步套接字文件在六个月内有 58 位作者参与修改。这是值得调查的信号,本身并不是诊断结论。
查看该文件,我看到了深层嵌套和集中在一个大模块中的许多职责。这样的“上帝类”会形成交通堵塞:即使开发者处理不同功能,也不得不修改同一处代码。模块化不仅能改善局部复杂度,也能降低组织摩擦。
我认为,在模块级代码健康之外,使架构对 AI 友好是下一个挑战。拥有扎实工程实践的组织更有条件从智能体中获益。我的结论是:工具变化时,仍要持续投入软件工程的基本功。
同频道的其他文章
 51:06EN → 简体中文
 GOTO Conferences· 2026年11月4日Kent Beck:AI 编程、森林与人的需求Kent BeckAI 会放大软件团队原有的工作方式。Kent Beck 呼吁保留未来的选择,并围绕人的需求设计工具。
 40:04EN → 简体中文GOTO Conferences· 2026年11月2日Sophia Drossopoulou:如何在开放世界中验证可信代码Sophia Drossopoulou · Imperial College London当可信代码调用未知对象时,能力、有作用域不变量和明确的信任假设有助于推理其影响。
 51:06EN → 简体中文GOTO Conferences· 2026年11月2日Kent Beck:为人的需求构建 AI 编程工具Kent Beck“精灵”会放大健康或不健康的开发实践。Beck 呼吁工具保留学习、连接与未来选择。
 20:04EN → 简体中文GOTO Conferences· 2026年10月30日Somtochi Onyekwere:将协议逻辑与 I/O 分离,实现确定性测试Somtochi Onyekwere · Fly.ioSans I/O 设计让本地模拟器可以使用虚拟时间和受控故障运行数千个协议状态。
 39:12EN → 简体中文GOTO Conferences· 2026年10月28日Cate Huston:严谨如何支撑 AI 辅助开发的交付速度Cate Huston · Twill两人团队分享发布关口、自动检查、优先级和加快交付的成本。
 22:33EN → 简体中文GOTO Conferences· 2026年10月26日William Schor:Netflix 如何从单元测试走向合成金丝雀William Schor · Netflix用生成的工作负载和接近生产的基础设施,测试分布式键值服务。