30 秒看懂
2025 年 1 月,Matthew Berman 讨论 DeepSeek-R1、它与中国量化投资公司幻方量化的联系,以及模型发布引发的反应。他权衡有关训练成本、GPU 获取和推理经济性的说法,认为成本降低可能扩大需求。广泛流传的 500 万美元数字实际上是范围较窄的 DeepSeek-V3 训练算力估算,并非 R1 的全部研发成本。
- 1R1 发布DeepSeek 发布开放权重推理模型并介绍其训练方法,于 2025 年 1 月引发广泛关注。
- 2成本数字的含义V3 报告中的 557.6 万美元是对特定训练阶段 GPU 小时的估算,并非 R1 的完整预算。
- 3与幻方量化的联系Berman 讨论 DeepSeek 与一家量化交易公司的联系;社交媒体将其称为单纯副项目,并不是经过核实的成本明细。
- 4未经证实的说法关于政府秘密指挥或隐藏特定数量 GPU 的说法需要证据;视频将其呈现为有争议的猜测。
- 5需求与反弹效应Berman 认为效率提升可能扩大推理需求,但反应的大小及其对总支出的影响需要实证检验。
- 6开放研究Yann LeCun 强调共享研究和工具的价值;R1 已公开的权重与报告支持进一步实验。
要点建议
- DeepSeek 发布了 R1 权重和技术报告,但详细的训练方法不等于发布了精确复现所需的每个数据集和组件。
- 广泛引用的 557.6 万美元估算根据假定的 GPU 租赁价格计算 DeepSeek-V3 特定训练阶段的费用,排除了此前研究和实验,并非 R1 的总研发成本。
- 视频讨论的秘密 GPU 库存、政府指挥和异常低廉的 API 使用成本等说法,并未由所引用的社交媒体帖子证实。
- 单位成本降低可能增加使用量,但总支出或算力需求反弹并无保证。
- 基准测试比较取决于测试任务和配置,仅有更多算力并不能保证得到最好的模型。
按章节阅读整理后的全文
发布与成本争论
Berman 描述 R1 引发的反应,并将其与大型基础设施投资计划比较。常被引用的训练成本针对 V3,且排除了重要开支。
DeepSeek-R1 于 2025 年 1 月发布,在 AI 行业内引起强烈反应。这是一个公开了权重和技术报告的推理模型,其他人可以在适用条款下研究和运行它。与 OpenAI o1 的比较基于特定评估,不应推广到所有任务。
我重复了一个广泛流传的说法,称该模型训练成本约为 500 万美元。这需要更正:[DeepSeek-V3 技术报告](https://arxiv.org/abs/2412.19437)估算,V3 预训练、上下文扩展及 V3 后训练合计使用 278.8 万个 H800 GPU 小时,按每 GPU 小时 2 美元计算约为 557.6 万美元。该数字不包括此前研究和消融实验;它并非 R1 及其单独后训练、硬件、人员或服务的完整成本。
模型发布时,美国正计划大规模建设基础设施。Stargate 在 2025 年 1 月的公告中称,计划在四年内投资 5000 亿美元;这是计划,不能证明全部金额已经支出。Meta 和其他公司也讨论了大量 AI 资本开支,引发人们对未来能否更高效地构建系统的疑问。
DeepSeek 于 2025 年 1 月 20 日发布 R1。其报告描述了多阶段推理训练方法,选定基准测试结果与同期模型具有竞争力。尽管权重和重要细节已经公开,并非每个数据集和训练组件都已发布;能否复现以及运行大型模型的实际成本仍是不同的问题。
最初的兴奋随后演变为关于大型 AI 公司是否过度支出的争论。我不认为单凭这次发布就能证明它们的投资没有必要。比较成本需要以一致口径计算此前研究、训练、基础设施和推理,而不是把范围较窄的 V3 算力估算当成全部费用。
一则广泛传播的帖子将 DeepSeek 描述为与中国量化交易公司幻方量化有关的副项目。这种联系是公司背景的一部分,但社交媒体帖子并非对其人员、设备或目标经过审计的说明。开放权重可以在独立硬件上运行,但完整模型仍需要大量资源,使用托管 API 也有自己的成本。
量化基金与争议说法
他讲述与幻方量化的联系,以及公众对硬件和动机的猜测。社交媒体说法并非独立证据。
网上反应从低成本模型击败 OpenAI 的玩笑,到称此次发布是政府主导的经济战的指控,不一而足。我不接受 OpenAI 已被击败这一夸张结论;视频中关于秘密国家行动的说法也未经证实。仅凭模型发布或低 API 价格不能证明这种意图。
Scale AI 的 Alexandr Wang 推测 DeepSeek 可能拥有约 5 万块 NVIDIA H100 GPU,并讨论了美国出口管制。这是一项说法,并非独立核实的库存数字或违规证明。DeepSeek 报告披露了特定 V3 训练运行所使用的 H800 硬件和 GPU 小时;该数字不能说明公司全部硬件持有量。
我提到 Hugging Face 正在尝试复现该方法的部分内容。它后来发起的 [Open-R1 项目](https://huggingface.co/blog/open-r1)描述了重建数据和训练流程的工作,既体现了公开报告的价值,也说明完全开放地复现仍有工作要做。Emad Mostaque 也在社交媒体上提出成本估计;这些是估算,不是对 DeepSeek 总支出的审计。
一些社交媒体帖子声称大量 API 调用费用极低,并将其服务能力与竞争对手比较。这些轶事无法证明总体吞吐量、实际单位成本、盈利能力或部署的硬件数量。定价可能反映补贴、促销、输出长度等多种条件。
推理经济性与需求
Berman 区分训练与推理,并提出反弹效应的论点。效率和支出的最终结果仍不确定。
训练模型与提供回答服务是不同的成本。推理系统可以在推理时使用额外算力,更多计算可能对某些任务有帮助,但不能保证每次回答都更好。单凭公布的低 API 价格,无法看出服务商的全部成本,也不能证明其拥有独特的技术优势。
Wang 认为美国应加快创新并收紧芯片管制,同时将 DeepSeek 描述为对股票市场的潜在威胁。这些是政策和市场观点,并非模型发布所确立的结论。可以讨论出口管制、竞争和资本支出,而不必把未经核实的硬件数量当成事实。
我的第一种情景是,高效技术得到复现,推理成本下降。我引用杰文斯悖论:当一种资源变得更便宜时,使用量增加可能抵消部分甚至全部节省。但总能源消耗、GPU 需求或支出是否真的增加,取决于需求的响应程度;反弹是可能性,而非自动成立的经济规律。
第二种情景是,该公司拥有比某些人认为的更多的计算资源。我认为,在这两种情景下,投资仍可能有用,因为高能力系统有大量需求。我更强的说法,即拥有最多算力的人必然造出最聪明的模型,只是一项预测:算法、数据、工程、获取能力和部署同样重要。
Y Combinator 的 Garry Tan 也认为,更便宜的训练可能加速推理需求。这是合理的市场情景,但需求规模及其在不同公司之间的分布,并不会仅因一个模型发布而必然确定。训练经济性、服务经济性和数据中心投资回报应分别评估。
不同投资观点与开放研究
他讨论对资本支出的不同解读,并肯定开放研究。他对算力和模型领先地位的预测属于观点。
投资者 Chamath Palihapitiya 提出了不同观点,呼吁审查可能存在的受禁芯片获取,并区分训练芯片管制和全球推理市场。他还预测,投资者重新考虑企业资本支出时,市场会出现波动。这些是他的政策和市场论点,并非某次具体芯片转移已经发生的经核实结论。
我不同意更高效的模型必然使大型基础设施支出成为错误的观点。我预计更便宜的 AI 会进入更多应用场景并消耗可用算力;Palihapitiya 则认为,如果公司无需花那么多钱也能获胜,市场可能会奖励它们。结果取决于未来的定价、生产力、竞争和需求。
Palihapitiya 还认为,约束可以鼓励更有创造力的工程工作。这是一种值得考虑的可能性:有限资源可能促使团队提高效率。但它不能说明 DeepSeek 资源的完整历史,也不能证明大规模投资与创新互相排斥。
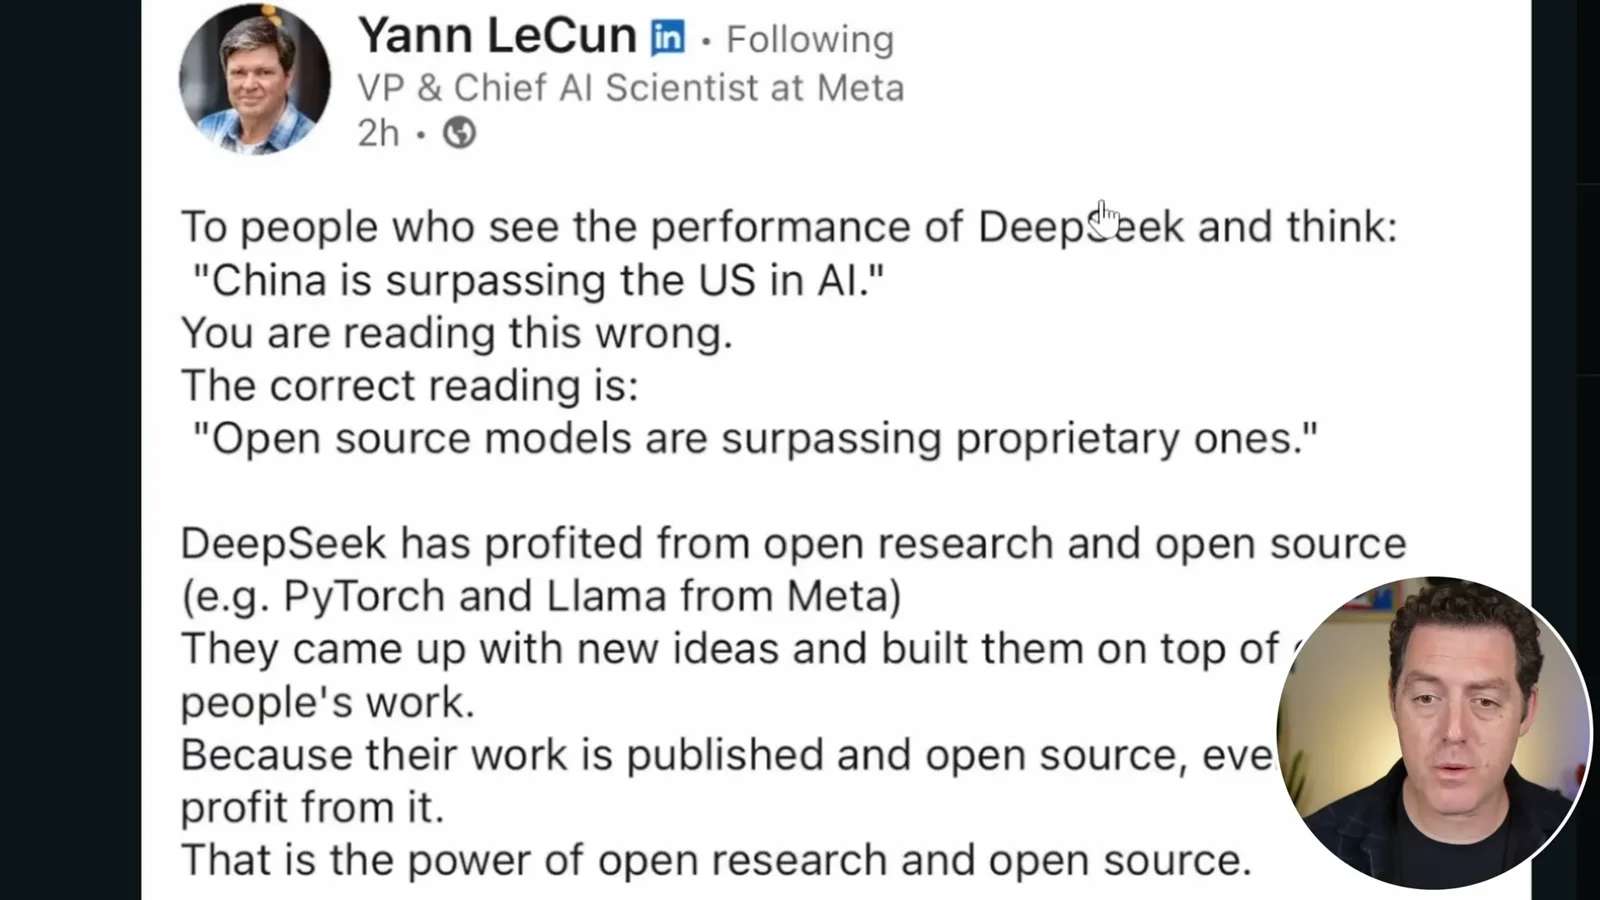
Yann LeCun 认为 DeepSeek 受益于开放研究和工具,包括 PyTorch 和 Llama,而公开改进让其他人能够继续在此基础上发展。我同意共享研究和权重可以扩大参与范围。但仍需区分:可获得的权重和论文支持实验,却不会自动提供精确复现所需的全部数据和材料。
录制时,关于 DeepSeek 硬件、成本和竞争影响的许多问题仍没有定论。我不想在隐藏资源的理论和“各方面都很便宜的副项目”叙事之间简单二选一,而将其视为一场仍在发展的讨论,涉及效率、开放研究和 AI 需求。每项说法所拥有的证据各不相同。
同频道的其他文章
 14:45EN → 简体中文
 Matthew Berman· 2026年10月29日Matthew Berman 解读 Google 的 Gemini 4 Carbon 公告Matthew Berman · Forward FutureMatthew Berman 回顾 Google 公布的 Gemini 4 Carbon 基准结果、分阶段开放计划与定价,同时指出自己尚未使用该模型。
 34:21EN → 简体中文Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。