30 秒看懂
Matthew Berman 逐一回顾 Google I/O 2024 的部分发布内容和演示。他最关注 Gemini 与个人数据和工具的整合、适用于编程的长上下文、多模态 Project Astra,以及能够执行多步骤任务的智能体。本文区分产品发布、预录演示、未来工作流设想与经过独立测量的能力。
- 1长上下文Google 讨论了 100 万和 200 万 token 的上下文窗口,Berman 看到了其处理大型代码库的潜力。
- 2Ask Photos演示通过自然语言搜索照片中的细节并总结成长里程碑。
- 3有人监督的智能体Google 设想智能体处理退货和搬家任务;Berman 更看重能大幅节省精力的工作。
- 4Project Astra预录的多模态演示结合了视觉问答、代码解释、语音和记忆。
- 5Workspace 自动化规划中的收据工作流经用户批准后,可整理附件并将字段提取到电子表格。
要点建议
- Google 发布了 Gemini 1.5 Flash,并讨论了 Pro 更长的上下文窗口。
- Ask Photos 和 Workspace 演示展示了 Gemini 搜索或总结个人资料的能力,但使用受到产品可用性和权限限制。
- Project Astra 作为实验性多模态助手展示,使用的是预录演示,而非大规模可靠性评估。
- Google 预览了 Veo,以及处理收据、搬家和团队协作的智能体工作流。
- Berman 认为整合数据是一项优势,同时担心过度依赖单一生态系统。
按章节阅读整理后的全文
Gemini 与搜索
Berman 介绍 Google 对 AI 的重视和长上下文模型的发布消息,并讨论搜索和竞争背景。
Google I/O 2024 发布了大量 AI 消息。我想和大家一起看看最有意思的部分,从 Google 产品中的 Gemini 到多模态助手演示,并将这些想法与 OpenAI 前一天展示的内容作比较。
Google 正在进一步将 Gemini 引入 Docs、Sheets、Gmail 和 Workspace,不过有些发布内容听起来似曾相识。让我特别关注的是长上下文窗口:Gemini 1.5 Pro 支持最多 100 万 token,Google 还在讨论 200 万 token。大窗口能带来新的用途,但本身并不能保证检索或推理完全准确。
Sundar Pichai 将 Gemini 描述为原生多模态模型,能够处理文本、图像、视频和代码。Google 还希望在其核心业务搜索中扩大 AI 的应用。我认为竞争压力显而易见,也预计人们会提出更长、更复杂的问题,并用照片进行搜索。
Ask Photos 与 Workspace
Google 演示自然语言照片搜索和邮件摘要。Berman 思考整合的个人数据如何支持主动式助手。
Google Photos 是我最喜欢的产品之一。Google 演示了 Ask Photos:你不用手动翻找多年照片中的车牌,只需提出问题,Gemini 就会利用照片上下文找到号码。这是一场产品演示,发布时该功能被称为实验性功能。
另一个例子询问一个孩子是什么时候学会游泳的,以及她的游泳水平如何进步。演示将图像、活动、日期和证书组合成摘要。我已经很喜欢自动整理的相册和回忆,因此能通过提问获得个性化版本,是我会使用的功能。
长上下文窗口尤其让我对编程感到兴奋:100 万 token 可以容纳一个大型代码库。Google 讨论了将窗口扩大到 200 万,我也提到听说内部正在探索更大的窗口。但这并不等于已经公开推出产品,也不能保证模型会正确使用每一个细节。
Google 在人们已经使用的服务上有优势。Gemini 可以利用邮件、文档和演示文稿回答问题,最终还可能帮助完成任务。我认为这比孤立的模型更有用,不过访问数据和执行操作仍取决于产品权限及可用性。
主题演讲精心制作并按照脚本进行,相比之下,我更喜欢 OpenAI 较为随意的展示方式。在 Google 的 Gmail 示例中,Gemini 总结了孩子学校最近发来的邮件和 PDF 附件。能够搜索并总结大量邮件,对我尤其有吸引力。
演示还介绍了当家长错过会议时,如何总结一段较长的 Google Meet 录音。我希望助手更进一步:发现我当时正在旅行,准备一份相关摘要并建议后续回复,但是否发送仍由我决定。
Google 展示了 Gemini 起草回复,自愿参加一场家长活动。我不希望每一步都单独输入提示词:助手可以根据上下文先准备草稿,供我审核批准。这是我希望未来实现的主动工作流,并不能证明演示已经做到。
NotebookLM 与智能体
学习材料演示预览了音频概览。Google 提出由用户监督的退货和搬家智能体。
NotebookLM 整理文档、PDF 和笔记,让用户围绕它们提问。在演示中,一位家长添加了科学练习题、幻灯片和教科书;工具可以生成摘要、学习指南、常见问题解答和测验。
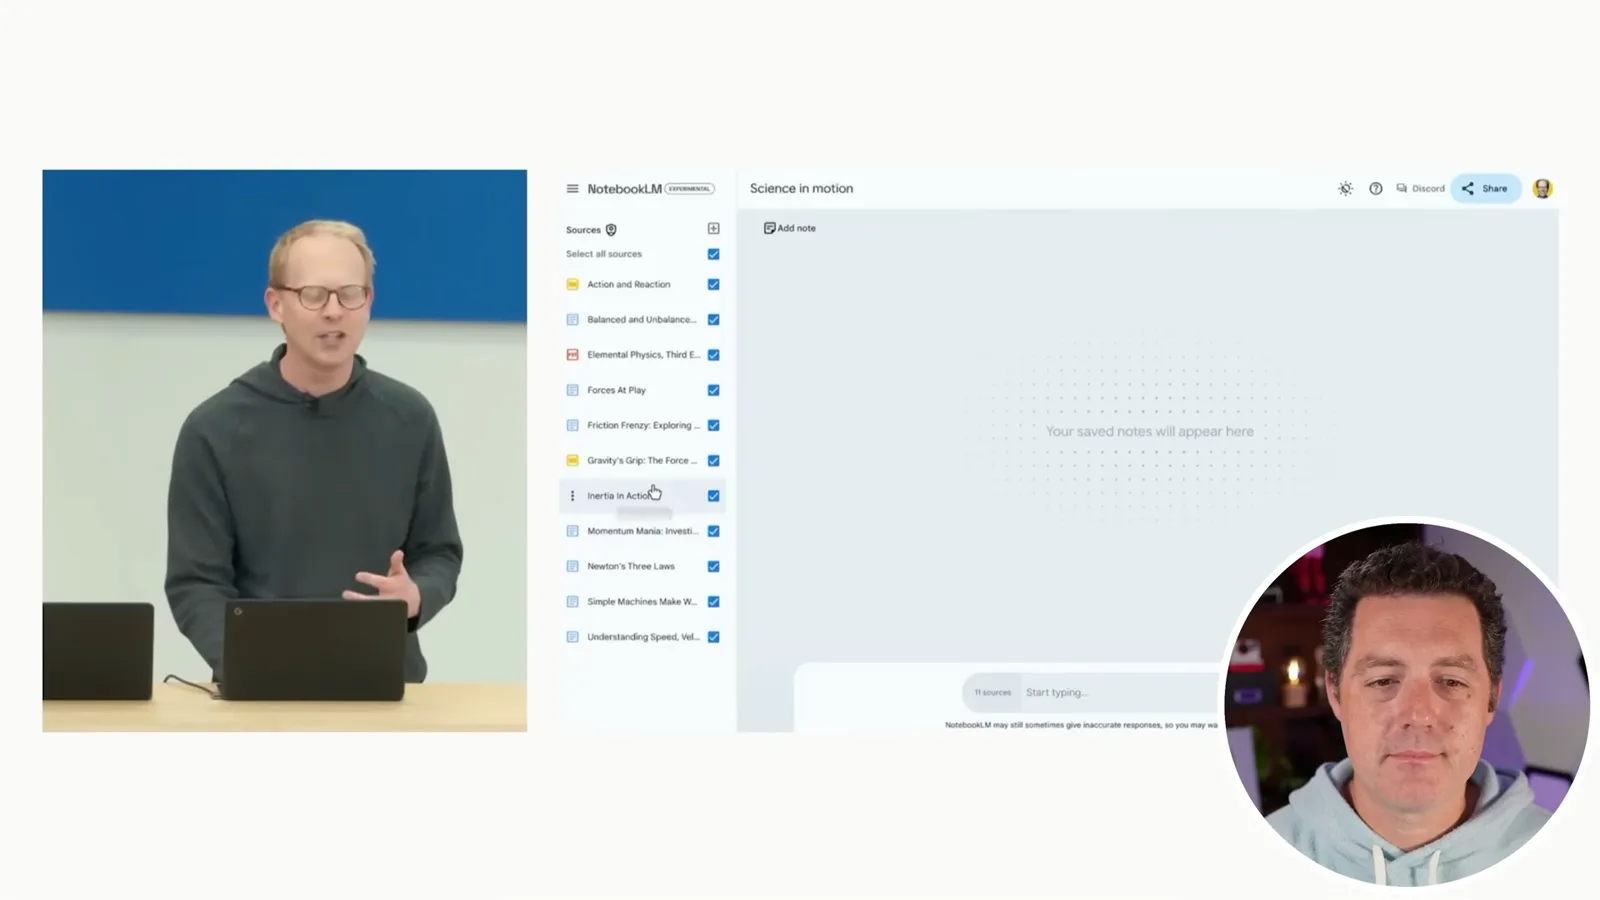
Google 预览了一项音频概览功能,将资料变成一段关于物理学的对话。我喜欢这个想法,但还没有找到适合自己的用途。对我来说,一项令人印象深刻的技术功能需要解决真实需求才有意义。
Google 将智能体定义为能够跨多个步骤和软件系统进行推理、规划和记忆,同时接受用户监督的系统。第一个例子是购物和退鞋,包括查找收据、填写表格和安排取件。虽然这一系列操作有用,但我认为这个任务不如其他工作吸引人。
第二个设想的工作流是搬到芝加哥:Gemini 和 Chrome 可以帮助寻找服务,并在许多网站上更新地址。寻找休闲活动比较普通,但在多个网站更新地址会节省大量时间。Google 将其作为原型展示,并表示需要时会要求用户提供更多信息。
Gemini Flash 与 Project Astra
Google 推出较小的模型,并播放多模态助手的预录演示。Berman 对其视觉、语音和记忆能力作出评价。
Demis Hassabis 介绍了 Gemini 1.5 Flash,这是一款较小的模型,旨在快速、经济地处理多模态任务。Google 表示,其开发者工具中的 Flash 和 Pro 均可使用最多 100 万 token 的上下文,并开放报名测试 200 万 token。这些是 2024 年大会上的发布信息。
随后,Google 展示了实验性多模态助手 Project Astra。我将它与 OpenAI 为 GPT-4o 展示的对话体验进行比较。Google 表示演示是以正常速度一镜到底预录的;即使演示令人信服,也不能衡量它在所有场景中的可靠性。
在 Astra 视频中,助手识别了一个扬声器及其高音单元,用蜡笔编了一句头韵句,并解释屏幕上的加密代码。随后,它识别出伦敦的一个地区,还记得曾看到一副眼镜放在苹果附近的桌子上。语音、视觉上下文和记忆之间的无缝切换让我印象深刻。
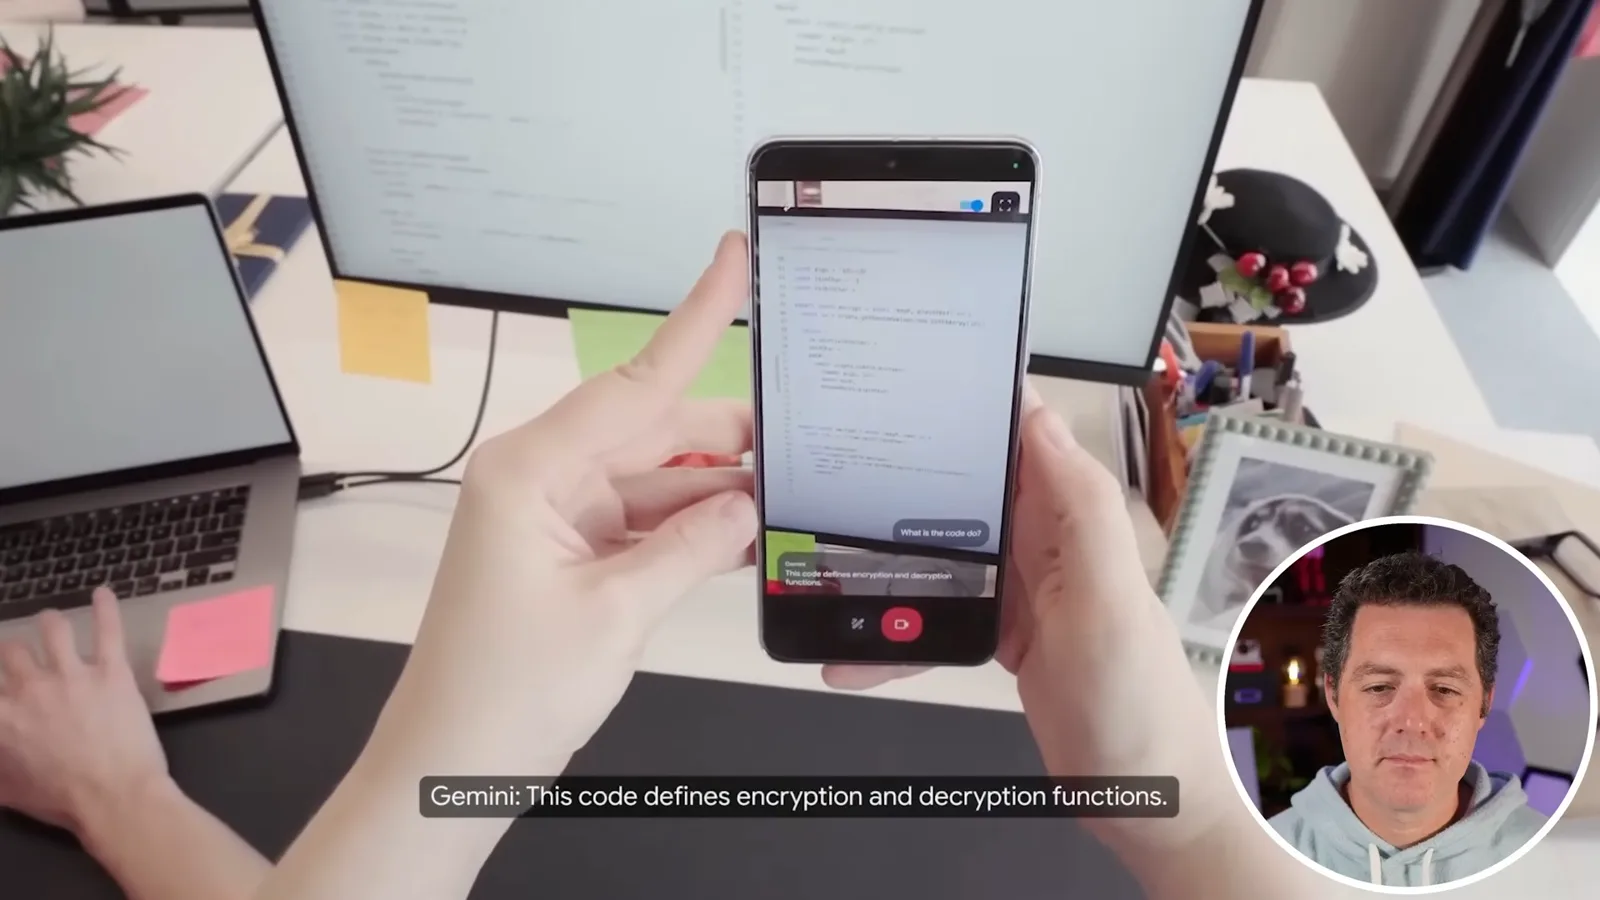
接下来展示的是带摄像头的眼镜。助手建议在服务器和数据库之间增加缓存,回答了另一个视觉问题,并想出了一个乐队名称。我希望拥有能这样自然来回交流的眼镜;我不知道演示中使用的具体硬件是什么。
Veo、搜索和 Workspace 自动化
大会预览了视频生成、AI Overviews 和收据处理工作流。Berman 评价了它们可能带来的实用价值。
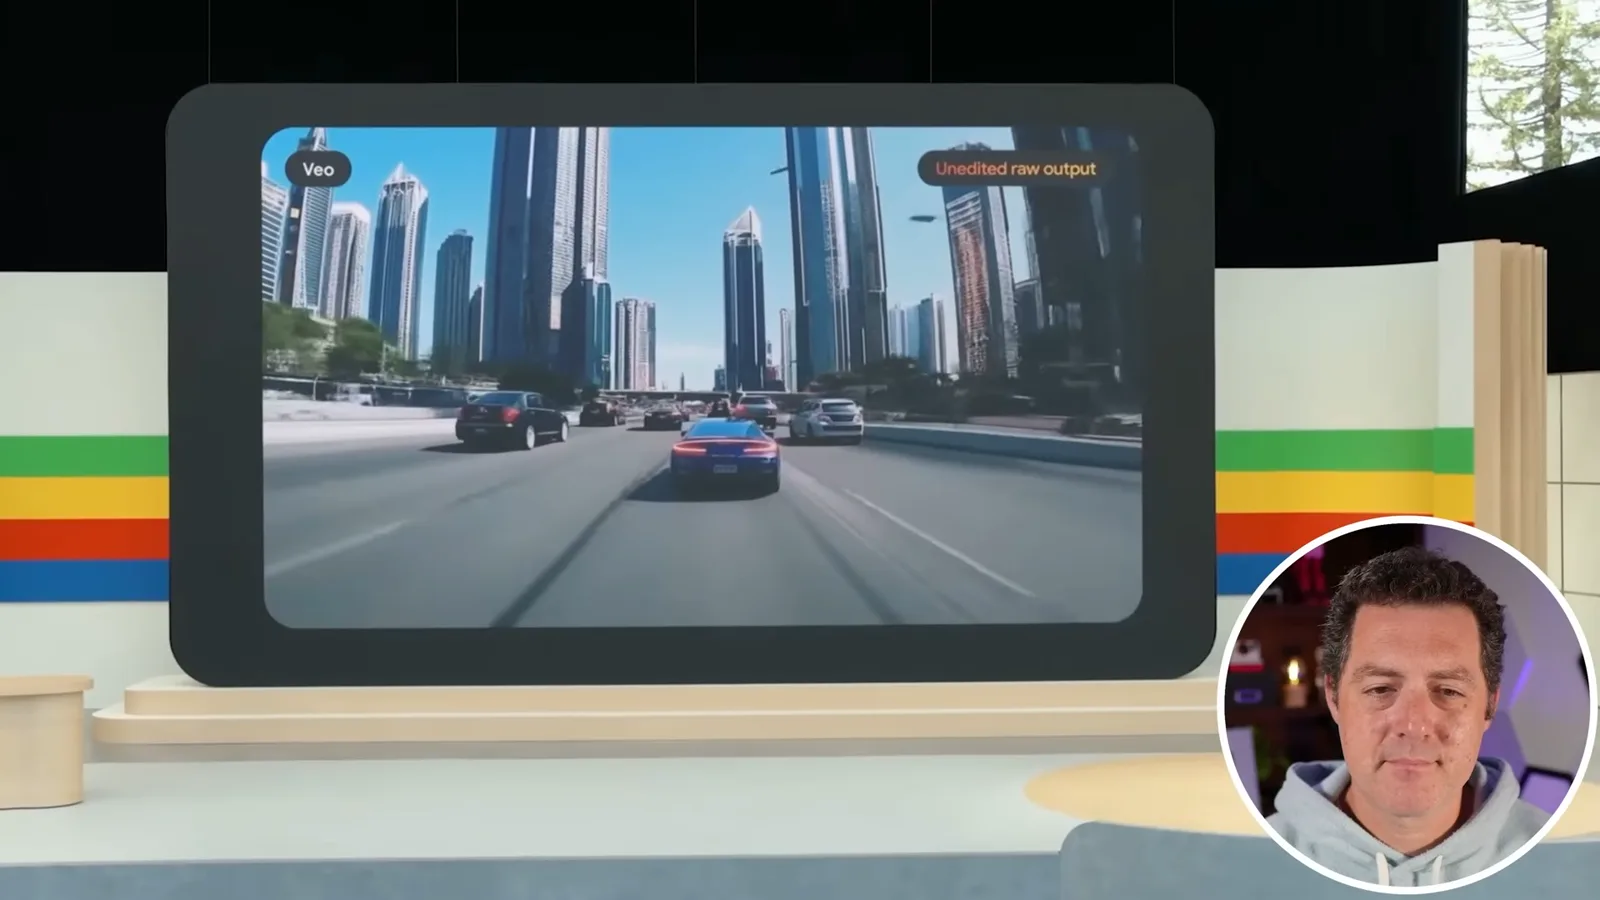
Google 还发布了 Imagen 3 和生成式音乐,但我的注意力放在视频上。Veo 被介绍为一款能够根据文本、图像和视频提示生成 1080p 视频的模型,支持电影化的指令和通过进一步提示进行编辑。Google 将 VideoFX 描述为实验性工具。
一段生成的驾驶场景中,汽车在空间中移动时看起来保持了一致性,我将其与 Sora 的演示进行比较。精选片段展示了系统能够生成什么,但不能说明每个生成场景都会有同样可靠的运动和一致性。
Google 又谈到了搜索中的 AI Overviews。一条关于瑜伽和普拉提工作室的复杂查询,汇集了评分和首次体验优惠。我认为这是 Google 试图让搜索产品更好地回答需要综合多条信息的问题。
Workspace 侧边栏演示从一封附有酒店收据的邮件开始。Gemini 提议找到这张收据和另外 37 张收据,创建一个 Drive 文件夹,并将商家、日期和费用提取到电子表格中。用户可以编辑或批准提议的操作。
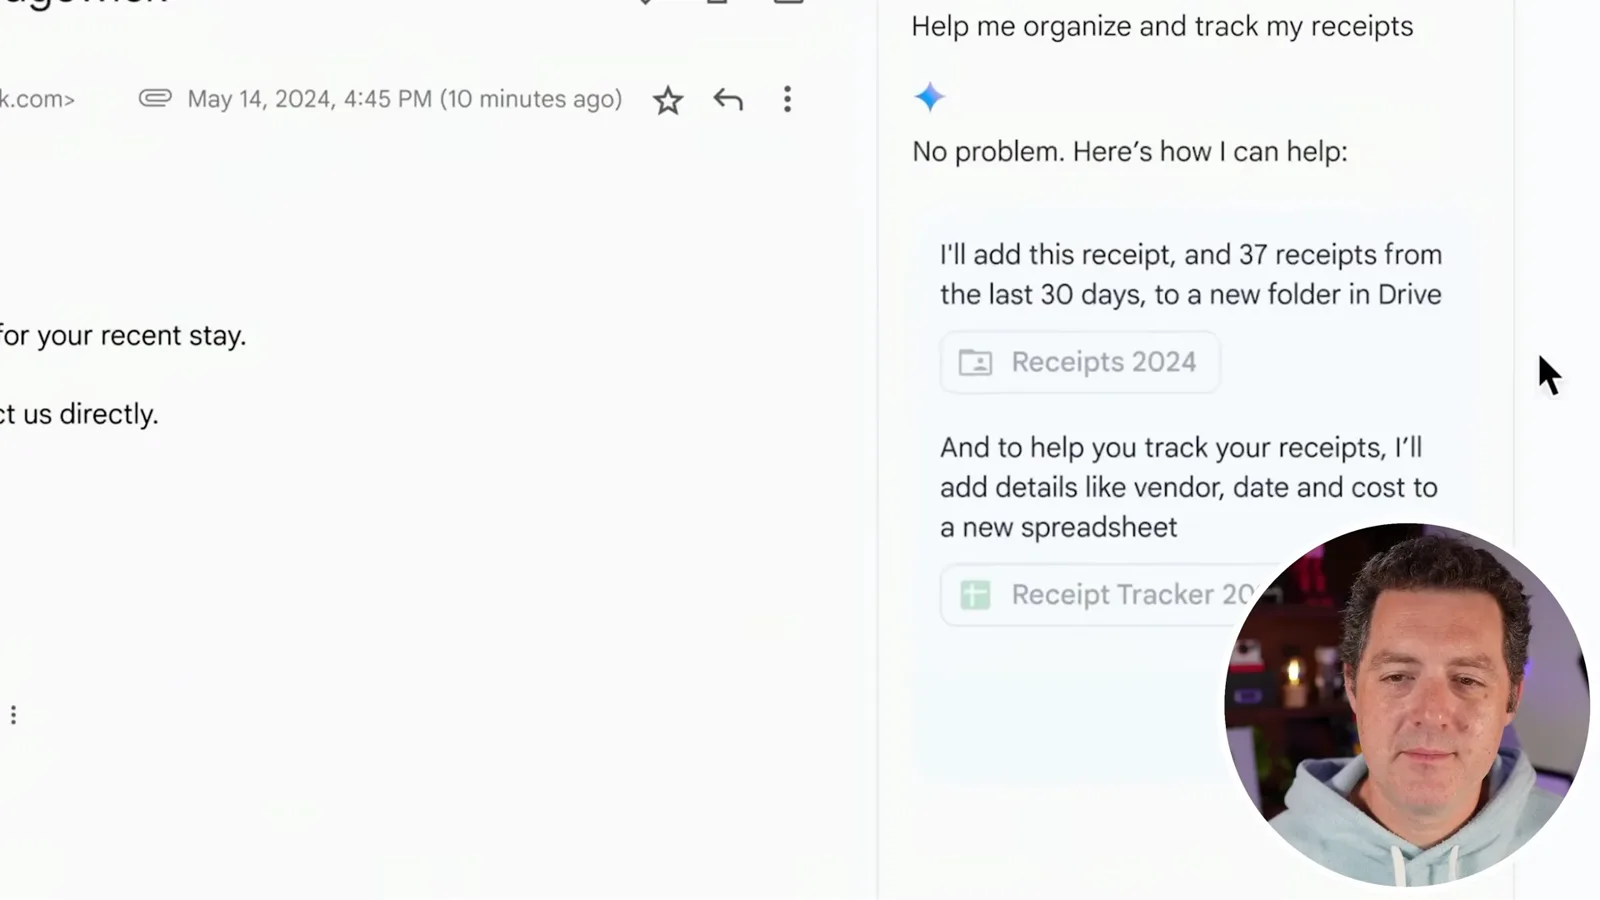
演示接着建议为未来的邮件自动执行同一工作流。这正是我想要的智能体行为:只需解释一次重复性任务,就让它持续完成。这里展示的是一种拟议体验,并非对它在所有收件箱中运行可靠性的独立评估。
虚拟队友与生态取舍
Google 演示了 Workspace 虚拟队友。Berman 权衡整合数据带来的便利与平台依赖。
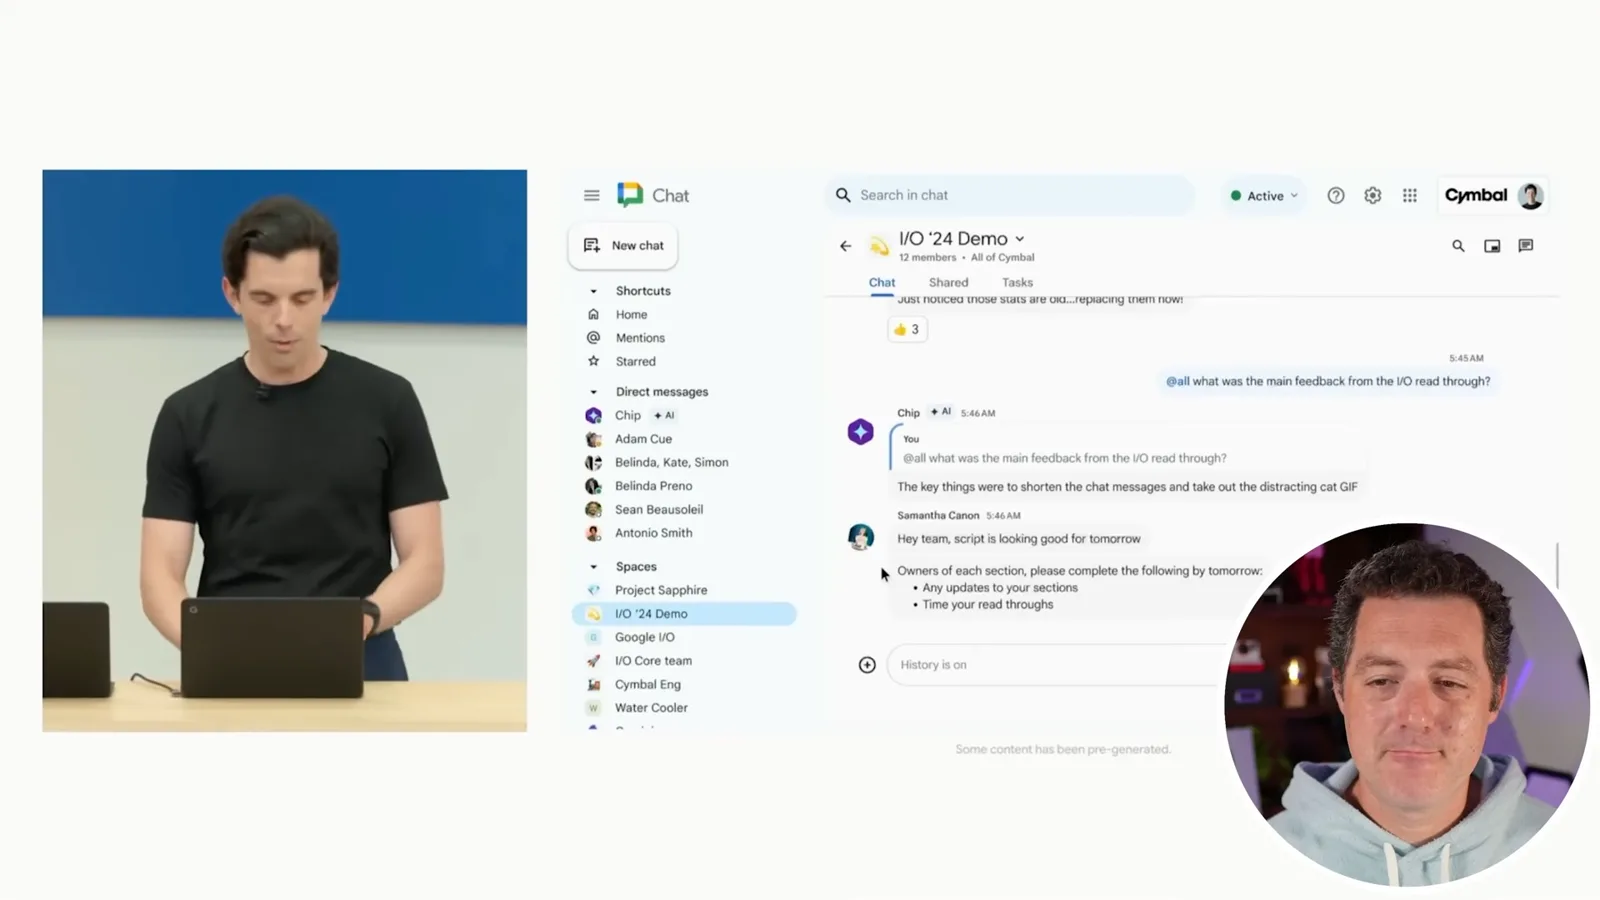
Google 还演示了名为 Chip 的虚拟队友,它拥有自己的账号、角色和监控项目的指令。我喜欢在配置时可以直接引用外部文档和其他上下文。
在 Google Chat 中,Chip 搜索项目对话,回答有关活动故事板的问题。我自己不使用 Google Chat,但这种从文档、邮件和对话中寻找答案的广泛能力,无论界面是什么都有价值。
这种整合也给企业带来了取舍。开源工具可能让企业更灵活地跨服务使用数据,减少对单一平台的依赖,但它们仍需要访问底层数据。如果提供商不开放这些数据,开放系统不能简单地假设自己能够获取。
Google 还讨论了 Pixel 手机上的 AI 功能。作为结尾的玩笑,Pichai 提到了去年关于“AI”一词出现次数的热门统计,并让 Google 计算今年的次数。这也结束了我认为最有意思的发布内容。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。