30 秒看懂
OpenAI o1-preview 于 2024 年 9 月发布后不久,Matthew Berman 用 Python 俄罗斯方块、信封尺寸、词数统计和物理推理等提示测试该模型。他称赞了几个回答,同时指出模型在北极题中混淆了原始起点和后来的转弯点。 视频还展示了一个主观伦理问题,以及 Berman 没有独立核实的高等数学答案。这些是说明性的单次测试,并非全面评估或当前排名。
- 1预览版与俄罗斯方块模型在展示的运行中生成可玩的俄罗斯方块;Berman 说此前一次运行需要修正。
- 2信封尺寸模型换算并检查了给定尺寸,包括方向。
- 3杯子与弹珠模型解释说,单独提起倒置杯子时,弹珠可能留在桌上。
- 4北极题错误它的纬线圈解释回到的是转弯点,而非最初的北极起点。
- 5未核实的数学答案预览版对较难的提示给出 721;Berman 没有独立检查。
要点建议
- 演示中的俄罗斯方块程序在首次尝试的短暂试玩中运行,但这不能验证全部游戏机制。
- 模型根据提示给出的尺寸检查了信封方向。
- 倒置杯子的回答区分了留在桌上的物体与被提起的杯子。
- 在北极测试中,模型把后来的转弯点误当作原始起点。
- 可见的思考文字是摘要;主观伦理判断和未经核实的数学答案需要采用不同于客观任务的评估方式。
按章节阅读整理后的全文
早期 o1-preview 编程测试
Berman 注意到 OpenAI 的一个示例与自己的弹珠问题相似,随后测试生成的俄罗斯方块游戏。画面显示的推理是摘要。
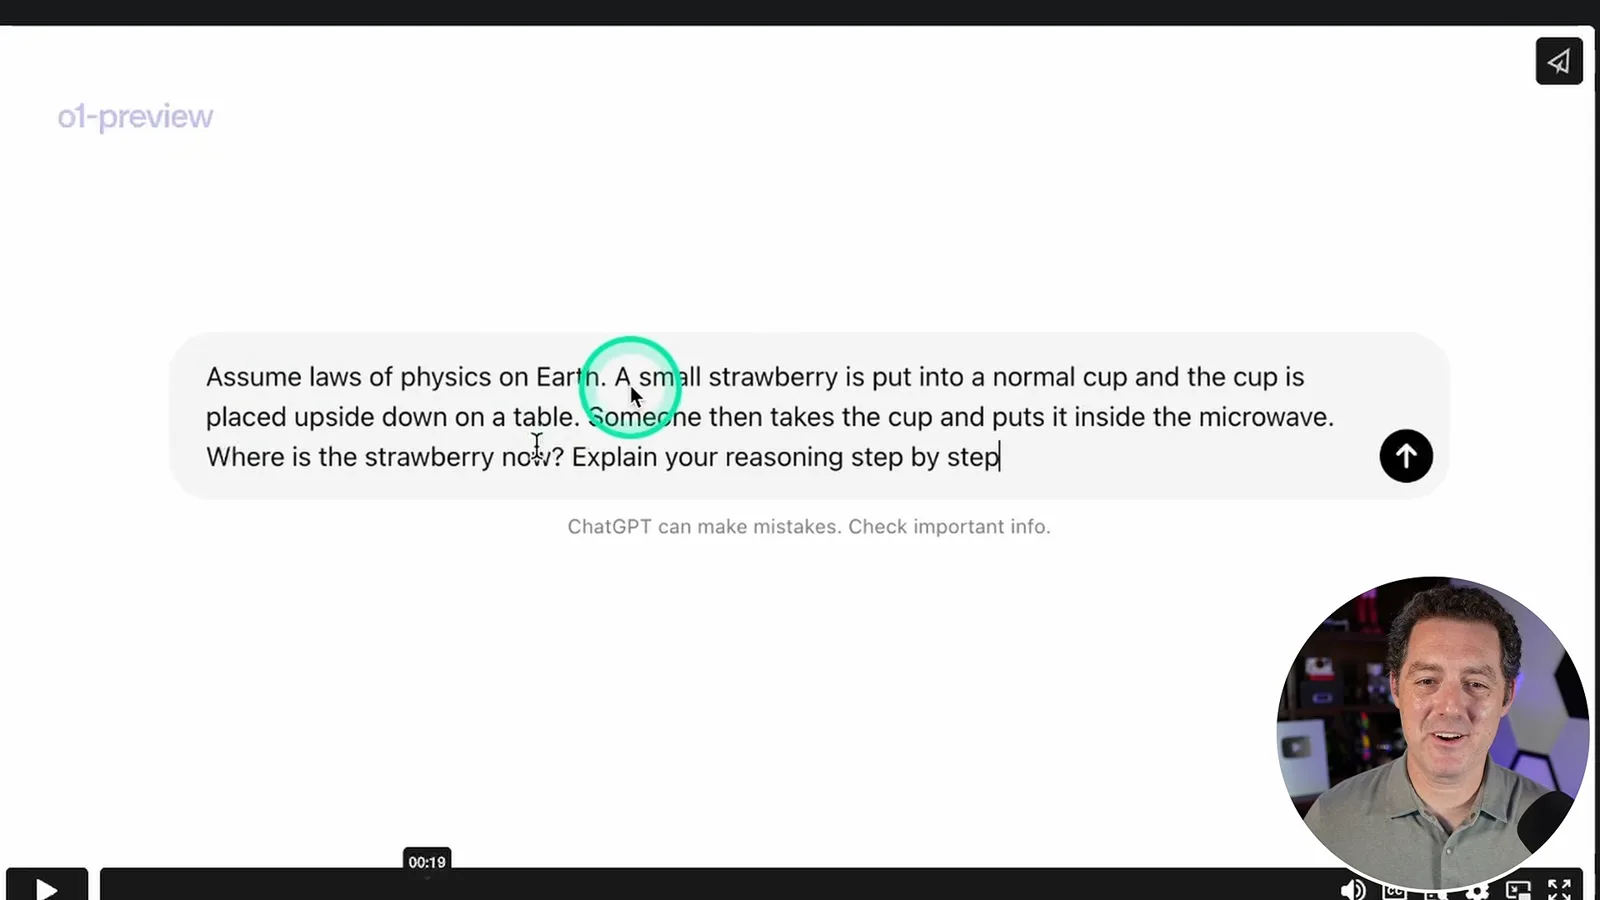
2024 年 9 月,Matthew Berman 用自己非正式的语言模型评分题目测试 OpenAI 刚发布的 o1-preview。他注意到 OpenAI 发布示例中有一个倒置杯子下的草莓问题,与他自己的弹珠问题非常相似。他猜测该公司可能看过他的视频,但没有证明这一联系。
Berman 在 ChatGPT 中选择 o1-preview,首先要求用 Python 编写俄罗斯方块。他指出,可见的思考文字是摘要,并非模型原始的内部推理。这次运行大约 35 秒后开始输出;他说此前一次运行更久,最初生成的代码还需要修正。
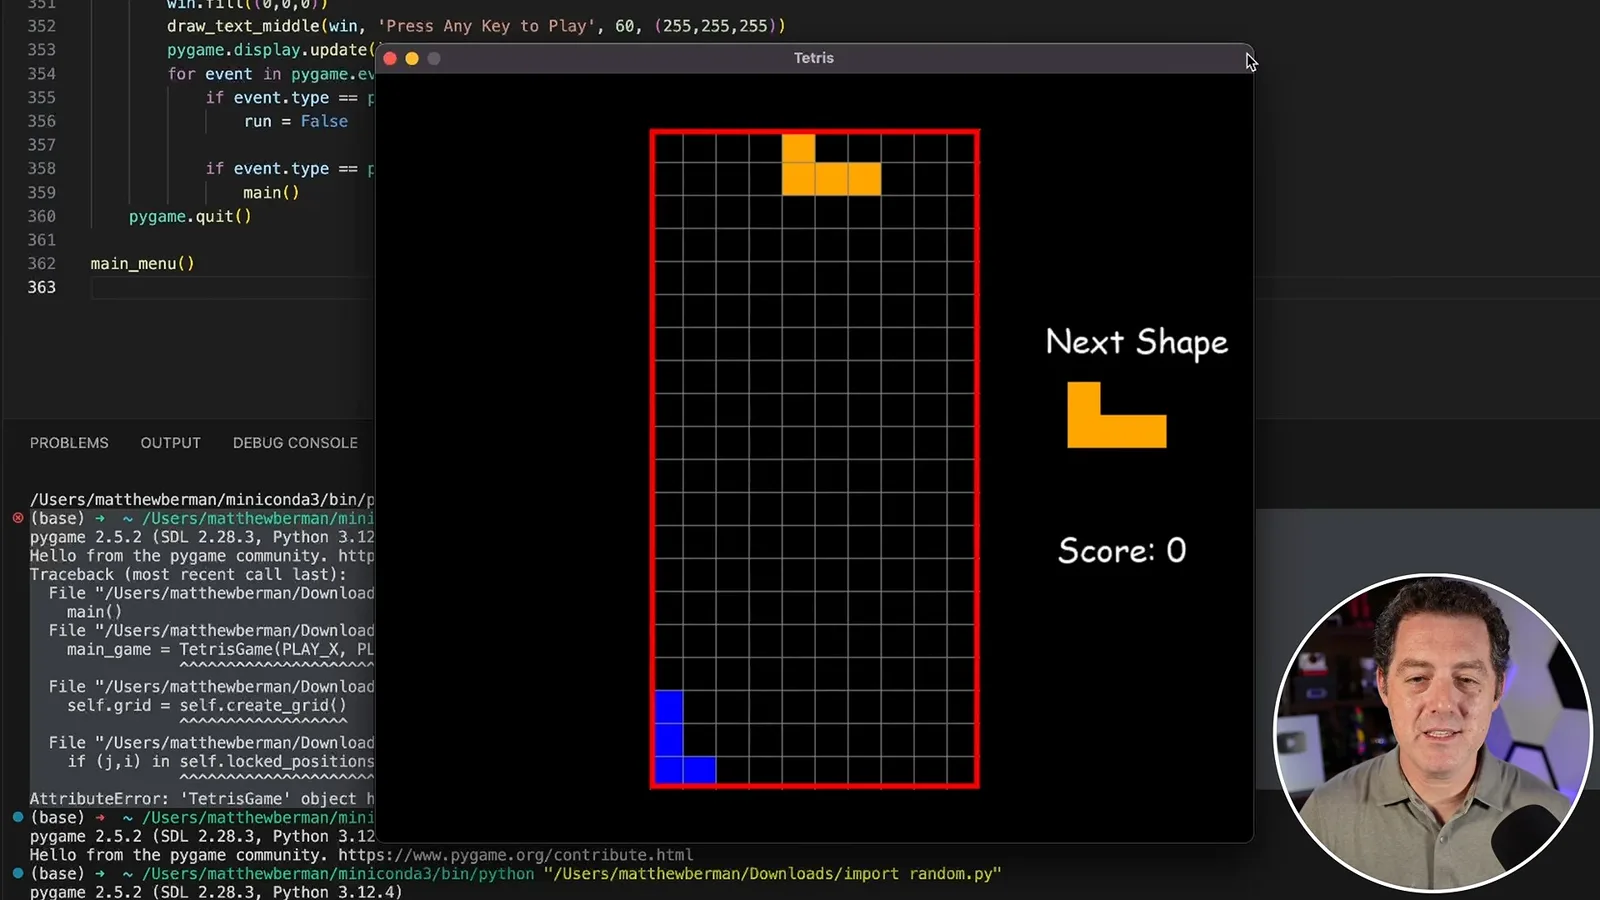
新的俄罗斯方块程序首次运行就成功,显示下一块和分数,在短暂演示中看起来可以玩。Berman 认为它通过测试,表现优于此前一次。但短暂试玩不能证明所有游戏机制都正确。
尺寸、词数与谜题
模型检查信封、统计自己的词数,并考虑杀手与倒置杯子情景。Berman 对每个输出评分。
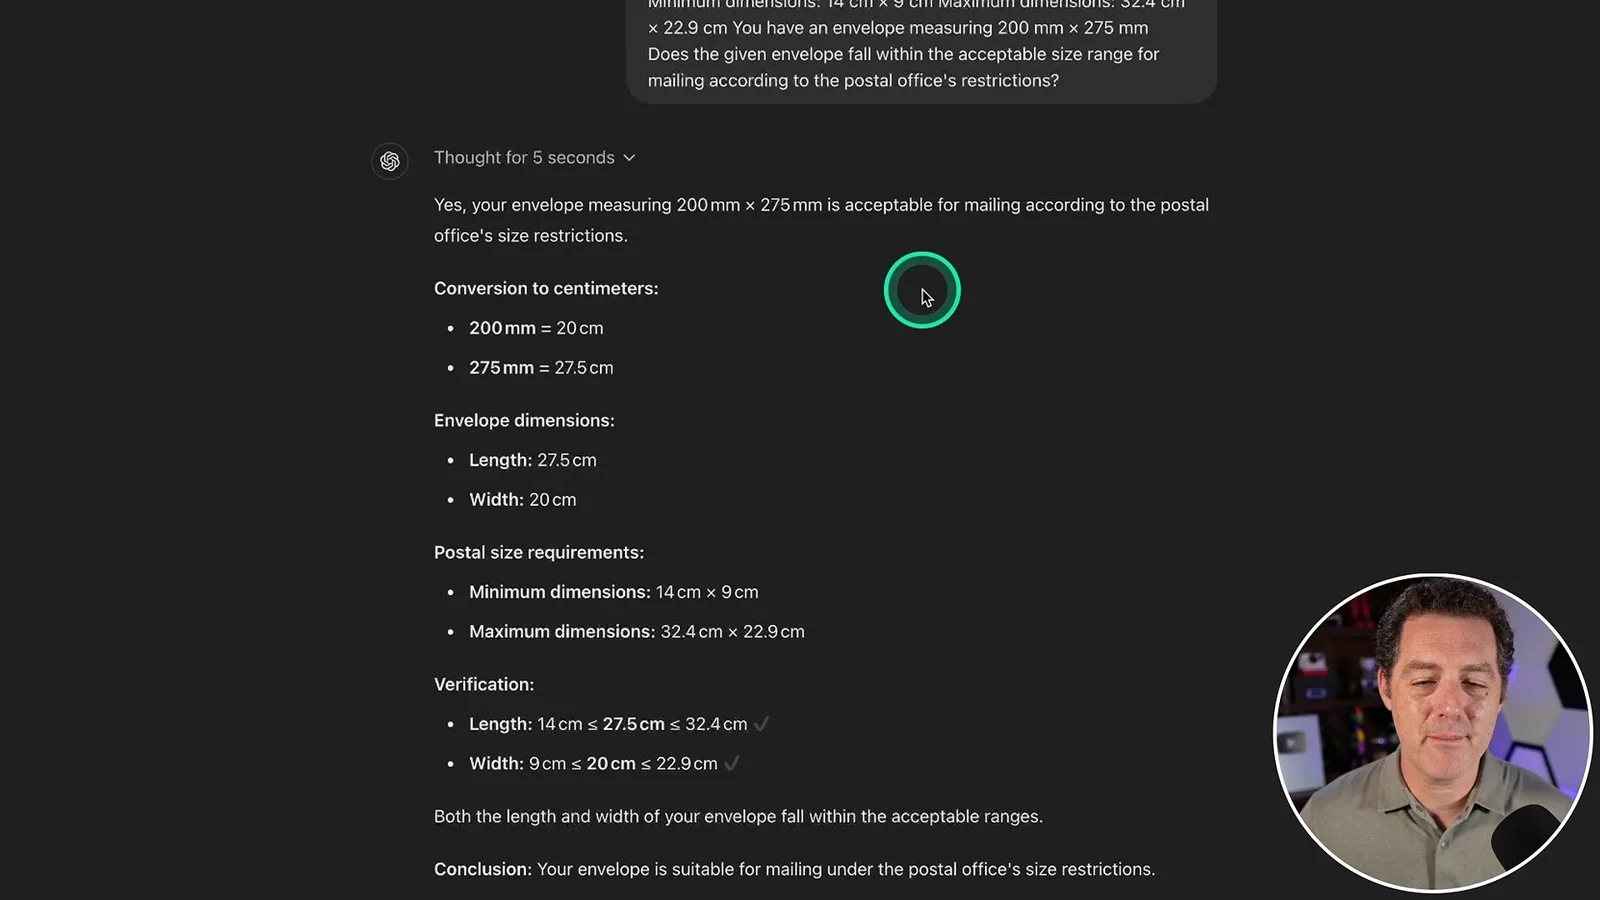
接着他询问一个 200 × 275 毫米的信封是否符合指定的邮寄尺寸限制。模型换算单位,将 27.5 厘米和 20 厘米与给出的最小、最大尺寸比较,并回答可以。Berman 称赞它考虑了方向;这一结果只适用于提示中的限制,并非当前邮政规则。
当被问及回答中有多少个单词时,模型返回“This response contains five words”,Berman 数出五个。他还提到此前一次也回答正确,并将其理解为推理能力的证据,但仅凭两个例子无法确定它能多稳定地成功。
在三个杀手的谜题中,一名新来者杀死其中一人,没有人离开。模型数出三名活着的杀手:原先存活的两人和新来者。它还指出,如果把死者也算作杀手,解释会有所不同;Berman 赞赏这一细节。
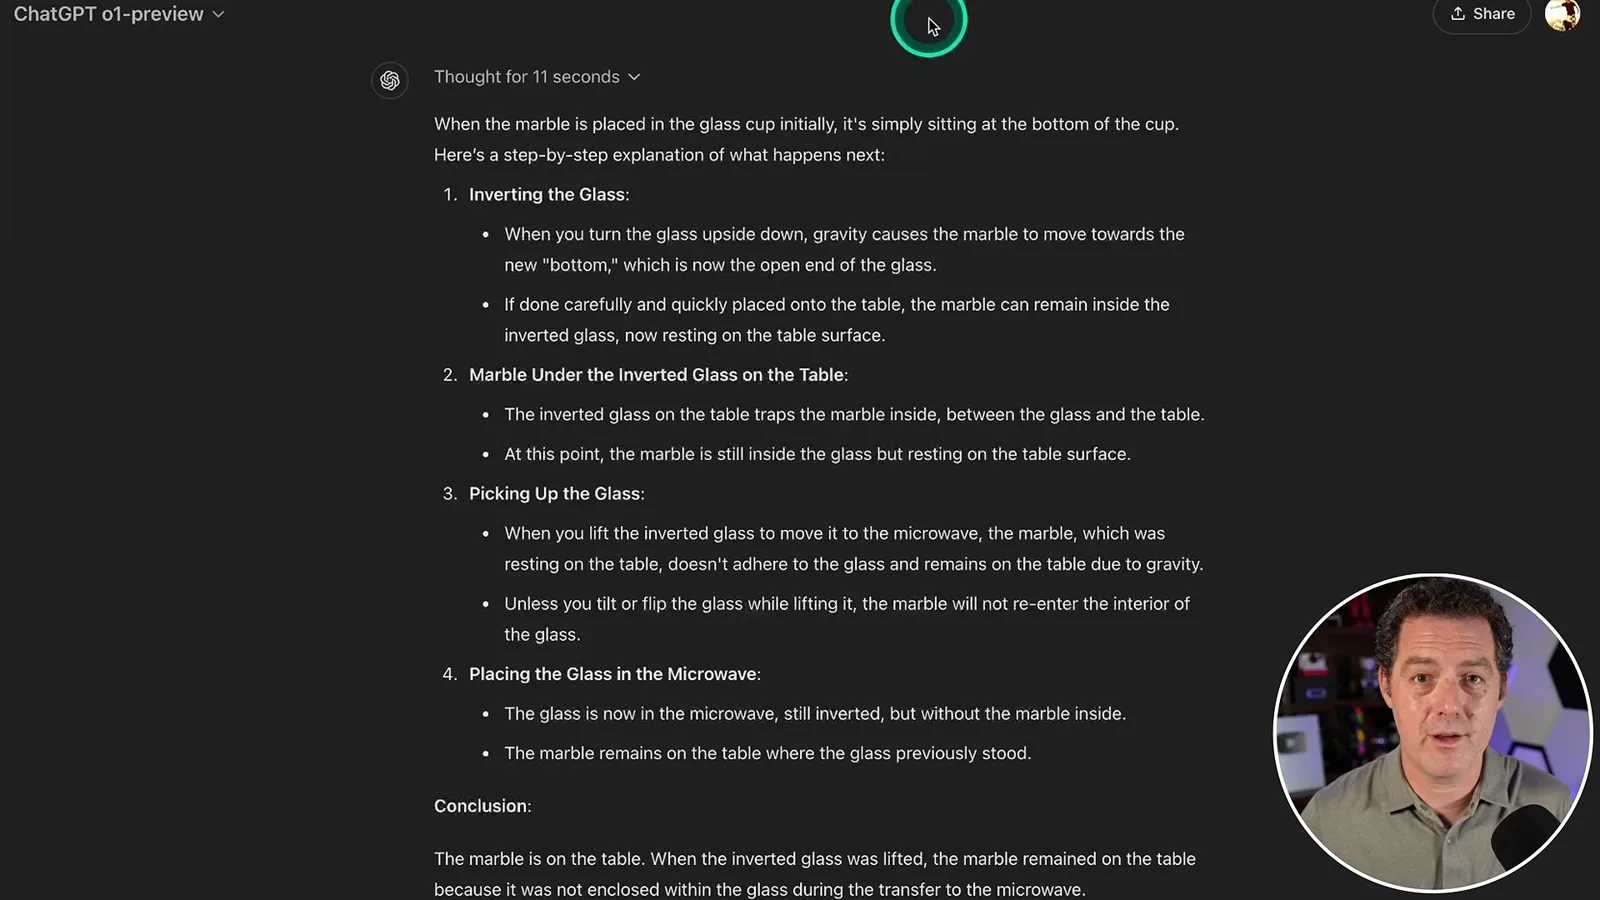
弹珠问题将弹珠放进杯子,把杯子倒扣在桌上,再将杯子移到微波炉中。模型认识到,如果小心放置,弹珠可能留在倒置杯子下面;如果只提起杯子,弹珠就会留在桌上。Berman 称赞它明确了假设,而不是把每个物理步骤都视为毫无歧义。
北极题错误与更多测试
模型混淆了原始起点和后来的位置。Berman 随后尝试拼写、小数、伦理假设和数学提示。
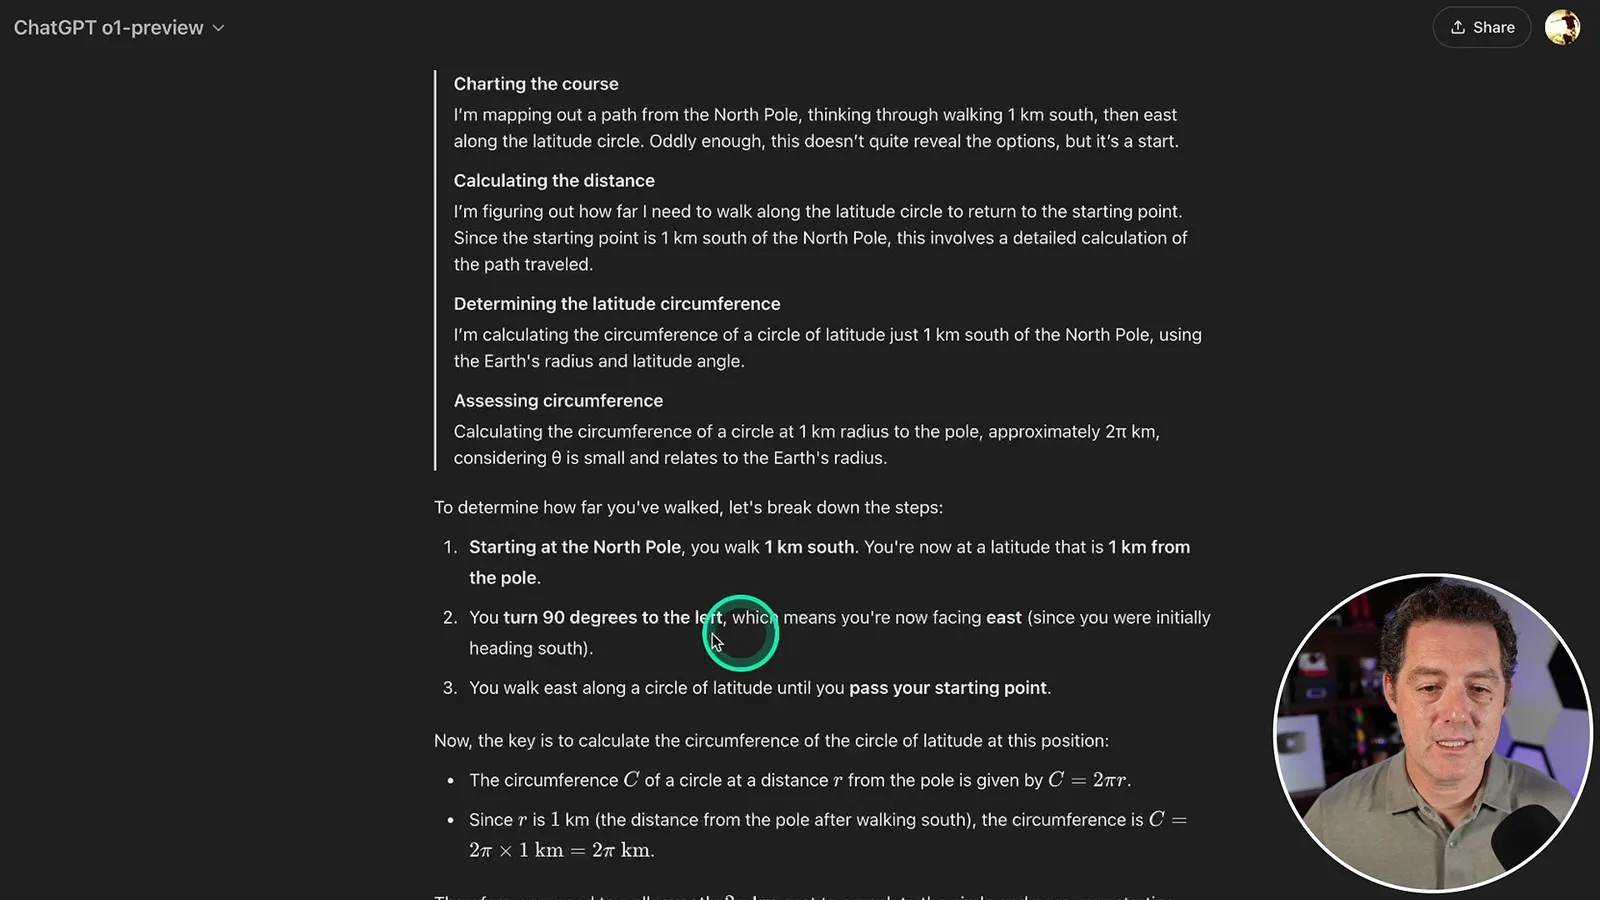
一道北极题要求从北极走一公里,左转 90 度,然后走到经过原始起点。模型假设沿纬线向东行走并计算约 2π 公里,但混淆了北极和向南一公里处的点。Berman 判定答案错误:绕该纬线一圈回到的是转弯点,而不是最初的北极。
模型给出十个以“apple”结尾的句子,数出“strawberry”中有三个字母 r,并判断 9.9 大于 9.11。Berman 将展示的这些运行判为通过,没有声称做过正式的重复评估。
在一个关于轻推某人以防人类灭绝的伦理假设中,模型起初讨论不同的伦理框架。当被要求明确回答是或否时,它回答“是”。Berman 赞同这一判断,但这个测试涉及对假设情景的看法,并非可以客观评分的数学问题。
Berman 尝试了一个推荐的高等数学提示。模型约 52 秒后给出格式化推导和 721 的答案;他说自己无法轻易解出这道题,因此视频没有独立验证结果。
被问及先有鸡还是先有蛋时,模型回答从进化历史看蛋先于鸡存在。Berman 认为 o1-preview 是自己测试过的最强模型,并指出它答错了北极题。这一结论反映的是少量提示和 2024 年 9 月的预览版本,而非当前排名或整体可靠性的证明。
同频道的其他文章
 14:45EN → 简体中文
 Matthew Berman· 2026年10月29日Matthew Berman 解读 Google 的 Gemini 4 Carbon 公告Matthew Berman · Forward FutureMatthew Berman 回顾 Google 公布的 Gemini 4 Carbon 基准结果、分阶段开放计划与定价,同时指出自己尚未使用该模型。
 34:21EN → 简体中文Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。