30 秒看懂
Matthew Berman 借助魔方模拟器、汉诺塔、乐高搭建工具和太阳系可视化程序,探索 Z.ai 的 GLM-4.5,随后查看模型开发方的基准测试图表。一些演示需要后续修复,魔方则通过反转记录的打乱步骤来复原。 他介绍了模型的混合专家规模和思考模式,认为开放模型正逐渐具备与专有模型竞争的能力。这些演示仅供参考,比较分数来自 Z.ai 选择的测试,并非独立的普遍排名。
- 1魔方模拟交互式魔方可以打乱并以动画恢复;画面显示程序通过反转记录的打乱步骤实现复原。
- 2太阳系一次后续提示修复了最初的加载问题,Berman 随后可以探索行星并调整可视化设置。
- 3两种模型规模Z.ai 称 GLM-4.5 有 3550 亿总参数、320 亿活跃参数;Air 有 1060 亿总参数、120 亿活跃参数。
- 4厂商基准图表Z.ai 报告 GLM-4.5 和 Air 在所选基准集中的综合分数分别为 63.2 和 59.8。
- 5十盘汉诺塔生成的程序通过递归解法演示 1023 步;模型展示的推理将步骤分组。
要点建议
- GLM-4.5 和 GLM-4.5-Air 的总参数分别为 3550 亿和 1060 亿,每个 token 只激活其中一部分。
- Z.ai 提供思考和非思考模式,但 Berman 在短暂测试中未能触发非思考模式。
- 魔方动画反转记录的打乱步骤,因此不能证明系统能解决任意未知魔方状态。
- 太阳系演示需要后续修复,乐高模拟则出现了对齐和放置错误。
- Z.ai 的图表显示模型在所选基准中具有竞争力,但不能据此确定普遍排名。
- 十盘汉诺塔动画展示的是代码实现的递归解法,而非逐步手工列出的推理过程。
按章节阅读整理后的全文
魔方模拟器
Berman 测试交互式魔方并要求更充分地打乱。画面显示程序通过反转记录的打乱步骤实现复原。
2025 年 7 月,Matthew Berman 通过编程演示和 Z.ai 自己的基准图表,考察其开放权重模型 GLM-4.5。他认为几个中国开放模型正在接近领先的专有系统,但这些示例和报告分数只是特定任务的快照,不能证明它们在所有方面都更强。
第一个演示是 3D 魔方模拟器。Berman 说,他经过几次后续交流才修复一个小问题;最终界面可以旋转各层、打乱魔方并显示操作记录。一个标准魔方看起来恢复了原状,随后 5×5 魔方也完成了复原。
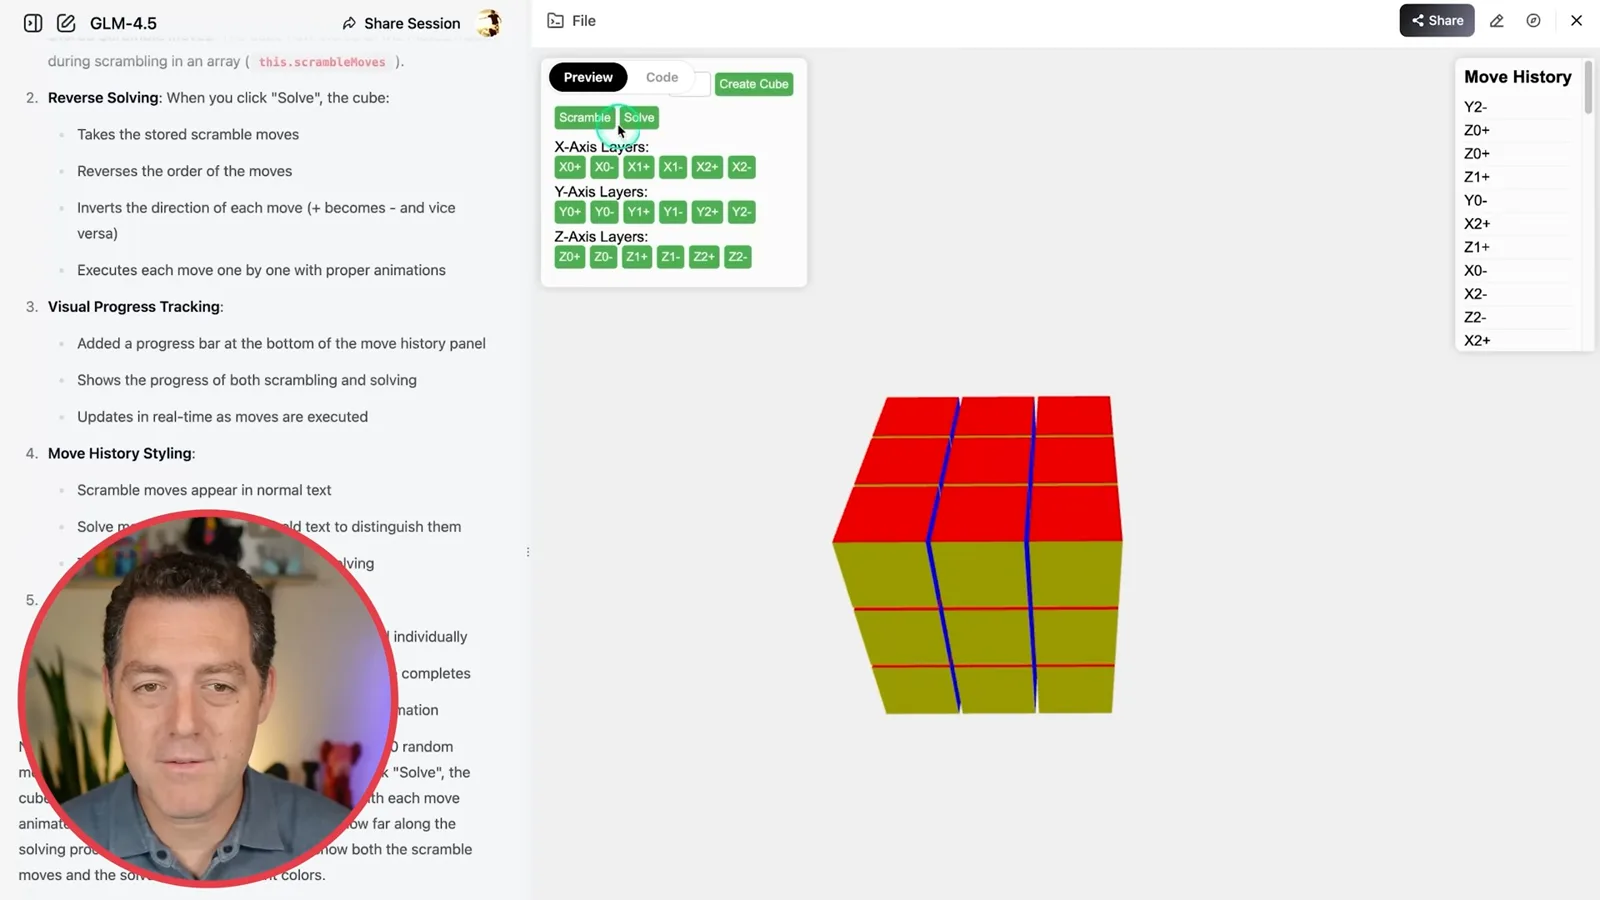
他还尝试了 10×10 魔方,但发现最初的打乱程度较低,于是让模型增加打乱步数控制。屏幕上的说明指出,求解是将保存的打乱顺序倒过来,并反转每一步的方向。因此,这展示的是基于撤销的模拟器,而非能独立求解任意魔方状态的程序。
汉诺塔、乐高与太阳系
模型创建了谜题可视化、积木搭建工具和可调节的太阳系。一些示例需要后续修复或出现放置错误。
接下来是四盘汉诺塔。Berman 要求模型先在推理中解决这个递归谜题,再创建可视化;他说展示的推理列出了 15 步。生成的可视化随后以动画演示解法。这个单一的小规模例子不能解决模型在不同谜题规模或条件下表现如何的更广泛问题。
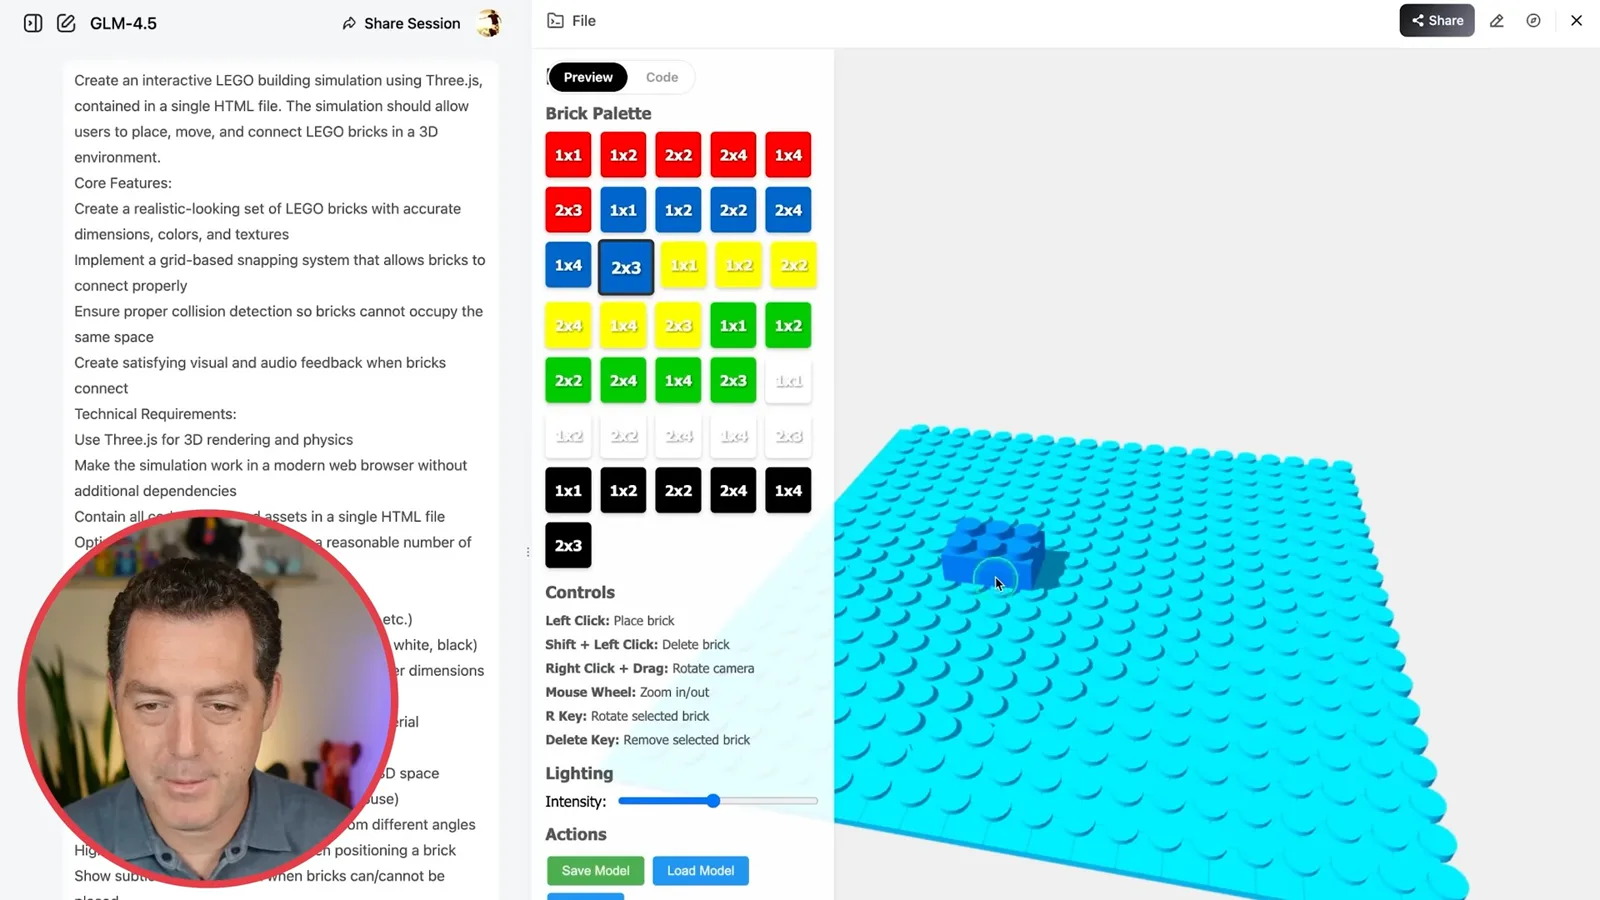
Berman 要求制作速度更快的十盘版本,然后转向用 Three.js 编写、包含在单个 HTML 文件中的交互式乐高搭建工具。他可以选择彩色积木并堆叠,但第一块没有完全对齐底板,另一次放置也出现错误。他认为结果很有潜力,但并不完美。
他最喜欢的演示是带有行星信息和可调设置的 3D 太阳系。第一次尝试一直卡在加载页面;他告诉模型这个问题后,模型修改代码,可视化程序便运行起来。Berman 使用的是 Z.ai 聊天界面的画布模式,而非本地开发环境。
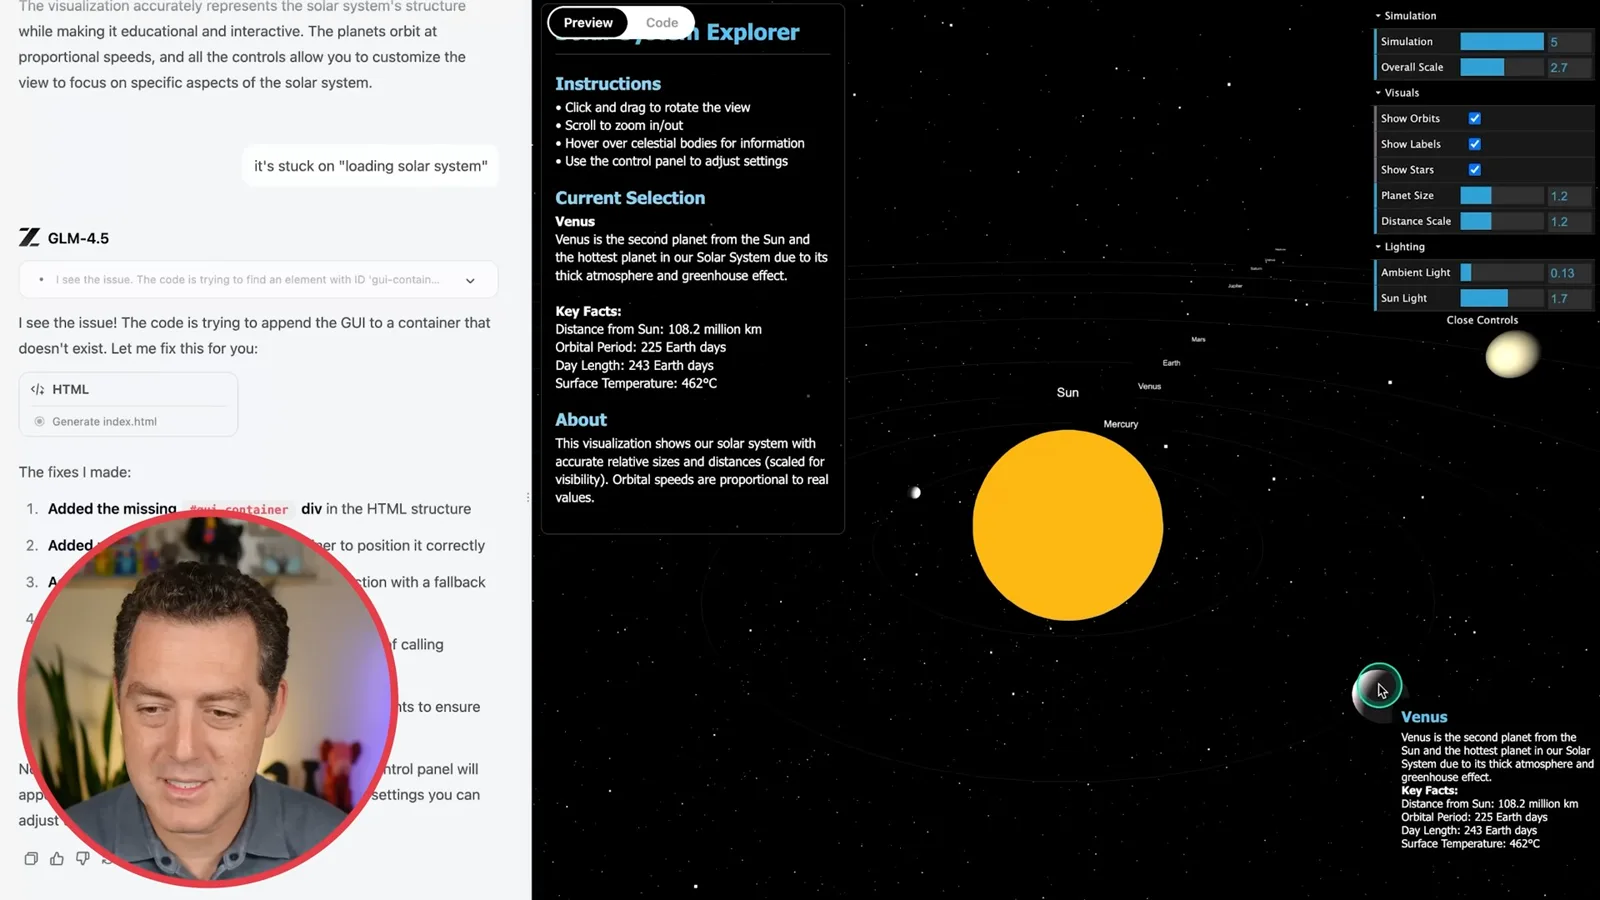
将鼠标悬停在金星上,可以看到它与太阳的距离、轨道周期等信息。Berman 调整了模拟速度、轨道、标签、星星、行星大小、距离比例和光照。演示展示了交互功能,但视频没有独立核实每个天文数值。
架构与报告的基准测试
Berman 介绍模型规模、思考模式及 Z.ai 的基准比较。结果由公司报告,取决于所选的评估项目。
Berman 接着介绍模型发布情况。GLM-4.5 有 3550 亿总参数,每个 token 激活 320 亿;较小的 GLM-4.5-Air 有 1060 亿总参数、120 亿活跃参数。根据 Z.ai 模型卡,两者都采用混合专家架构,权重以 MIT 许可证发布。
Z.ai 将两者描述为混合模型:思考模式用于复杂推理和工具使用,非思考模式用于即时回答。在 Berman 的快速测试中,即使询问加州首府或要求讲一个简单故事,也触发了可见的思考过程;他说自己没能启用非思考行为。
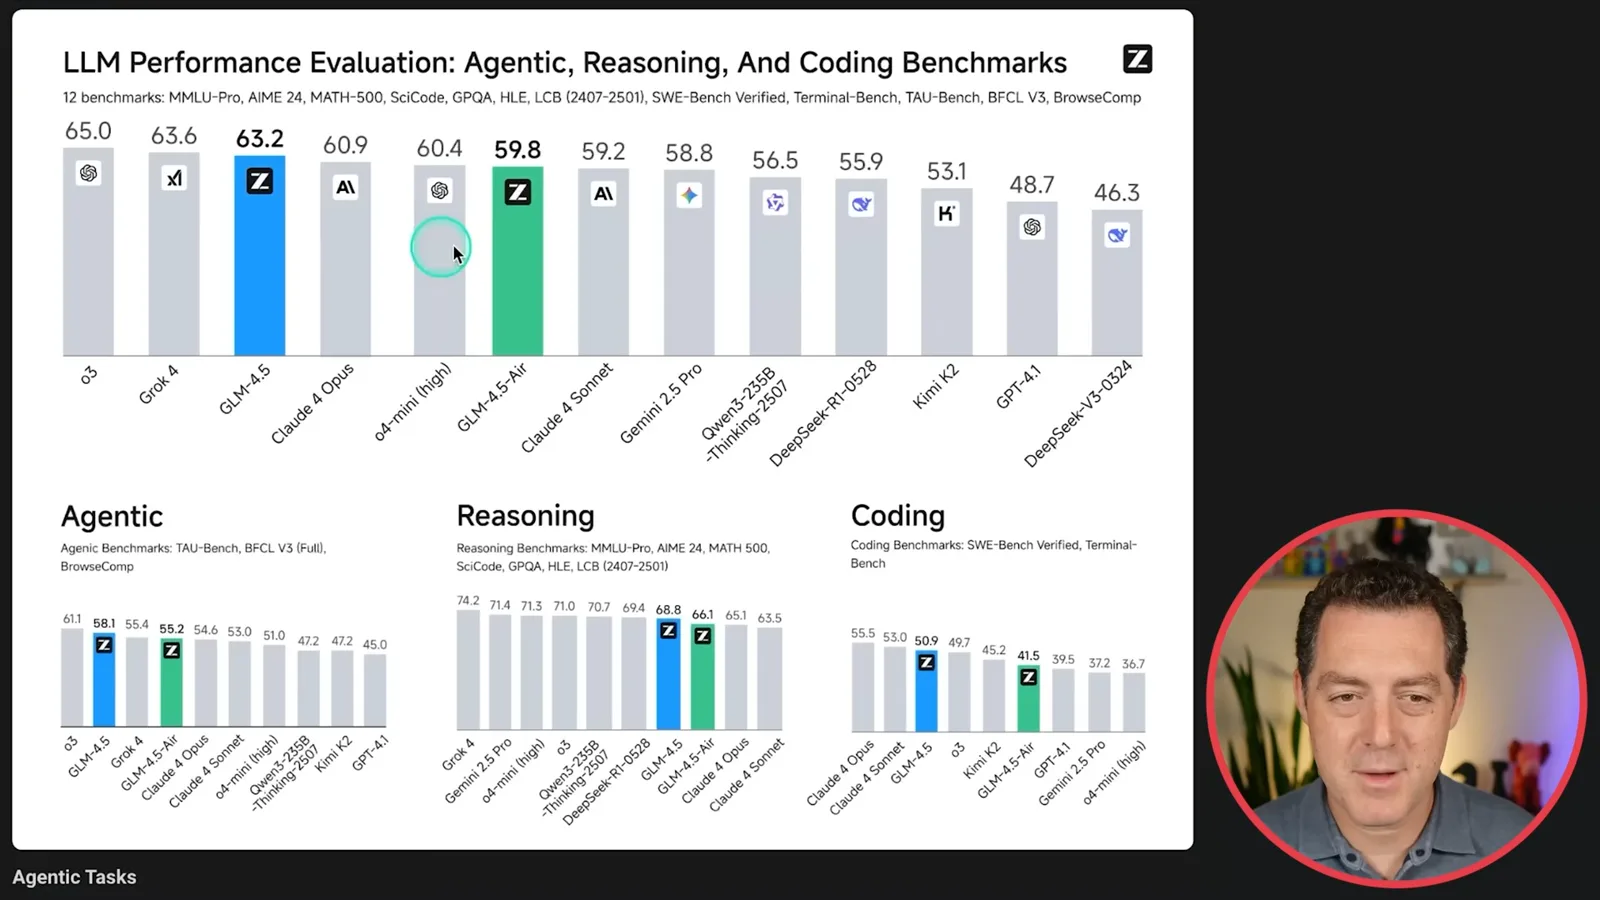
Berman 展示了 Z.ai 汇总 12 项基准的图表。公司报告 GLM-4.5 得分为 63.2,Air 为 59.8;同一图表中 OpenAI o3 为 65.0,Grok 4 为 63.6。这些是厂商在所选评估条件下报告的比较结果,并非当前或普遍适用的排名。
图表还将任务分为智能体、推理和编程。Berman 指出,GLM-4.5 的智能体结果表现强劲,推理排名低于几个竞争模型,编程结果则排在图中两个 Claude 4 模型之后。解读这些比较时,具体基准、测试设置和辅助框架都很重要。
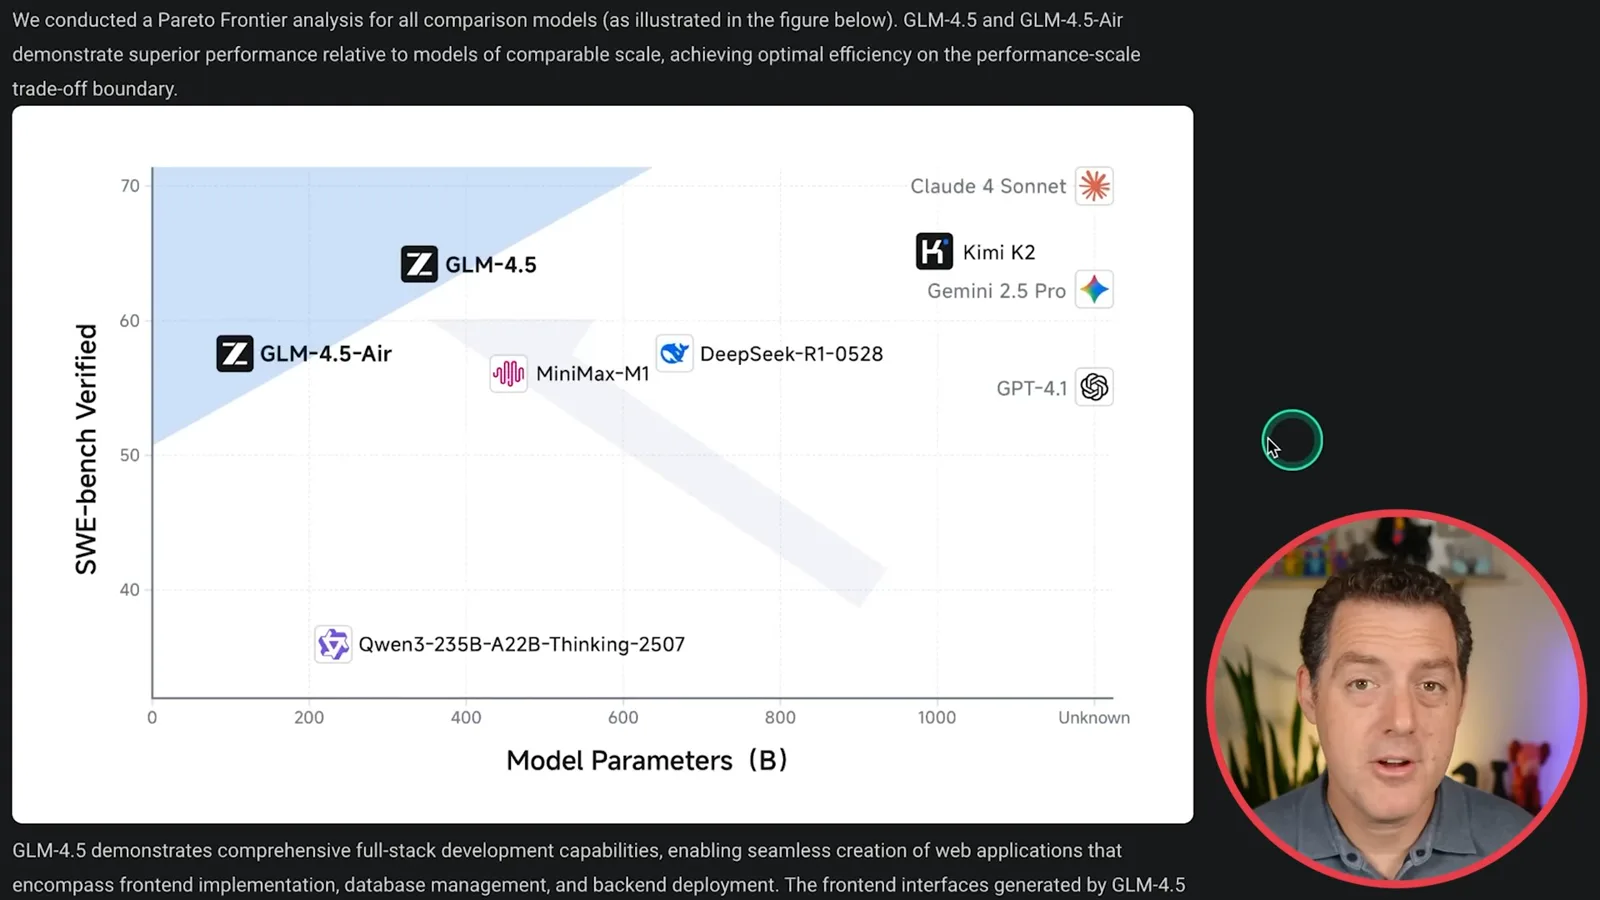
第二张厂商图表以总参数量为横轴,展示 SWE-bench Verified 表现。Berman 注意到 GLM-4.5 在图中的分数接近 Kimi K2,而总规模较小;Claude 4 Sonnet 的位置更高,但参数量未知。他提到 Z.ai 使用强化学习进行后训练,以提升智能体能力。
更多演示与十盘谜题
Berman 回到魔方,浏览厂商示例并展示十盘汉诺塔解法。他最后评估了 2025 年的模型格局。
回到魔方演示,Berman 使用新加的控制项,要求 10×10 魔方打乱 50 步,然后运行求解动画。他没有独立清点步数。画面中的实现说明显示,程序会反转已记录的打乱步骤,因此这一结果能证明的能力有限。
他随后浏览模型开发方提供的示例:用空格键操作的 Flappy Bird 风格游戏、3D 迷宫、可移动的待办看板、大语言模型发展史 SVG、嵌套旋转的六边形,以及 Pokédex 界面。这些是挑选出来的演示,并非对可靠性的系统测试。
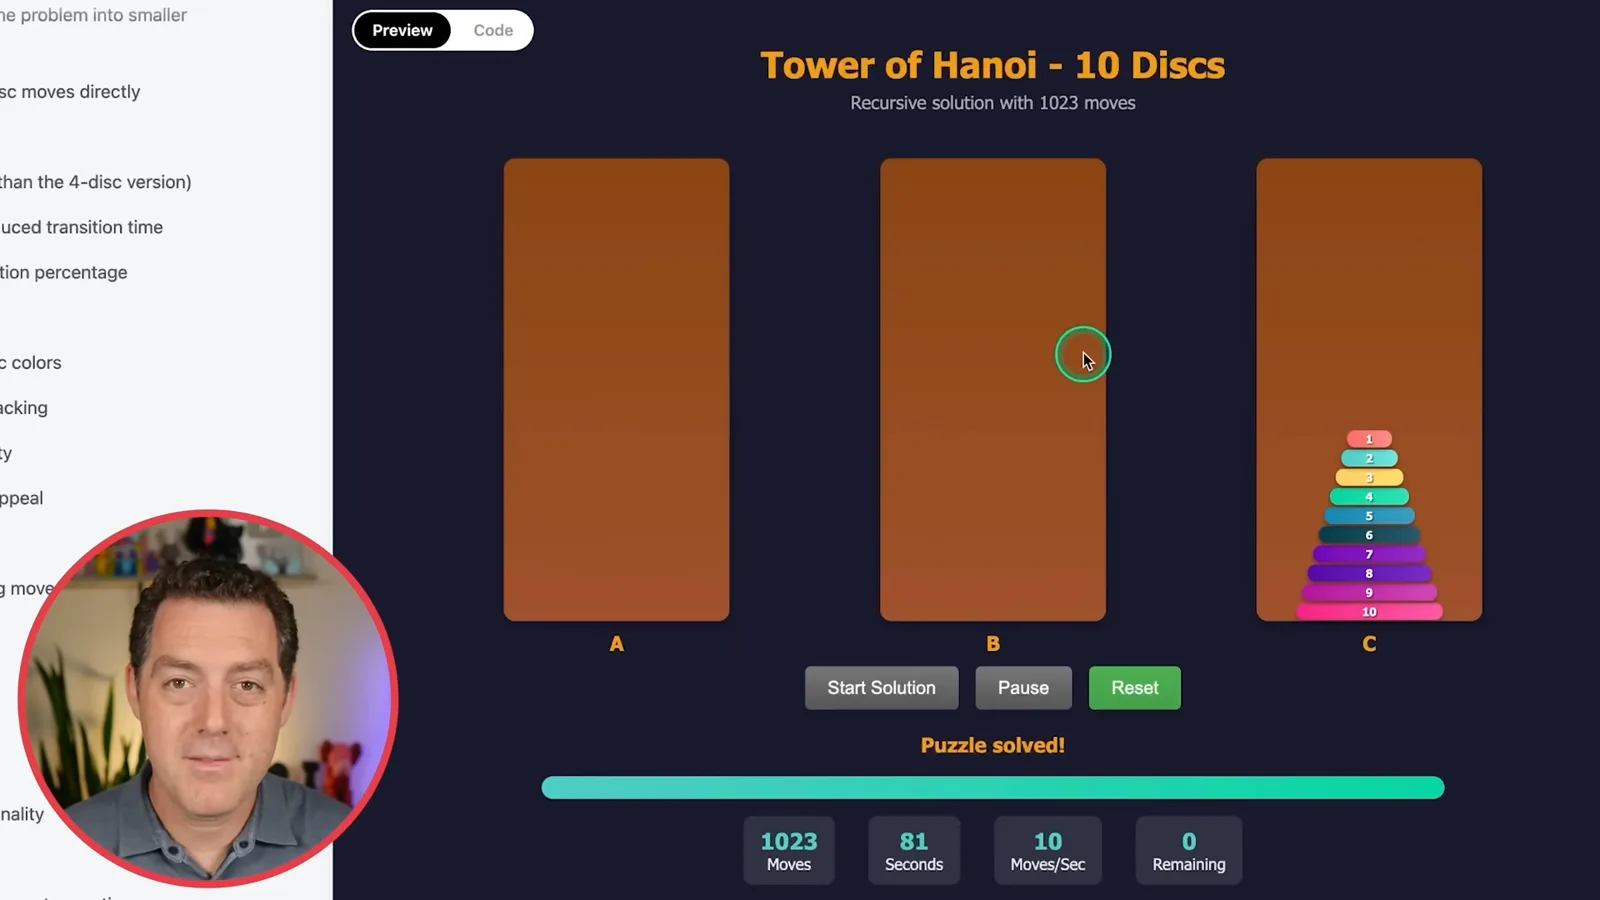
最后,十盘汉诺塔示例展示了递归算法和分组步骤,而非在显示的推理中列出每一步。动画结束时显示共 1023 步;界面还显示 81 秒和每秒 10 步的速度设置。Berman 对结果表示赞赏,但代码生成的动画不能证明模型手工推理了全部 1023 步。
Berman 认为,在他查看的示例和基准测试中,开放模型实际上已经追上闭源模型,同时猜测当时尚未发布的 GPT-5 可能改变这一比较。他的判断反映的是 2025 年 7 月的市场格局和当时可得的证据。
同频道的其他文章
 14:45EN → 简体中文
 Matthew Berman· 2026年10月29日Matthew Berman 解读 Google 的 Gemini 4 Carbon 公告Matthew Berman · Forward FutureMatthew Berman 回顾 Google 公布的 Gemini 4 Carbon 基准结果、分阶段开放计划与定价,同时指出自己尚未使用该模型。
 34:21EN → 简体中文Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。