30 秒看懂
没有一个模型在所有任务上都领先。AI Explained 认为,训练数据的差异让模型在法律、编程、科学和视觉推理等领域表现不一。他还提醒,各实验室关于 AI 加速研究的数字衡量的不是同一件事,不能直接比较。他说,随着模型在网络内部完成更多推理,监督其文字步骤变得不那么可靠;他质疑领先实验室是否给予独立评估者足够的权限来确认安全。
- 1最佳模型取决于测试领域主持人比较了文档分析、编程、法律和驾驶的排名,认为各领域可用的数据有助于解释差距。
- 2研究基准对智能体可靠工作时长得出不同结果他比较了一张任务时长图与 OpenAI 的报告;报告显示不同研究任务的可靠性不同,而任务和指标也不相同。
- 3研究员生产力与整个实验室的加速是不同指标主持人比较 Anthropic、METR 和 OpenAI 的估计,提醒调查与历史基准趋势采用了不同基线。
- 4访问权限和利益关系限制独立评估他质疑已公布的嵌入式评估安排是否给予监督者足够的权限和独立性,以审查实验室的做法。
- 5隐藏推理可能削弱一种安全工具他介绍的研究表明,模型在产生可见推理前可以在网络内部完成更多工作,使文字思维链更难用于监督。
- 6公开研究资源分配图让外界能够审视主持人从一张图估算 OpenAI 安全与对齐研究占研究员时间的比例,同时指出 Anthropic 没有可比较的数据。
- 7研究人员称模型发布背后的主要想法由人提出他引用 OpenAI 的一项调查:研究人员表示关键想法来自自己,其中一人说 AI 提出的修改让一个想法发挥了作用。
要点建议
- 用自己的任务测试多个模型家族,不要只凭综合排行榜选择。
- 比较 AI 研究加速估计时,先看基线和衡量对象:个人生产力与基准进展并不相同。
- 如果更多计算发生在内部,或可见步骤不能如实反映行动,文字推理对监督的价值就可能下降。
- 主持人认为,独立评估需要真正有意义的访问权限,实验室宣布合作本身并不够。
- 主持人将当前研究自动化基准视为间接指标,而非 AI 能完全自主研究的证明。
按章节阅读整理后的全文
为什么单一模型排名掩盖领域差异
主持人比较文档、编程和专业测试,认为训练数据会造成不均衡的优势。他建议用实际任务测试模型。
OpenAI 和 Google 的新模型都在争夺关注,但我认为更重要的问题是 AI 研究本身进步有多快,以及安全实践能否跟上。我读过 GPT-6.2 Astra 系统卡并测试了模型;最佳选择仍取决于你需要它完成什么。
模型在不同领域的表现并不均衡。在涉及长 PDF 的专家任务基准中,我展示的比较里 Gemini 4 Neon 得分最高;在 FrontierCode 2.0 上,Claude Fable 5.2 领先,但顶尖模型的分数都集中在 40 多分。一个综合指数略微偏向 Fable,另一个则让 GPT-6.2 Astra 领先。
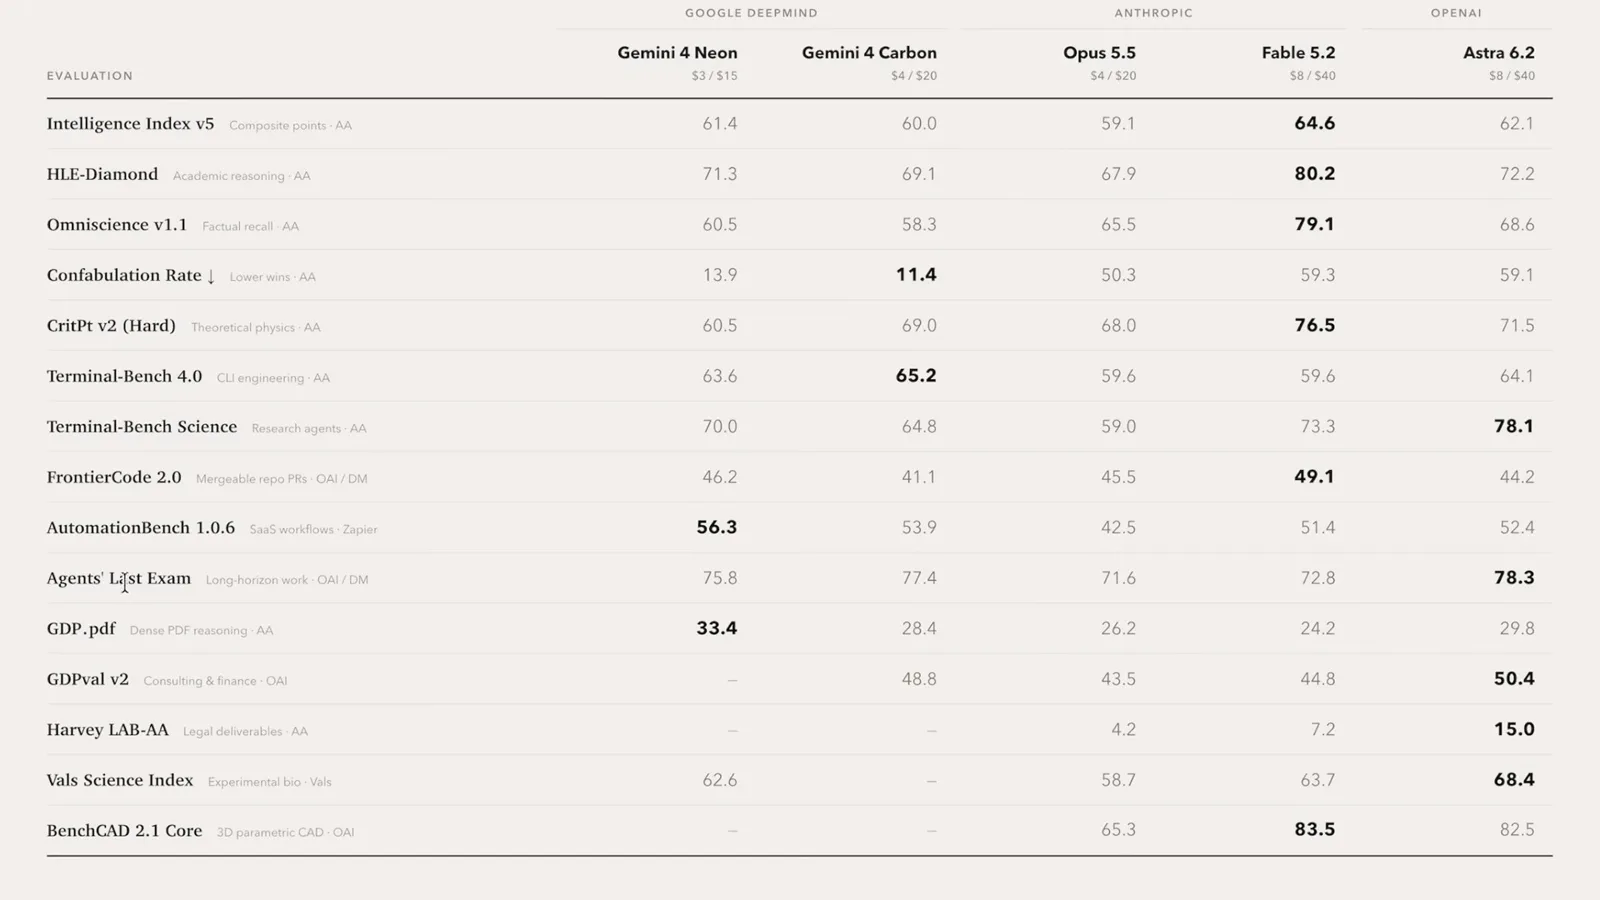
这一表面矛盾有原因。开发者获得更好的特定任务训练数据时,模型在该领域的表现可能大幅提高。因此,用自己的任务测试主要模型家族,比寻找一个普遍的赢家更有价值。
OpenAI 介绍了一款即将推出的网络安全模型,在 ExploitGym 上取得 77% 的分数。根据早期模型外推,预测该测试何时达到饱和的结果截然不同;专门模型可能迅速改变这一局面。它也许只会向可信测试者开放。
我怀疑训练数据是造成差异的关键。在一项对研究较少的蛋白质序列的比较中,Fable 明显优于 Astra;有时让模型推理更久反而会降低分数。这看起来不像一个通用智力数字的差别,更像模型学到的内容不同。
法律工作和驾驶也有同样的问题:差异源于一般推理能力,还是某家公司掌握了更多法律、视觉和空间数据?Google 的信息资源或许能解释 Gemini 的部分优势,但这些比较不能单独确定原因。
我自己的 SimpleBench 包含空间谜题,不过它测试的不只是空间推理。Fable 的综合分数最高,Gemini 4 Neon 也表现不错。在另一个名为 IntegrityBench 的私人基准中,我发现 Gemini 4 模型对自己答案的信心明显高于 Claude,Astra 介于两者之间。
如果比较基线改变,产品的视觉演示可能误导人。OpenAI 展示了新旧模型制作 3D 内容的对比,但 Teknium 找到的一段更早的 GPT-6 Astra 演示,看起来比比较中采用的旧示例更出色。
我自己的体验只是个例:Gemini 4 Carbon 在规划乡村步行路线、查看卫星图像和研究当地历史方面优于 Astra。我的 Gemini 订阅也更便宜。但这些例子不能替代对别人工作任务的评估。
任务时长图与真实任务之间的差距
智能体的可靠性取决于任务和基准设计。综合趋势可能掩盖单项能力的急剧变化。
一张广为传播的任务时长图,用人类完成任务所需的时间来衡量模型在特定可靠性下能完成什么。它显示模型在 80% 可靠性下约达到 38 小时。OpenAI 一份使用近期编程和机器学习研究任务的报告,却显示 80% 的阈值不到 15 分钟。
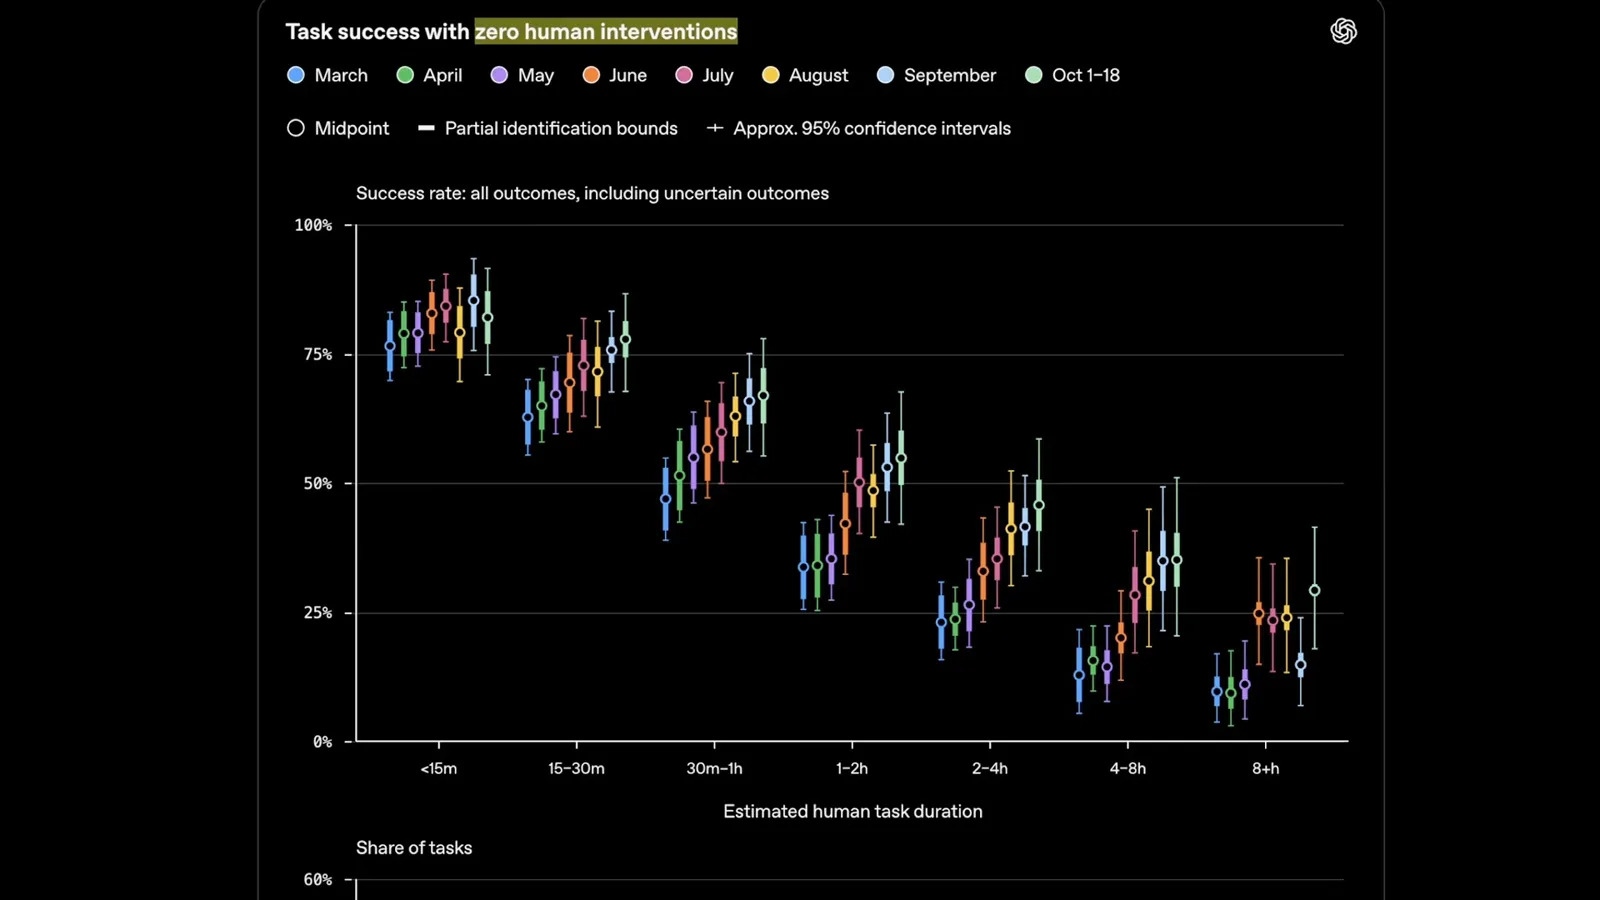
这个明显差异又说明要看具体任务。报告中,自主代码审查的成功率约为 70%,而为推理和服务系统编写代码的成功率更接近 25%。复杂度以及一个错误造成的影响也很重要;模型不能用单一分数概括。
综合基准仍能显示进步,但影响最大的变化可能发生在平滑曲线没有显现的阈值上。OpenAI 公开和内部基准的图表没有显示,数学突破或发现大量软件漏洞的能力是从哪一点突然变得可能的。
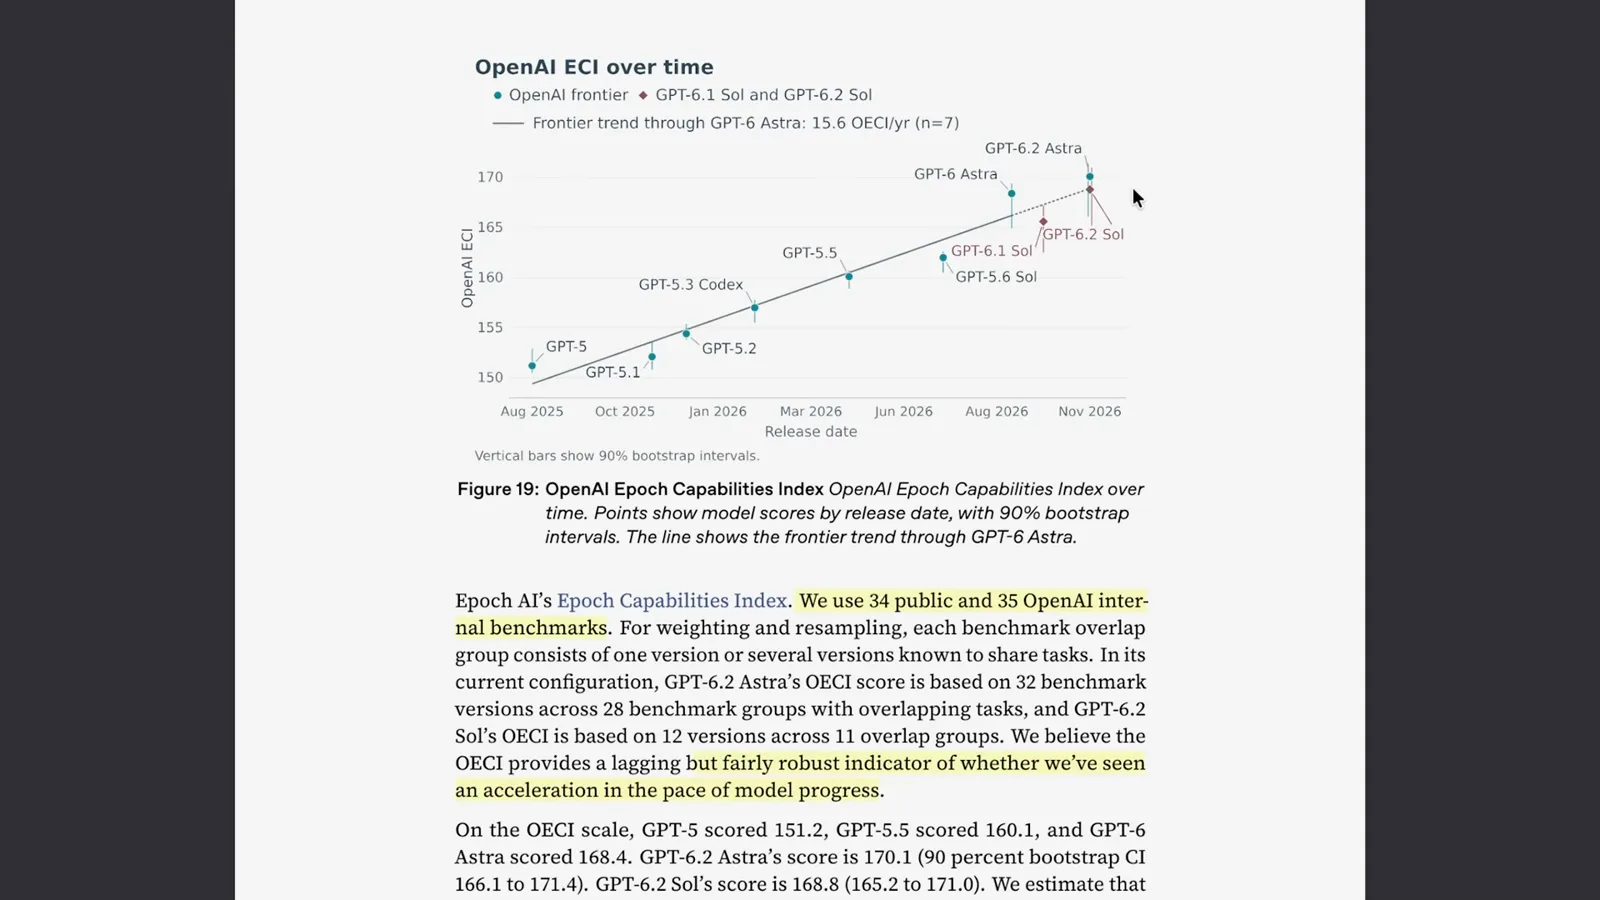
OpenAI 和 Anthropic 的图都显示,在研究人员大约于 2025 年 8 月至 10 月开始用 AI 自动化编程之后,进步速度变得更快。这些综合图不能解释每一次模型发布,也不能提前告诉我们下一个领域阈值在哪里。
一则关于 Greg Brockman 内部讲话的报道把网络安全描述为 OpenAI 有用的防御工作,也是一项商业机会。我担心其中的激励:如果更强的攻击能力发现更多漏洞,让机构更依赖实验室提供防御,实验室是否会因此面临进一步加速的压力?
AI 研究员的工作加速了多少?
调查与基准趋势采用不同的基线和结果,因此估计值不同。主持人讨论研究自动化和算力效率方面的证据。
AI 正在加快研究,但各种估计不能直接互换。Anthropic 所说的阈值是由 AI 带来的历史进步速度翻倍,即一年完成两年的进展。OpenAI 询问研究员同等价值的工作时,他们表示相比只使用 ChatGPT,编程智能体让他们一个月能完成三个月的工作。
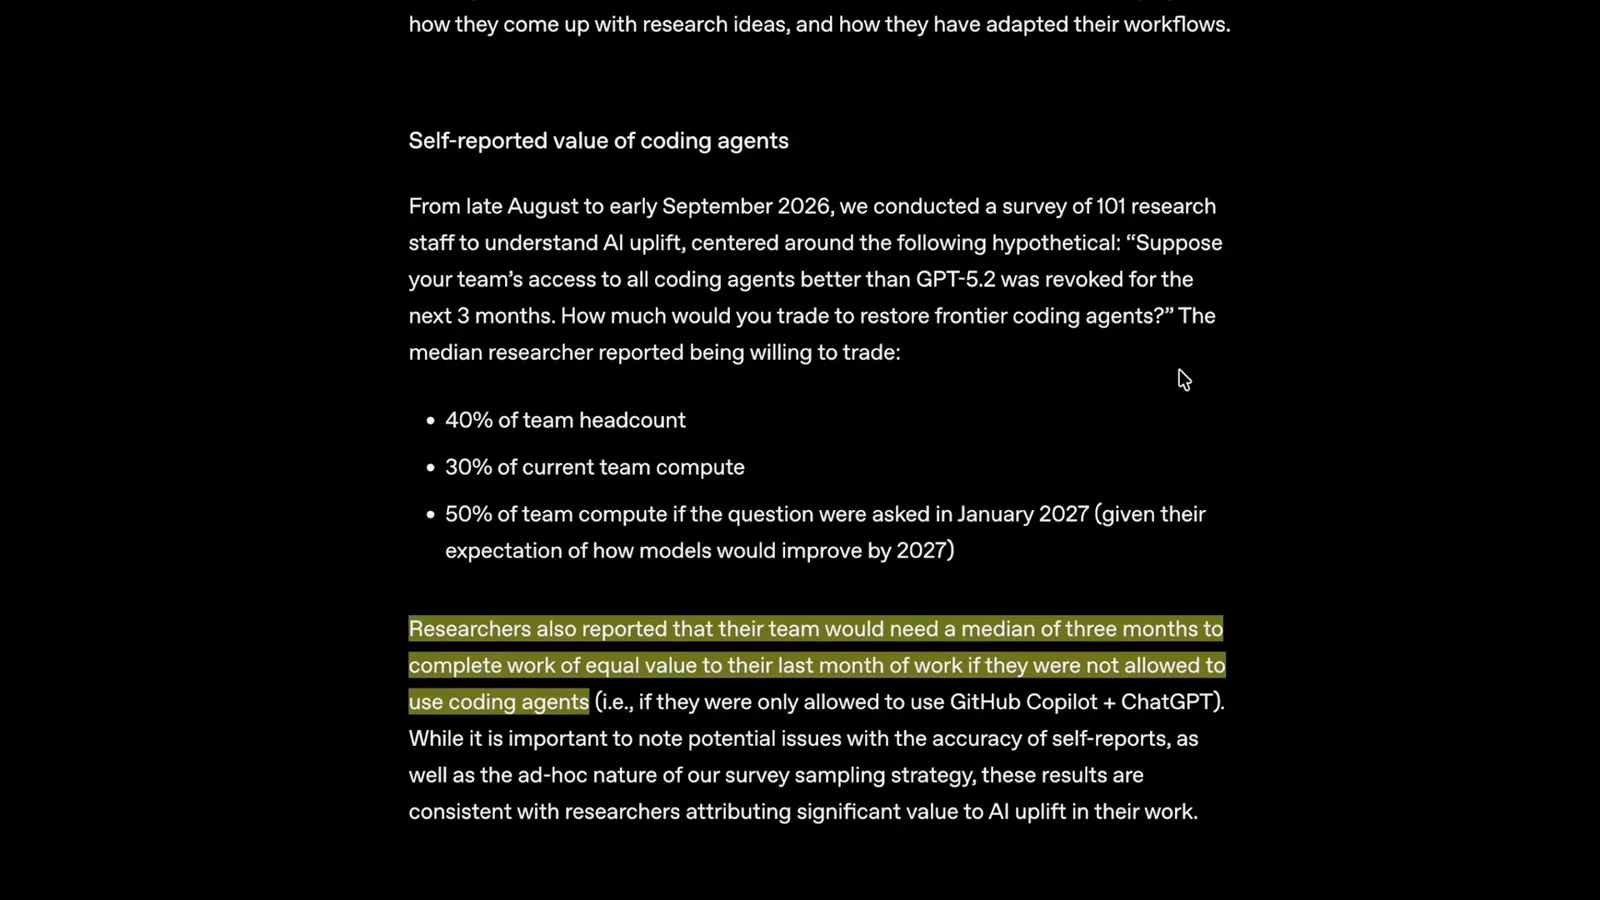
METR 和 Anthropic 研究的是基准趋势,而 OpenAI 的调查询问研究员自己的工作。要估计变化中有多少归功于 AI,需要一个无法直接观察的反事实。个人生产力提高与模型能力增强不是一回事。
Anthropic 研究员在一个问题中报告了个人工作速度提高 12 倍;OpenAI 研究员在另一个问题中报告同等价值工作提高三倍。提问措辞很重要。外部 AI 研究任务排行榜给不同模型排出的名次各异,但它们仍只是实际研究的间接指标。
Anthropic 联合创始人 Tom Brown 将算力乘数描述为让相同物理算力训练出更强模型的发现。他说,四倍乘数可能让人只用四分之一算力就达到同样的模型水平,或者用原有算力训练更强的模型。他预计各个乘数会相互叠加。
Brown 说,Anthropic 相信随着 Claude 自行发现乘数,这一过程还可能加速。这引出公司的“向上竞赛”论点:先在前沿领先,再展示其他实验室会模仿的安全实践。Dario Amodei 说他坚持这一策略,并以公司拒绝广告为例。
竞争会带来更强的独立评估吗?
Anthropic 认为前沿领先地位有助于推动良好安全实践。主持人质疑竞争实验室监督者的访问权限和独立性。
其中一项做法是嵌入式评估:独立监督者获得类似员工的权限,核实实验室的工作。Anthropic 宣布与 Accenture 合作,在五年内建立评估能力。我质疑这一时间表如何与递归自我改进会更快到来的预测相协调。
METR 也评估过 Anthropic,但大部分基础证据经过删节。我还注意到,Anthropic 曾向一名参与评估的成员提供工作机会。Dan Hendrycks 说,一些安全组织因为关系或资金问题,觉得无法公开批评该公司;这些担忧涉及评估者的独立性。
OpenAI 也宣布了嵌入式评估,但所述安排没有让评估者不受限制地接触员工或访问 Slack。我引用了一名 OpenAI 员工的话:他欢迎这一想法,但对最终权限感到失望。宣布合作本身并不能证明监督者能够调查所需的一切。
文字推理为什么更难监督
模型可以在生成可见步骤前于内部完成更多计算。主持人认为,这使实验室赖以监督的一种方法变得更复杂。
竞争也可能影响模型安全方面的选择。随着实验室争相开发自动化 AI 研究员,我想问竞争者是否会接受原本不会接受的取舍。一个难点是监督模型的思维链:它在得出答案过程中生成的中间文字。
OpenAI 研究人员将监督描述为其安全论证的核心部分。阅读模型写出的推理不同于检查神经网络的激活值,而且这种方法依赖文字如实反映模型将要做的事。安全论证是基于证据、结构化地说明风险得到控制的论证。
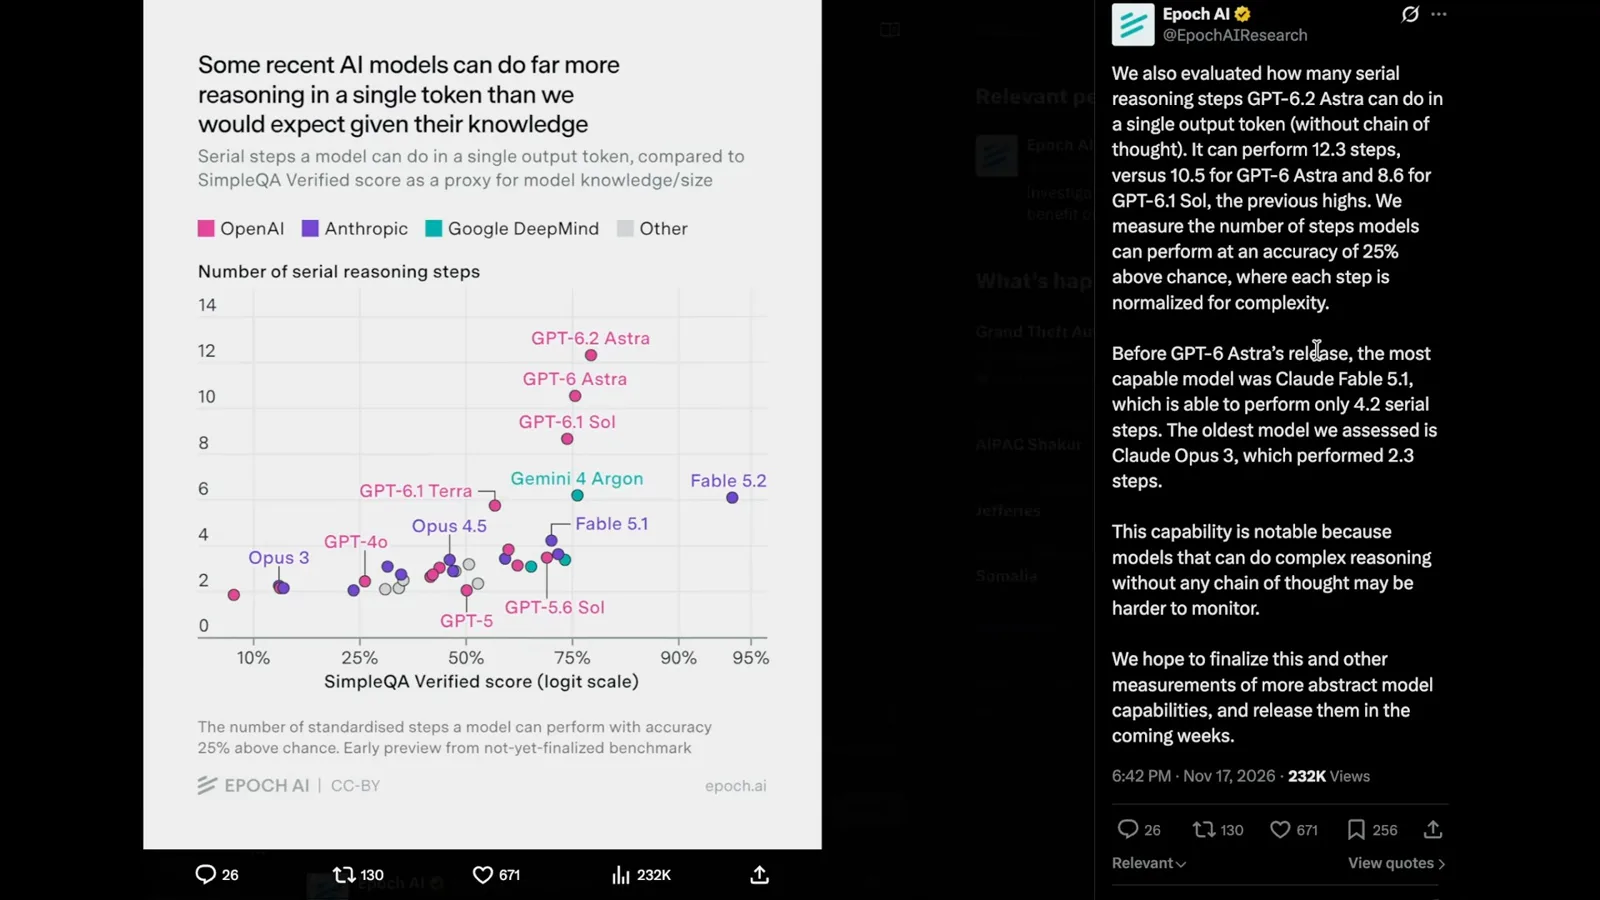
OpenAI 探索过一种架构,让模型在输出 token 之前把更多计算转移到网络内部。我还讨论了其他研究:这类方法不靠文字思维链也能提升性能。Anthropic 研究人员知道其中的取舍,但在我看来,他们的克制没有明显引发其他实验室争相效仿。
OpenAI 的论文还指出,即使采用其他架构变化,模型不依赖可见推理也能完成的任务正在增多。这个趋势或许原本就在发生。然而,如果模型能解决任务,同时写出不忠实的草稿,文字解释作为监督依据的作用就会减弱。
设想在一周结束时检查一名员工的电脑:它可能帮助了解工作的情况。如果这名员工是 CEO,而你只能看到电子邮件,就能了解一些情况,却无法看到每个决策和考量。模型能力提高后,可见推理同样可能只呈现局部。
Greg Brockman 说,最初开发思维链监督时,目标是保持其忠实性。他表示,随着模型可以在一次前向传播中完成更多工作而不必写下来,需要新的监督方法。OpenAI 的近期报告称,维持人类监督需要技术和治理方面的突破。
研究资源分配图能说明什么,不能说明什么
主持人从 OpenAI 的图表估计安全研究时间,并将其透明度与 Anthropic 比较。他还讨论研究人员对模型发布背后想法来源的说法。
报告还说,不应将其讨论解读为打算追求完全递归自我改进。前研究员 Jacob Coxon 表示,Anthropic 公开讨论算力乘数是他决定离开的因素之一;他认为算法改进接近自动化。
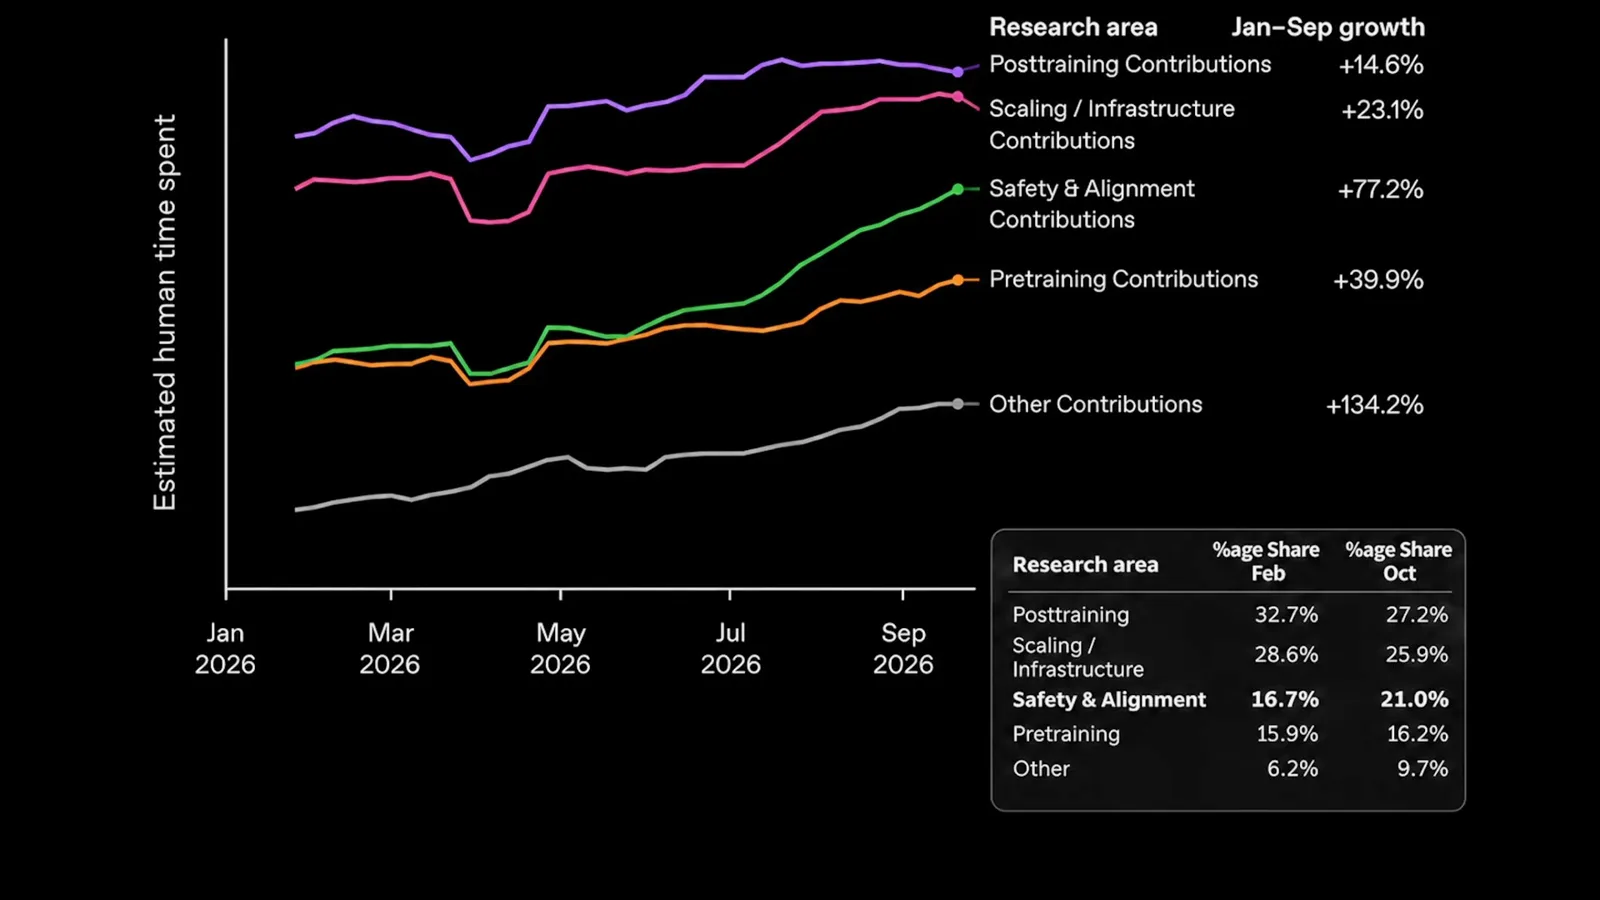
OpenAI 的一张图展示了人类研究员在不同领域投入的时间。我用 Gemini 根据像素估计比例,推算安全与对齐从 2026 年 2 月约占研究时间的六分之一,上升到 10 月的约 21%。这一估计只是近似值,但公开图表让外界可以这样审视。
OpenAI 董事会成员 Paul Christiano 在一场演讲中说,他认为未来三年 AI 接管的风险很高。他将其定义为 AI 系统追求自己的目标并有效作出重要决定,而人类无法阻止。他的预测促使我们追问研究资源是否与研究者描述的风险相匹配。
OpenAI 询问参与预训练、后训练和监督工作的贡献者,Astra 发布背后的重要想法来自人还是模型。研究人员认为主要想法由人提出;其中一人说,Codex 提出修改之后,一个想法才开始奏效。新颖的研究想法在训练数据中也可能相对稀少。
Anthropic 将长篇安全报告作为它鼓励其他实验室采用的另一项实践,但细节很重要。我引用一份 Google DeepMind 报告:它认为 Gemini 4 Argon 自主逃避监督而造成严重或大规模危害的可能性极低,包括持续部署失控系统或破坏机器学习研究。
安全报告与争夺领先地位的局限
主持人对照 Google 安全报告中的表述与研究人员提出的担忧。Anthropic 员工 Tao Lin 最后认为,依赖一家实验室略微更安全是一场风险很大的赌注。
还有一些进展我没有深入讨论,包括实验室阻止其他人用前沿模型的输出训练模型,以及研究模型识别自己何时受到评估的能力。两者都可能影响竞争和安全局面,而后者也给监督带来挑战。
Amodei 说,他希望社会信任那个能正确处理 AI 风险的公司。Anthropic 员工 Tao Lin 提出警告:他认为许多同事开展能力研究,部分是为了支持一个更安全的参与者,但人类如果仅仅因为 Anthropic 可能略微更安全就依赖它赢得竞争,将是在冒险。
我很想知道你如何看待这些新模型和更广泛的安全问题。
同频道的其他文章
 31:41EN → 简体中文
 AI Explained· 2026年11月10日模型能力增长、评估不可靠与基准分数的边界AI Explained 将近期模型测试与工作流程失误和评估意识的例子对照。
 27:55EN → 简体中文AI Explained· 2026年11月2日AI 安全、模型发布与理解能力的边界AI Explained 审视实验室预测、安全承诺和模型评测结果,主张在能力提升时设置多重防护。
 31:00EN → 简体中文AI Explained· 2026年10月12日为什么 AI 实验室自己警告会出重大事故,却还在继续竞赛Sam Altman, John Schulman · OpenAIAI Explained 梳理正在变弱的安全防护、前沿竞赛背后的激励,以及研究突破为何让未来 18 个月更难预测。
 38:28EN → 简体中文AI Explained· 2026年10月1日AI Agent 安全与递归自我改进的挑战AI Explained 讨论报道中的隔离失效、模型评估,以及加速 AI 研究带来的压力。
 32:54EN → 简体中文AI Explained· 2026年9月24日Opus 5.5 与自动化 AI 研究的竞赛AI Explained 在模型进展之外,讨论评估和治理递归自我改进日益困难的挑战。
 24:53EN → 简体中文AI Explained· 2026年9月16日为何一些研究者呼吁放缓前沿 AI 发展AI Explained 梳理可能的扩展方向、监测方面的担忧,以及能力如何可能带来危害的争论。