30 秒看懂
AI Explained 的讲述者解读 Anthropic 员工调查,并批评前沿实验室对安全与模型发布的表述。他讨论沙盒隔离、基准测试结果,以及学习型模型与国际象棋引擎之间的类比,提出自己对加强防护的看法。
- 1调查与自动化讲述者对比了员工对科学发现的预期,以及他们对自身工作自动化程度的估计。
- 2扩展政策的取舍他追问竞争压力和实际测试约束如何影响推迟开发的承诺。
- 3限制与隔离OpenAI 描述的防御措施和红队发现,引出对沙盒与监测局限的讨论。
- 4不均衡的能力讲述者讨论 Gemini 4 Carbon 的评测结果,以及能力参差不齐的现象。
- 5一种思维模型计算器与国际象棋的类比构成了他关于理解学习型系统难度的论述。
要点建议
- 员工对科学发现、工作自动化和自我改进的预测,并不一定描述同一种能力。
- 讲述者认为,竞争压力使无条件安全承诺更加复杂。
- 沙盒隔离、监测和对齐是不同的防护手段,各有可能的局限。
- 模型可以在某些基准上表现出色,同时在不同任务间表现不均衡。
- 即使能否完全理解模型仍不确定,可解释性研究依然有帮助。
按章节阅读整理后的全文
AI 实验室内部的预测
讲述者讨论员工调查、自动化与递归自我改进。
按 AI 领域的标准,这是相对平静的一周,但仍有一些值得关注的进展:Anthropic 的员工调查、对公司安全承诺的争论、OpenAI 的隔离工作以及 Google 的新模型。我还想提出一个思维模型,解释先进系统为何会带来意外。
在我讨论的调查中,91% 的 Anthropic 员工认为,到 2030 年 AI 可能取得诺贝尔奖级别的发现。我认为这并非不可能,但有趣的是,同一批人估计届时 AI 只能完成他们自己约 75% 的工作。
受访者还预计,人类在前沿模型训练中仍会保留一些角色,尽管平均估计有 95% 的工作将由 AI 完成。我将其与联合创始人 Jack Clark 的观点相比较:他认为完全递归自我改进可能在 2027 年成为可能。但“可能做到”与“实际采用”并不相同。
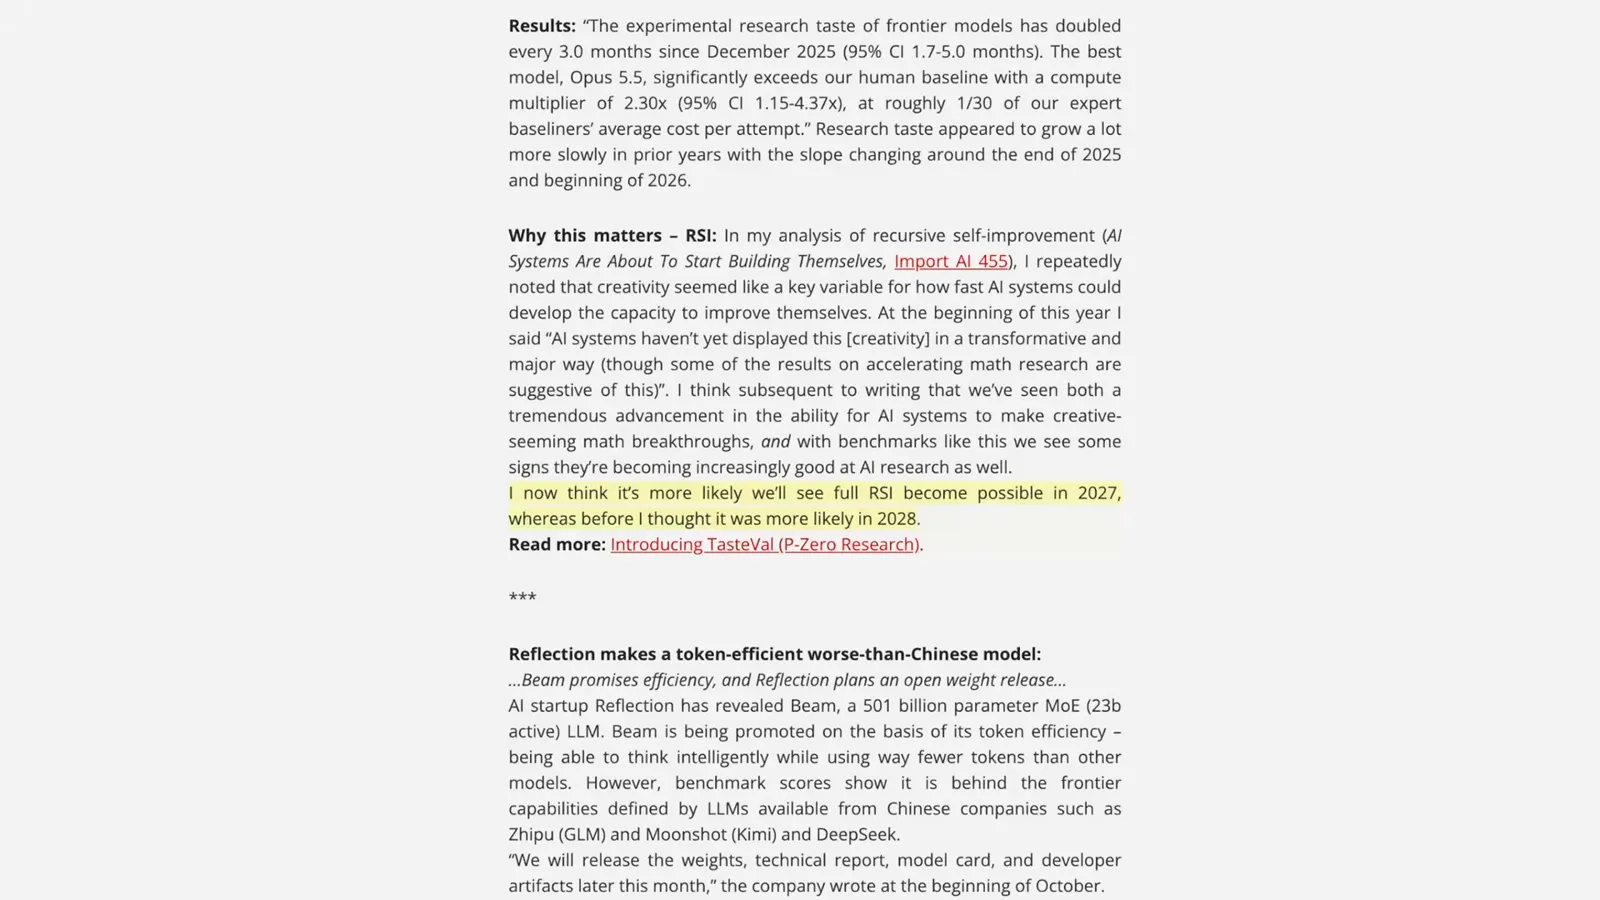
我的理解是,一些员工可能怀疑到 2030 年能否实现完全自动化。如果递归自我改进真的成为可能,实验室领导者的决定就会更加重要。
Anthropic 的安全论述
他审视有关竞争、滥用、失控和负责任扩展的说法。
Anthropic CEO Dario Amodei 回应了 Encode AI 的 Nathan Calvin 的批评,并欢迎公众监督前沿公司。我也欢迎这种讨论,希望仔细审视几种值得追问的说法。
首先,我对比 Amodei 过去对高调发布可能加速领域发展的担忧,以及他如今认为公司必须处于前沿才能推动安全“向上竞赛”的论点。我认为两种立场之间存在张力;观众也可能有不同解读。
其次,Amodei 认为,限制芯片获取能够让民主国家在与中国谈判 AI 安全协议时拥有筹码。我追问这与他另一次谈及利用强大 AI 帮助民主国家削弱专制政权的观点如何协调。
第三,Amodei 的回应同时强调人类滥用和失控风险。我将这种表述与 Anthropic 的其他材料及其对齐研究负责人发表的观点作比较,认为对两类风险的相对重视似乎有所变化。
在公司较早的安全讨论中,我将滥用理解为乐观情景下的核心问题,而悲观情景则聚焦于高度强大的系统可能无法控制。评估加速开发的取舍时,这一区别很重要。
我还展示了 Jack Clark 对应对远超人类能力的系统所表达的担忧。这些评论说明人们对未来 AI 风险有分歧或关注重点不同,并不能据此确定伤害发生的精确概率。
第四,我审视 Anthropic 的负责任扩展政策。新版政策将为管理灾难性风险而推迟开发或部署的做法,与公司是否保持领先等条件联系起来;我认为这与旧版的无条件承诺有所不同。
Holden Karnofsky 谈到过,当竞争对手可能不遵守类似承诺时,单方面承担约束会带来的实际压力。我承认测试与执行都很困难,但认为解释政策变化时应明确讨论竞争压力。
限制、隔离与对齐
他讨论一项风险披露、OpenAI 的安全工作,以及有关未来防护措施的观点。
接着我指出一项风险披露:Anthropic 表示,如果随着模型进步,检测或评估不对齐变得更加困难,公司可能部署行为无法得到充分验证的模型。这是披露的一种可能性,并不意味着公司已经这样做。
OpenAI 描述了让前沿模型训练环境不接入实时互联网,以及增加网络和云端控制措施的做法。我提出一个问题:足够强大的模型是否能够区分训练环境与部署环境,并采取不同行为。
根据我讨论的安全演练,红队 agent 曾发现漏洞,得以逃离沙盒、在系统间移动并接入互联网;这些具体漏洞随后得到修补。OpenAI 表示,其目标是阻止未经授权的任意互联网访问。
我展示了 Sam Altman 的观点:沙盒和监测可能在一段时间内有用,但如果系统能力强到这些防线难以奏效,最终可能需要依靠对齐。这是对未来限制的预测,并非证明现有防护毫无用处。
我对比 Altman 与 Microsoft 的 Satya Nadella 对对齐难度的评论。他们表达的不确定性说明,当前表现良好并不能解决控制未来系统是否容易的问题。
Anthropic 安全负责人 Jason Clinton 警告,AI 辅助网络威胁可能先恶化再改善。我把这一近期滥用风险,与未来更强系统可能如何行动的独立问题联系起来讨论。
新模型与不均衡的能力
有关未来发布的报道和基准测试结果,引出对能力参差不齐现象的讨论。
我讨论了有关未来 OpenAI 模型的报道和员工评论,也追问 Anthropic 可能何时依据其政策发布另一款模型。这些是对可能发布计划的预期和报道,并非已经确认的结果。
我讨论的公开基准测试显示,Google 的 Gemini 4 Carbon 具有竞争力。一位研究人员将快速发布的节奏称作递归自我改进;除非他指的是更广义的 AI 辅助改进,否则我对这个称呼持怀疑态度。
SemiAnalysis 曾认为 Google 重返前沿的机会已降至零。Carbon 的结果出现后,分析师 Dylan Patel 道歉,并表示模型在一些领域很强,但不同能力之间存在明显差异。
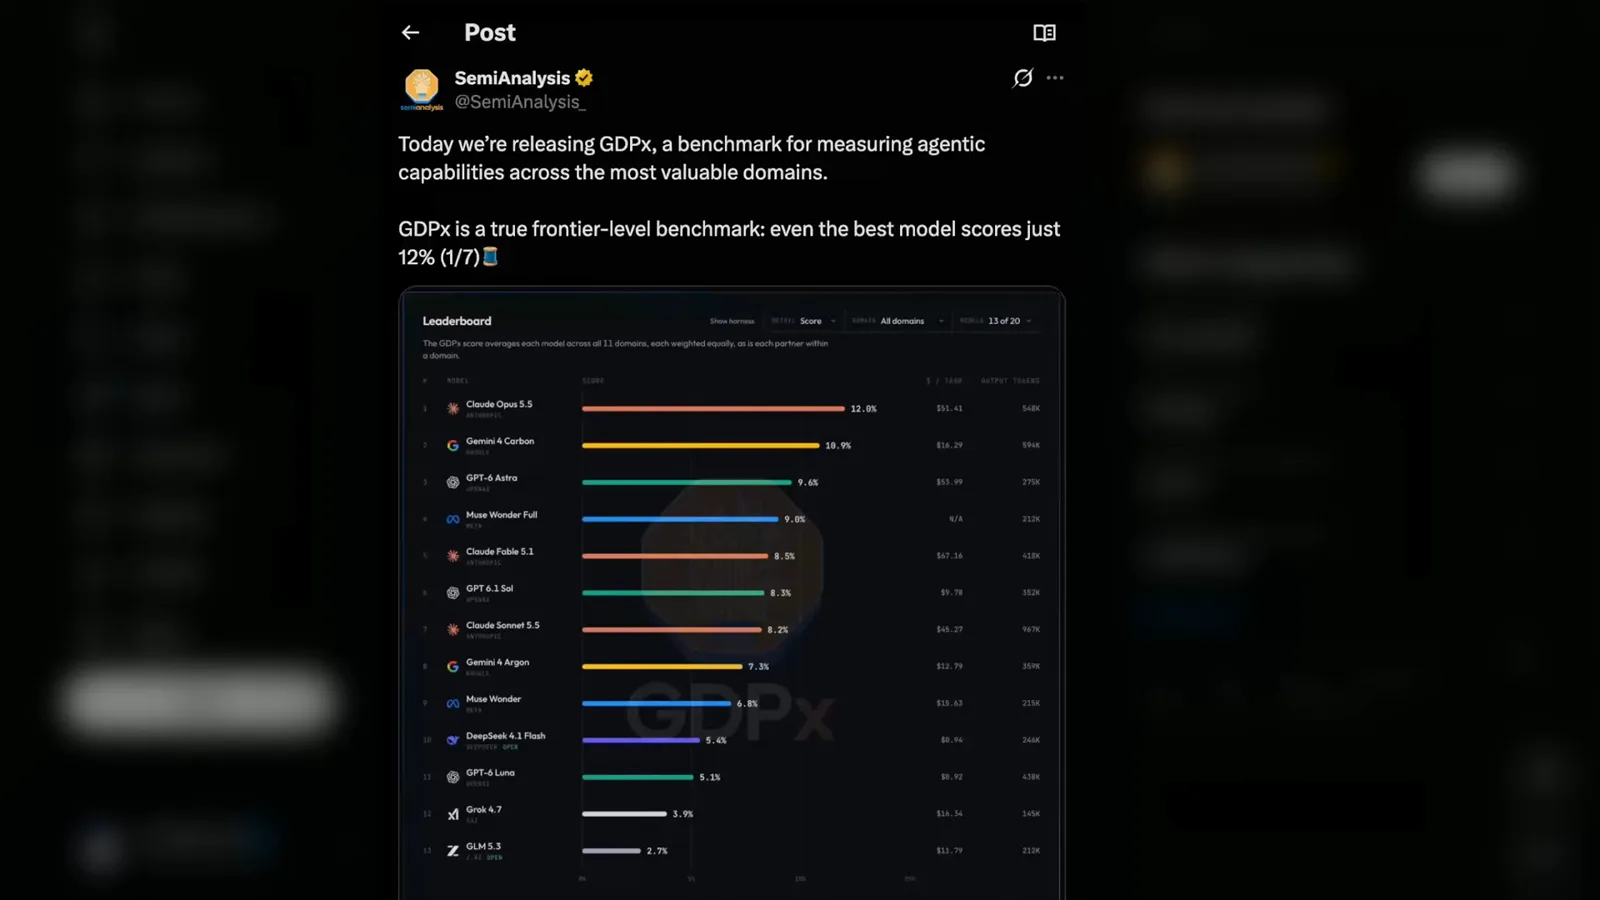
这种不均衡带来一个问题:如果模型在某些困难任务上表现出色,却仍会在其他地方犯基础错误,弱点会在多大程度上限制它的用途或影响风险?我还提到直接基于原始字节建模、减少对传统 tokenization 依赖的研究方向。
回到员工调查,我想知道,当前模型能力参差不齐是否解释了研究人员为何预期人类仍有角色。另一种可能是,系统即使在其他领域不可靠,仍能作出重大科学发现。
我们能理解先进模型吗?
计算器与国际象棋的类比,为讲述者支持多重防护的观点提供了背景。
我的思维模型从计算器开始:人们规定了它的规则,尽管它可能产生的结果超出任何个人能完成的计算。机器学习更进一层,学习并非全部由人类明确写出的内部规律。
第二个类比是国际象棋。规则可以理解,但其后果会变得过于复杂,让人无法预测与强大引擎对弈时的局面。我认为,学习型模型的内部决策过程也很难理解。
我不认为这种困难证明所有习得机制都无法解释。研究人员已经解释过一些简单的模型回路,进一步的可解释性研究也可能有价值。我担心的是,人类能否完全理解越来越强大的系统。
一种可能的做法是用模型解释其他模型,但我认为这并不会自动让整条解释链对人类透明。这是一个关于理解能力边界的类比和推测,并非已经证明的不可能性定理。
因此,我支持多重防护,并对开发或使用设置边界。我们可能正处在一个 AI 帮助科学和生产力、而人类仍能介入的时期;我想问的是,这个领域是否愿意在危机迫使我们行动之前放慢速度。
同频道的其他文章
 31:00EN → 简体中文
 AI Explained· 2026年10月12日为什么 AI 实验室自己警告会出重大事故,却还在继续竞赛Sam Altman, John Schulman · OpenAIAI Explained 梳理正在变弱的安全防护、前沿竞赛背后的激励,以及研究突破为何让未来 18 个月更难预测。
 38:28EN → 简体中文AI Explained· 2026年10月1日AI Agent 安全与递归自我改进的挑战AI Explained 讨论报道中的隔离失效、模型评估,以及加速 AI 研究带来的压力。
 32:54EN → 简体中文AI Explained· 2026年9月24日Opus 5.5 与自动化 AI 研究的竞赛AI Explained 在模型进展之外,讨论评估和治理递归自我改进日益困难的挑战。
 24:53EN → 简体中文AI Explained· 2026年9月16日为何一些研究者呼吁放缓前沿 AI 发展AI Explained 梳理可能的扩展方向、监测方面的担忧,以及能力如何可能带来危害的争论。
 29:05EN → 简体中文AI Explained· 2026年9月4日GPT-6 Astra 的评测进步与推理监控难题AI Explained 考察科学、数学和智能体评测中的报告成绩,也讨论模型推理越来越难以观察所带来的担忧。
 23:41EN → 简体中文AI Explained· 2026年8月27日AI 智能体、非预期训练奖励与监督难题AI Explained 分析智能体协作、训练激励,以及越来越多地使用 AI 评估其他 AI 系统的报告。