30 秒看懂
Nathan Lambert 解释 RLHF 中的显式 KL 惩罚,并将其与优化几何的分析区分开来。他在明确假设下比较正向和反向 KL,回顾泛化与遗忘实验,并介绍智能体强化学习中较新的稳定性问题。
- 1显式 KL 惩罚加权散度项在学习到的奖励与偏离参考策略之间取得平衡。
- 2KL 的两个方向SFT 拟合固定数据;带 KL 正则化的强化学习可以表示为朝向奖励加权参考策略的反向 KL 最小化。
- 3为什么 SFT 仍可能遗忘覆盖新的目标分布,并不等于保留原模型的所有模式。
- 4较新的稳定性问题智能体强化学习还必须处理轨迹采样与训练器之间的不匹配。
要点建议
- 参考模型 KL 惩罚控制策略在优化奖励时偏离参考策略的程度。
- KL 散度不对称,因此方向和采样分布很重要。
- Lambert 推导的奖励优化与反向 KL 等价关系要求 KL 惩罚系数为正。
- 覆盖新的数据分布,并不会自动保留先前学到的每一种能力。
- 采样器与训练器的不匹配,是不同于相对固定参考模型散度的稳定性问题。
按章节阅读整理后的全文
显式 KL 惩罚
Lambert 解释参考策略控制、KL 方向和训练期间的监控。
这节课将正则化、策略更新以及强化学习为何可能与监督微调有不同的泛化表现联系起来。眼前的问题是:强化学习更新如何改变模型分布,又该怎样控制这种变化?
在常见的 RLHF 表述中,学习得到的奖励需要与训练策略和参考策略之间的 KL 散度惩罚相权衡;参考策略通常是强化学习开始前的模型。惩罚权重决定优化过程抵抗偏离参考模型的力度。相关控制思想早于现代语言模型 RLHF。
在一些 RLVR 和智能体训练配方中,固定参考模型的 KL 惩罚已不如过去常见,但控制更新的更广泛需求仍然存在。不同代训练系统以不同方式处理相关的稳定性和过度优化问题。
奖励目标从奖励模型分数中减去加权散度。参考策略是强化学习更新之前的策略。不同文献可能把同一类系数写作 lambda 或 beta,因此需要结合上下文理解符号。
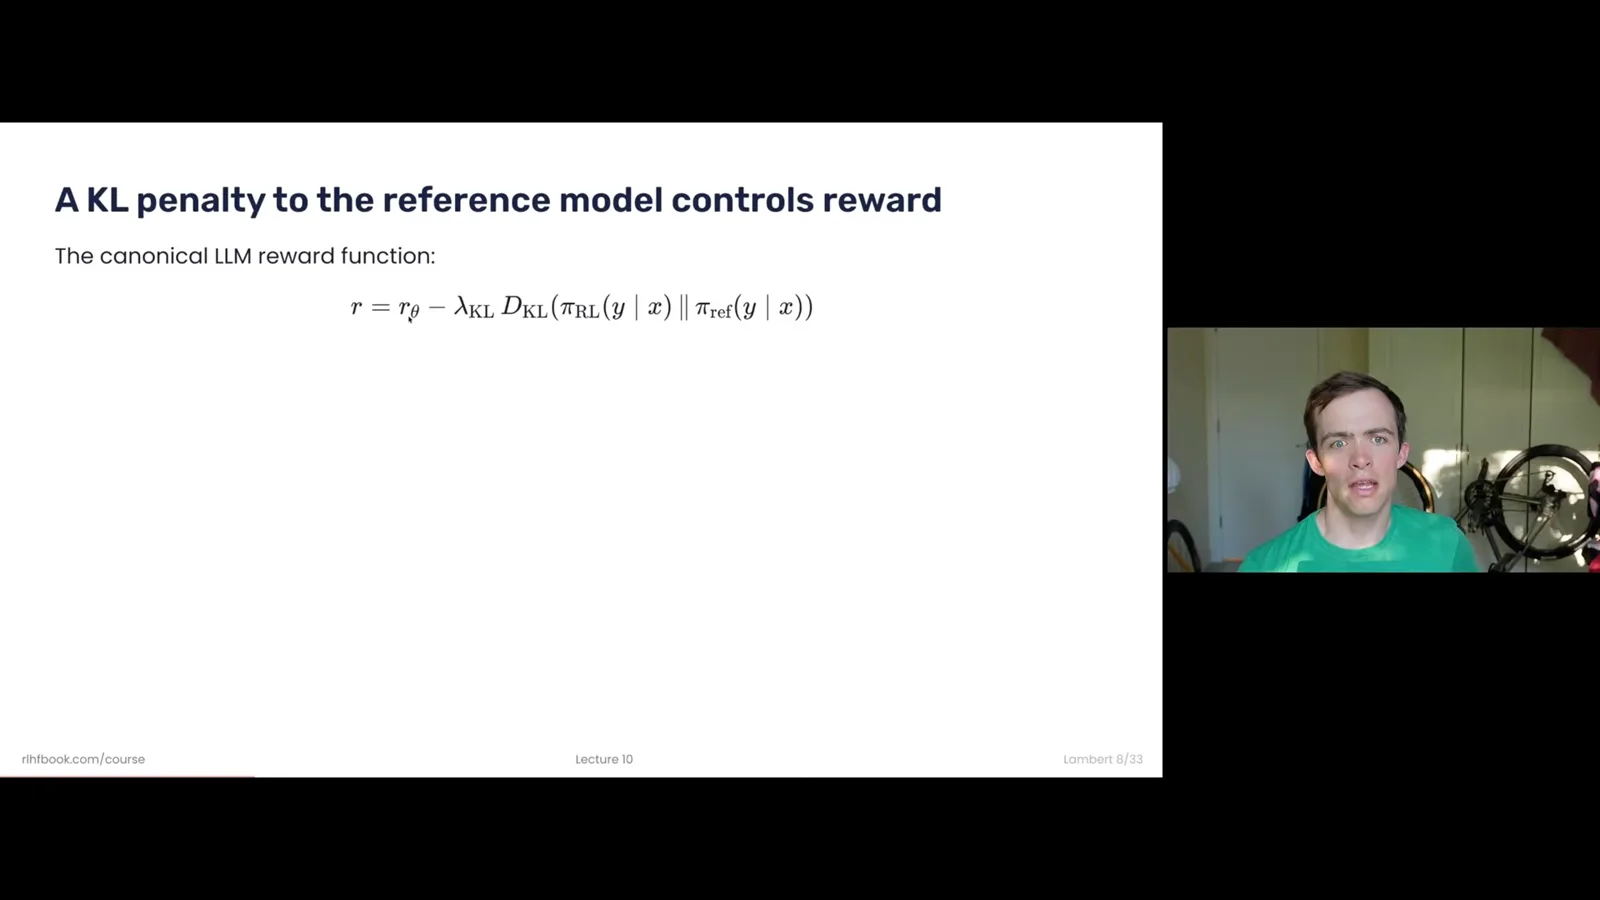
这一惩罚通常使用反向 KL:样本来自正在训练的策略,再相对于参考策略计算。人们常把 KL 称作距离,但它不对称,因此不是真正的距离度量。方向很重要,因为它决定哪个分布提供样本。
观察模型变化时,把 KL 称作距离有助于直觉理解,但交换两个参数会改变它的值。Lambert 稍后会利用这种不对称性比较不同分布,以及正向和反向目标的行为。
实践中,团队从采样 token 的对数概率估计 KL,并监控曲线是否有尖峰或异常变化。即使显式惩罚为零,也可以跟踪相对于初始模型的散度。序列级估计取决于实现和采样方式。
实现过程使用采样 token 的对数概率,并可在整个序列上汇总。不同估计量在实际性质上有所取舍;应当检查具体库的实现,而不是假定每段代码计算的量都一样。
图中的一次 OLMo 数学训练从零散度开始,因为训练策略最初与参考策略相同。即使没有启用惩罚,轨迹也能显示模型如何移动。曲线的形状和规模是诊断信号,不能单独衡量质量。
早期 RLHF 工作有时会使用控制器,随时间调整惩罚系数,以维持目标散度。现代配方通常使用固定系数,或者完全省略显式参考惩罚。Lambert 提到早期 PPO 和人类偏好微调工作,将其作为自适应控制的例子。
优化几何
他对比正向 KL 的监督学习与正惩罚系数下强化学习目标的反向 KL 视角。
Lambert 区分了奖励目标中的显式惩罚,与对优化问题形状的另一种描述。他用“隐式正则化”称呼后者:分析目标和采样分布如何影响策略,而不是手动添加一个单独的项。
监督微调从固定数据集或教师模型采样;在忽略与模型无关的常数后,最小化负对数似然等价于最小化从数据分布到学习策略的正向 KL。强化学习从自身策略采样。在 KL 惩罚系数为正时,正则化奖励目标可以改写为朝向奖励加权参考策略的反向 KL 最小化。
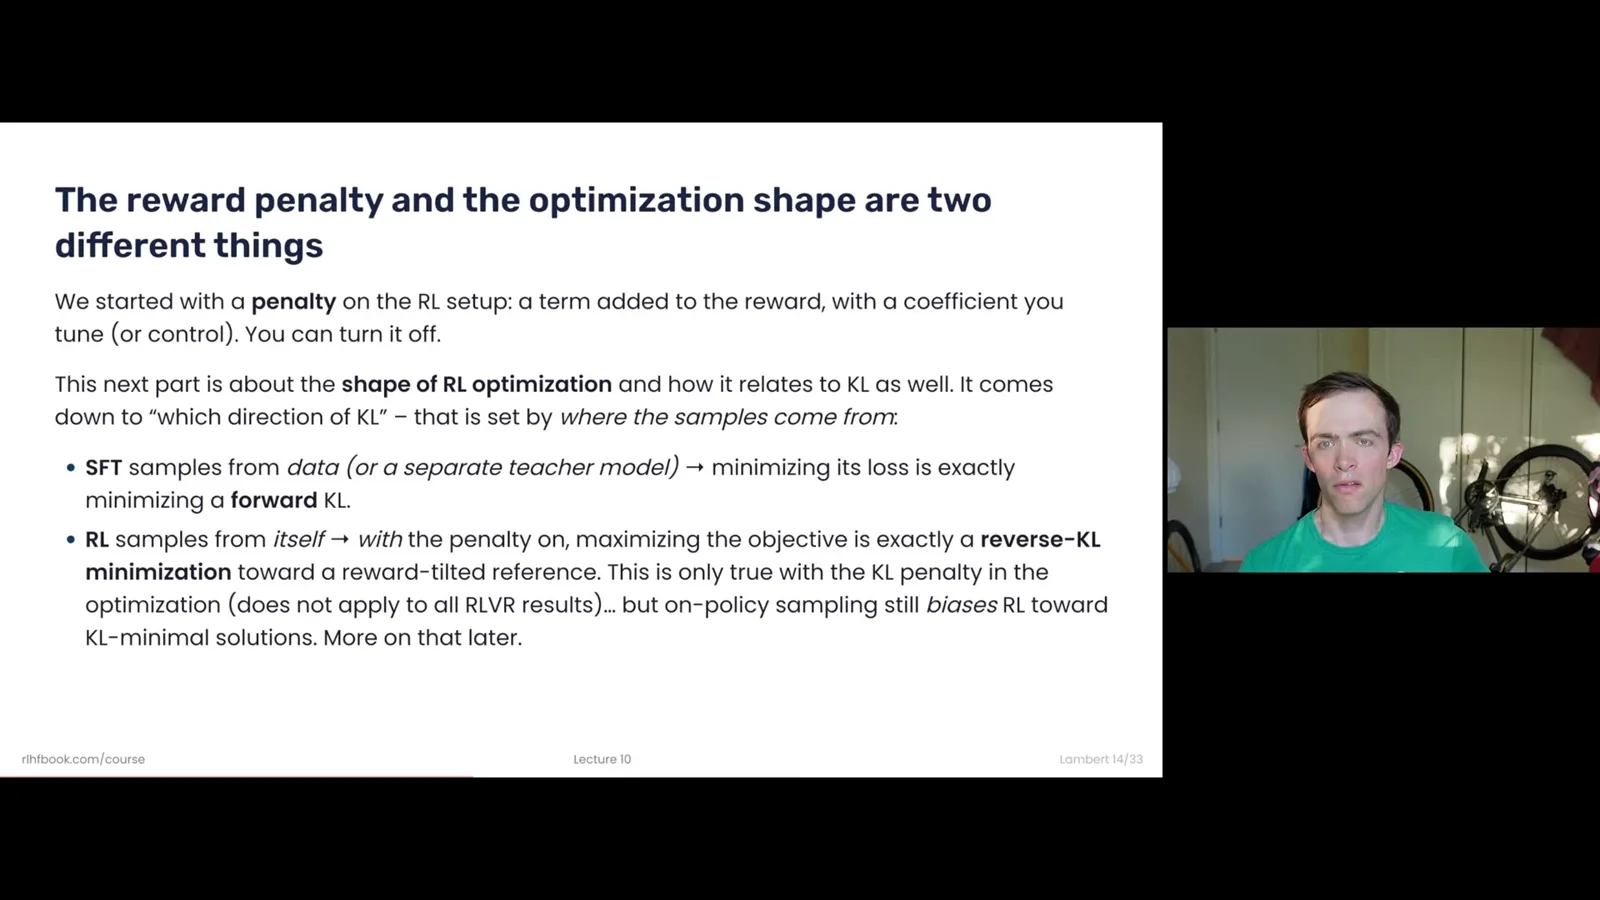
这种严格的反向 KL 等价依赖惩罚项存在。如果系数为零,这一特定推导就不适用。Lambert 强调这一条件,因为许多当前的可验证奖励配方省略了显式项。
奖励加权的最优策略通过奖励的指数函数重新加权参考策略,并使用归一化因子。惩罚权重较小时,奖励可以把策略拉得更远;权重较大时,最优策略更接近参考。把这一最优策略代回反向 KL 表达式,便可在常数和比例因子意义下还原正则化奖励目标。
奖励加权策略中的归一化因子使其成为有效分布。Lambert 将最优策略代入反向 KL,拆分各项并去掉常数。乘以惩罚系数后,这一最小化问题便与原来的奖励最大化形式联系起来。
对于监督微调,展开正向 KL 后得到与模型无关的数据熵项,加上监督损失。求梯度时常数项消失。两种观点描述的是不同问题——从数据学习与最大化奖励——但有助于比较优化形状。
正向 KL 通常被称为“覆盖概率质量”:如果目标数据在某处有概率,而学习策略在该处的概率趋近于零,损失就会变大。学习分布因此会被推动去覆盖目标概率质量。在上述设定下,反向 KL 通常被称为“寻找模式”,倾向于集中在高奖励区域。
如果某个目标示例在数据分布下有概率,但训练策略几乎不给它概率,正向 KL 就会产生很大的损失。这种压力鼓励模型覆盖目标分布,但不应把它误解为要求保留原始模型的每一种模式。
蒸馏中也出现类似区别:从固定教师学习类似正向 KL,而同策略方法自然地与反向方向联系起来。这些直觉有用,但具体分布和假设仍然重要。
泛化与遗忘
受控实验和多峰例子提供了可能的直觉,但有重要限制。
Lambert 回顾了题为《SFT Memorizes, RL Generalizes》的研究,该工作比较了在简单任务上训练,并在任务属性有所变化的测试上评估。报告中的实验显示,在这些场景下强化学习泛化更好,而狭窄的监督训练可能损害泛化。他把这作为有用的受控例子,而非普遍保证。
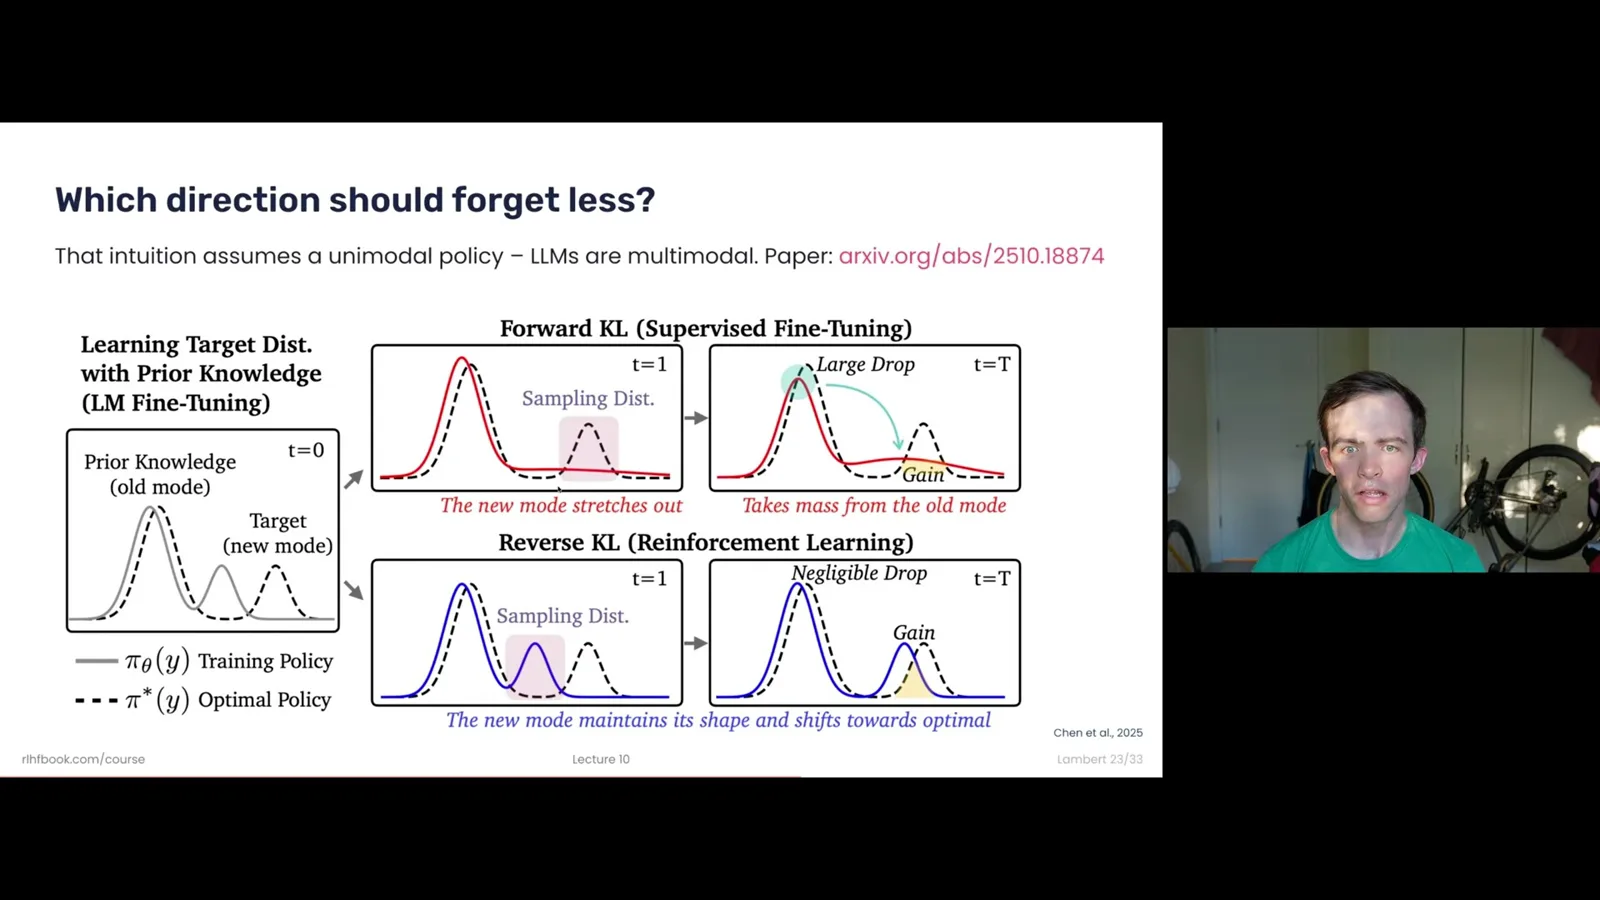
为什么覆盖概率质量的监督目标仍可能遗忘?目标数据分布并不等于原始模型已知的一切。在展示的多峰例子中,拟合新目标可能扩展一个学习到的模式,并从旧模式中拿走概率质量。覆盖新数据并不能保证保留每项原有能力。
在图示中,原始策略和目标策略都包含多个模式。正向 KL 更新可能拓宽新模式,并降低旧模式的概率质量;反向 KL 的示意则让新模式更局部地移动。Lambert 提醒,这张图提供的是直觉,而不是对神经网络训练的完整解释。
Lambert 讨论了另一篇论文《RL Razors》:在其比较相似任务性能的实验中,强化学习策略在 KL 意义下移动较少,对域外知识的遗忘也较少。他把这些作为有边界的经验结果,而不是每次强化学习都能保留所有能力的证明。
其他控制方法与智能体强化学习
课程最后讨论其他正则化方法以及采样器与训练器的稳定性方法。
训练配方中还出现过其他正则化方法。InstructGPT 在强化学习奖励之外加入预训练数据上的下一 token 目标,以保留语言模型行为。一些偏好方法为被选中的回答添加似然项,而不只依靠选中和拒绝回答之间的差距。
Llama 2 也在奖励模型训练中利用偏好强度信息。这些额外设计可能解决特定时期的具体问题,但 Lambert 建议在后续配方中重新审视复杂度:更简单的方法可能更容易扩展和理解。
近期智能体强化学习引入了与原始参考模型惩罚不同的稳定性问题。除了控制训练策略相对于固定参考策略的变化,系统还必须处理生成轨迹的采样器与更新权重的训练器之间的不匹配。这是不同的分布,也是不同的问题。
参考策略的作用随着时代变化。早期 RLHF 侧重防止模型在偏离初始策略时利用学习到的奖励模型。在工具使用强化学习中,即便不使用参考 KL 惩罚,轨迹生成引擎和训练器之间的数值差异也可能使更新不稳定。
Lambert 讨论了 T-MAX 使用的 divergence proximal policy optimization,即 DPPO,以及相关的逐 token 方法。这些方法可以掩蔽存在异常差异的 token,而不是只依赖裁剪概率比。他提醒听众,自己仍在学习这种新算法,可能遗漏了细节。
他提到的新方法包括 GLM、Kimi 相关的逐 token 掩蔽方法以及 DPPO。目标是处理采样 token 中极端或不可靠的差异。Lambert 明确称这部分是初步理解,并邀请实践者纠正。
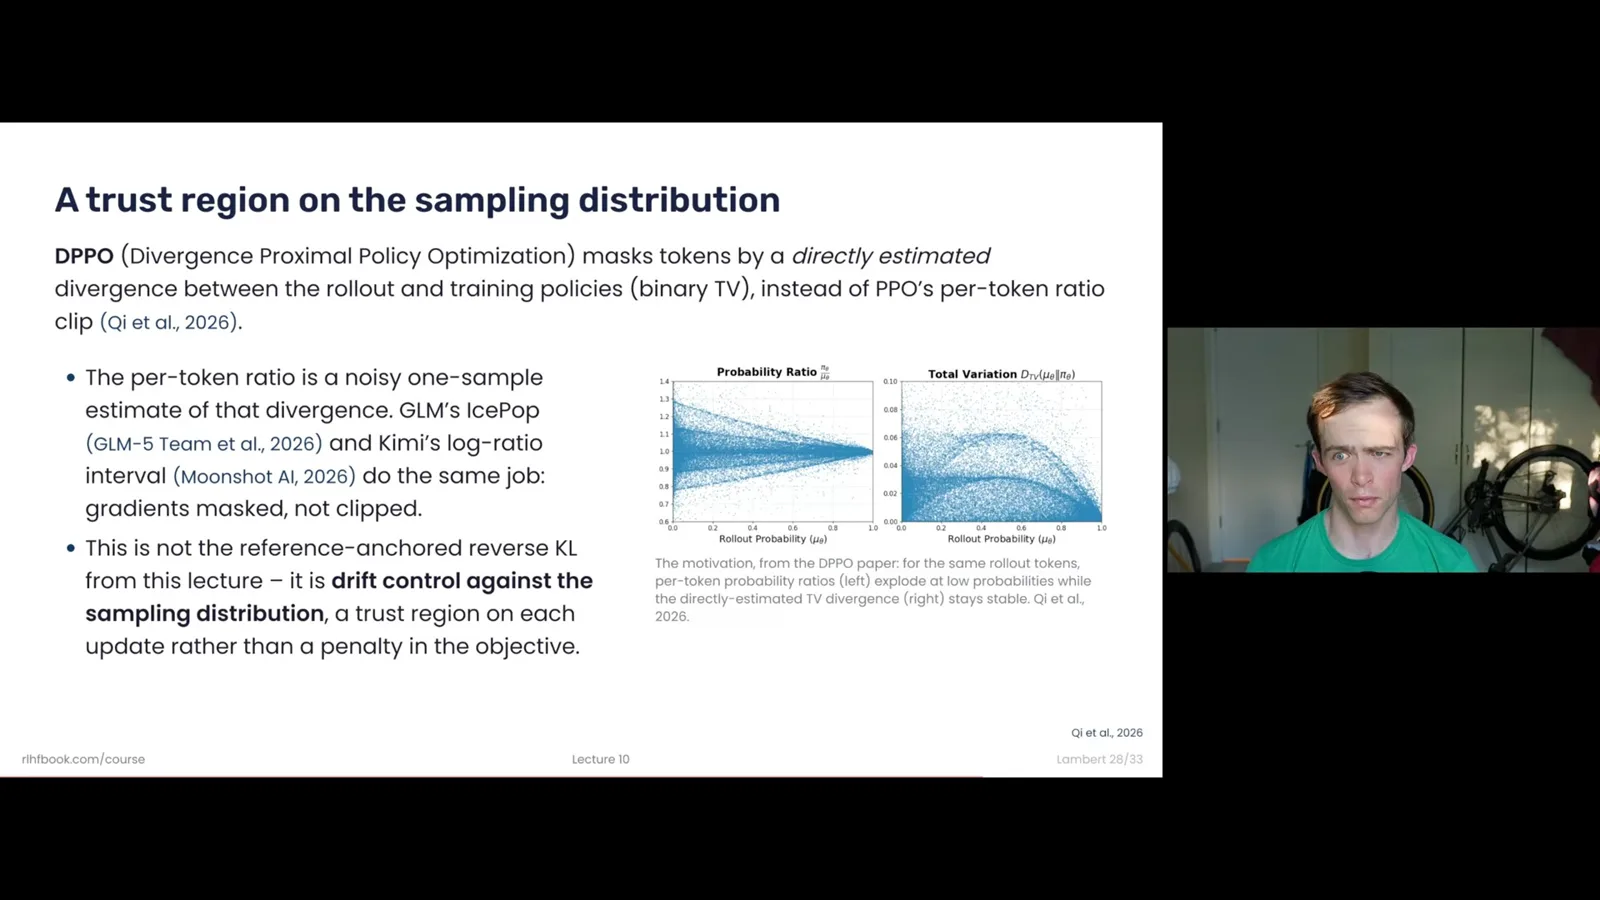
主要区别在于:一种惩罚锚定原始参考策略,另一类控制则约束一次更新相对于采样策略的漂移。Lambert 总结说,正向和反向 KL 是理解监督学习和正则化强化学习目标的有用视角,但关于泛化和遗忘的经验研究仍需要谨慎解读。
同频道的其他文章
 16:48EN → 简体中文
 Nathan Lambert· 2026年11月2日Nathan Lambert:开放模型如何与前沿实验室竞争Nathan Lambert · Allen Institute for AI开放模型的用量正在增长,能力差距也在缩小,但开发者需要可持续的经济模式和价格之外的优势。
 48:04EN → 简体中文Nathan Lambert· 2026年10月26日Nathan Lambert:开放语言模型的历史、竞争与风险Nathan Lambert · Allen Institute for AI从开放权重、研究基础设施和蒸馏,到采用情况与模型开发者面临的选择。
 46:42EN → 简体中文Nathan Lambert· 2026年10月25日Nathan Lambert 与 Florian Brand 谈 Kimi K3.1、网络风险和 AI 智能体Nathan Lambert, Florian Brand · Allen Institute for AIInterconnects 主持人讨论模型评估的分歧、安全漏洞披露潮,以及个人智能体在日常生活中的作用。
 5:42EN → 简体中文Nathan Lambert· 2026年8月12日修格斯为何成了 AI 后训练的吉祥物Nathan Lambert · Allen Institute for AINathan Lambert 追溯了这种怪物从洛夫克拉夫特小说走向语言模型、微调与 RLHF 视觉隐喻的历程。
 32:56EN → 简体中文Nathan Lambert· 2026年8月6日Nathan Lambert:AI 角色训练入门Nathan Lambert · Allen Institute for AI从 constitution、model spec 到人格实验和激活引导,理解后训练如何塑造模型行为。
 32:11EN → 简体中文Nathan Lambert· 2026年8月5日Nathan Lambert:语言模型评估如何演变Nathan Lambert · Allen Institute for AI从少样本提示与 pass@k,到智能体沙箱、分数噪声和基准污染。