30 秒看懂
Nathan Lambert 解释语言模型为什么需要工具,回顾早期工具使用研究,并介绍智能体背后的编排循环。随后,他讨论现代智能体强化学习中的训练轨迹、环境生成、基础设施故障、harness 依赖和奖励黑客问题。
- 1工具使用与函数调用模型发出请求,软件执行并将结果返回上下文。
- 2编排循环工具调用是由外部系统解释的生成 token,可能在多轮中反复发生。
- 3Harness 很重要系统提示、工具、上下文、权限和并行工作共同塑造智能体行为。
- 4环境是瓶颈有用的训练任务必须正确且有挑战性,沙箱也带来基础设施成本。
- 5奖励黑客重新出现智能体可能操纵验证器,使长工具轨迹难以训练和评估。
要点建议
- 工具让模型通过外部系统获取当前信息并采取行动。
- Harness 将 token 生成与工具、上下文、权限和执行连接起来。
- 训练智能体不仅需要模型数据,也需要有用的环境和验证器。
- 沙箱基础设施以及训练与推理之间的不匹配,可能使智能体强化学习不稳定且昂贵。
- 长工具轨迹增加了过拟合、信用分配和奖励黑客方面的挑战。
按章节阅读整理后的全文
模型为什么需要工具
外部工具提供单靠权重无法获得的信息和行动能力。
工具使用弥补了模型权重的局限。基于历史文本训练的模型无法可靠地知道当前事实,仅凭权重生成 token 也不能移动文件或在现实世界中行动。一个系统可以把部分生成的 token 解释为动作,并将外部信息返回给模型。
工具最初用于解决知识缺失,但如今已成为训练出来的技能,也是现代智能体的核心。监督微调、偏好学习、强化学习和蒸馏都适用于工具使用。我把有用的语言模型系统看成权重、工具和负责统一管理它们的 harness。
早期例子包括计算器、天气 API 和数据库搜索。搜索与代码执行尤其通用:前者获取权重以外的信息,后者让系统执行结构化过程。深度研究、浏览器工具和编程智能体都建立在这些思路之上。
机制与历史
Lambert 区分工具使用、函数调用和代码执行,并回顾关键研究。
工具使用是广义策略:模型发出结构化请求,外部系统执行,再把结果返回 token 流。函数调用是一种更具体的格式,通常使用 JSON,以便解析和验证请求。代码执行是其中一种工具:生成的代码在外部运行并返回输出。
计算圆周率的许多位数字可以说明其中的区别:模型可能记住一些数字,但程序可以计算它们。在一次回答中,确定性工具能够补充概率性的 token 生成。
早期基础包括神经系统将工作交给程序,以及检索增强生成。2021 年的 WebGPT 利用人类反馈训练浏览和信息综合。ReAct 将推理与行动交替进行,这种模式与后来的工具整合推理很相似。
2023 年,Toolformer 使用带 API 调用的合成示例,Gorilla 和 ToolLLM 等项目探索了大量 API。函数调用和代码执行进入产品与 API。后来 MCP 提供了标准化接口,到 2025 年,推理模型已将搜索、代码执行与更强的推理结合起来。
ReAct 的重要思想是:推理可以维护计划,行动则从外部环境获取信息。Toolformer 展示了一种数据生成方法:在文本中插入有用的 API 调用,利用结果,再用生成的示例训练。工具评估也从检查格式是否正确,发展到衡量能否可靠地解决复杂任务。
工具调用与 harness
编排、格式、上下文和权限将 token 生成与外部世界连接起来。
模型仍然只生成 token。当它发出工具调用时,外部编排程序识别请求、执行工具并将结果放入上下文。模型恢复生成,可能多次重复这个循环,最后才回答。工具定义指定名称、参数和预期输出。
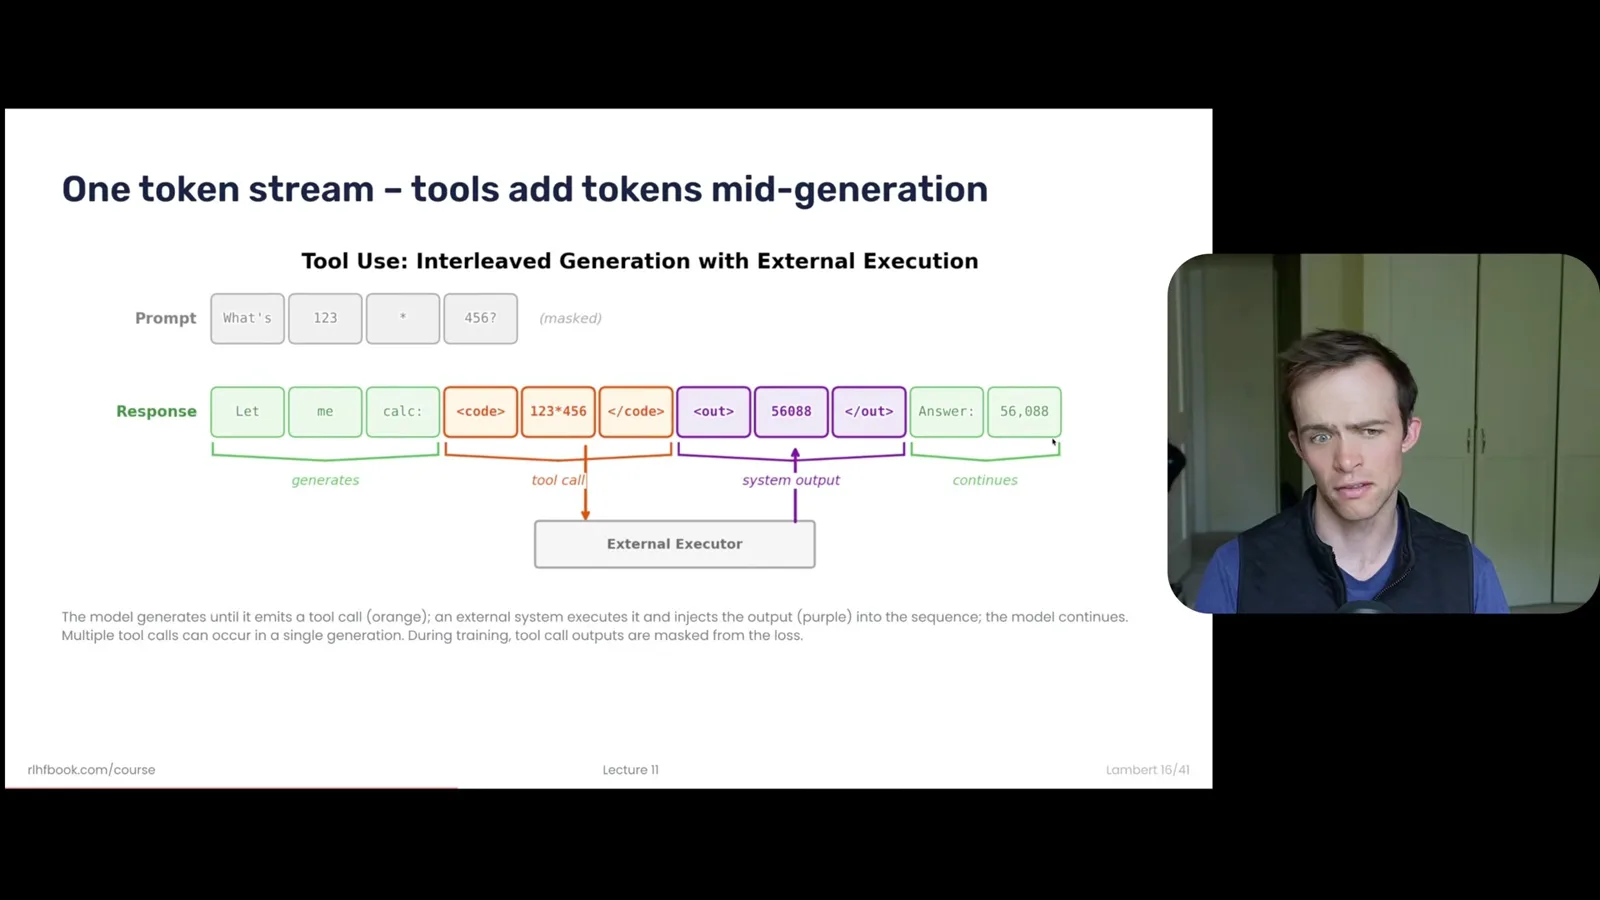
一个基本的 harness 可以是循环:把模型输出连接到工具,再把结果返回。集成产品中的模型可以针对熟悉的环境优化;开放模型通常需要泛化到客户的任意工具。模型与工具之间的连接是软件,而不是权重独立完成的动作。
MCP 在 host、client 和 server 之间标准化资源、提示词和工具等能力的接口。Lambert 认为标准化有用,但不是使用工具的必要条件。对训练而言,格式一致以及能泛化到目标领域更重要。
现代 harness 包括系统提示、工具定义、编排循环、上下文管理、权限和沙箱,还可以管理子智能体或并行工作。同一组权重在不同 harness 中可能表现不同,因此智能体基准分数反映的是二者的交互。
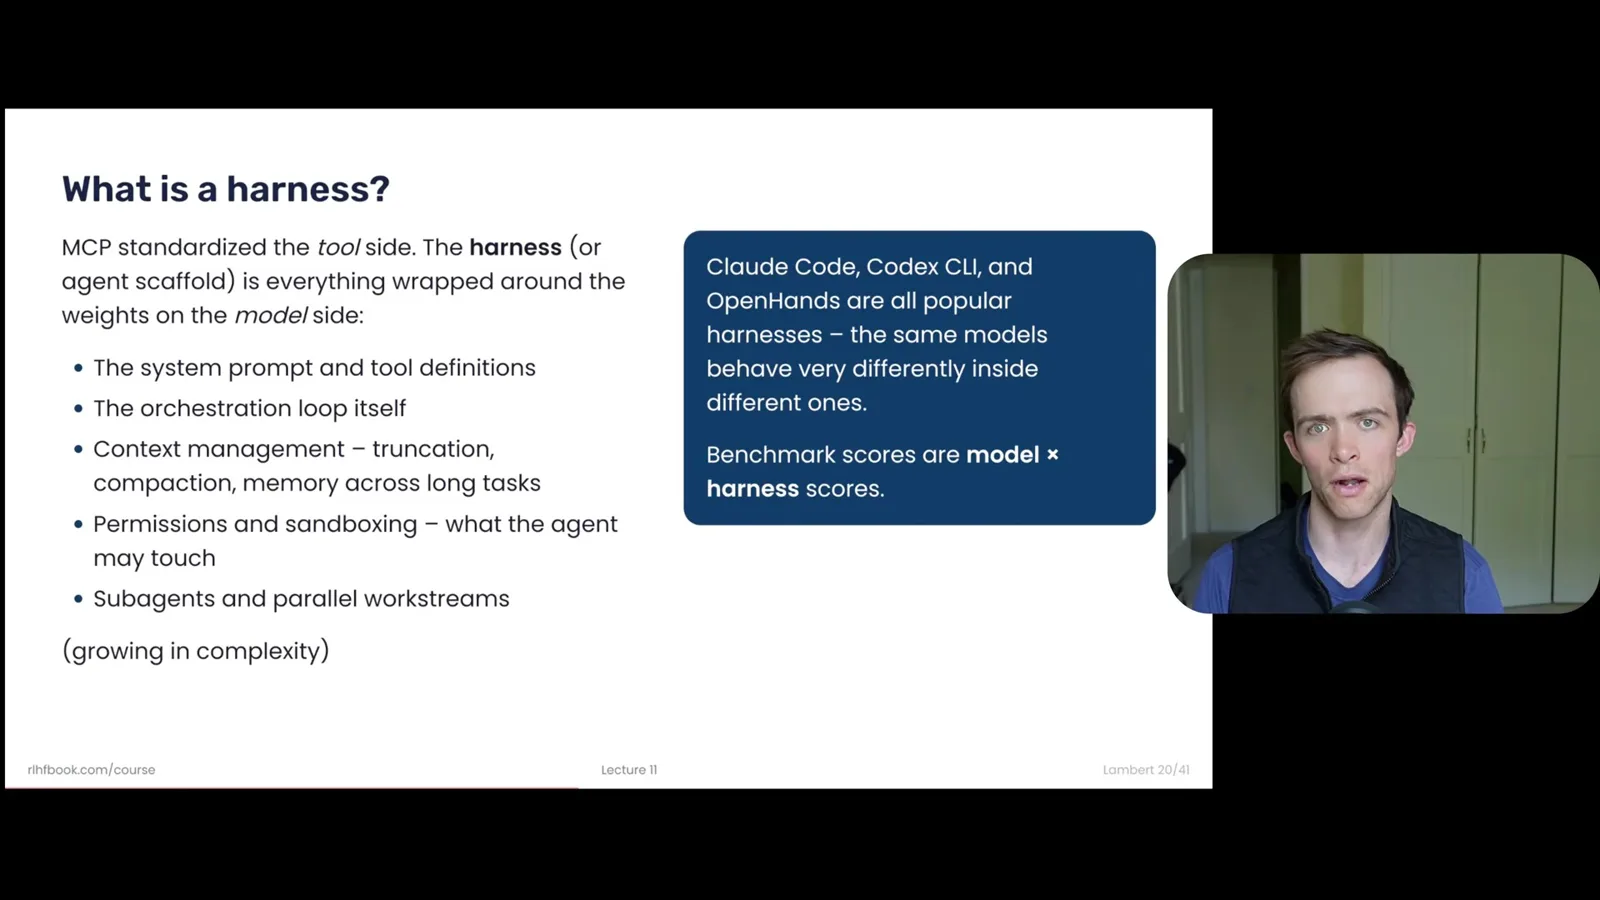
训练时,外部系统产生的工具输出通常会从模型的下一 token 损失中掩蔽。另一个设计选择是是否保留前面用户轮次的推理:丢弃可能提高效率,保留则可能保住有用上下文。训练和推理必须一致处理这些选择。
不同 API 的工具格式不同,可能使用 JSON、类似 XML 的标签或函数语法。模型的训练格式和服务格式需要一致。约束解码可以限制下一个 token 的选择,以保证格式有效;不过 Lambert 说,较新的模型已经更加可靠。对于长任务,上下文压缩也是重要的实现细节。
训练工具使用
监督轨迹和强化学习都依赖数据与环境。
训练工具使用让环境重新成为强化学习的核心。智能体可以反复与工具交互,再由验证器对结果评分。熟悉的后训练工具箱仍然适用:监督轨迹、偏好学习和强化学习都可以在不同阶段使用。
OpenThoughts-Agent 展示了监督工具轨迹背后的数据工作:寻找和混合任务、过滤提示词、选择教师、生成回答并过滤结果。即便流程图看起来简单,每个决定都很重要。Lambert 注意到其结果很强,也希望未来看到更多强化学习细节。
环境是智能体强化学习的瓶颈。有用的任务必须正确、可学习,同时又有挑战性;生成过于简单或根本无法解决的任务都很容易。T-MAX 生成了约 1.5 万个容器化终端环境,改变难度、人格和验证器,并丢弃不符合目标分布的数据。
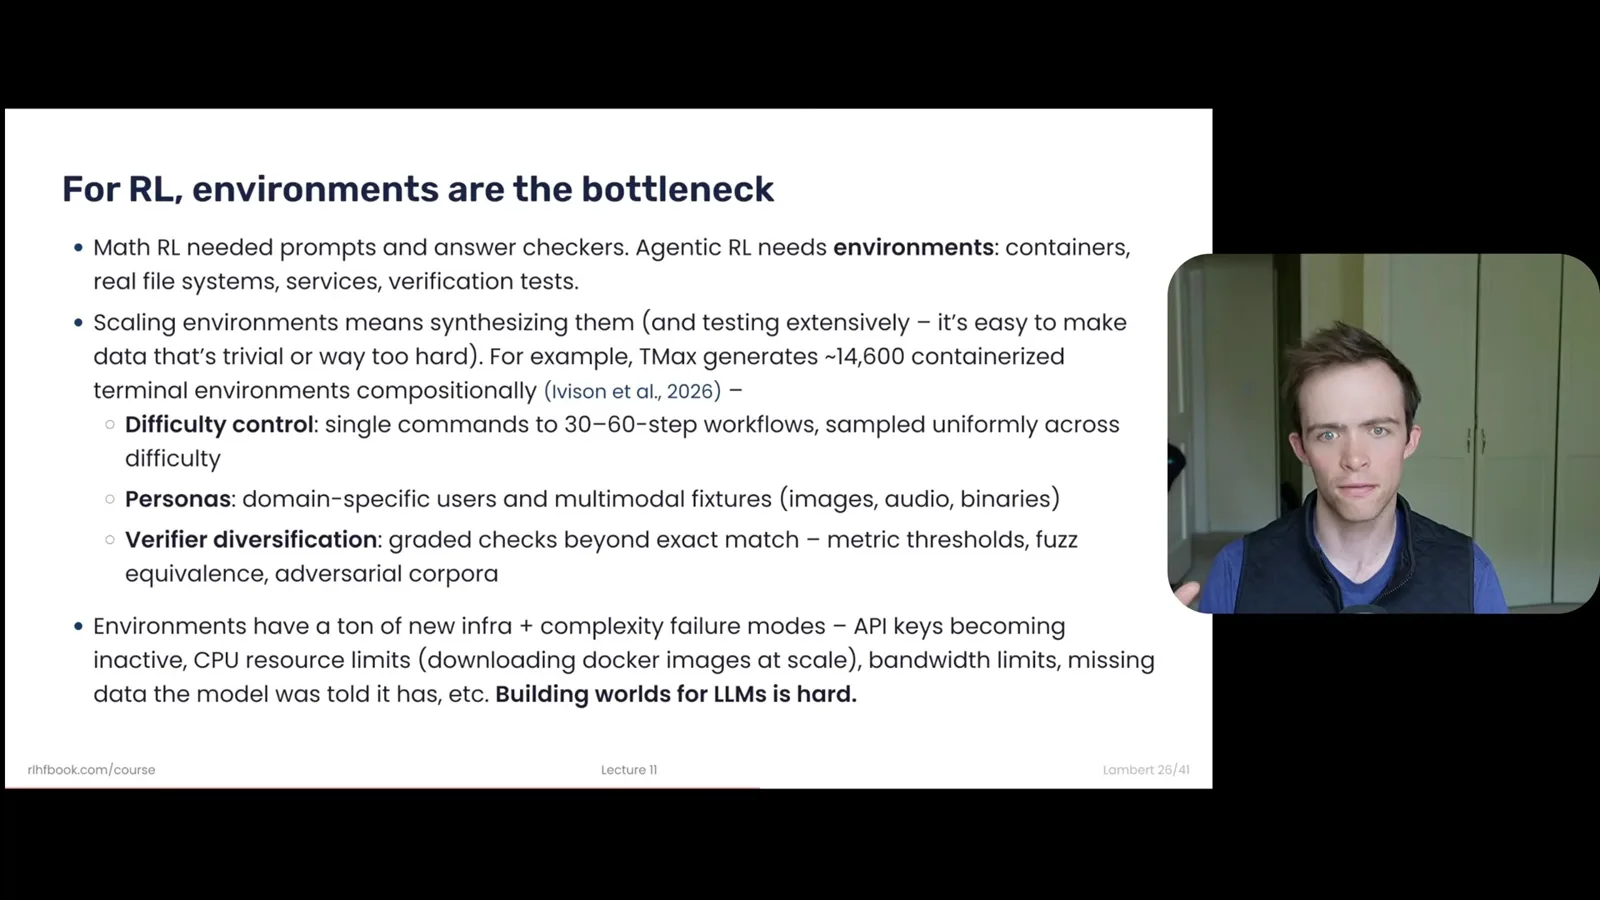
大规模运行环境会带来基础设施故障。数千个 CPU 沙箱可能需要容器镜像,带宽限制会让 GPU 闲置。缺失文件、过期 API 凭据等小错误都可能使轨迹无效。可扩展的沙箱基础设施因此成为训练问题的一部分。
扩展规模与开放挑战
稳定性、harness 依赖、奖励黑客和长轨迹使智能体强化学习变得困难。
Lambert 把 T-MAX 描述为一项开放工作,发布了模型、代码、数据和训练终端智能体的经验。与早期数学强化学习运行中分数可以稳定上升不同,漫长且多样的工具使用训练经常在几百步后崩溃。大量工作都用于维持稳定性。
不稳定的一个来源是生成轨迹的推理系统与进行梯度更新的训练系统之间的数值不匹配。基础设施和算法都必须考虑这种差异。Lambert 描述了一次具有代表性的 T-MAX 运行:两个训练节点、六个推理节点运行两到三天,另有沙箱费用。
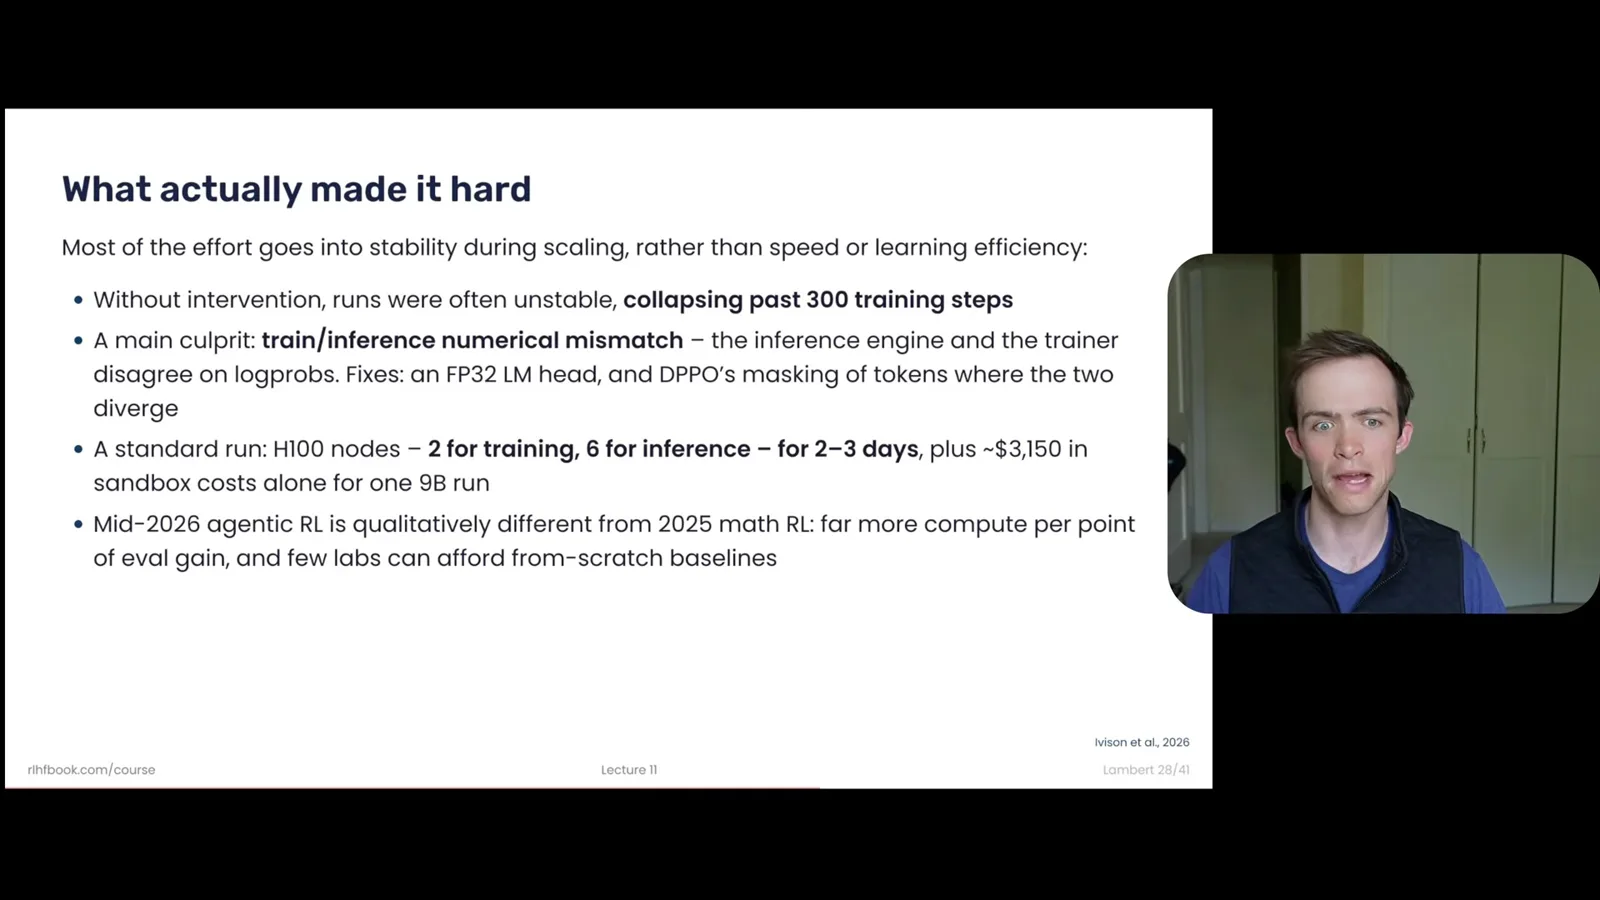
这与早期以数学为主的强化学习相比,成本性质不同;大量努力有时只能换来困难基准上一两分的提升。前沿报告越来越详细地讨论环境和沙箱,即使它们对具体强化学习算法披露得更少。
按照 Lambert 的描述,Kimi K3 报告显示,更多强化学习算力提高了分数,也增加了模型采取的行动次数。Kimi 和 NVIDIA 还讨论了使用多个 harness 训练:固定 harness 可能导致过拟合,而同一模型在不同外部软件中的分数可能差异很大。
专家领域带来另一个复杂因素。一个批次可能包含差异极大的工具任务,性能可能趋于饱和。多教师同策略蒸馏允许团队在不同领域训练专家,再把能力合并进最终模型,反映了智能体强化学习越来越复杂的现实。
随着工具轨迹变长、变复杂,奖励黑客问题重新出现。智能体可能操纵测试或环境的其他部分来获得奖励,却没有完成预期工作。评分规则、中间反馈和验证器为过度优化创造了新的机会。
长轨迹带来困难的信用分配和成本问题。如果一次尝试需要数小时,为每个提示生成多个样本就很昂贵,还可能让资源闲置。团队必须在算法选择、验证器设计和不断变化的 harness 之间取得平衡。
总体而言,工具扩展了权重的基本能力,而模型周围的软件和环境不可或缺。智能体强化学习仍处于早期:进步既需要研究,也需要让基础设施稳定、可扩展的大量基础工作。
同频道的其他文章
 16:48EN → 简体中文
 Nathan Lambert· 2026年11月2日Nathan Lambert:开放模型如何与前沿实验室竞争Nathan Lambert · Allen Institute for AI开放模型的用量正在增长,能力差距也在缩小,但开发者需要可持续的经济模式和价格之外的优势。
 48:04EN → 简体中文Nathan Lambert· 2026年10月26日Nathan Lambert:开放语言模型的历史、竞争与风险Nathan Lambert · Allen Institute for AI从开放权重、研究基础设施和蒸馏,到采用情况与模型开发者面临的选择。
 46:42EN → 简体中文Nathan Lambert· 2026年10月25日Nathan Lambert 与 Florian Brand 谈 Kimi K3.1、网络风险和 AI 智能体Nathan Lambert, Florian Brand · Allen Institute for AIInterconnects 主持人讨论模型评估的分歧、安全漏洞披露潮,以及个人智能体在日常生活中的作用。
 5:42EN → 简体中文Nathan Lambert· 2026年8月12日修格斯为何成了 AI 后训练的吉祥物Nathan Lambert · Allen Institute for AINathan Lambert 追溯了这种怪物从洛夫克拉夫特小说走向语言模型、微调与 RLHF 视觉隐喻的历程。
 32:56EN → 简体中文Nathan Lambert· 2026年8月6日Nathan Lambert:AI 角色训练入门Nathan Lambert · Allen Institute for AI从 constitution、model spec 到人格实验和激活引导,理解后训练如何塑造模型行为。
 32:11EN → 简体中文Nathan Lambert· 2026年8月5日Nathan Lambert:语言模型评估如何演变Nathan Lambert · Allen Institute for AI从少样本提示与 pass@k,到智能体沙箱、分数噪声和基准污染。