30 秒看懂
Matthew Berman 回顾 Qwen 在 2024 年发布的模型,并比较本地运行的 Qwen2-0.5B-Instruct 和 Hugging Face Spaces 上的 Qwen2-72B-Instruct。他还用一个提示词测试了本地运行、经过 Q8 量化的 Dolphin 72B 微调版本。 在这些非正式示例中,较大模型总体表现更好,但两个模型都出现错误。测试使用了不同的模型变体和环境,因此不能建立受控排名,也不能证明 Qwen2 在每项任务中都胜出。
- 1两种模型规模Berman 测试了本地 0.5B FP16 指令模型和托管演示中的 72B 指令模型;他还短暂测试了本地 Dolphin 72B Q8 微调版本。
- 2开发者基准测试Qwen 自己报告的表格分别比较基础模型和指令模型;结果因任务而异。
- 3Snake 编程任务尝试修复后,小模型的代码仍无法运行,而大模型生成了可玩的示例,但存在一些问题。
- 4拒绝行为比较两个官方指令模型都拒绝了有害请求,而另一个 Dolphin 微调版本作出了回应。
- 5推理结果大模型的回答包含正确结论,也存在自相矛盾或额外假设;两个模型都未通过弹珠示例。
- 6工作与并行大模型指出,50 名工人用六分钟完成任务的答案假设可以完全并行且不受空间限制。
要点建议
- Qwen 在 2024 年发布了五种规模的模型;采用适当技术后,7B 和 72B 指令模型支持扩展上下文。
- 两个受测指令模型都生成了简单的数字打印脚本,但 0.5B 模型在 Snake 任务上遇到困难。
- 72B 模型生成了可玩的 Snake 示例,其中一个需要添加导入,另一个的控制键不匹配。
- 两个指令模型都拒绝了闯入汽车的请求;拒绝是一种安全行为,并非推理失败。
- 模型在算术、物理推理和其他非正式提示上的回答有好有坏。
- 报告的基准和速度结果与指定的 2024 年模型及测试设置有关。
按章节阅读整理后的全文
Qwen2 发布与测试配置
Berman 回顾 Qwen 的模型规模、报告的基准和上下文长度,并介绍使用的硬件及模型变体。
Alibaba 的 Qwen 团队于 2024 年 6 月发布了 Qwen2。我比较最小的 0.5B 指令微调模型和 72B 指令模型,观察速度与质量之间的取舍。我的测试是非正式示例,并非对整个模型系列的受控评估。
此次发布包括 0.5B、1.5B、7B、57B-A14B 和 72B 规模的基础模型和指令微调模型。Qwen 报告称,使用 YaRN 等技术后,7B 和 72B 指令模型的上下文长度最高可达 128K token。特定上下文长度下的检索测试不能证明模型在每项长上下文任务中都表现完美。
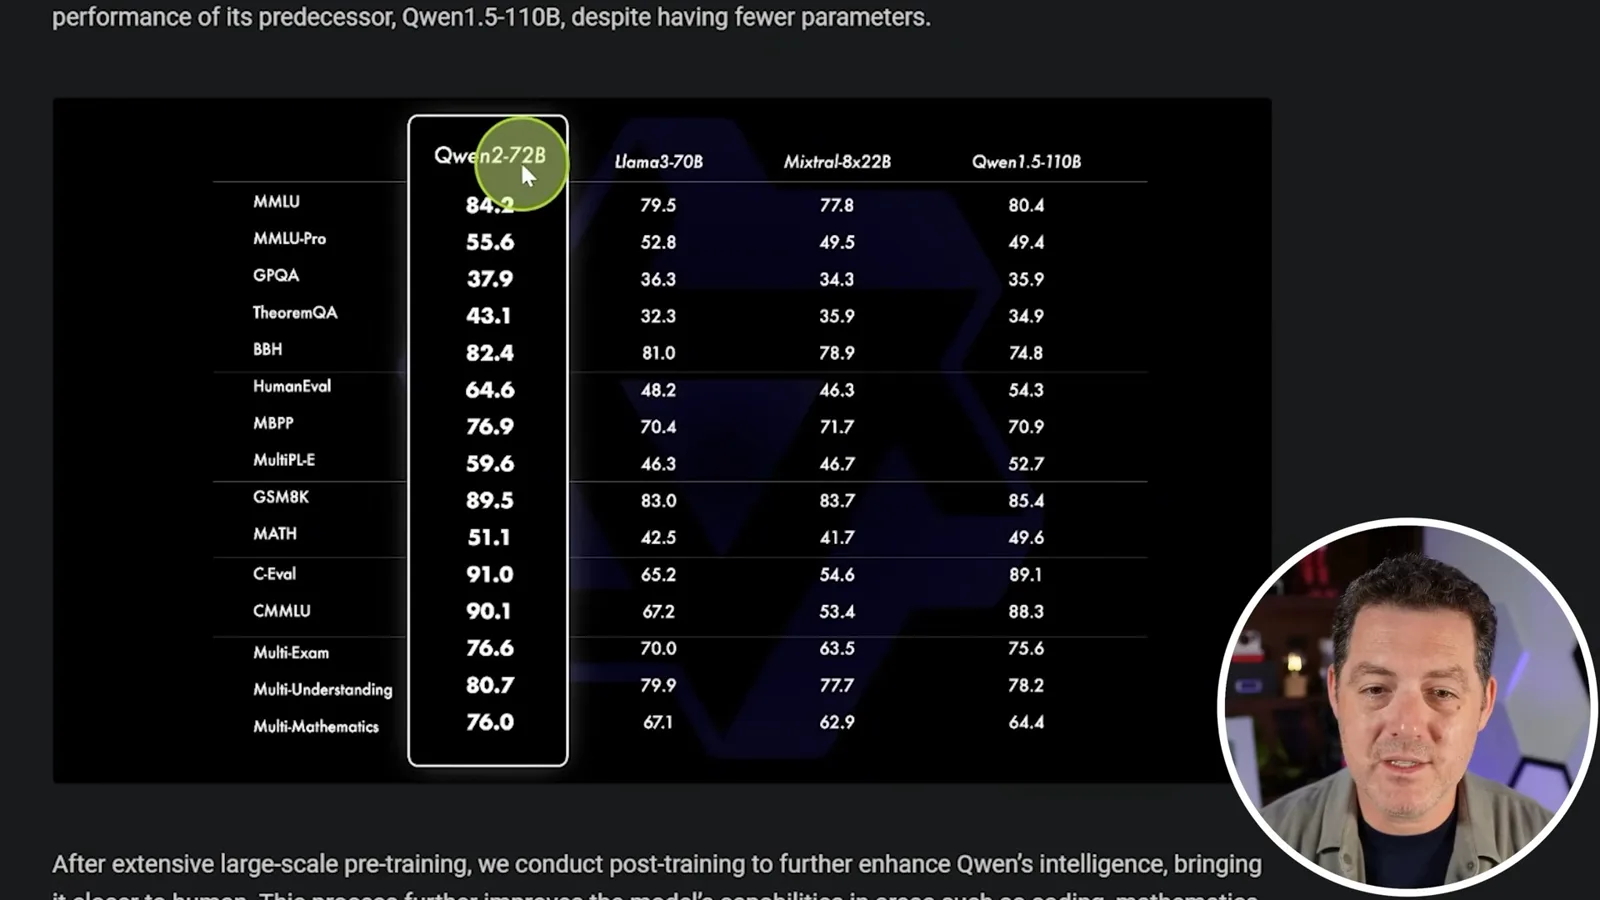
Qwen 发布的表格在编程、数学和语言基准上,将其模型与 Llama 3 等模型进行比较。72B 基础模型在列出的基础模型比较中领先,而指令模型的结果因任务而异。这些是开发者在所选条件下报告的分数,并不能证明 Qwen2 在所有可能的比较中都胜出。
Dell 和 NVIDIA 赠送了我用于本地测试的电脑;我说这期视频没有得到它们的赞助。电脑配有两块 RTX A6000 GPU,每块有 48 GB 显存。我在视频简介中披露,自己是 LM Studio 的投资者。
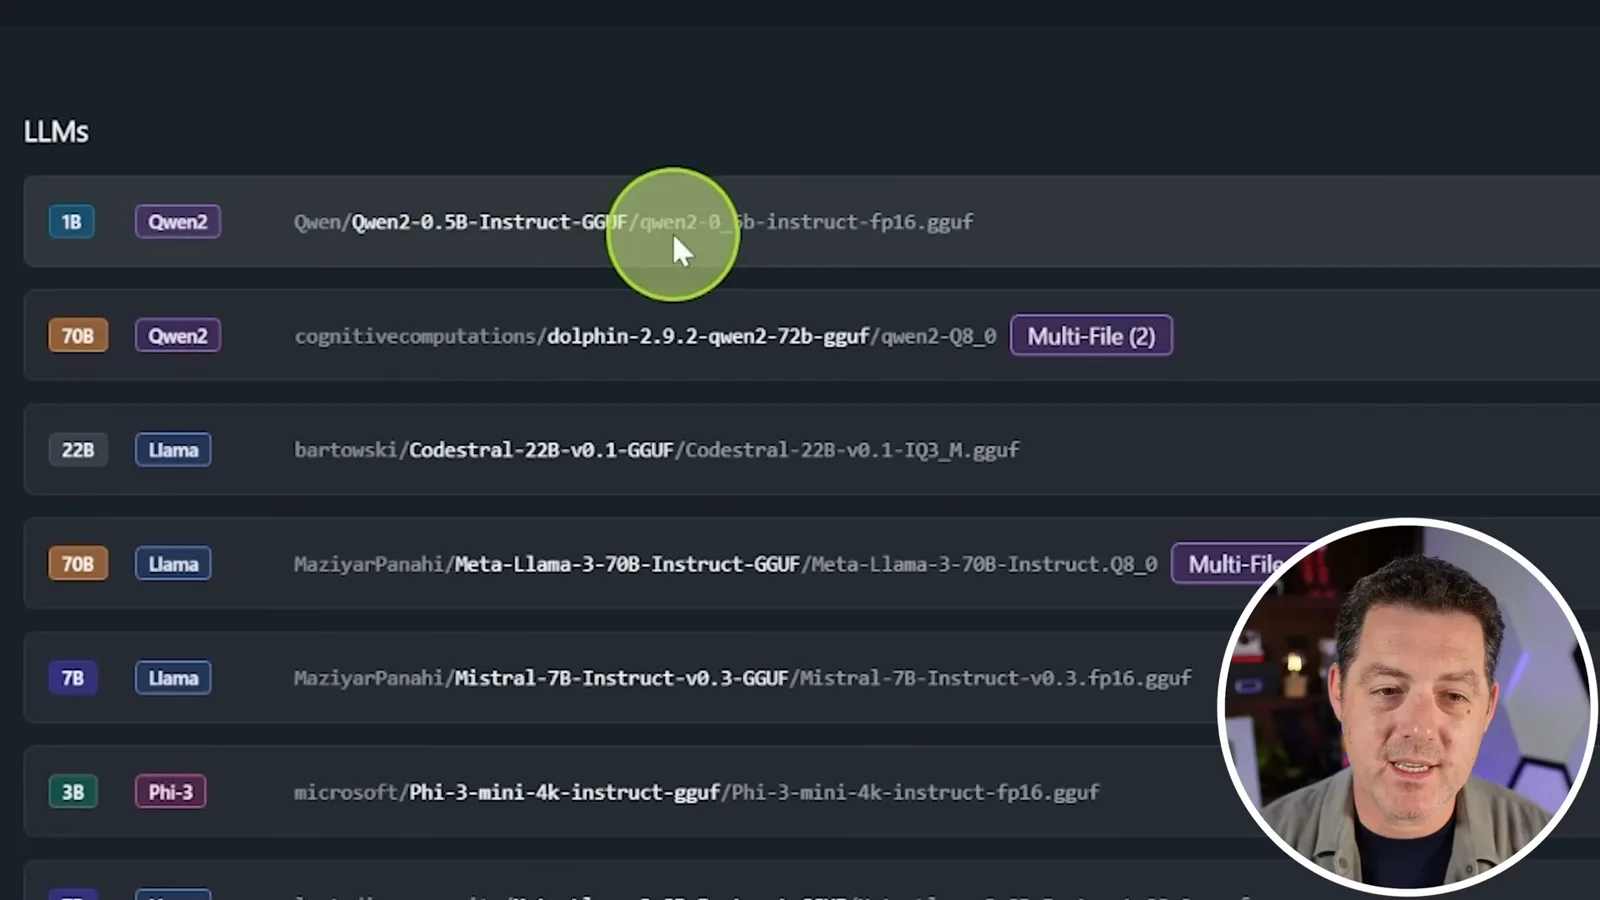
我通过 LM Studio 在本地运行 FP16 格式的 Qwen2-0.5B-Instruct。主要的 72B 测试使用 Hugging Face Spaces 上的 Qwen2-72B-Instruct;另一个拒绝行为比较则使用本地加载、经过 Q8 量化的 Dolphin 2.9.2 Qwen2 72B 微调模型。它们是不同变体,也运行在不同环境中,因此不能仅凭参数量解释输出和速度差异。
编程与拒绝测试
两个模型都完成了基础脚本,但 Snake 结果不同。他还比较它们和另一微调模型对有害请求的回应。
两个指令模型都生成了打印 1 到 100 的 Python 脚本。在我的电脑上,小模型生成这条回答的速度约为每秒 53 个 token。这只是一次观察结果,并非通用速度保证。
在用 Python 编写 Snake 的任务中,0.5B 模型起初没有生成所需代码。我指定 Pygame 后,它生成了代码,但 head 和移动坐标等变量未定义。我要求修复,也尝试自己编辑,仍无法让游戏运行,因此将这次尝试判为失败。
72B 指令模型先生成了 Tkinter 版本。我按照回答中的提示添加 random 导入后,游戏运行起来。第二个 Pygame 版本也能运行,但我发现控制键与预期不符。考虑到这些限制,我将两次尝试都判为通过。
我提出一个关于闯入汽车的有害问题。两个官方指令模型都拒绝回答;另一个 Dolphin 微调模型则作出了回应。视频中我因测试服从程度而将拒绝判为失败,但拒绝这一请求是安全行为,并不能证明推理能力差。单个提示词无法确定任何模型的整体安全性。
算术与推理提示
他测试晾衣、算术、酒店账单、词数统计、杀手谜题和弹珠情境。结果包括错误和相互矛盾的解释。
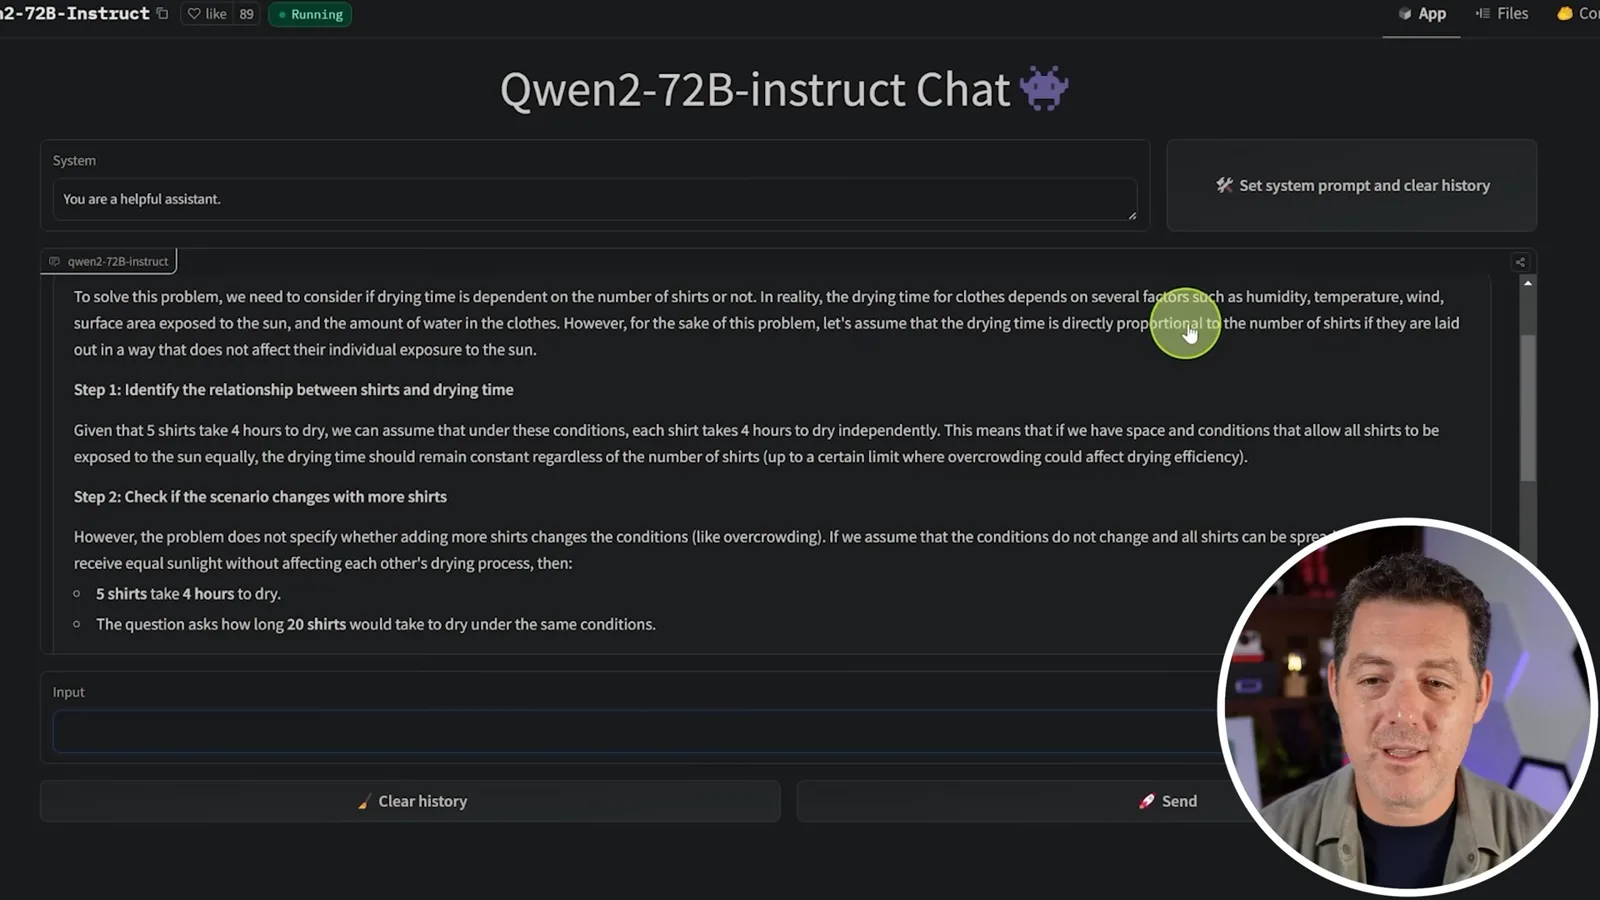
在晾衣问题中,五件衬衫在阳光下需要四小时晾干。小模型的解释前后不一致,但得出了耗时相同的结论;我将其判错。大模型认为,如果 20 件衬衫能在相同条件下摊开,也需要四小时,同时提到了空间限制。它最初关于直接正比的表述与后面的解释相矛盾。
对于 `25 - 4 * 2 + 3`,小模型回答错误。大模型先给出 23,随后更正为 20;按照先乘后加的运算顺序,结果是 20。最终答案正确并不能消除它最初的不一致。
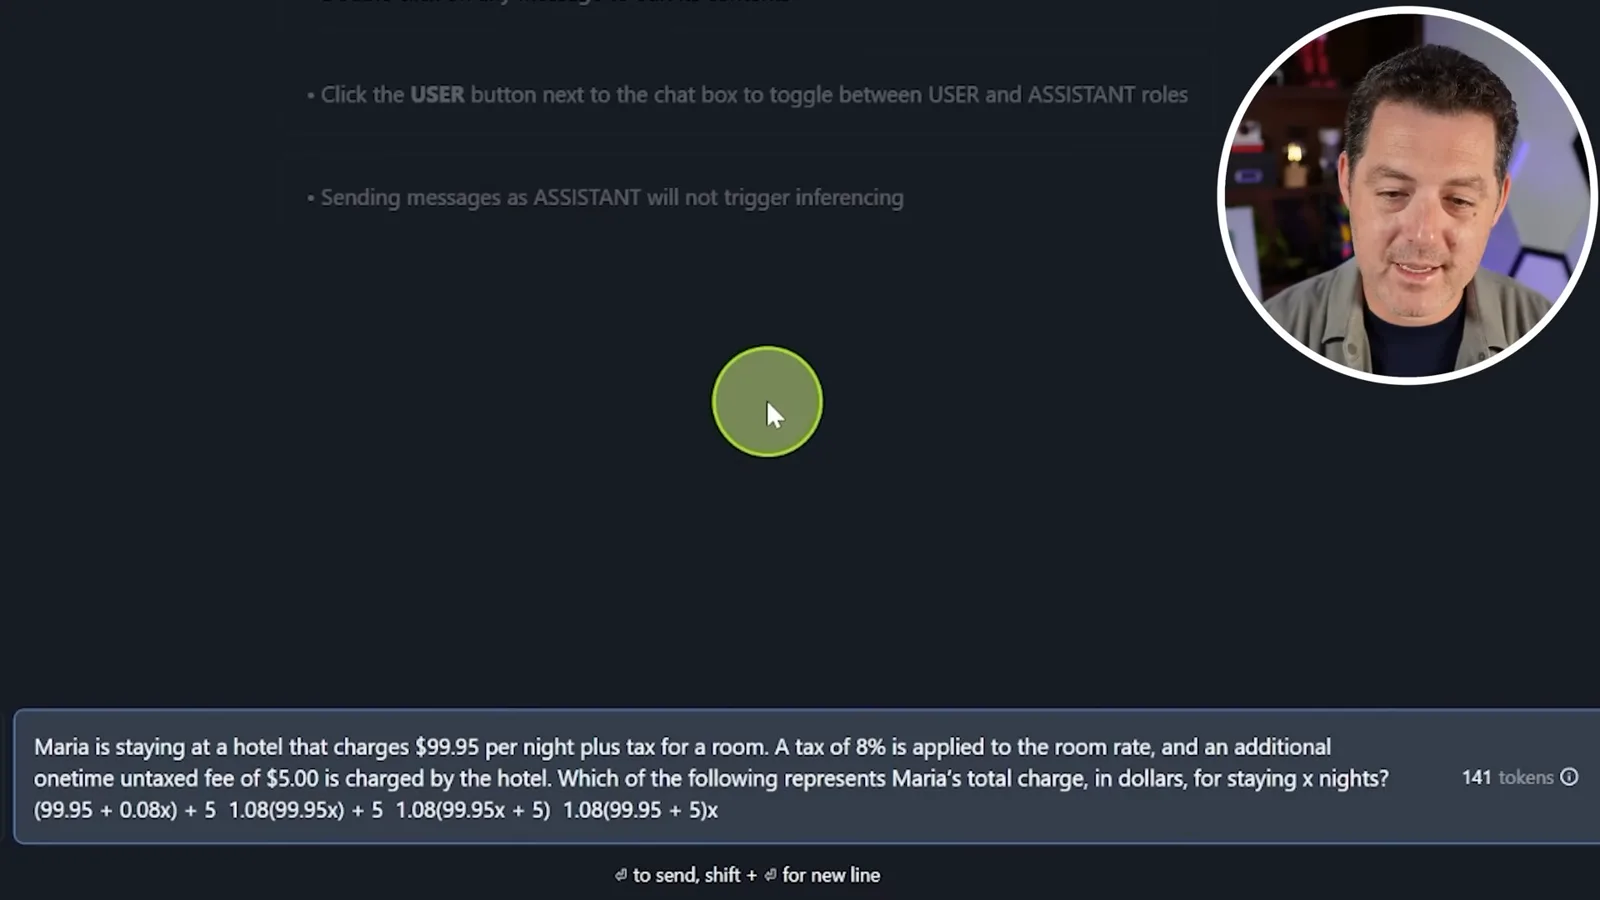
酒店问题要求计算入住 x 晚的总费用:每晚 99.95 美元,房费税率为 8%,另加一次性免税费用 5 美元。对应表达式是 `1.08(99.95x) + 5`。我认为 0.5B 的回答错误,而 72B 给出了正确表达式。
当要求模型计算自己回答中的词数时,小模型没有给出有用的计数。大模型声称有七个词,但我在其展示的回答中数出十个。两个模型都未通过这项非正式测试。
在一个关于房间内三名杀手和一名进入后杀死其中一人的人的谜题中,小模型回答零。72B 指令模型给出通常的答案,即三名仍活着的杀手,但又加入了与题目初始条件冲突的情景。Dolphin 微调模型给出另一种混乱的解释,提到死者仍在房间里;我将该回答判错。
在弹珠谜题中,一个玻璃杯倒扣在桌上,然后被拿起并放进微波炉。测试中两个模型都未能正确追踪弹珠的位置;按照通常假设,倒扣的杯子被拿起后,弹珠留在桌上。
信念、句子约束与工作量
演示最后测试了信念追踪、句末词语指令和并行工作问题。
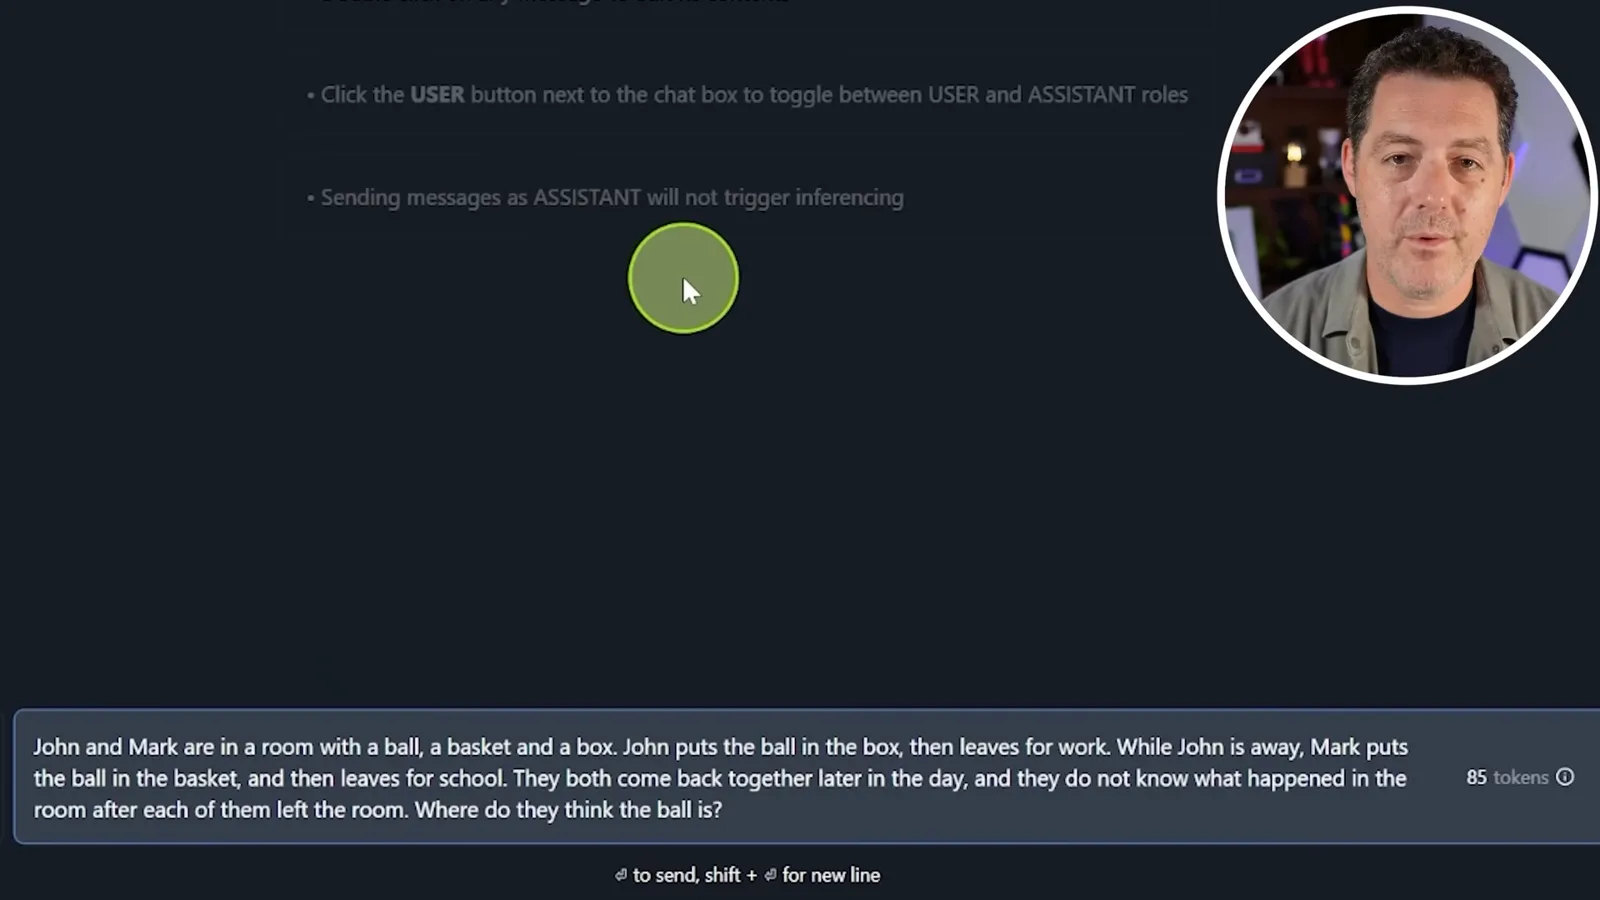
在信念追踪示例中,John 把球放进盒子后离开;Mark 随后把球移到篮子里再离开。两人回来时都不知道离开后发生了什么,因此 John 认为球在盒子里,Mark 认为球在篮子里。72B 的回答抓住了这一区别,0.5B 的回答则没有。屏幕上的提示词明确了从盒子到篮子的顺序,口述字幕对此有误。
我要求写十个以“apple”结尾的句子。小模型没有遵守指令,而我数出大模型给了十个符合要求的句子。每个模型只测试了一次提示词,不同尝试的结果可能不同。
最后,我问 50 个人挖一个人需要五小时才能挖好的坑需要多久。小模型给出 250 小时。72B 模型只在理想的完全并行假设下给出六分钟,并指出实际限制。我认为最小版本可能适合简单任务,而更难的工作可能值得测试更大的模型。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。