30 秒看懂
AI Explained 解读 Phi-1 论文及与合著者 Ronen Eldan 的交流。视频认为精选和合成训练数据可以改善小型代码模型,也讨论了模型局限、安全与推测性的时间表。
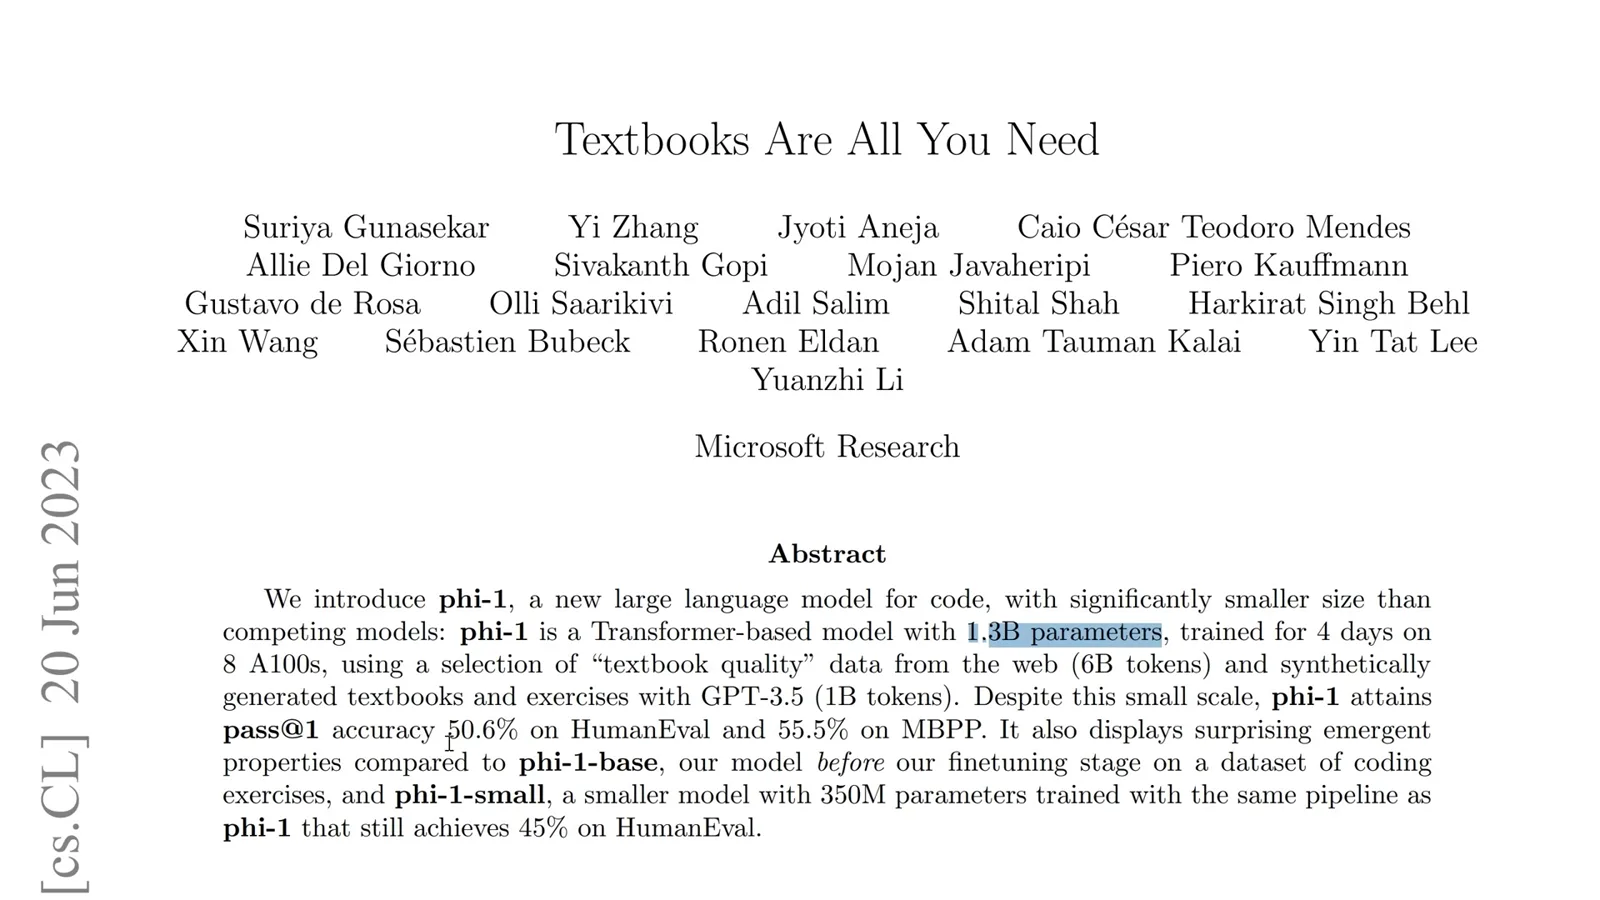
- 1小模型与代码基准这个 13 亿参数模型报告在 HumanEval 上达到 50.6% 的 pass@1。
- 2精选数据和练习训练配方结合筛选代码、合成教材与练习。
- 3重复训练对比包括在现有数据上增加训练轮数。
- 4专用模型的局限模型专注 Python,对提示词变化较敏感。
- 5安全与时间表讲解者及被引用的研究者讨论风险并作出不确定的预测。
要点建议
- 这个 13 亿参数模型报告在 HumanEval 上达到 50.6% 的 pass@1。
- 训练配方结合筛选代码、合成教材与练习。
- 对比包括在现有数据上增加训练轮数。
- 模型专注 Python,对提示词变化较敏感。
- 讲解者及被引用的研究者讨论风险并作出不确定的预测。
按章节阅读整理后的全文
Phi-1 为何重要
讲解者介绍这个小型代码模型及其 2023 年的背景。
Phi-1 值得关注,不只是因为这个小模型能完成 Python 编程任务,也因为它引出了语言模型未来发展和人类水平智能时间表的问题。我与论文合著者 Ronen Eldan 交流过这些结果。以下是 2023 年的判断,并非确定的预测。
Phi-1 有 13 亿个参数,约为 GPT-3 的百分之一。论文报告它在 Python 编程基准 HumanEval 上达到 50.6% 的 pass@1。Andrej Karpathy 认为,未来对小型专家模型的创新可能更加重视数据质量和多样性,而不只是数量。
数据质量与合成教材
训练配方借鉴 TinyStories,并使用精选的教学数据。
论文把数据质量作为除算力和数据量之外的另一条改进路径。此前的 TinyStories 研究用 GPT-3.5 和 GPT-4 生成短篇故事,再用精选样本训练很小的模型。讲解者将这些模型的故事结尾与参数更大的 GPT-2 作比较。
Phi-1 团队筛选了 The Stack 和 Stack Overflow 中有教学价值的代码,得到约 60 亿个 token;又用 GPT-3.5 生成约 10 亿个 token 的 Python 教材数据,以及约 1.8 亿个 token 的练习和解答。Eldan 认为,现有数据的价值远未被充分挖掘。
比较结果说明什么
图表区分模型规模、数据重复和练习微调的影响。
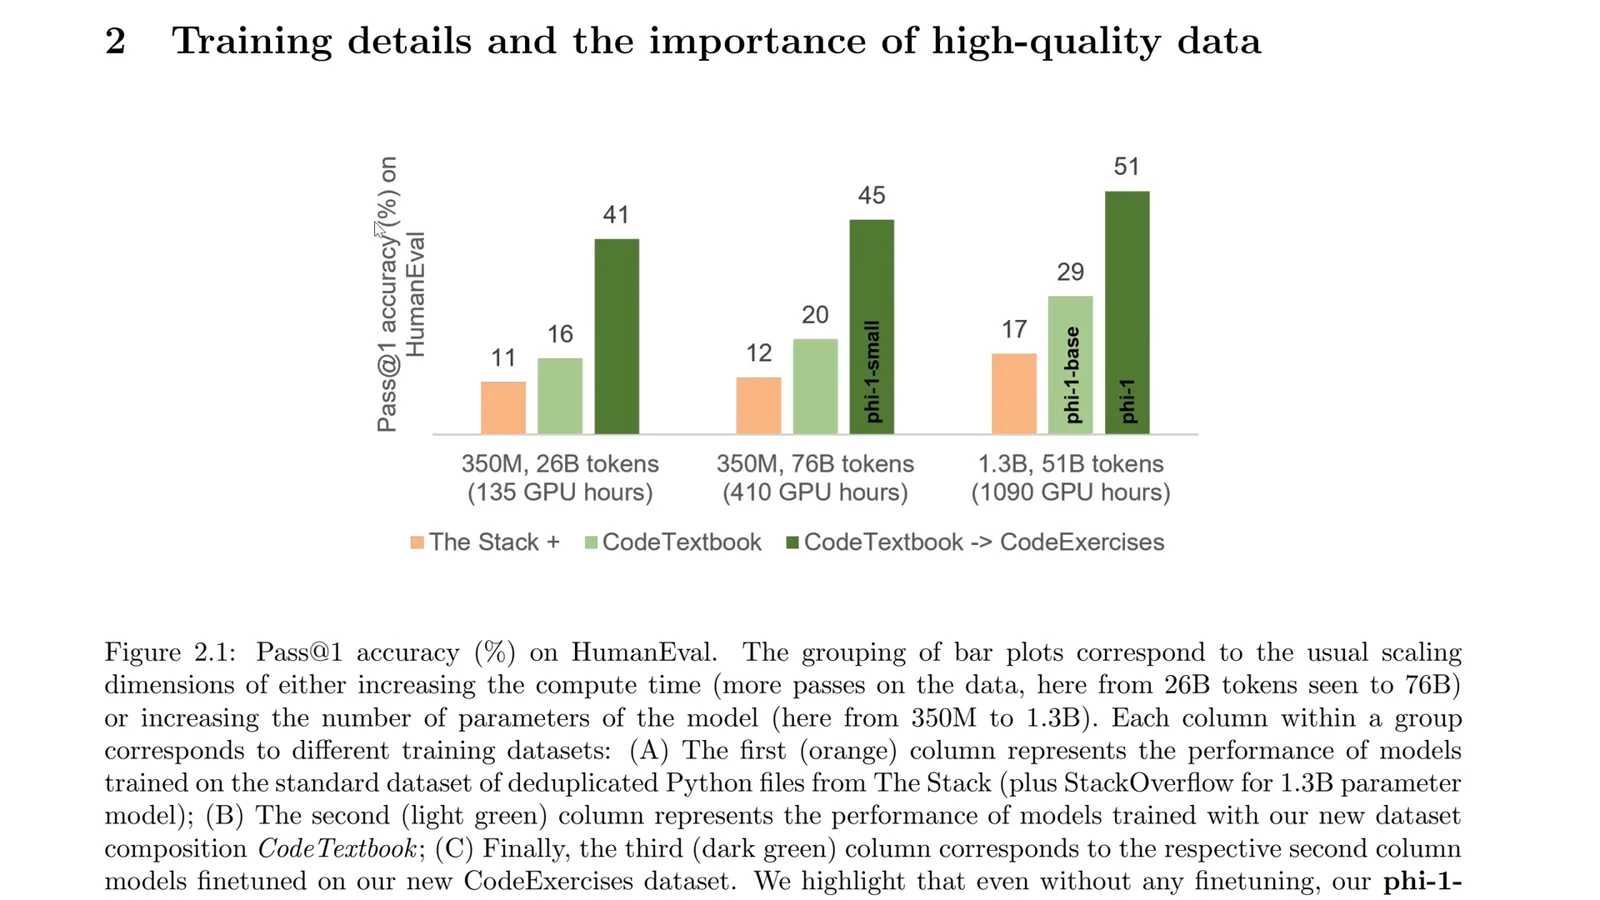
一张图比较了不同模型规模、算力预算和训练配方。与只使用筛选后的代码相比,加入合成代码教材提高了 HumanEval 成绩;再用练习微调,又带来大幅提升。例如,图中的 13 亿参数模型从 17% 升至 29%,再升至约 51%。
较小模型还展示了重复使用同一数据:尽管数据集本身更小,训练中见到的 token 数从 260 亿增加到 760 亿。Eldan 说,一些研究者原本以为超过一两轮训练就会过拟合。讲解者引用另一项研究,指出少量重复仍可能有用,但重复很多轮后收益会递减。
作者假设,嘈杂、有歧义且不完整的代码数据会增加学习自然语言到代码映射的难度。精选的练习及解答则提供更清晰的教学信号,就像学生从好的练习材料中获益一样。
筛选与局限
GPT-4 帮助筛选教学样本,而训练出的模型仍然较专用。
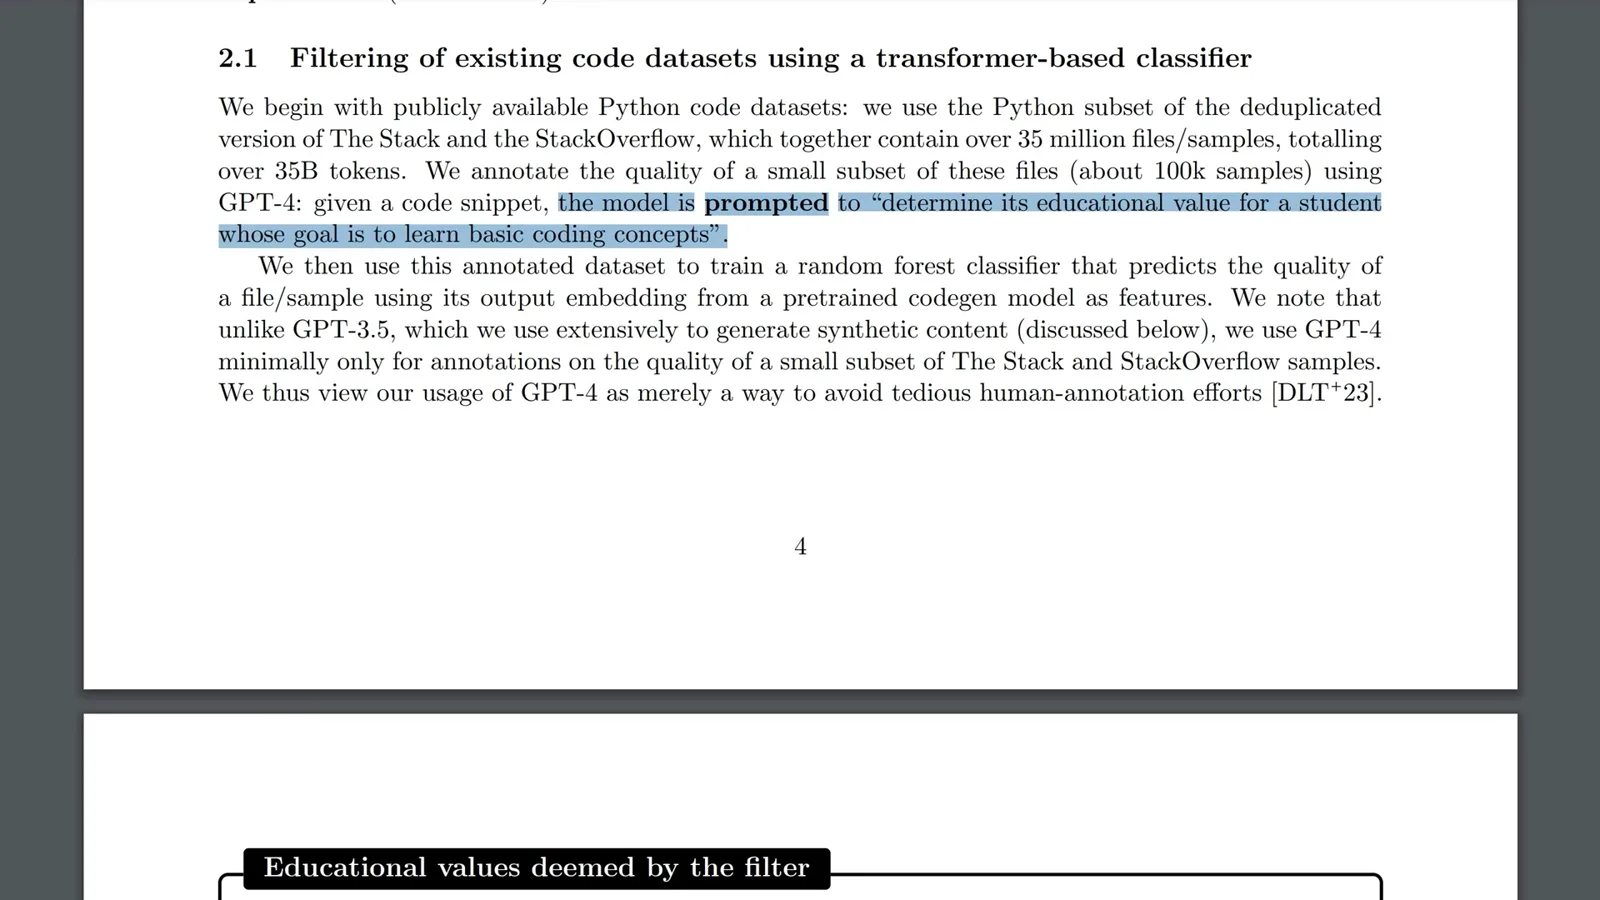
为了筛选原始材料,研究者用 GPT-4 标注约 10 万段代码的教学价值,再利用代码嵌入训练随机森林分类器。讲解者设想把类似筛选方法用于其他任务,但这些是可能性,而不是已经证明的结果。
Eldan 说,强大的模型既能直接发挥作用,也能帮助构建更好的小模型。讲解者希望领先的 AI 实验室正视这一能力。他还指出,代码练习微调意外改善了一些未直接覆盖的任务,包括使用练习集中没有出现的库。
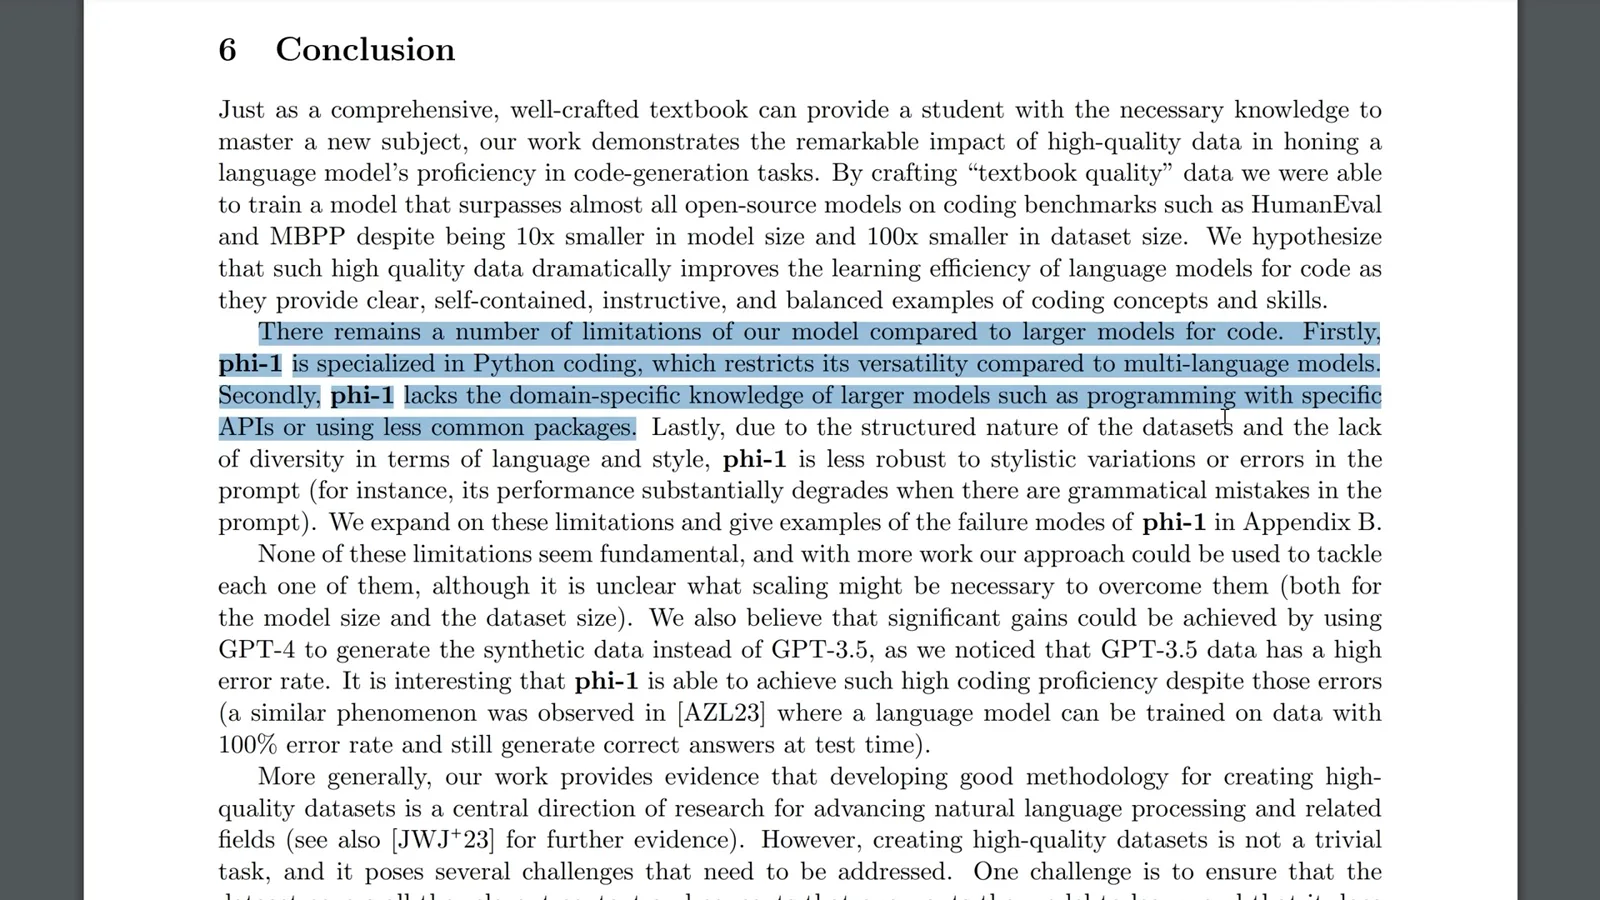
Phi-1 存在重要局限:它专攻 Python,对某些领域特定 API 和软件包了解不足,而且面对提示词风格变化或错误时不够稳健。作者认为 GPT-4 生成的合成数据可能改善结果;Eldan 则说 GPT-4 更慢、成本更高,他们也希望展示 GPT-3.5 的能力。
小模型、安全与时间表
讲解者比较相关研究,并讨论不确定的未来情景。
讲解者把规模大得多、通过增加训练题目难度来训练的 WizardCoder 与 Phi-1 等重视数据设计的研究相比较。他讨论 Sarah Constantin 的设想:许多专用小模型可能与更大模型的持续进步并行发展,从而改变经济激励。
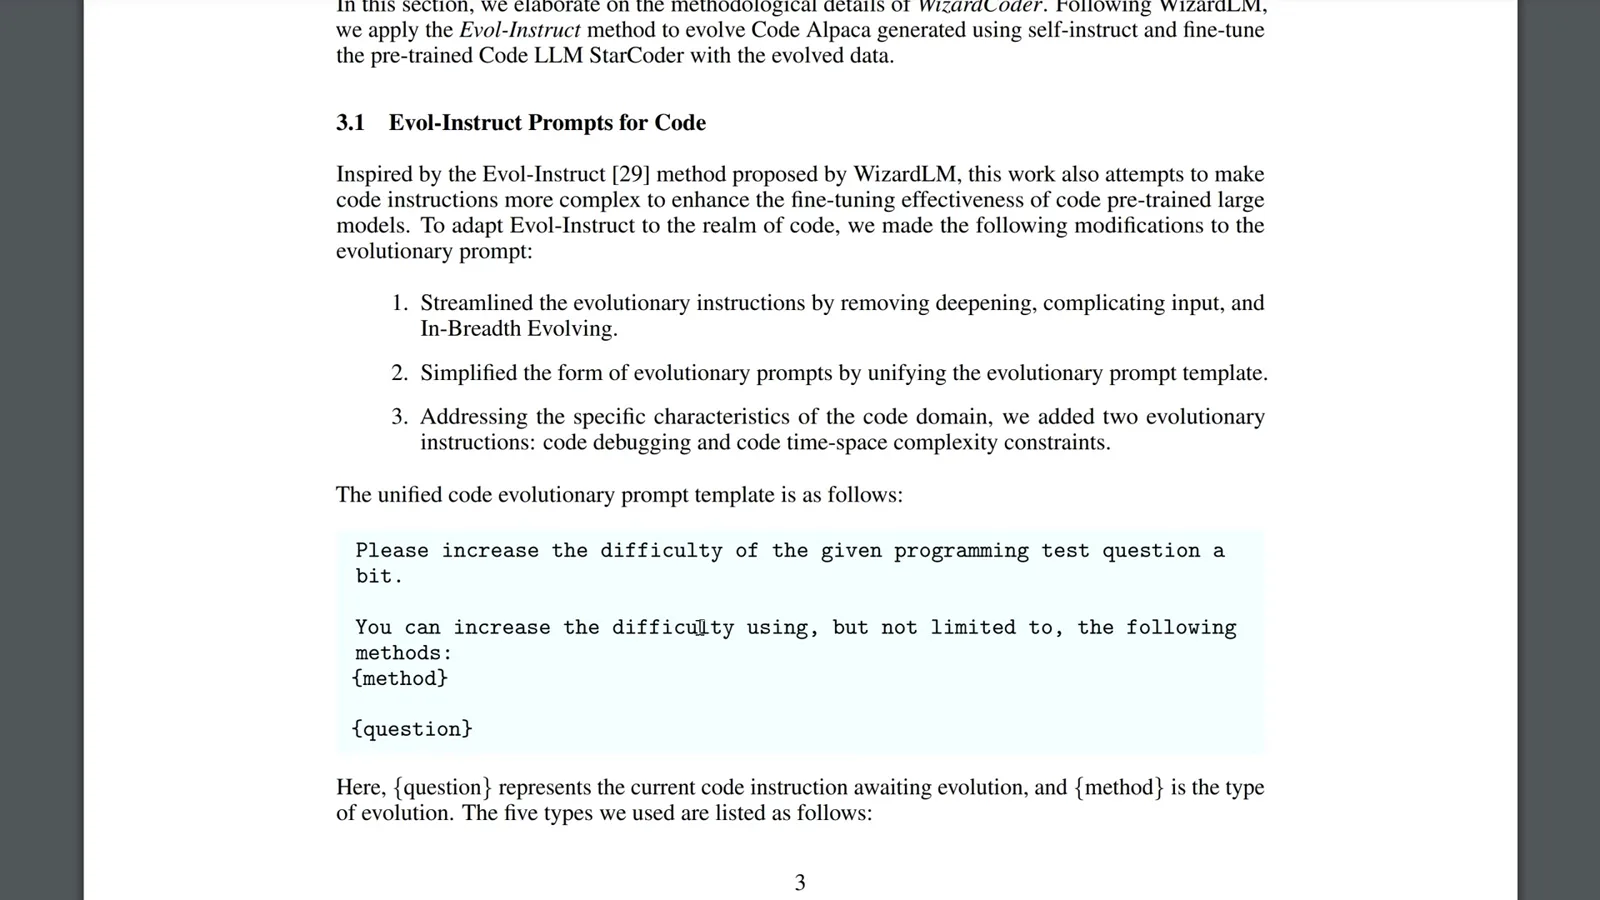
谈到安全时,他质疑暂停大型算力项目是否只会促使公司从现有资源中挖掘更多能力。他主张围绕具体风险开展公共讨论,并引用研究对生物设计工具被滥用的担忧。这些是风险情景,并非已发生的结果。
在交流中,讲解者和 Eldan 推测变革性 AI 可能在几年内出现,但这取决于投入训练的资源。Eldan 提到 GPU 生产、数据中心、电力、数据质量和算法等可能的限制。讲解者承认,人们对 AGI 的定义各不相同。
一段 Carl Shulman 的访谈讨论了另一种可能:如果 AI 硬件带来很高的经济回报,或许可以支持芯片制造的快速投资,并协助工程工作。他也提出相反的情景:即使投入巨大,扩展和研究收益仍可能停滞。
Shulman 认为,经济资源向 AI 的快速转移不可能永远持续。如果当前扩张无法产生所需能力,后续进步可能更多依赖整体经济增长和人口增长等较慢的因素。他把较多概率放在未来十年的看法是一项预测,而非保证。
同频道的其他文章
 31:00EN → 简体中文
 AI Explained· 2026年10月12日为什么 AI 实验室自己警告会出重大事故,却还在继续竞赛Sam Altman, John Schulman · OpenAIAI Explained 梳理正在变弱的安全防护、前沿竞赛背后的激励,以及研究突破为何让未来 18 个月更难预测。
 38:28EN → 简体中文AI Explained· 2026年10月1日AI Agent 安全与递归自我改进的挑战AI Explained 讨论报道中的隔离失效、模型评估,以及加速 AI 研究带来的压力。
 32:54EN → 简体中文AI Explained· 2026年9月24日Opus 5.5 与自动化 AI 研究的竞赛AI Explained 在模型进展之外,讨论评估和治理递归自我改进日益困难的挑战。
 24:53EN → 简体中文AI Explained· 2026年9月16日为何一些研究者呼吁放缓前沿 AI 发展AI Explained 梳理可能的扩展方向、监测方面的担忧,以及能力如何可能带来危害的争论。
 29:05EN → 简体中文AI Explained· 2026年9月4日GPT-6 Astra 的评测进步与推理监控难题AI Explained 考察科学、数学和智能体评测中的报告成绩,也讨论模型推理越来越难以观察所带来的担忧。
 23:41EN → 简体中文AI Explained· 2026年8月27日AI 智能体、非预期训练奖励与监督难题AI Explained 分析智能体协作、训练激励,以及越来越多地使用 AI 评估其他 AI 系统的报告。