30 秒看懂
Nathan Lambert 从 KL 正则化奖励目标和成对偏好模型推导 DPO,并解释似然位移、DPO 变体、偏好数据的重要性,以及与强化学习之间的实际权衡。
- 1更简单的偏好流水线DPO 将偏好学习合并为可以直接求导的损失。
- 2正则化最优策略归一化后,奖励加权的参考策略是理想化目标的解。
- 3成对偏好损失两个回答共享提示词时,配分函数会相互抵消。
- 4似然位移即使选中回答的概率下降,偏好间隔也可能改善。
- 5DPO 与强化学习两种方法在实现简单性、探索能力和基础设施成本之间权衡。
要点建议
- DPO 直接根据偏好对训练,无需单独的奖励模型和强化学习循环。
- 其推导把正则化最优策略与 Bradley–Terry 偏好模型联系起来。
- 偏好间隔扩大并不保证选中回答的概率提高。
- 合成及同策略偏好数据对结果的影响可能与算法选择同样重要。
- DPO 易于上手;强化学习可以探索更多,但需要更多资源。
按章节阅读整理后的全文
DPO 为什么重要
DPO 让更多开放模型研究者能够开展偏好训练。Lambert 将它放回更大的后训练流水线中。
直接偏好优化,也就是 DPO,是后训练工具箱中的重要方法。本讲将推导它的目标并介绍相关方法。即便注意力转向智能体强化学习,理解 DPO 仍能帮助我们认识改变模型行为的另一种方式。
2023 年 DPO 论文发表时,开放研究项目正发现完整 RLHF 流水线很难运行。更简单的训练方式让更多人能够开展偏好优化,尽管开放模型仍花了几个月才找到实际可用的设置和数据。
Lambert 回忆,Zephyr 和 Tülu 2 等早期开放模型帮助展示了 DPO 的实用性。他把直接针对成对偏好数据训练的整类方法称为直接对齐算法,尽管这个名称没有得到普遍采用。
关于 DPO 与强化学习孰优的争论持续了多年。我的实际答案是两者都是工具。DPO 直接从偏好对学习,不需要单独的奖励模型和强化学习循环,因此更容易起步;完整的后训练方案也可以结合多种方法。
推导分为四步:求出正则化 RLHF 目标的最优策略,反推出对应奖励,将其代入 Bradley–Terry 偏好模型,再构造损失和梯度。最终实现比推导短得多。
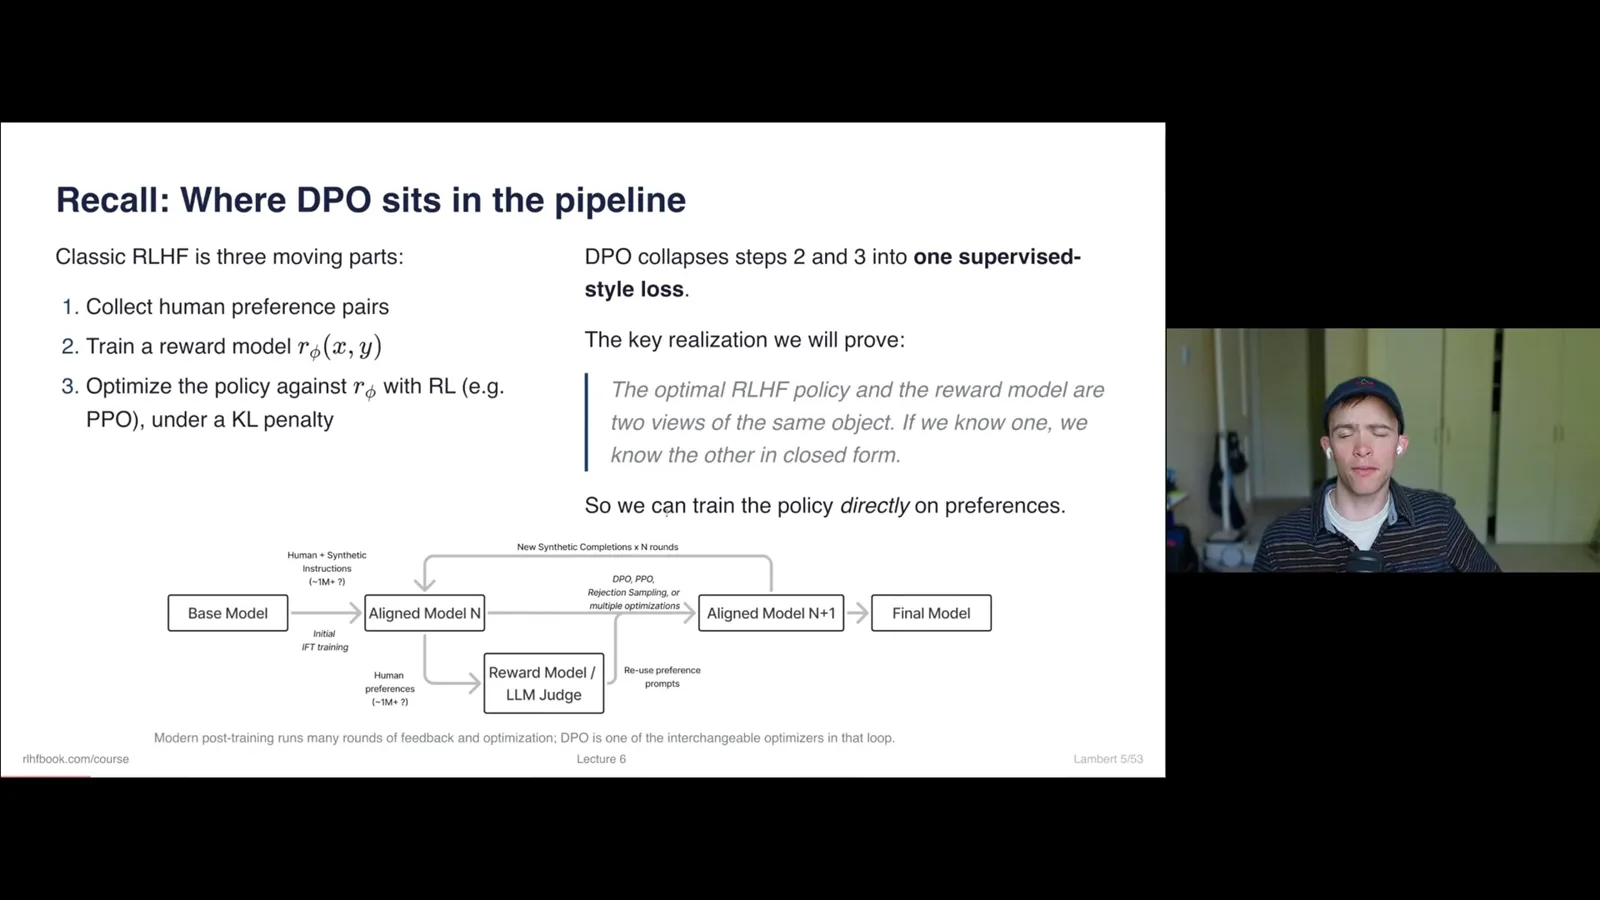
经典 RLHF 使用偏好对训练奖励模型,再针对它优化策略。DPO 将这些步骤合并为类似监督学习的偏好损失。实际流水线可能包含多轮数据生成、评估和优化,DPO 只是其中一个组件。
推导最优策略
KL 正则化奖励目标可以改写为归一化的奖励加权参考分布。Gibbs 不等式给出最优解。
从一个策略开始:它最大化期望奖励,同时惩罚与参考策略之间的 KL 散度。参数 beta 控制两者的权衡。提示词来自数据集,回答从策略中采样。
展开 KL 项,将最大化改写为最小化,并重新组合期望。利用对数和指数恒等式,可以把奖励与参考策略项合并为一个类似 KL 散度的表达式。
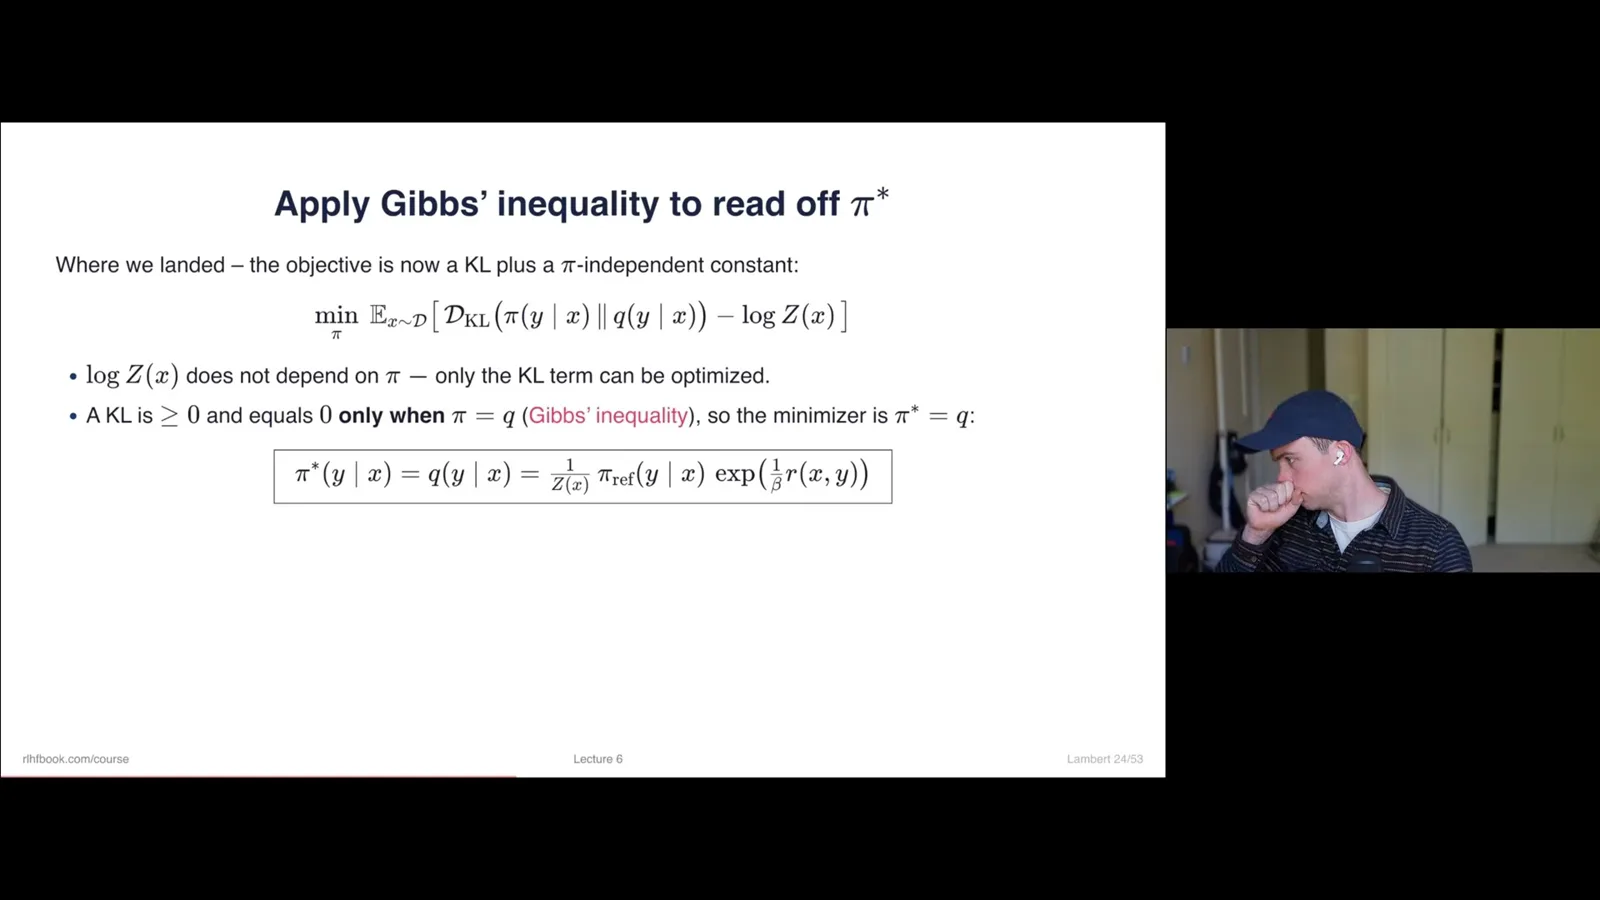
Gibbs 不等式告诉我们,当两个分布相同时,KL 散度达到最小值。但奖励加权的参考项尚未归一化,并不是有效概率分布,因此不能直接应用这个不等式。
针对每个提示词引入配分函数 Z,对奖励加权参考策略进行归一化,就得到有效分布 q。Lambert 强调,正是归一化让后面的 KL 论证成立。
加上并减去对数配分函数,重新排列各项,便能识别出候选策略到 q 的 KL。剩余的 log Z 依赖提示词,却不依赖正在优化的策略,因此不会改变使目标最小化的策略。
结果是最优策略等于参考策略乘以指数形式的奖励权重,再由 Z 归一化。更高奖励会提高回答的相对权重,beta 则控制正则化强度。
从隐式奖励到损失
策略隐含一个奖励;将其代入 Bradley–Terry 模型便得到成对损失。自动微分负责计算梯度。
接下来对最优策略等式取对数并重新排列,将奖励表示为策略与参考策略的对数比值,加上一个依赖提示词的归一化项。这就是语言模型能够表示隐式奖励的含义;DPO 并没有训练单独的奖励模型。
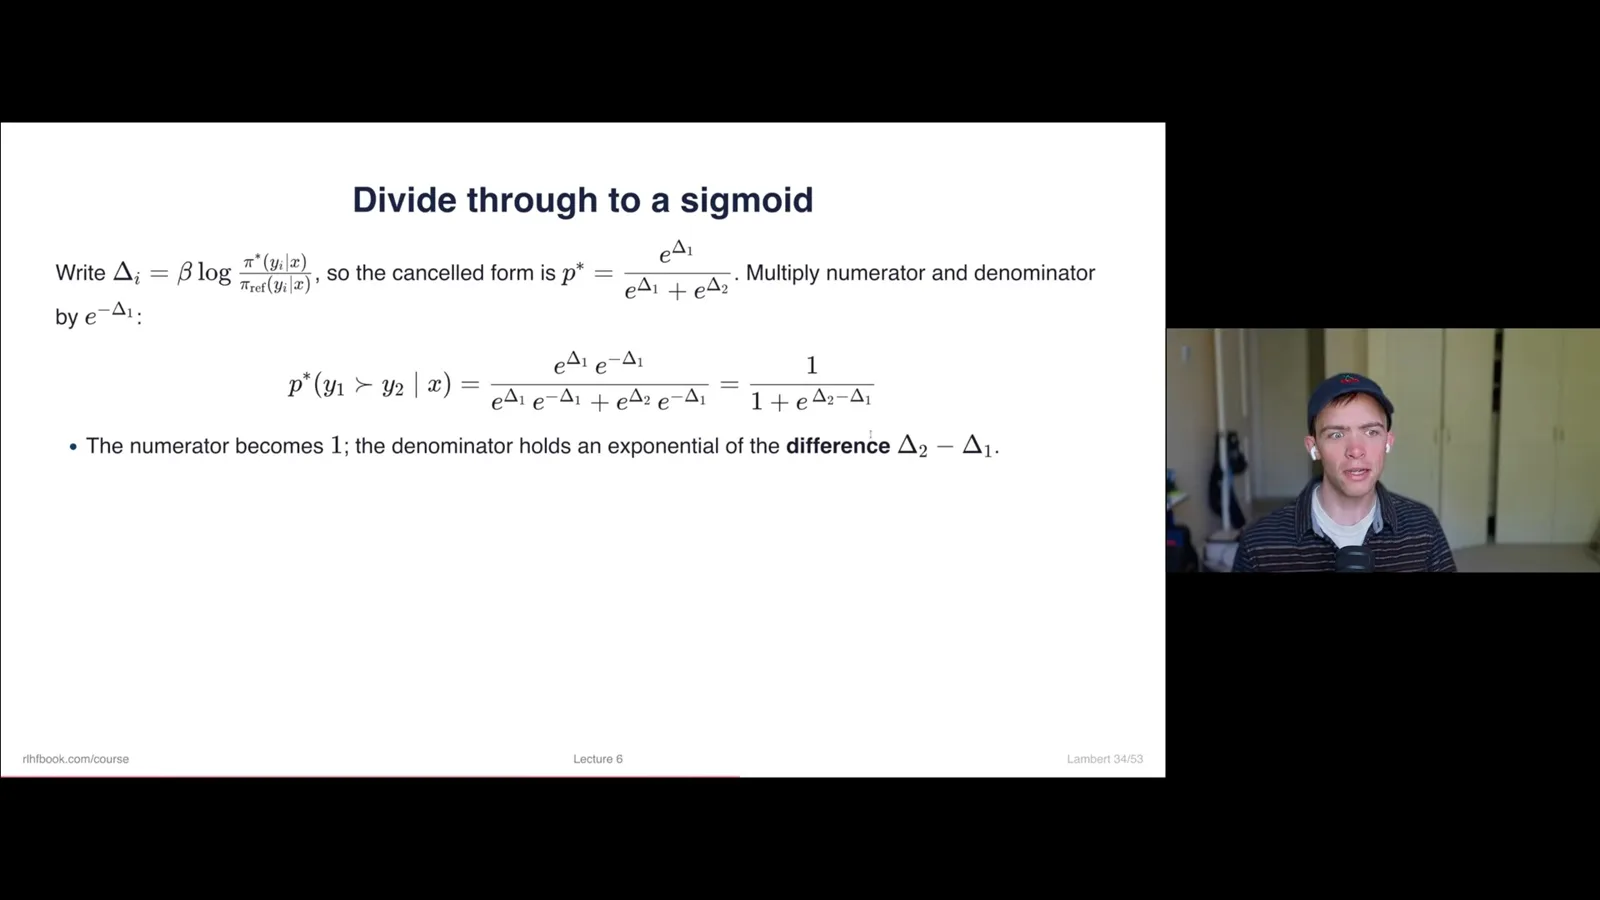
Bradley–Terry 模型用两个回答的奖励差表示其中一个更受偏好的概率。把策略导出的奖励分别代入两个回答。由于它们对应同一个提示词,配分函数项会相互抵消。
化简后,偏好概率是选中和被拒回答各自策略—参考对数比值之差,经 beta 缩放后的 sigmoid。难以直接计算的配分函数已从成对比较中消失。
训练时,最小化观察到的偏好的负对数似然,就得到 DPO 损失。实现通常直接写出损失,让 PyTorch 自动微分计算梯度,而不是手工编码导数。
求导使用链式法则和 sigmoid 恒等式。参考策略固定,因此其参数不接收梯度。Lambert 提醒读者仔细跟踪符号以及选中、被拒回答的顺序,并指出一张幻灯片上可能存在 beta 排版错误。
如果被拒回答相对于选中回答的排名过高,梯度会给予更大权重。更新调整的是语言模型的似然,而不是训练显式奖励网络。Beta 对偏好目标及其与参考模型的关系进行缩放。
局限与替代方法
似然位移和参考模型成本催生了多种变体。Lambert 介绍 IPO、保守 DPO、ORPO 和 SimPO。
一个微妙的局限是似然位移。目标关注选中和被拒回答之间的间隔,并不绝对保证选中回答的概率会上升。被拒回答的概率可能下降得更快,同时选中回答的概率也在下降。
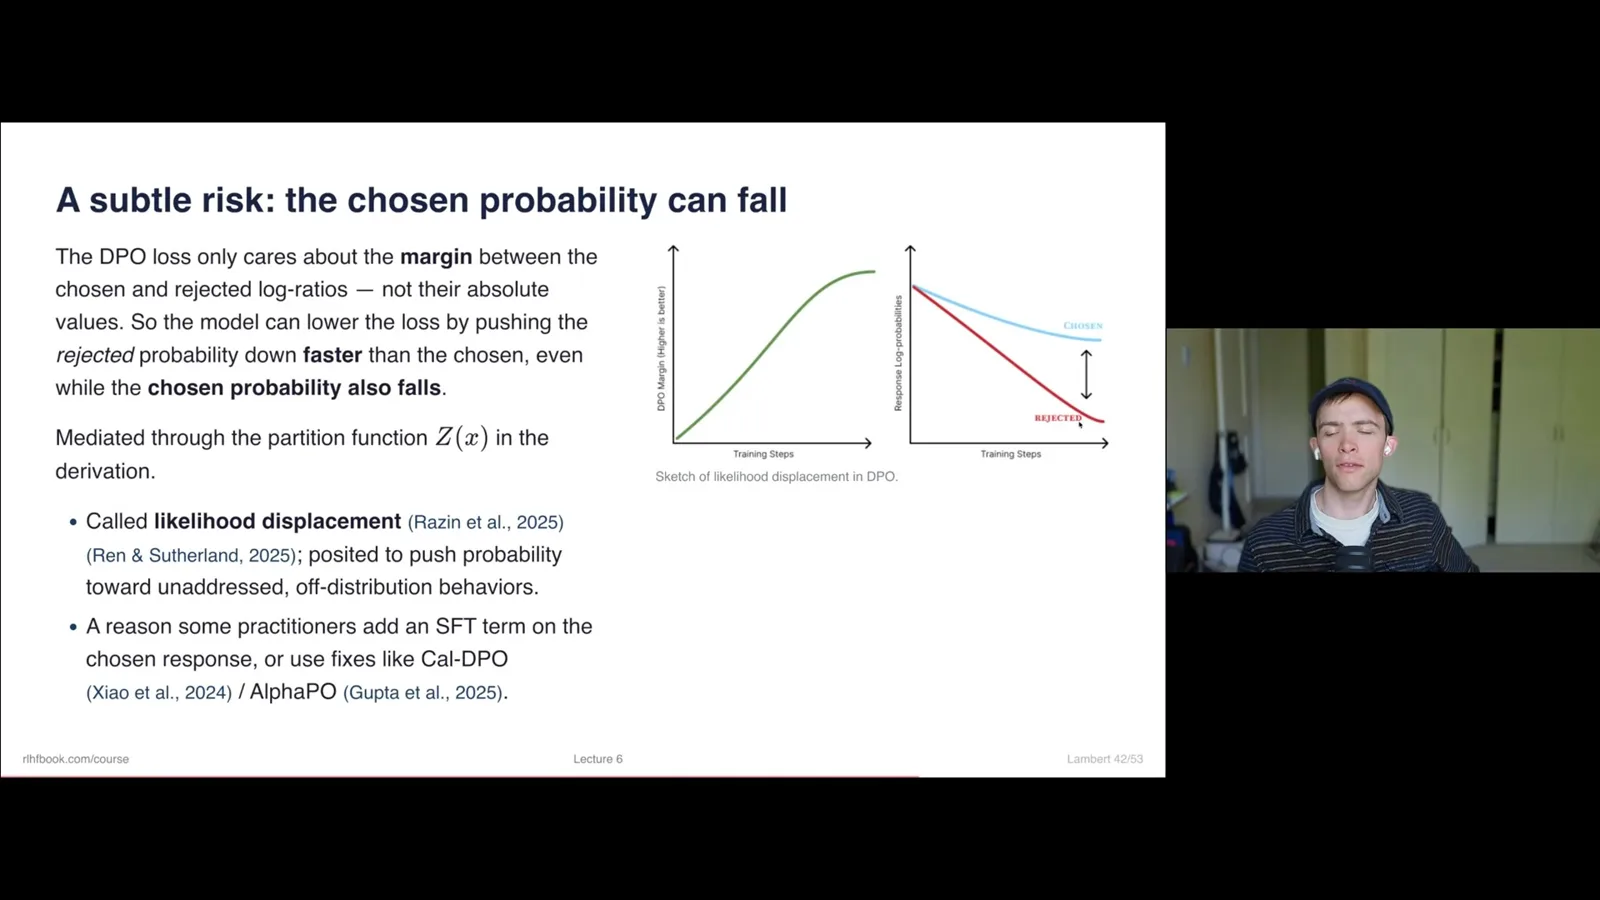
Lambert 描述了一个担忧:概率可能转移到其他分布外输出。研究者提出了保持或提高选中回答似然的方法。这说明偏好间隔增长并不能反映全部情况。
KL 在 DPO 中的作用也不同于强化学习循环里的显式惩罚。DPO 的参考模型和 beta 进入推导所得目标;实际行为仍取决于优化和调参。一些强化学习实现可以在训练中动态调整 KL 惩罚。
相关变体很多。Identity Preference Optimization 修改偏好目标以应对可能的过拟合;保守 DPO 对带噪偏好标签建模;offset DPO 加入反映偏好强度的间隔。
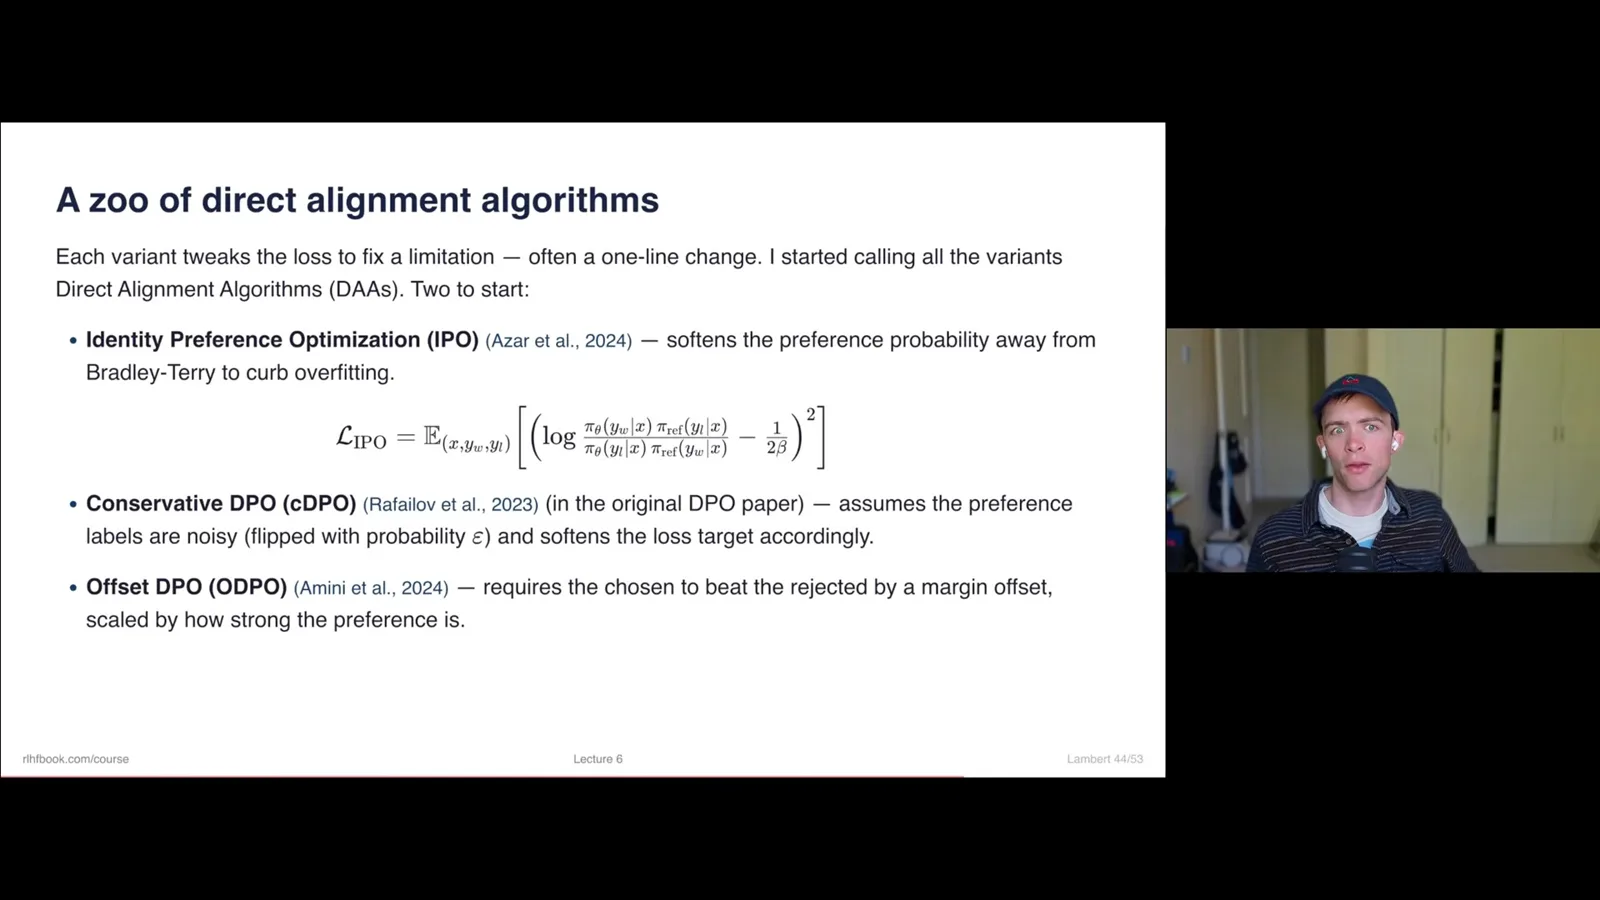
参考模型会占用内存,或者需要提前计算并存储其对数概率。ORPO 在没有单独参考模型的情况下,将偏好学习与选中回答的监督项结合。SimPO 也去掉参考模型,并使用长度归一化等调整。
数据与现代实践
合成和同策略偏好推动了 DPO 的成功。Lambert 对比了其易用性与强化学习的探索潜力。
在代码中,先取得选中和被拒回答的策略对数概率,与参考模型的对数概率比较,再应用 beta 和 log-sigmoid,最后最小化损失。这种紧凑的实现帮助人们尝试 DPO。
合成偏好数据也是重要催化剂。UltraFeedback 使用模型生成的回答,并让 GPT 评判器从多个方面排序。Lambert 认为,它帮助早期 DPO 方法无需完全依靠人工收集偏好,就展示了实际收益。
Tülu 3 和其他项目探索了扩大合成偏好规模,以及加入正在训练的模型自己生成的回答。这些同策略回答可以让比较数据更贴近实际模型及其训练方案。
Lambert 还提到 OLMo 3 关于选中和被拒回答质量差距的研究:如果两者过于相似,训练信号可能较弱。他认为偏好数据的结构和质量仍是值得进一步研究的重要领域。
DPO 更简单,容易起步,也更便于使用固定数据快速迭代。强化学习可以在训练中探索新的回答,但需要更多算力和工程投入。Lambert 引述一些研究,其中强化学习达到了更好的峰值结果,同时强调两种方法在实践中承担不同角色。
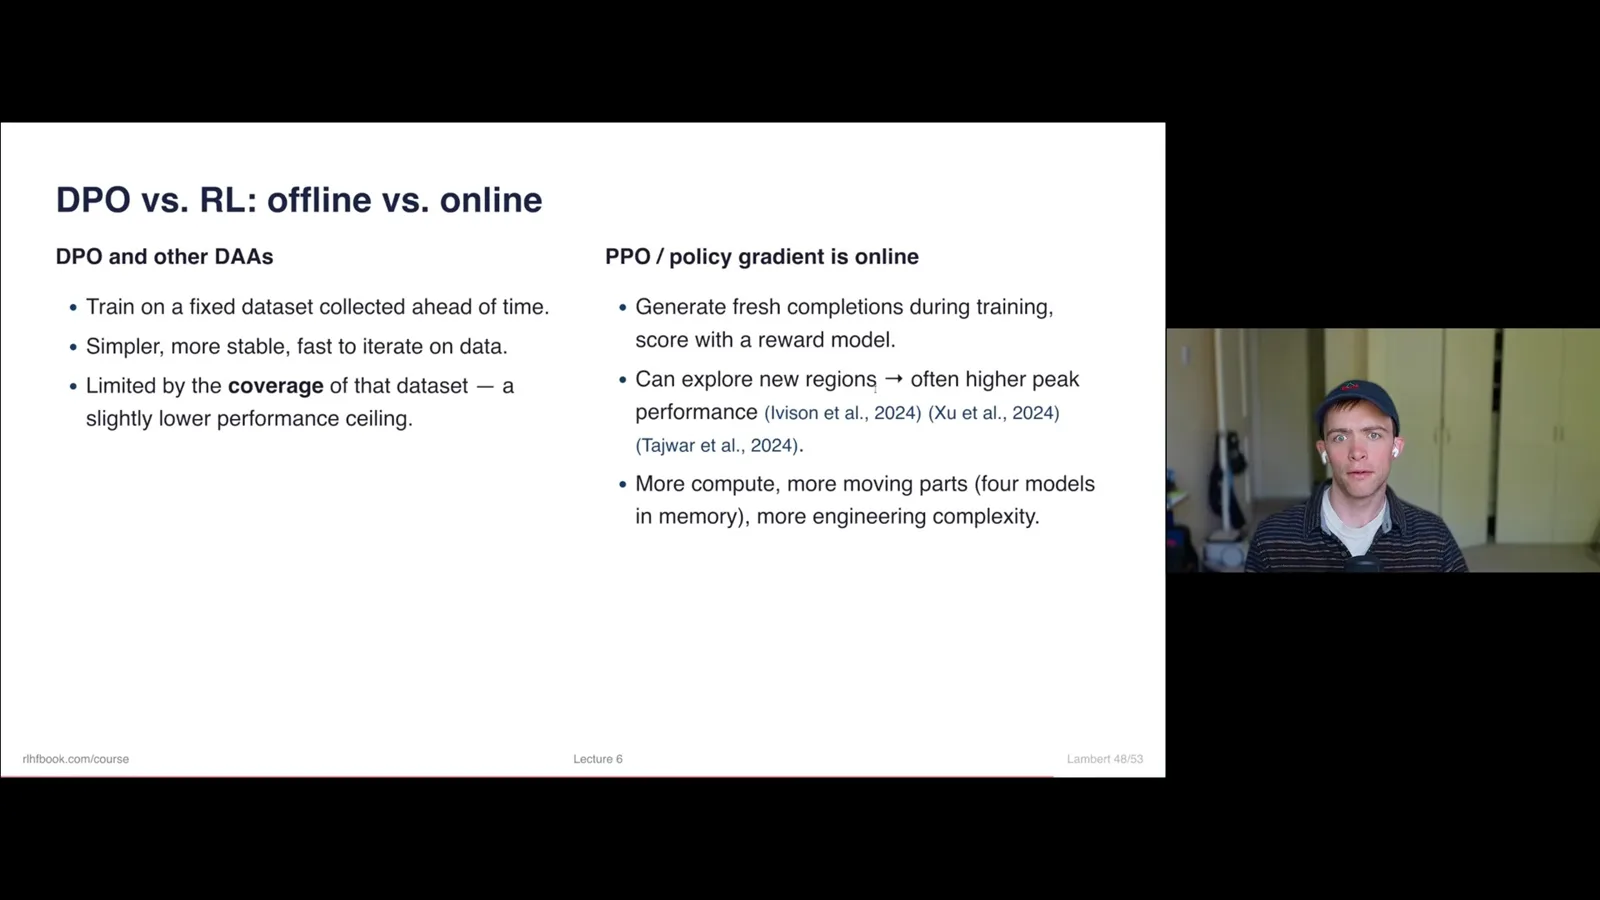
在 Lambert 看来,DPO 仍然适合构建实用模型或测试想法。拥有更成熟的数据流水线、工程能力和资源的团队,可能从将偏好信号整合进更广泛的强化学习阶段中获得更多收益。他预计自己会继续使用这两种方法。
同频道的其他文章
 16:48EN → 简体中文
 Nathan Lambert· 2026年11月2日Nathan Lambert:开放模型如何与前沿实验室竞争Nathan Lambert · Allen Institute for AI开放模型的用量正在增长,能力差距也在缩小,但开发者需要可持续的经济模式和价格之外的优势。
 48:04EN → 简体中文Nathan Lambert· 2026年10月26日Nathan Lambert:开放语言模型的历史、竞争与风险Nathan Lambert · Allen Institute for AI从开放权重、研究基础设施和蒸馏,到采用情况与模型开发者面临的选择。
 46:42EN → 简体中文Nathan Lambert· 2026年10月25日Nathan Lambert 与 Florian Brand 谈 Kimi K3.1、网络风险和 AI 智能体Nathan Lambert, Florian Brand · Allen Institute for AIInterconnects 主持人讨论模型评估的分歧、安全漏洞披露潮,以及个人智能体在日常生活中的作用。
 5:42EN → 简体中文Nathan Lambert· 2026年8月12日修格斯为何成了 AI 后训练的吉祥物Nathan Lambert · Allen Institute for AINathan Lambert 追溯了这种怪物从洛夫克拉夫特小说走向语言模型、微调与 RLHF 视觉隐喻的历程。
 32:56EN → 简体中文Nathan Lambert· 2026年8月6日Nathan Lambert:AI 角色训练入门Nathan Lambert · Allen Institute for AI从 constitution、model spec 到人格实验和激活引导,理解后训练如何塑造模型行为。
 32:11EN → 简体中文Nathan Lambert· 2026年8月5日Nathan Lambert:语言模型评估如何演变Nathan Lambert · Allen Institute for AI从少样本提示与 pass@k,到智能体沙箱、分数噪声和基准污染。